


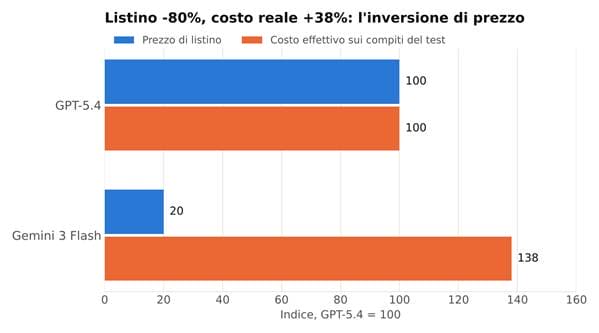
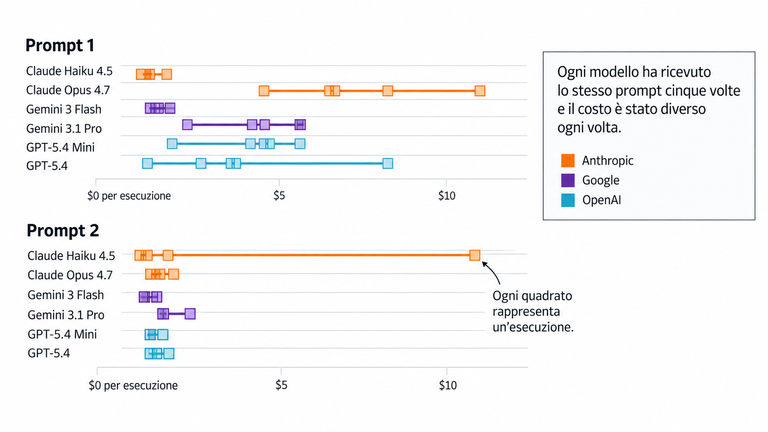
A listino, Gemini 3 Flash costa l’80% in meno di GPT-5.4, eppure, messo alla prova su una batteria di compiti di matematica, scienze e programmazione, ha chiuso il conto con una spesa superiore del 38%. È uno dei casi documentati da un gruppo di ricercatori di Stanford, Berkeley e Microsoft Research, rilanciato il 5 ottobre dal Wall Street Journal in un’inchiesta sulle aziende che non riescono più a mettere a budget la spesa in intelligenza artificiale.
Il dato che accompagna il caso è ancora più netto, perché solo l’11% delle imprese riesce a prevedere quanto spenderà. La ragione sta nel modo in cui si consumano i token, le unità di testo su cui i fornitori calcolano la tariffa: un modello che ragiona a lungo, o un agente che ripete dieci volte lo stesso passaggio, moltiplica la quantità consumata senza che il prezzo unitario lo lasci intuire.
Il listino dice quanto costa un litro di carburante, non quanti chilometri farà l’auto.
La conseguenza per la gestione della spesa tecnologica è diretta. L’unità di misura su cui confrontare i modelli diventa il costo per compito portato a termine, e intorno a questa misura va costruita una disciplina di controllo simile a quella nata una decina di anni fa per governare la bolletta del cloud.
Indice degli argomenti:
Solo l’11% prevede il budget AI entro il 10%
Il numero viene dal rapporto annuale di Mavvrik e Benchmarkit, che fra aprile e maggio ha interrogato 396 organizzazioni di tecnologia, finanza, retail e manifattura. Mavvrik vende software per il controllo dei costi AI e ha quindi interesse a raccontare il problema, ma la serie storica basta a indicare la direzione: la quota di aziende capaci di stimare la spesa con uno scarto entro il 10% è scesa dal 15% del 2025 all’11% di quest’anno, e tra le società nate sull’AI si ferma al 3%.
Le conseguenze sono già organizzative. Il 40% del campione ha dovuto portare una sorpresa di costo all’attenzione del consiglio di amministrazione, un terzo ha congelato la spesa in emergenza, un’azienda su quattro ha rinviato o cancellato un progetto e quasi la metà ha dovuto rivedere il prezzo dei propri prodotti basati sull’AI.
Il WSJ propone una chiave per leggere questi numeri: l’AI agentica, quella che esegue compiti in più passaggi scegliendo da sola i passi successivi, si comporta più come un lavoratore che come un software, prende decisioni, sbaglia, ritenta, e ogni tentativo finisce in fattura. Una licenza costa uguale che la si usi bene o male, un collaboratore pagato a ore invece costa in proporzione al tempo che impiega, compresi gli errori.
Inversione di prezzo nel 32% dei confronti
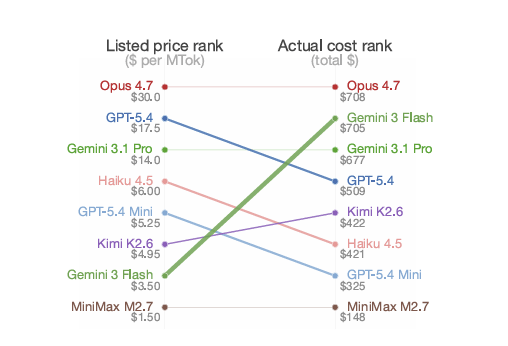
Lo studio sul fenomeno dell’inversione di prezzo, firmato tra gli altri da Lingjiao Chen, Ion Stoica, Matei Zaharia e James Zou, ha messo a confronto otto modelli di ragionamento su dodici compiti, dalla matematica da competizione alla generazione di codice fino agli agenti multi-dominio. Nel 32% delle coppie il modello con il listino più basso ha prodotto il conto più alto, con scarti che arrivano a 28 volte.
La causa principale ha un nome tecnico preciso: i token di ragionamento, ovvero il testo intermedio che i modelli di nuova generazione producono per elaborare la risposta prima di scriverla, e che il cliente paga come output anche quando non lo vede. Sulla stessa domanda un modello può generarne il 900% in più di un altro, e nei compiti agentici il numero di turni di interazione può crescere fino a dieci volte. Chen, intervistato dal Journal, osserva che il prezzo da solo non indica quale modello costi meno.
Sulle previsioni pesa soprattutto la ripetizione. Lanciando due volte la stessa richiesta allo stesso modello, la quantità di token di ragionamento può variare fino a 9,7 volte, una soglia di rumore che secondo gli autori nessuna stima per singola richiesta potrà eliminare, tanto che chiedono ai fornitori un monitoraggio trasparente del costo di ogni chiamata.
I modelli testati appartengono alla generazione di inizio anno e i listini sono cambiati più volte da allora, il meccanismo è però strutturale, perché nasce dal modo in cui questi sistemi ragionano.
Agenti in loop: varianza fino a 30 volte
Con gli agenti, cioè i sistemi che pianificano, eseguono, verificano e correggono il proprio lavoro in cicli successivi, la variabilità si amplifica. Un secondo studio, al quale ha partecipato anche Erik Brynjolfsson dello Stanford Digital Economy Lab, ha analizzato le esecuzioni di otto modelli su SWE-bench Verified, il banco di prova più usato per misurare la capacità di correggere bug reali in progetti open source.
I compiti agentici consumano circa mille volte i token di una conversazione sul codice, e a pesare è soprattutto l’input, perché a ogni passaggio l’agente rilegge tutto il contesto accumulato fino a quel momento. Due esecuzioni dello stesso compito possono differire di trenta volte, oltre un certo livello di spesa l’accuratezza smette di crescere, e i modelli interrogati su quanto consumeranno sottostimano in modo sistematico il proprio fabbisogno.
Nelle aziende questa dinamica ha già prodotto i primi casi di scuola. Secondo il Financial Times, ripreso da The Next Web, Amazon ha speso circa 1,8 milioni di dollari in un progetto basato su Claude per abbinare i record degli autori alle schede prodotto del proprio store, sforando il budget dell’860% senza che nessuno se ne accorgesse per cinque mesi, e senza arrivare a un risultato utilizzabile.
Uber, come ha raccontato un suo dirigente al Journal, aveva esaurito già a marzo il budget annuale per l’AI agentica, e ha poi fissato un tetto di 1.500 dollari al mese per dipendente su ciascuno strumento di coding agentico, da Cursor a Claude Code.
GitHub Copilot e la fine del costo a seat
Il caso di GitHub Copilot mostra dove sta andando il mercato degli strumenti per sviluppatori. Dal primo giugno le richieste premium a forfait sono state sostituite da crediti che si consumano in base ai token di input, di output e di cache, ai prezzi pubblicati di ciascun modello, e chi esaurisce la dotazione non può più ripiegare su un modello più economico.
GitHub ha motivato il cambio osservando che con il vecchio schema una domanda veloce in chat e una sessione di coding autonomo di diverse ore potevano costare all’utente la stessa cifra.
Il prezzo degli abbonamenti è rimasto invariato, ed è cambiato il loro significato: il canone a utente, il cosiddetto seat, diventa una franchigia di consumo, e per gestire ciò che eccede GitHub ha introdotto budget configurabili a livello di azienda, di centro di costo e di singolo utente.
Le grandi aziende si muovono nella stessa direzione dal lato della domanda. A fine maggio il Journal ha raccontato che Microsoft ha limitato per una parte dei dipendenti l’accesso a Claude Code a favore di un assistente interno, che il CTO di Meta Andrew Bosworth ha scritto in un memo che il volume di token non misura l’impatto del lavoro, e che Salesforce ha costruito un sistema per collegare l’uso dei token ai risultati di business. Pochi giorni dopo Sam Altman ha ammesso che il costo è diventato un problema enorme per le imprese, quando a inizio anno nessun cliente ne parlava.
Il gergo della Silicon Valley ha già trovato un nome, tokenmaxxing, per l’abitudine di spingere l’uso dei modelli come se il consumo fosse di per sé una prova di produttività, e Amazon ha chiuso la classifica interna che premiava i dipendenti in base ai token utilizzati.
FinOps dell’AI: misurare il costo per task
La risposta più solida arriva da una disciplina che le aziende conoscono già. Il FinOps, nato per governare la spesa cloud, mette finanza, tecnologia e linee di business attorno agli stessi numeri e assegna a ciascuno la responsabilità dei costi variabili che genera, e applicato all’AI parte da un cambio di unità: il riferimento diventa il costo per compito completato con successo, misurato sui propri carichi di lavoro, con i propri prompt e i propri dati.
Da quella misura discende il resto. L’instradamento dei compiti, che le architetture più mature affidano a un router capace di scegliere il modello per tipo di richiesta, va tarato su test interni e non sulla classifica dei listini, perché le due graduatorie non coincidono. Molte API consentono di fissare un budget di ragionamento o un numero massimo di passaggi per gli agenti, e il contesto che si ripete può essere messo in cache, cioè conservato dal fornitore e riletto a una frazione del prezzo pieno, due accorgimenti che da soli comprimono buona parte della varianza.
Sul piano del budget, i tetti funzionano meglio se assegnati ai flussi di lavoro anziché alle persone, con una regola esplicita su cosa succede quando si esauriscono, e la previsione annuale va costruita per fasce, a partire da un periodo pilota strumentato e da revisioni trimestrali. Anche le simulazioni fatte sui listini, utili per capire gli ordini di grandezza, andrebbero lette come un limite inferiore della spesa reale.
Il cloud ha impiegato quasi un decennio per dotarsi di strumenti, ruoli e clausole contrattuali capaci di governare una spesa variabile, e il FinOps è nato quando le bollette hanno cominciato a sorprendere i direttori finanziari. Con l’AI agentica quel percorso va compresso in pochi trimestri, perché la variabilità è più alta e la quantità consumata la decide in buona parte il modello stesso, e le aziende che oggi misurano il costo di ogni compito avranno, alla prossima revisione dei listini, il solo numero utile per scegliere un modello.



Partecipa alla community