


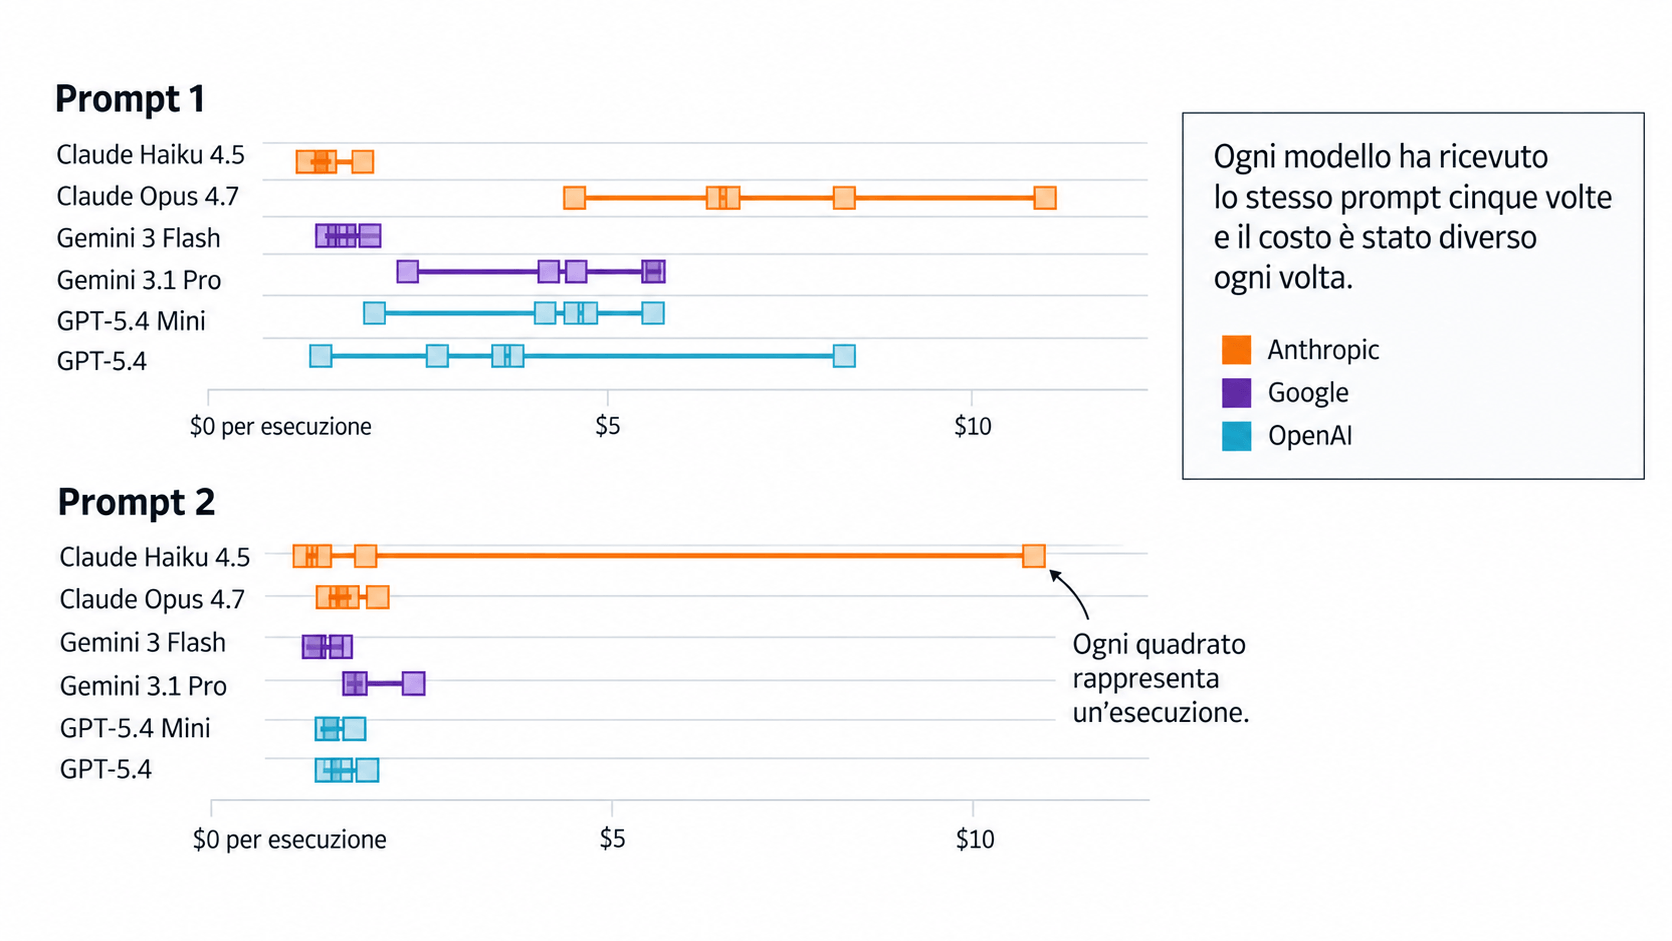
Le imprese hanno trascorso gli ultimi due anni a spingere dipendenti e sviluppatori a utilizzare l’intelligenza artificiale. Ora devono fare i conti con una voce di spesa che assomiglia poco alle tradizionali licenze software. Il costo dell’AI dipende dal numero di token elaborati dai modelli, ma quel consumo può cambiare molto da un’attività all’altra e persino tra due esecuzioni dello stesso compito.
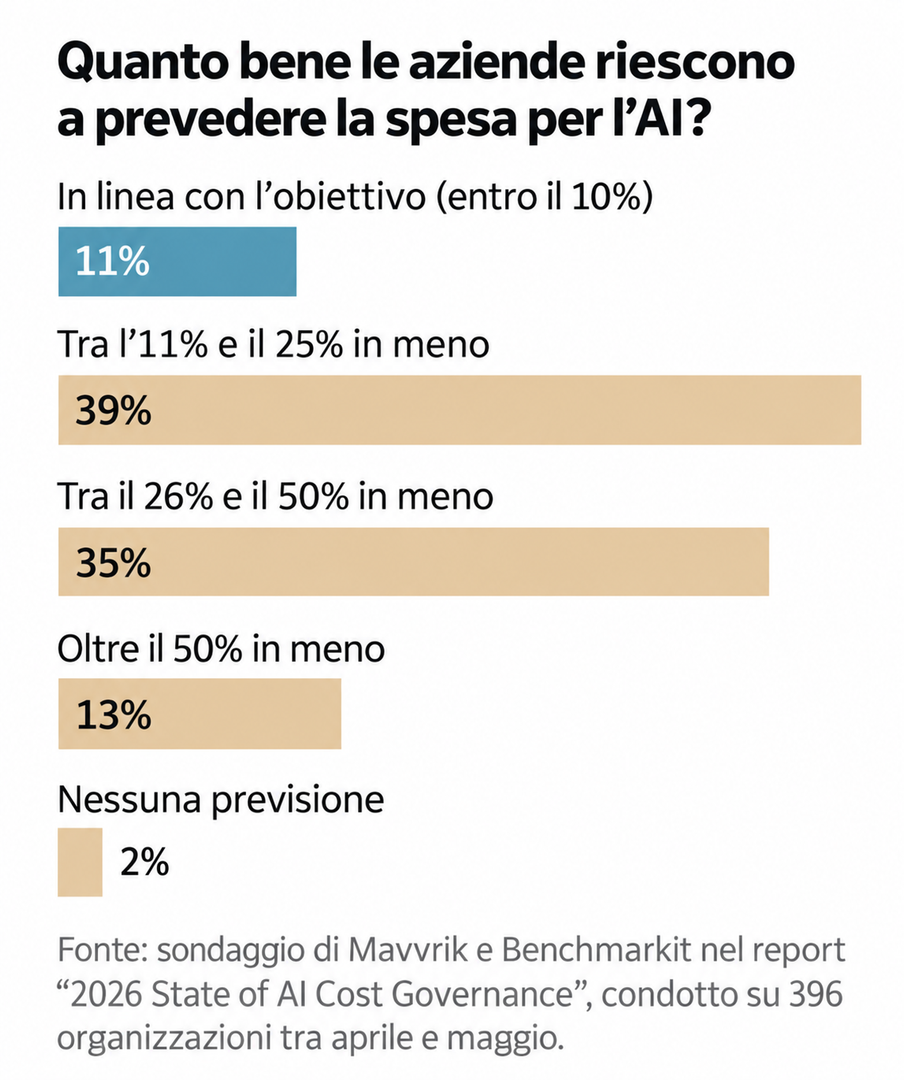
Il problema è diventato abbastanza rilevante da entrare nei budget dei chief information officer e dei direttori finanziari. Secondo lo State of AI Cost Governance Report 2026 – Mavvrik e Benchmarkit, basato su 396 organizzazioni intervistate nell’aprile e maggio 2026, appena l’11% riesce a prevedere la spesa per l’AI con uno scarto inferiore al 10%. L’89% sbaglia quindi le previsioni di almeno dieci punti percentuali. Nel 62% delle aziende un costo inatteso ha già modificato una decisione aziendale e una su quattro ha cancellato almeno un progetto AI.
Indice degli argomenti:
Il prezzo del token non dice quanto costerà un lavoro
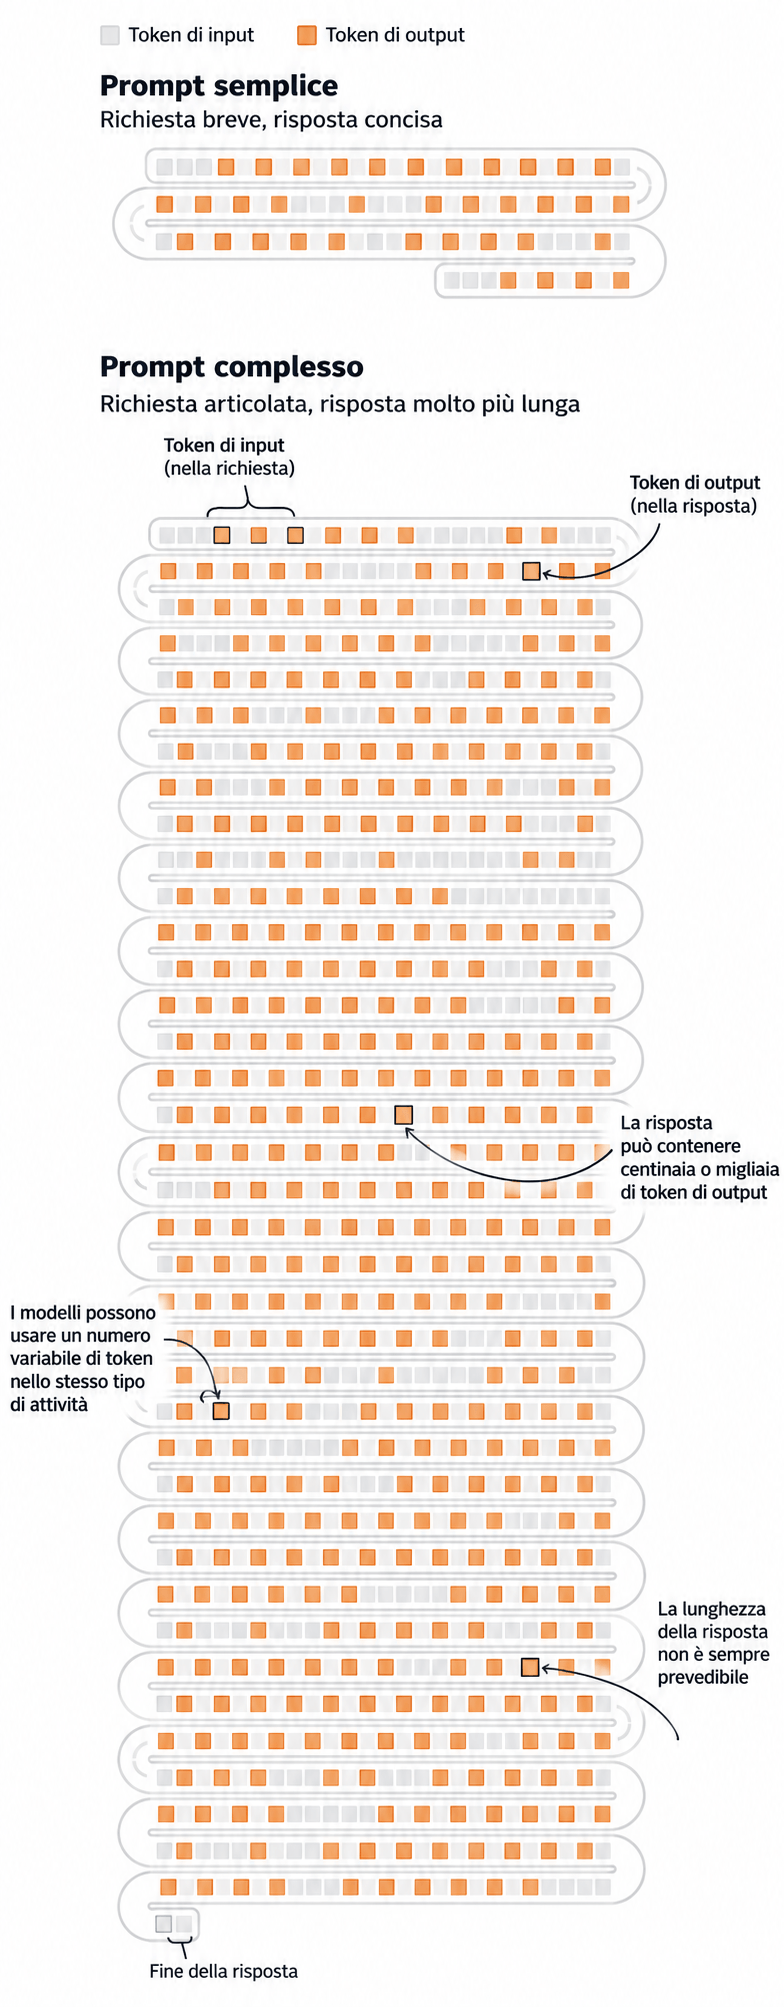
Il token è l’unità con cui i fornitori misurano la quantità di testo e di altre informazioni elaborate dai modelli. Input, output, informazioni recuperate da banche dati e passaggi di ragionamento possono generare consumi differenti. Il listino indica quindi il prezzo unitario, ma non permette di sapere con certezza quanti token serviranno per arrivare al risultato.
È una differenza sostanziale rispetto al software tradizionale acquistato con un canone per utente o con una licenza annuale. Una stessa applicazione AI può utilizzare pochi token per classificare un documento e quantità molto maggiori per analizzare un contratto, scrivere codice o coordinare un agente autonomo che esegue decine di operazioni.
Un lavoro pubblicato il 25 marzo 2026 da Lingjiao Chen, Chi Zhang, Yeye He, Ion Stoica, Matei Zaharia e James Zou, The Price Reversal Phenomenon, ha misurato il fenomeno su otto modelli avanzati e nove categorie di attività, dalla matematica alla programmazione. Nel 21,8% dei confronti tra modelli, quello con il prezzo nominale inferiore ha generato un costo complessivo maggiore. In alcuni casi il divario ha raggiunto 28 volte.
La ragione principale è il numero di token utilizzati durante il ragionamento. Secondo i ricercatori, sullo stesso quesito un modello può impiegarne fino al 900% in più rispetto a un concorrente. Eliminando dal calcolo i token di ragionamento, il numero dei casi in cui il modello apparentemente economico diventa quello più costoso diminuisce del 70%.
Quando il modello meno caro finisce per costare di più
Un esempio riportato dal Wall Street Journal il 5 ottobre 2026 mostra quanto possa essere ingannevole il confronto basato soltanto sui listini. Lo stesso compito di analisi di un fotogramma video è stato affidato a Gemini 3.1 Pro di Google e al più economico Gemini 3 Flash. Il modello Pro ha concluso l’attività dopo 85 passaggi. Flash si è avvicinato a mille passaggi senza riuscire a completarla.
Il risultato economico è stato opposto a quello che il prezzo unitario avrebbe fatto prevedere: circa 14 dollari di consumo per il modello meno costoso, senza ottenere il risultato, contro circa un dollaro per quello più caro, che ha completato il compito. Il caso non dimostra che un modello avanzato sia sempre più conveniente, ma mostra perché il costo per milione di token non possa essere usato da solo per scegliere l’opzione economicamente migliore.
Anche i listini dei principali fornitori mostrano ormai differenze molto ampie tra famiglie di modelli, modalità di elaborazione, input, output e memoria cache. OpenAI, per esempio, applica tariffe diverse per token di ingresso, token generati, contesto lungo e contenuti già presenti nella cache.
Anthropic distingue a sua volta input, output e cache, mentre Google include nei propri prezzi anche specifiche condizioni per i token utilizzati durante il ragionamento. La fattura effettiva nasce quindi dall’incrocio tra prezzo unitario, architettura dell’applicazione e comportamento del modello.
Lo stesso compito può produrre fatture diverse
La variabilità non riguarda soltanto il confronto fra modelli differenti. Anche lo stesso modello può scegliere percorsi diversi quando riceve la medesima richiesta.
Il paper di Chen e degli altri ricercatori ha registrato variazioni fino a 9,7 volte nel numero dei token di ragionamento tra esecuzioni ripetute dello stesso quesito. Per un responsabile finanziario significa che conoscere il costo di una precedente elaborazione non permette necessariamente di trasformarlo in una previsione affidabile per quella successiva.
Il problema aumenta con gli agenti AI, che non producono una singola risposta ma operano in più fasi: leggono informazioni, interrogano strumenti esterni, verificano risultati, aggiornano il contesto e decidono quale operazione svolgere dopo.
Uno studio dello Stanford Digital Economy Lab pubblicato il 14 aprile 2026, How Do AI Agents Spend Your Money? Analyzing and Predicting Token Consumption in Agentic Coding Tasks, ha analizzato le traiettorie di otto modelli avanzati alle prese con SWE-bench Verified. I ricercatori hanno rilevato che le attività agentiche possono consumare fino a mille volte più token rispetto a normali conversazioni sul codice o compiti di code reasoning. Ripetendo la stessa attività, il consumo complessivo è variato fino a 30 volte. I modelli testati, inoltre, tendevano a sottostimare in anticipo il proprio consumo.
È questo meccanismo a rendere particolarmente difficile costruire un budget quando un’impresa passa da un chatbot usato occasionalmente a migliaia di agenti integrati nei processi aziendali.
Lo studio rileva inoltre che i modelli non riescono a prevedere con precisione il proprio consumo futuro e tendono sistematicamente a sottostimarlo. Gli autori sono Longju Bai, Zhemin Huang, Xingyao Wang, Jiao Sun, Rada Mihalcea, Erik Brynjolfsson, Sandy Pentland e Jiaxin Pei. Paper completo su arXiv.
È questo meccanismo a rendere particolarmente difficile costruire un budget quando un’impresa passa da un chatbot utilizzato occasionalmente a centinaia o migliaia di agenti integrati nei processi aziendali.
I token costano meno, ma la spesa può continuare a salire
La pressione sui budget arriva mentre il prezzo medio dell’intelligenza artificiale sta diminuendo. Il Financial Times, il 5 ottobre 2026, ha riportato che il Silicon Data Token Expenditure Index è sceso di oltre il 52% rispetto al massimo registrato nel maggio 2026. Più concorrenza, modelli più efficienti e spostamento di alcuni carichi verso sistemi meno costosi hanno contribuito alla riduzione.
Un token più economico, però, non implica automaticamente una fattura inferiore. Se il costo unitario si dimezza mentre il consumo cresce di cinque o dieci volte, la spesa totale aumenta. Gli agenti accentuano questo effetto perché trasformano una richiesta dell’utente in una sequenza di elaborazioni.
Le previsioni di Gartner – Worldwide AI Spending Forecast, 16 settembre 2026, rendono visibile la dimensione del fenomeno. La società di analisi ha aggiornato a 2.700 miliardi di dollari la stima della spesa mondiale legata all’AI per il 2026, il 49,5% in più rispetto all’anno precedente. Per agenti e assistenti AI Gartner prevede 29,2 miliardi di dollari nell’anno, mentre i modelli generativi arriverebbero a 28,3 miliardi.
A luglio Gartner aveva inoltre stimato una crescita del 63,4% della spesa degli utenti finali per modelli e piattaforme AI nel 2026, fino a 64 miliardi di dollari. La società segnalava già allora una maggiore attenzione delle aziende a costo, latenza, prestazioni e affidabilità.
Anche il collegamento con i risultati economici rimane debole. Una ricerca Accenture pubblicata il 10 settembre 2026, The CIO’s Guide to AI Tokenomics, si basa su un’indagine condotta fra 750 dirigenti senior di 17 Paesi e su interviste a 15 responsabili tecnologici e finanziari di grandi aziende. La ricerca rileva che meno del 20% della spesa in token può essere associata a un risultato finanziario quantificato, come maggiori ricavi, costi evitati o produttività convertita in valore economico.
Solo il 35% delle aziende riesce a calcolare il costo per risultato di business persino nel proprio principale progetto AI. Accenture stima inoltre che il consumo di token possa crescere del 78% nei successivi 24 mesi e rileva che un’organizzazione su tre esaurisce il proprio budget annuale di token prima della fine dell’anno.
Il vero problema è sapere quale attività genera il costo
Il controllo finanziario diventa ancora più difficile quando le aziende non riescono ad attribuire la spesa a un prodotto, un dipartimento o un risultato.
La ricerca Mavvrik-Benchmarkit rileva che la copertura dei sistemi di rendicontazione scende al 36% per workflow agentici e infrastrutture GPU. Il 98% delle aziende intervistate utilizza strumenti AI per la programmazione, ma soltanto il 42% include quella spesa nei propri sistemi di reporting. Il 47% indica inoltre gli extra-costi delle piattaforme dati come principale fonte di spesa inattesa, davanti persino ai token dei grandi modelli linguistici, citati dal 43%.
Il problema non riguarda quindi soltanto il prezzo dell’inferenza. Entrano nel conto database vettoriali, ricerca, trasferimento e conservazione dei dati, GPU, strumenti per sviluppatori, API esterne, sistemi di osservabilità e infrastrutture cloud.
Dalla FinOps alla “tokenomics”
La risposta delle imprese sta prendendo la forma di una disciplina specifica. Il 3 giugno 2026 la Linux Foundation ha annunciato la Tokenomics Foundation, nata per sviluppare standard, benchmark e pratiche comuni per misurare l’economia dell’infrastruttura AI, lavorando insieme alla FinOps Foundation.
La logica estende all’intelligenza artificiale strumenti già utilizzati per governare il cloud: attribuire ogni consumo a un responsabile, stabilire soglie, monitorare la spesa in tempo reale e confrontare il costo con il valore prodotto. La differenza è che l’unità da amministrare non è più soltanto una macchina virtuale o un gigabyte di memoria, ma un processo la cui quantità di calcolo può cambiare durante l’esecuzione.
Anche McKinsey ha misurato il problema attraverso la propria Enterprise AI FinOps Survey, condotta nel maggio 2026. Nell’articolo The Cost of Intelligence: How CIOs Can Manage AI Demand at Scale, pubblicato il 20 luglio, la società riferisce che il 93% delle organizzazioni intervistate ha superato almeno una volta il proprio budget AI. Il sondaggio ha coinvolto 120 partecipanti, dei quali 75 qualificati, appartenenti a cinque grandi settori industriali.
Secondo McKinsey, le aziende che gestiscono in modo più disciplinato il consumo di AI possono ottenere risparmi nell’ordine del 20-30%.
Cache, limiti di spesa, instradamento automatico delle richieste e misurazione del costo per attività permettono di ridurre gli sprechi senza bloccare l’utilizzo dell’AI. Il punto decisivo diventa il costo per risultato: quanto costa risolvere un ticket, sviluppare una funzione software, analizzare un documento o completare un processo, e quale valore economico produce quell’attività.
L’AI sta diventando una voce ordinaria dei costi aziendali
La selezione del modello diventa quindi una decisione economica continua. Le attività semplici possono essere indirizzate verso sistemi piccoli e poco costosi; quelle che richiedono ragionamento, affidabilità o molti passaggi possono risultare più economiche con modelli avanzati. Cache, limiti di spesa, instradamento automatico delle richieste e misurazione del costo per attività permettono di ridurre gli sprechi senza bloccare l’utilizzo dell’AI.
Il budget, però, non potrà essere costruito semplicemente moltiplicando il numero previsto di richieste per un prezzo di listino. Con la diffusione degli agenti, le imprese dovranno stimare intervalli di consumo, misurare ogni workflow e collegare la fattura al valore prodotto. L’AI sta diventando una voce ordinaria dei conti aziendali proprio mentre dimostra di avere un comportamento economico molto meno ordinario del software che l’ha preceduta.





Partecipa alla community