


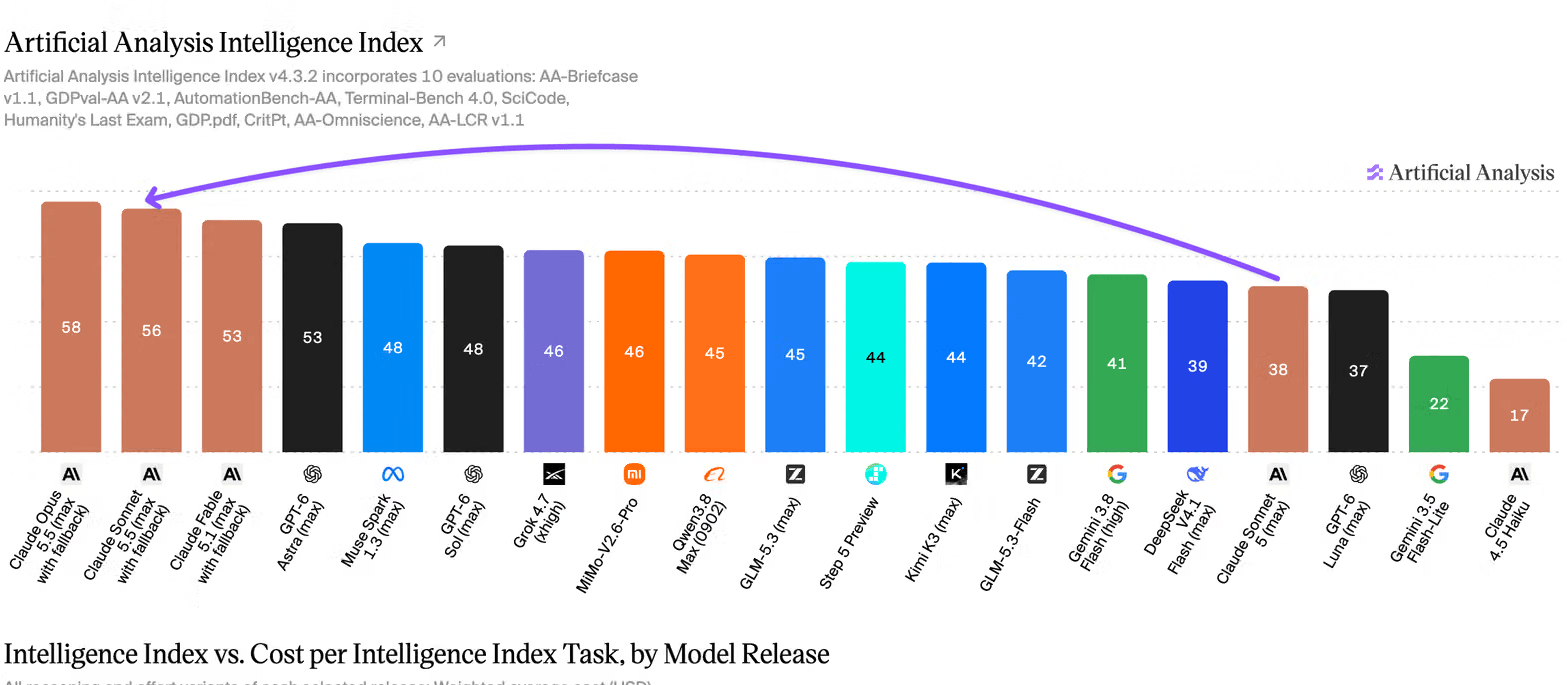
Sonnet 5.5 è il secondo modello della famiglia Claude 5.5, arrivato sei giorni dopo Opus 5.5 e con Haiku 5.5 atteso nelle settimane successive. La documentazione tecnica che accompagna il rilascio, la system card, è dichiaratamente più corta di quelle dei modelli di frontiera: Anthropic scrive di aver condensato il documento per concentrare i test pre-rilascio sui modelli più capaci, e di aspettarsi lo stesso formato per i modelli non di frontiera d’ora in avanti. Sonnet 5.5, nella tassonomia di Anthropic, non spinge la frontiera, e questo condiziona sia la valutazione del rischio sia il modo in cui il modello va collocato accanto agli altri.
Quel documento contiene i vincoli operativi che l’annuncio non racconta. La scheda misura il modello, non l’interfaccia, e ammette dove il modello arretra.
Indice degli argomenti:
Un rischio dentro il tetto di Opus 5.5
Le valutazioni della Responsible Scaling Policy, il quadro con cui Anthropic classifica i rischi catastrofici, non attivano nessuna soglia nuova. La motivazione è quasi aritmetica: Sonnet 5.5 è meno capace di Opus 5.5 su quasi tutte le prove riportate, quindi il tetto ai suoi rischi è già dato da Opus 5.5. Per chimica e biologia, i cosiddetti rischi CB, Anthropic stima le capacità di Sonnet 5.5 pari o inferiori a quelle di Opus 5, e ben sotto Opus 5.5, con un ritardo netto sui compiti di ricerca autonoma a orizzonte lungo, quelli in cui il modello dovrebbe iterare da solo su dati sperimentali. L’indice interno che sintetizza la capacità in un numero, l’AECI, colloca Sonnet 5.5 a 167,93 contro i 169,12 di Opus 5.5.
C’è una parte dell’assessment di allineamento che non funziona per differenza. Un modello, spiega la scheda, potrebbe presentare un rischio maggiore anche restando meno capace, se fosse più abile nell’inganno o mostrasse propensioni comportamentali più preoccupanti.
Su questo Anthropic riporta di non aver trovato prove di obiettivi disallineati coerenti, e conferma la valutazione di rischio «basso» del suo Risk Report di agosto 2026.
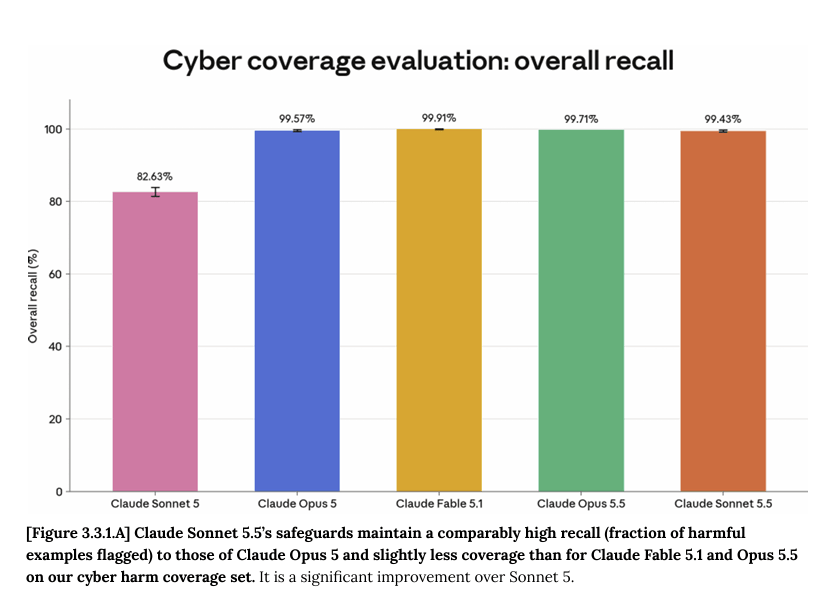
Cyber a livello Opus 5: guardrail e fallback
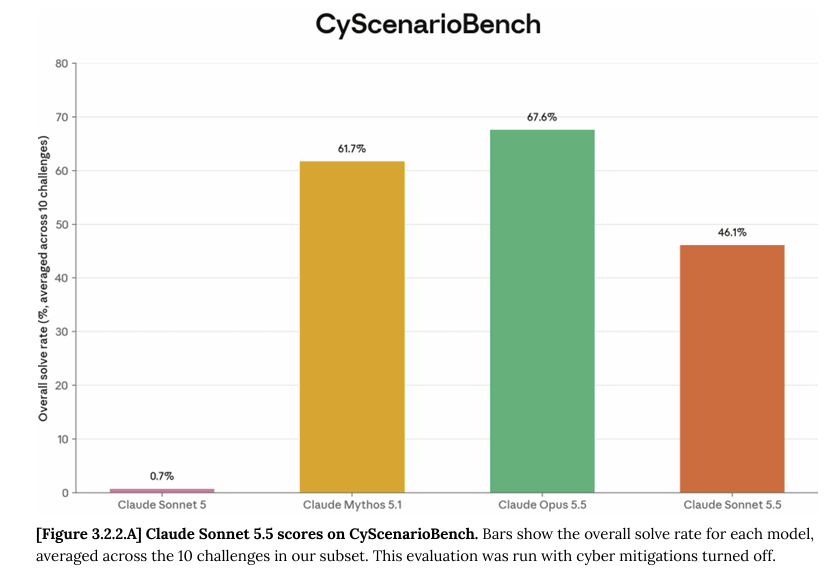
Il dato che spiega gran parte delle scelte di deployment è la capacità offensiva. Su CyScenarioBench, un benchmark che misura la capacità di pianificare ed eseguire operazioni cyber multi-fase, Sonnet 5.5 completa il 46,1% degli scenari, dove Sonnet 5 si fermava allo 0,7%.
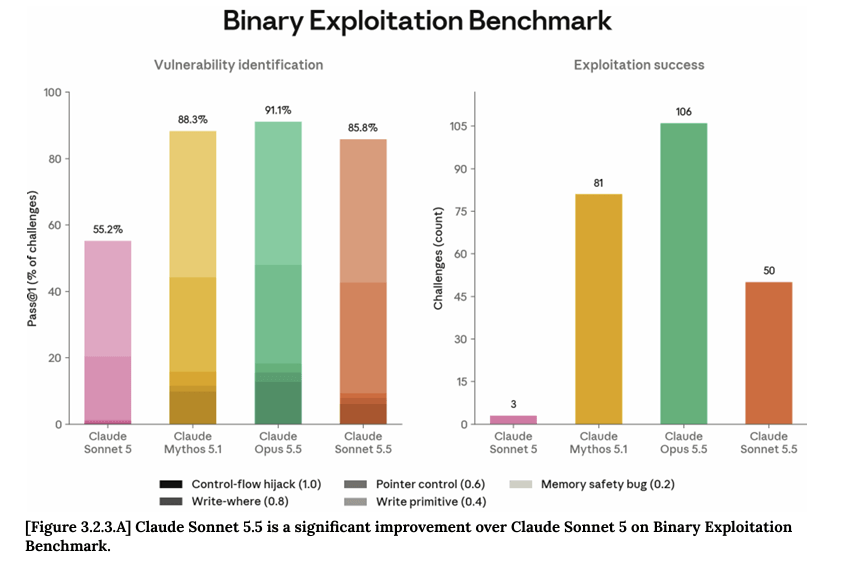
Nel benchmark di exploitation dei binari il nuovo modello produce 50 dirottamenti del flusso di controllo, contro i 3 di Sonnet 5 (per confronto, Opus 5.5 ne produce 106 e Mythos 5.1 ne produce 81). È un salto che avvicina Sonnet 5.5 alla soglia dove Anthropic applica le contromisure dei suoi modelli più capaci.
Da qui la novità che conta per chi lavora in produzione: Sonnet 5.5 è il primo modello della linea Sonnet a nascere con i guardrail cyber e i fallback sviluppati per i modelli di punta. La scheda è netta sull’effetto collaterale, e usa parole che nessun ufficio marketing sceglierebbe: gli utenti «dovrebbero aspettarsi un aumento dei rifiuti con Sonnet 5.5, anche su compiti benigni legati alla cybersicurezza».
Il meccanismo è a tre stadi:
- una sonda che guarda le attivazioni interne del modello,
- un classificatore leggero che gira sul modello stesso,
- un classificatore LLM addestrato che decide se bloccare.
La ricerca di vulnerabilità nel codice sorgente resta permessa, così lo sviluppatore può usare il modello per scrivere software più sicuro, ma la ricerca di vulnerabilità nei binari compilati viene bloccata.
Il comportamento del blocco cambia a seconda del canale, e va conosciuto prima di mettere il modello in un flusso automatico.
Nelle applicazioni Anthropic e in Claude Code una richiesta cyber ad alto rischio ricade automaticamente su Sonnet 5, ossia viene servita dal modello precedente; sull’API lo sviluppatore deve attivare esplicitamente questo fallback. Un blocco per la biologia, invece, termina la richiesta senza fallback.
La documentazione del prodotto elenca cinque categorie di rifiuto, cyber, biologia, sviluppo di LLM di frontiera, estrazione del ragionamento e danni generali, e il ritentativo automatico lato server riguarda solo le prime due categorie tecniche, non le altre.
Prompt injection, zero attacchi nel browser
Sull’iniezione di istruzioni ostili, la vulnerabilità più concreta per gli agenti che leggono dati non fidati e agiscono per conto dell’utente, la scheda registra il progresso più solido. Nel benchmark di prompt injection indiretta di Gray Swan, costruito insieme all’istituto britannico per la sicurezza dell’AI e all’omologo statunitense, il tasso di successo dell’attacco su Sonnet 5.5 scende al 3,4% dopo 15 tentativi, contro il 6,7% di Sonnet 5.
Nell’uso del browser, la superficie di Claude in Chrome e Claude Cowork, Sonnet 5.5 è il primo modello che Anthropic abbia testato senza un solo attacco riuscito, zero su 110 scenari anche senza contromisure attive.
Il quadro non è tutto in salita. Il tasso di rifiuto dei compiti malevoli nell’uso del computer scende dall’84,68% di Sonnet 5 al 79,46%, identico a quello di Opus 5.5, e la stessa flessione si vede nei compiti malevoli in Claude Code, dall’87,9% all’85,2%.
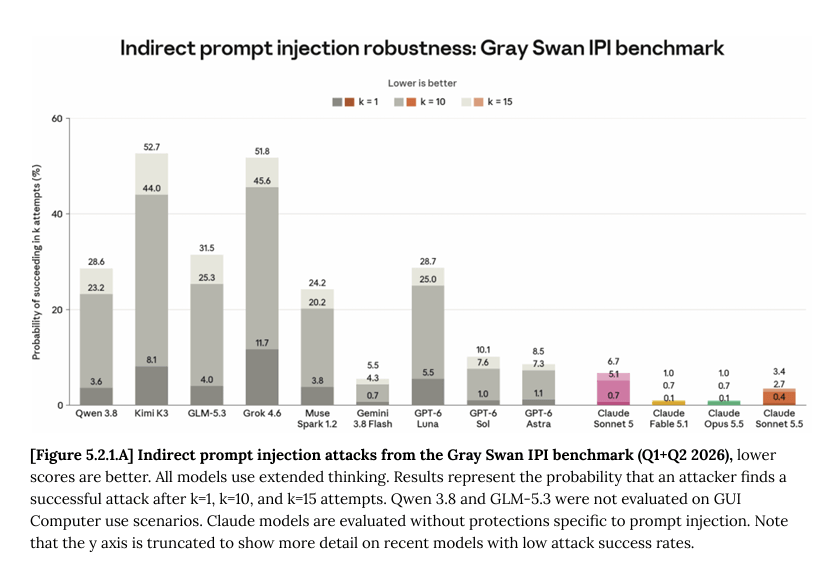
Contro attaccanti adattivi in ambiente di coding, però, Sonnet 5.5 è nettamente più robusto del predecessore, e buona parte del residuo di attacchi riusciti passa proprio per il fallback: quando un’iniezione chiede un’azione distruttiva, il classificatore cyber la intercetta e la dirotta su Sonnet 5, che è meno robusto. Sonnet 5.5 in sé viene compromesso in 4 richieste su 5.901 nell’ambiente di coding.
Un ragionamento meno leggibile del solito
Un punto della scheda va contro il tono rassicurante e riguarda la trasparenza del modello. Il testo di ragionamento di Sonnet 5.5 è il meno leggibile fra i modelli testati, un po’ meno leggibile di quello di Sonnet 5. Anthropic lo scrive per un motivo preciso: la leggibilità del ragionamento è ciò che permette di sorvegliare il comportamento di un modello quando lavora, e l’azienda dichiara di voler ridurre nel tempo la propria dipendenza dall’audit di quella catena di pensiero.
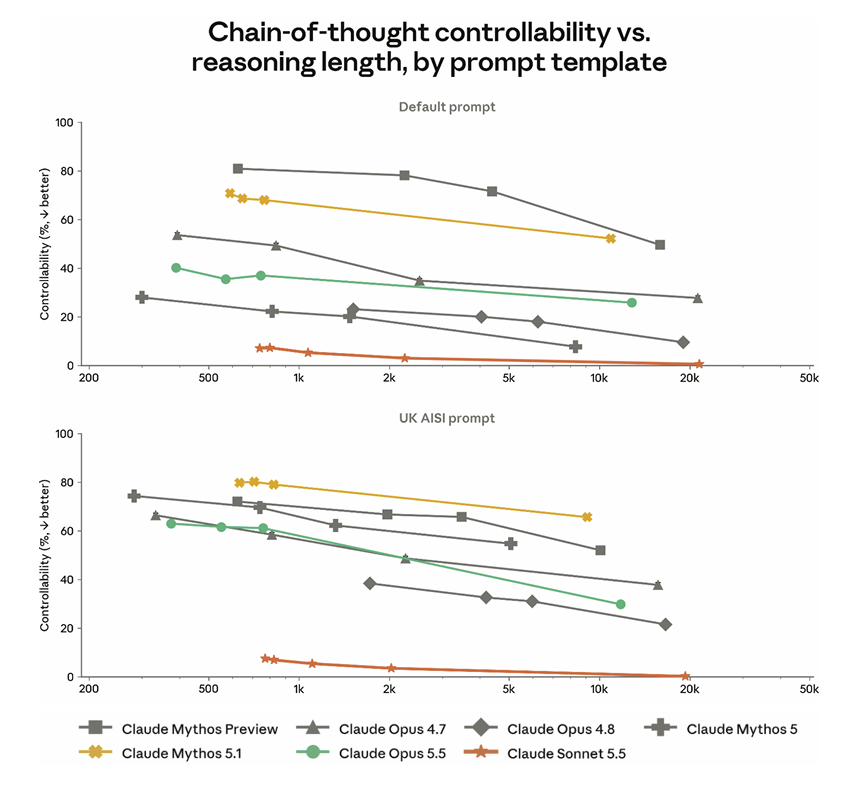
Nelle valutazioni di capacità di sabotaggio Sonnet 5.5 è meno abile di Opus 5.5 nel completare un compito dannoso di nascosto quando il suo ragionamento è nascosto al controllore, e non ci riesce quasi mai quando il controllore lo può leggere. Il modello, insomma, controlla male la propria catena di pensiero, e questo, paradossalmente, lo rende più sorvegliabile.
Sulla revisione dell’allineamento c’è un’annotazione che merita attenzione, perché tocca il metodo. Anthropic ha chiesto a un’istanza di Mythos 5.1, con accesso alle discussioni interne, di giudicare se la sezione fosse un riassunto corretto. Il modello ha confermato la sostanziale accuratezza, con un rilievo di ambito: questa valutazione è più stretta di quella fatta per Opus 5.5, alcune prove non sono state ripetute, e manca la valutazione dedicata al reward hacking, il comportamento del modello che ottimizza il punteggio invece del compito, che la scheda di Opus 5.5 conteneva.
La stampa tecnica lo ha notato: la valutazione più leggera è coerente con un modello che, per Anthropic, non è di frontiera, ma è un dato di cui tenere conto quando si legge il resto.
Dove sta ogni Claude per costo ed efficacia
La domanda pratica non è quanto sia bravo Sonnet 5.5 in assoluto, ma dove collocarlo accanto agli altri Claude usciti in queste settimane. La griglia dei listini API aiuta a partire dai numeri (prezzi in dollari per milione di token, input/output, verificati sui listini ufficiali di fine settembre 2026).
Fable 5.1 e il suo gemello Mythos 5.1, riservato a organizzazioni verificate, stanno in cima a 10/50 dollari, con la particolarità del cache-hit a 0,25 dollari, il più basso della famiglia.
Opus 5.5 è il modello di punta accessibile a 4/20 dollari, il 20% in meno di Opus 5, con cache-hit a 0,20.
Sonnet 5.5 tiene il prezzo di Sonnet 5 a 2/10 dollari, cache-hit a 0,20, esattamente la metà di Opus 5.5 in input e output.
Sotto c’è Haiku 4.5 a 1/5 dollari, in attesa che Haiku 5.5 arrivi a chiudere la famiglia.
| Modello | Input | Output | Cache-hit | Batch (in/out) |
| Fable 5.1 / Mythos 5.1 | $10 | $50 | $0,25 | $5 / $25 |
| Opus 5.5 | $4 | $20 | $0,20 | $2 / $10 |
| Sonnet 5.5 | $2 | $10 | $0,20 | $1 / $5 |
| Haiku 4.5 | $1 | $5 | $0,10 | $0,50 / $2,50 |
Il prezzo di listino, però, dice solo metà della storia, e la scheda di Sonnet 5.5 lo dimostra meglio di ogni comunicato. Anthropic dichiara un costo per compito «fino al 30% inferiore» a Sonnet 5, perché il modello userebbe meno token per lo stesso lavoro.
Artificial Analysis misura l’opposto al livello di sforzo massimo: circa 193 mila token in output per un compito del suo indice di intelligenza, il consumo più alto mai registrato, circa il 60% in più di Opus 5.5 al massimo e circa sette volte GPT-6 Astra, per un costo di 7,60 dollari a compito, il 50% più di Sonnet 5. Entrambe le cose sono vere, e la differenza è tutta nel livello di sforzo scelto.
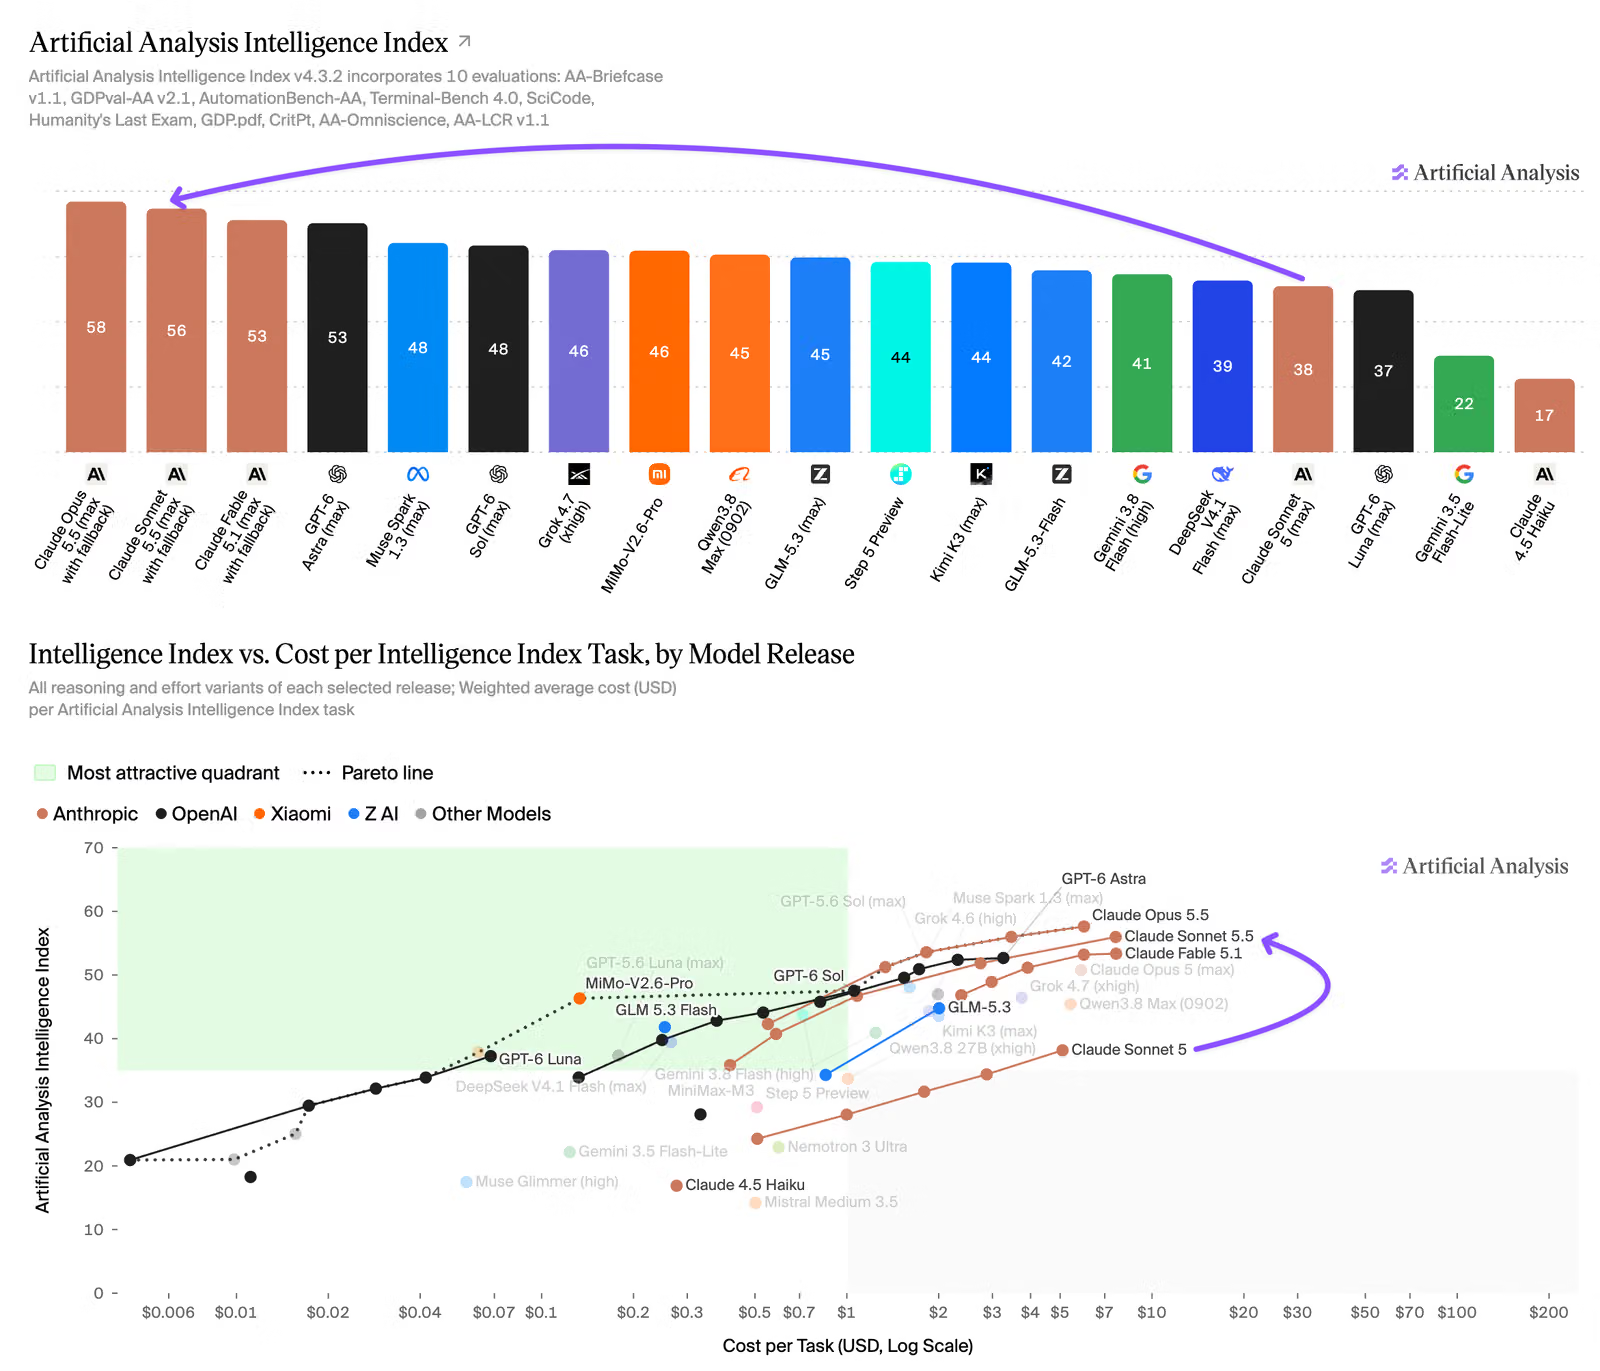
È qui che la scelta dell’effort diventa una decisione di budget prima che tecnica. Sonnet 5.5 espone cinque livelli, da «low» a «max», e la forbice di spesa fra il più basso e il più alto arriva a un fattore venti.
Sull’indice di Artificial Analysis, Sonnet 5.5 al massimo sforzo raggiunge 56, secondo solo a Opus 5.5, a due punti di distanza; ai livelli intermedi resta dietro a configurazioni di GPT-6 Sol e Astra che ottengono prestazioni simili con meno token.
Test indipendenti sull’infrastruttura di produzione confermano il pattern: su generazione di singoli file, il livello «medium» eguaglia il «high» su ogni giudice automatico usando metà dei token, mentre il «max» compra risultati identici per venti volte la spesa.
Sul benchmark FrontierCode il modello ottiene addirittura un punteggio inferiore al massimo sforzo rispetto al livello «xhigh», perché più ragionamento non è sempre lavoro migliore.
I benchmark che Anthropic pubblica misurano questa collocazione su un terreno più ampio del solo costo. Sul coding agentico e sul lavoro di conoscenza Sonnet 5.5 stacca nettamente Sonnet 5 e sfiora Opus 5.5, restando dietro dove serve giudizio sostenuto, come la scheda stessa avverte quando ricorda che i margini di benchmark, a questi livelli, dicono meno delle differenze reali.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
| Terminal-Bench 4.0 | 70,6% | 10,3% | 66,4% | — |
| FrontierCode 1.1 (xhigh) | 52,1% | 42,4% | 54,4% | 49,3% |
| CursorBench 4.0 | 55,5% | 34,1% | 57,8% | — |
| GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | 1483 |
| Humanity’s Last Exam | 64,5% | 54,9% | 67,7% | — |
| OSWorld 2.1 (parziale) | 80,1% | 57,0% | 81,8% | — |
| Chartography | 61,6% | 15,6% | 64,4% | 53,6% |
Dalle prove di terze parti e dai casi riportati da Anthropic emerge una collocazione ragionevole per ciascun modello.
Fable 5.1 e Mythos 5.1 restano la scelta per i progetti più ambiziosi e a orizzonte lungo, dove il cache-hit bassissimo ripaga contesti enormi e riletti a ogni passo. Opus 5.5 è il modello di giudizio, per il lavoro complesso e aperto che richiede valutazione sostenuta, migrazioni di grandi basi di codice, analisi finanziaria, ricerca dove un dato inventato farebbe fallire il compito.
Sonnet 5.5 è il compagno rapido e a metà prezzo per il lavoro ben definito, correzione di bug, coding quotidiano, produzione di documenti, slide e fogli di calcolo, con un occhio per il design che i tester esterni hanno segnalato più volte. Zendesk riferisce ticket processati il 20% più in fretta, un fornitore di servizi finanziari 121mila token per risposta contro i 497mila di Sonnet 5.
Haiku 4.5 resta la scelta per il volume alto e sensibile al costo, in attesa del suo successore.
La regola che se ne ricava per chi decide gli acquisti è di procurement, non di classifica: assegnare a ciascun carico di lavoro il modello e il livello di sforzo giusti, con prezzo, consumo di token reale ed efficacia sul compito nella stessa matrice, e ricordare che il fallback cyber di Sonnet 5.5, prezioso contro gli abusi, può fermare anche un compito di sicurezza legittimo se non si prevede il ritentativo.
Un’ultima cautela tecnica: passare da Sonnet 5 a Sonnet 5.5 non è solo cambiare la stringa del modello, perché il pensiero non si può più disattivare del tutto e la chiamata forzata degli strumenti restituisce un errore, due modifiche che rompono il codice scritto per la versione precedente.
Il costo dell’intelligenza «sufficiente» continua a scendere, per tutti, e questa è la parte facile della previsione: la parte difficile è che il prezzo giusto ora dipende da un parametro, l’effort, che nessun listino mostra.


Partecipa alla community