

Quarantacinque posti di lavoro tagliati e poi ripristinati. Commonwealth Bank of Australia aveva giustificato la riduzione del personale con un assistente vocale che, secondo la banca, faceva calare le chiamate di circa duemila a settimana, finché il sindacato del settore non ha mostrato che i volumi stavano crescendo, con straordinari e capi team costretti a rispondere al telefono, e nell’agosto 2025 la banca ha fatto marcia indietro. Il risparmio dichiarato non era stato misurato contro una baseline trasparente, cioè contro un punto di partenza documentato prima dell’intervento, e senza quel punto la discussione sul ritorno dell’investimento si è trasformata in una disputa sui numeri.
Il caso australiano è estremo ma il meccanismo è comune: il ROI dell’intelligenza artificiale si sbaglia molto prima di misurarlo, quando si scrive il caso d’uso senza dire da dove si parte né quando ci si ferma.
Nel 1987 Robert Solow scrisse che l’era del computer si vedeva ovunque tranne che nelle statistiche della produttività, e quasi quarant’anni dopo le indagini sull’AI raccontano una storia molto simile.
Indice degli argomenti:
Più scala e lo stesso 37% di impatto
L’ultima edizione del rapporto The state of AI di McKinsey, pubblicata a fine agosto su 1.719 rispondenti, registra che il 44% delle organizzazioni dichiara di scalare l’AI a livello aziendale, contro il 38% di un anno prima, mentre la quota di chi attribuisce all’AI almeno un impatto sul margine operativo resta al 37%, praticamente invariata. Le aziende che ricavano dall’AI almeno il 5% dell’EBIT sono il 6%, la stessa percentuale del 2025, e circa una su cinque riferisce che i costi di esercizio, token compresi, hanno limitato l’uso.
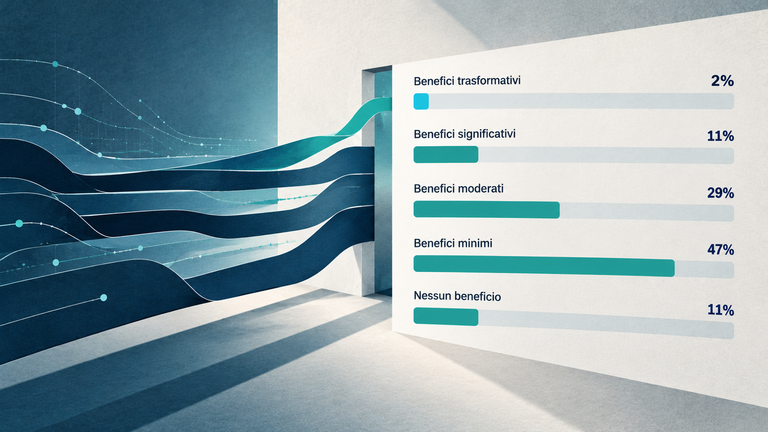
Il sondaggio PwC tra 4.454 amministratori delegati, presentato a gennaio, dice che il 56% non ha visto benefici finanziari significativi e che solo il 12% ha ottenuto insieme riduzione dei costi e crescita dei ricavi. In Italia il mercato dell’AI ha toccato 1,8 miliardi di euro nel 2025, con il 71% delle grandi imprese impegnate in almeno un progetto, e l’Osservatorio Artificial Intelligence del Politecnico di Milano segnala che circa un’azienda su tre fatica a stimare costi e benefici prima di partire.
Il dato più citato degli ultimi dodici mesi, il 95% di progetti pilota senza impatto misurabile sul conto economico attribuito al rapporto del MIT NANDA, va maneggiato con cautela: il rapporto definisce il successo come un impatto marcato e sostenuto e si basa su interviste, non su bilanci, tanto che gli stessi autori parlano di numeri indicativi. Ciò che accomuna le indagini, letti i limiti di ciascuna, è la distanza tra adozione e risultato, il paradosso di Solow riproposto con un’altra tecnologia.
Ritorni all’81% per chi sa chiudere
L’indagine di Gartner pubblicata il 1° settembre, su 1.303 aziende con almeno 50 milioni di dollari di fatturato, aggiunge un elemento che le altre ricerche lasciano sullo sfondo. Solo il 22% ha portato l’AI su più unità di business, e l’11% non sa quanto la propria funzione abbia speso in AI nel 2025; le organizzazioni più efficaci, quelle che tracciano il ritorno e fermano i progetti deboli, dichiarano risultati positivi sull’81% delle iniziative, mentre le meno efficaci ignorano il ritorno di quasi un progetto su tre.
La differenza tra i due gruppi sta nella disciplina di fermarsi più che nella tecnologia adottata. Gartner aveva già previsto nel 2025 che oltre il 40% dei progetti di AI agentica, quella che esegue compiti in autonomia, sarà cancellato entro la fine del 2027 per costi crescenti, valore incerto o controlli insufficienti sul rischio, e ognuna di queste cause si vede in anticipo se il progetto nasce con una baseline e con criteri di uscita scritti.
Il gate G0 e l’alternativa senza modelli
Il primo controllo si fa prima di scegliere qualsiasi modello e consiste in una domanda semplice: il problema merita davvero una soluzione basata sull’AI? Nel metodo di ZeroFive.AI, la società di consulenza sull’adozione dell’AI che ho fondato, è il primo dei gate decisionali, G0, e il suo criterio non si negozia: per ogni caso d’uso va descritta un’alternativa senza AI, che può essere un’automazione tradizionale o una semplice revisione del processo, e va motivato per iscritto perché la si scarta. Il campo si compila prima di conoscere la risposta, altrimenti diventa una giustificazione a posteriori.
Il value case, il documento che descrive il valore atteso di un caso d’uso, contiene poi due elementi che quasi nessun progetto pilota ha al momento dell’avvio: la baseline misurata sul processo attuale, in tempo per pratica, errori e costo unitario, e il valore obiettivo con il modo in cui verrà rilevato. Una buona parte dell’efficienza cercata sotto l’etichetta dell’AI si ottiene con automazioni deterministiche, regole e integrazioni che costano meno e sbagliano in modo prevedibile, e dichiararlo protegge il budget per i casi in cui un modello serve davvero.
Klarna offre l’esempio opposto. All’inizio del 2024 l’azienda annunciava un assistente che gestiva due terzi delle conversazioni con i clienti, il lavoro di 700 persone, con un miglioramento stimato dei profitti di 40 milioni di dollari; a maggio 2025 l’amministratore delegato ha ammesso che la spinta sui costi era andata troppo oltre e che la qualità ne aveva risentito, e l’azienda ha ripreso ad assumere operatori. Il conto iniziale misurava il costo per conversazione e lasciava fuori la qualità del servizio, una seconda metrica che nessun value case serio può omettere.
Costo per task doppio a 53 punti
La seconda correzione riguarda l’unità di misura. I listini dei modelli si leggono in dollari per milione di token, i frammenti di testo che un modello legge e produce, ma l’azienda paga compiti svolti, e il rapporto tra le due unità cambia da modello a modello. Artificial Analysis ha introdotto il costo per task, la spesa media per completare uno dei compiti del suo indice di capacità, calcolata su token in ingresso, in uscita, di ragionamento e in cache.
Nelle tabelle consultate a ottobre GPT-6 Astra e Claude Fable 5.1, entrambi nella configurazione di massimo sforzo, ottengono lo stesso punteggio di 53, ma il primo costa 3,26 dollari per task e il secondo 7,63; DeepSeek V4 Flash scende a 22 centesimi con 18 punti in meno, mentre Gemini 3.5 Flash, con un punteggio leggermente inferiore a quello di DeepSeek, costa 1,56 dollari per task.
Un prezzo basso per token non garantisce un costo basso per lavoro svolto, perché conta quanti token il modello consuma per arrivare alla risposta.
Per un caso d’uso aziendale il calcolo va portato un passo oltre: costo per pratica completata, includendo i tentativi falliti e il tempo delle persone che controllano l’output. È un conto che si fa con un foglio di calcolo e un campione di qualche centinaio di casi reali, e cambia spesso la classifica dei modelli che si ottiene leggendo i listini.
Dodici settimane e un’ipotesi falsificabile
L’ultima correzione è temporale. Un progetto pilota senza scadenza tende a diventare permanente: si aggiungono funzioni e si rimanda il passaggio all’uso quotidiano, mantenendo in vita un sistema che nessuno ha il mandato di chiudere. Una durata massima tra otto e dodici settimane, con criteri di passaggio e di chiusura scritti prima dell’avvio, trasforma il pilota in un esperimento con un esito, e l’esito in una decisione binaria.
Il criterio di passaggio più utile è un’ipotesi falsificabile, dichiarata prima di cominciare: il tempo medio di risposta a un’offerta scende sotto una soglia, oppure il costo per pratica cala di una quota fissata rispetto alla baseline. Se l’ipotesi viene smentita il progetto si chiude e si scrive perché, un’informazione che vale quanto un successo per il caso successivo.
Solow vide le sue statistiche cambiare negli anni Novanta, quando le aziende smisero di aggiungere computer ai processi esistenti e cominciarono a ridisegnare il lavoro intorno a loro, e i guadagni di produttività arrivarono quasi un decennio dopo il suo aforisma. Con l’AI quel ritardo si può accorciare, a patto di scrivere la baseline il giorno prima del pilota e la decisione di chiudere il giorno in cui il pilota comincia.



Partecipa alla community