


L’11 novembre Google DeepMind ha presentato Gemini Decisions API, un servizio per affidare all’intelligenza artificiale centinaia di microdecisioni in un’unica richiesta. Il nuovo modello, Gemini Decision 1, può valutare fino a mille domande su uno stesso insieme di informazioni, che comprende testo, immagini, audio, video e PDF, restituendo probabilità invece di generare spiegazioni in linguaggio naturale. Il prezzo annunciato è di 0,10 dollari per milione di token in ingresso, senza addebiti per i token di output.
La novità arriva in un mercato già avviato: da settembre sono comparsi modelli decisionali come Jev di TypeSafe, Microsoft-Decision-1 e la Decisions API di OpenAI. Google prova a differenziarsi soprattutto per la gestione multimodale e per il numero di verifiche effettuabili insieme.
Il servizio è già accessibile in anteprima agli sviluppatori tramite Google AI Studio, con un livello gratuito per le prove; l’integrazione nella piattaforma Gemini di Google Cloud è invece annunciata per una fase successiva.
Indice degli argomenti:
Un documento, mille domande: come funziona Gemini Decision 1
Un’assicurazione riceve un modulo di sinistro, alcune fotografie e la registrazione di una telefonata. Il gestionale deve stabilire se manca un documento, quanto è urgente la pratica e a quale ufficio inviarla. Con un modello generativo tradizionale potrebbe produrre una risposta scritta e poi trasformarla in campi utilizzabili dal software. Con Gemini Decision 1 può invece definire in anticipo le risposte ammesse e ricevere direttamente punteggi e probabilità per ciascuna verifica.
Le domande possono assumere tre forme: Noul, per stimare la probabilità che una condizione sia vera; Choice, per scegliere tra due e 255 alternative; e Score, per assegnare un punteggio secondo livelli ordinati. Le domande indipendenti possono essere combinate nella stessa chiamata, condividendo un input fino a 256 mila token; quelle che dipendono dal risultato di un controllo precedente richiedono un altro passaggio.
Mille è il numero massimo di domande riferite a quello stesso input: non significa elaborare mille sinistri o mille documenti indipendenti gratuitamente.
La valutazione avviene in un solo passaggio del modello, anziché generare una sequenza di parole. L’applicazione può impostare soglie: per esempio, smistare automaticamente i casi chiari, richiedere una seconda analisi quando i punteggi sono incerti e inviare a una persona quelli che possono incidere sui diritti del cliente. A decidere che cosa fare dopo il punteggio è però il software progettato dall’azienda: il modello non dispone autonomamente un rimborso o un rifiuto.
Jev, OpenAI e Microsoft erano già arrivati: cosa aggiunge Google
La categoria dei decision model è stata descritta su AI4Business.it nella nostra analisi che confronta Jev, Clef, OpenAI e Microsoft, e mentre in una guida vediamo probabilità calibrate, tipologie di domanda e soglie di intervento. Google entra quindi in una competizione già definita, anziché inventare un nuovo modo di usare l’intelligenza artificiale.
TypeSafe aveva inaugurato il segmento a settembre con Jev. Secondo la documentazione tariffaria ufficiale, il prezzo è di 0,042 dollari per milione di token in ingresso. Il 9 ottobre Microsoft ha presentato Microsoft-Decision-1, disponibile in Foundry e tramite OpenRouter, con lo stesso prezzo base. Il modello Microsoft è derivato da un Qwen3.5-9B successivamente addestrato per valutazioni strutturate.
OpenAI offre una Decisions API basata su GPT-6 Luna: supporta testo, immagini e dati JSON, fino a 400 domande per richiesta, e costa 0,10 dollari per milione di token di input non memorizzati nella cache. Nella documentazione attuale è indicata come generalmente disponibile, con opzioni di elaborazione regionale europea per i clienti idonei. Nella fascia dei modelli più specializzati si collocano anche Liquid d1 e Clef di Cloudflare, quest’ultimo con pesi aperti.
Il prezzo per token è soltanto una parte del confronto. Google accetta nativamente anche audio e video e mette a disposizione mille domande su un input condiviso; OpenAI ne prevede 400 e offre altre opzioni per cache e trattamento regionale. Per Microsoft e Jev contano integrazione, requisiti di deployment e prestazioni sul singolo compito.
Il numero massimo di domande misura la capacità di raggruppare controlli, non la precisione delle loro risposte.
Quattro offerte di modelli decisionali a confronto
| Prodotto | Input dichiarati | Domande per richiesta | $/milione token input |
|---|---|---|---|
| Google Gemini Decision 1 | Testo, immagini, audio, video, PDF | 1.000 | 0,10 |
| OpenAI Decisions / GPT-6 Luna | Testo, immagini, JSON | 400 | 0,10 |
| Microsoft-Decision-1 | Valutazioni strutturate | Non specificato | 0,042 |
| TypeSafe Jev | Testo e dati strutturati | Non specificato | 0,042 |
Fonti: annunci e documentazione dei rispettivi produttori, consultati il 12 novembre 2026. Prezzi base pubblici in dollari per milione di token d’ingresso; output non tariffato nei quattro casi. Tariffe, regioni, cache, formati e qualità dei risultati non sono equivalenti. Il limite indicato è quello documentato pubblicamente, non una misura di accuratezza.
Quanto si risparmia facendo molte verifiche sulla stessa pratica
Il vantaggio delle mille domande emerge soprattutto quando il sistema deve controllare molti aspetti del medesimo materiale. Google precisa che il documento o altro input condiviso viene fatturato una sola volta per richiesta, mentre le istruzioni e i criteri di ciascuna domanda aggiungono i propri token. Non si paga per il testo della risposta, perché il modello restituisce direttamente valori strutturati.
Un esempio aritmetico chiarisce l’effetto della condivisione dell’input. Se una pratica richiede dieci controlli, ciascuno di 100 token di istruzioni, e il documento comune occupa 4.000 token, una chiamata aggregata usa circa 5.000 token contro 41.000 di dieci chiamate separate che rileggono ogni volta tutto il documento. Applicando lo stesso listino Google, su 100 mila pratiche la componente di inferenza passerebbe teoricamente da 410 a 50 dollari.
Con documenti brevissimi, da 200 token, lo stesso confronto scende da 30 a 12 dollari: il risparmio relativo è più piccolo, perché pesa di più il testo delle dieci domande. Sono simulazioni di soli token di input, non costi misurati in produzione: escludono overhead, eventuali cache, servizi di acquisizione dei documenti, controlli aggiuntivi, persone incaricate della revisione e chiamate a modelli più costosi.
Quanto incide l’input condiviso: simulazione su 100 mila pratiche
| Documenti per pratica | 10 chiamate separate | 1 chiamata, 10 controlli | Rapporto |
|---|---|---|---|
| 4.000 token condivisi | 410 $ | 50 $ | 8,2 volte |
| 200 token condivisi | 30 $ | 12 $ | 2,5 volte |
Elaborazione su prezzo dichiarato Google di 0,10 $ per milione di token input: 100.000 pratiche, 10 domande da 100 token ciascuna, senza cache o overhead aggiuntivo. Non è un benchmark delle API e non quantifica il costo complessivo di un processo.
Benchmark: Google dichiara risultati migliori, ma manca il confronto indipendente
Nell’annuncio Google afferma che Gemini Decision 1 guida la serie di prove pubblicata dall’azienda, dedicata a instradamento degli agenti, ragionamento, ranking e comprensione multimodale, con errori di calibrazione inferiori a quelli degli avversari testati. Dichiara inoltre 50-100 millisecondi mediani di calcolo del modello e 150-250 millisecondi complessivi di risposta nei test indicati, con contesti fino a 16 mila token. La capacità massima di contesto, 256 mila token, non implica che la latenza resti invariata a quella lunghezza.
Google parla anche di un costo quasi cinque volte inferiore a Gemini 3.5 Flash-Lite con Interactions API sui carichi utilizzati nel proprio confronto. Si tratta di misure del produttore: non dimostrano che Gemini Decision 1 sia il modello decisionale più accurato o veloce in ogni applicazione aziendale. Le architetture, le regioni di elaborazione e la formulazione delle domande influiscono sui risultati.
Una valutazione esterna utile è quella pubblicata in ottobre da Arize, società specializzata nella valutazione dei sistemi AI. Ha messo alla prova otto modelli precedenti a Gemini Decision 1 su 2.675 casi di rilevazione delle allucinazioni in RAGTruth, 655 casi di valutazione raccolti nelle suite Phoenix e 52 decisioni di instradamento di agenti.
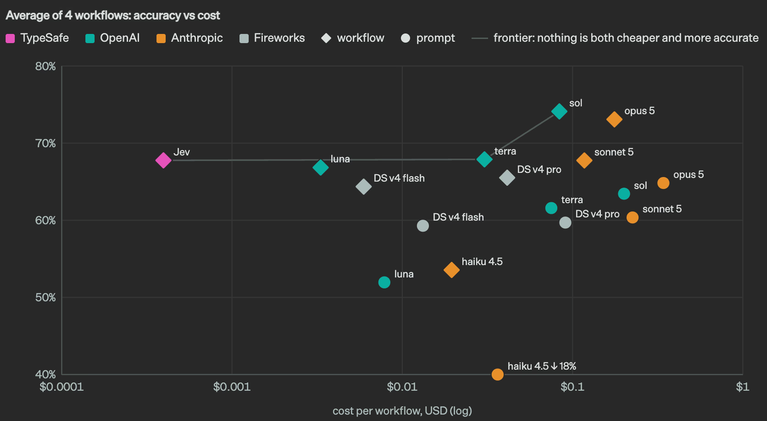
Sul primo compito Jev 1.13 ha raggiunto l’85,5% di accuratezza bilanciata, Clef l’85,2%, Liquid d1 l’84,8% e OpenAI Decisions l’81,5%, con intervalli di confidenza che impediscono classifiche troppo nette fra i primi modelli.
La stessa prova ha rivelato un limite che il solo prezzo non cattura: alcuni modelli cambiavano radicalmente risposta quando una domanda veniva formulata al contrario. Chiedere se tutte le affermazioni sono sostenute dalle fonti oppure se esiste un’affermazione non supportata dovrebbe produrre giudizi coerenti. Per Liquid d1, nel test di Arize, l’AUC è passata da 0,92 a 0,17.
Jev, Clef e OpenAI hanno invece mantenuto risultati vicini. Google non era incluso in questa prova, e occorre testarlo sullo stesso materiale prima di attribuirgli un vantaggio comparabile. Jim Bennett, autore dell’analisi Arize, sintetizza la precauzione: “Mettete alla prova la domanda con lo stesso rigore con cui valutate il modello”.
Le applicazioni già usate da Google e quelle possibili nelle imprese italiane
Google segnala alcune applicazioni interne. In Gemini Notebook l’API indirizza le richieste verso il livello di modello e di ragionamento ritenuto più adatto; l’azienda indica riduzioni della latenza fino al 40% per le richieste quotidiane esaminate. In altri progetti il modello seleziona reazioni grafiche e controlla comportamenti sospetti nell’uso di strumenti software. Sono casi dichiarati da Google, senza dati pubblici sufficienti a ricostruire una misurazione indipendente di accuratezza e costi.
Nelle aziende italiane gli impieghi più immediati sono il triage di ticket, la classificazione di fatture e documenti, il controllo preliminare di pratiche, la scelta fra strumenti di un agente e la selezione di richieste da inviare a un operatore. Il modello può riconoscere che un dato manca o che un documento richiede attenzione; calcoli esatti, confronto di date e applicazione di una regola contrattuale deterministica restano preferibilmente affidati al normale codice applicativo. L’automazione va provata anche su testi italiani, documenti poco leggibili e casi fuori distribuzione.
Per dati aziendali riservati serve una verifica preventiva del trattamento. La documentazione Google sui livelli gratuito e a pagamento dell’API distingue l’uso dei contenuti per migliorare i prodotti, previsto nel livello gratuito e non in quello a pagamento secondo le condizioni pubblicate.
Poiché l’integrazione in Google Cloud deve ancora arrivare, le imprese europee devono verificare regione di elaborazione, accordi e requisiti di residenza dei dati per il servizio effettivamente disponibile, anziché estendere automaticamente a questa API le caratteristiche di altri prodotti cloud.
Quando la probabilità diventa una decisione che riguarda una persona
Smistare un ticket interno comporta rischi diversi dal rifiutare automaticamente un finanziamento o una polizza. Per le decisioni individuali basate esclusivamente su trattamenti automatizzati, che producono effetti giuridici o incidono analogamente in modo significativo, l’articolo 22 del GDPR prevede una disciplina specifica, con eccezioni e garanzie. Una probabilità alta non autorizza da sola una scelta automatica se il procedimento ricade in quelle condizioni.
La Corte di giustizia dell’Unione europea, nel caso SCHUFA del 2023, ha chiarito che anche il calcolo automatizzato di un punteggio di solvibilità può rientrare nell’articolo 22 quando condiziona in modo determinante una decisione successiva sul credito. È un precedente rilevante per chi usa punteggi probabilistici nell’erogazione di servizi: se il software trasforma il voto del modello in un esito per la persona, la presenza di un passaggio formale a valle non basta, da sola, a escludere le garanzie previste dal GDPR.
Per valutare Gemini Decision 1 in un processo aziendale occorre quindi raccogliere casi già risolti e verificati da esperti, misurare separatamente falsi positivi e falsi negativi, testare le formulazioni delle domande e i documenti in italiano, definire le soglie di rinvio a un operatore e registrare le decisioni.
Il costo dell’API va letto insieme al costo degli errori e delle revisioni: un classificatore economico che manda troppe pratiche nella coda sbagliata può costare più di un modello meno rapido ma meglio calibrato sul lavoro dell’azienda.



Partecipa alla community