


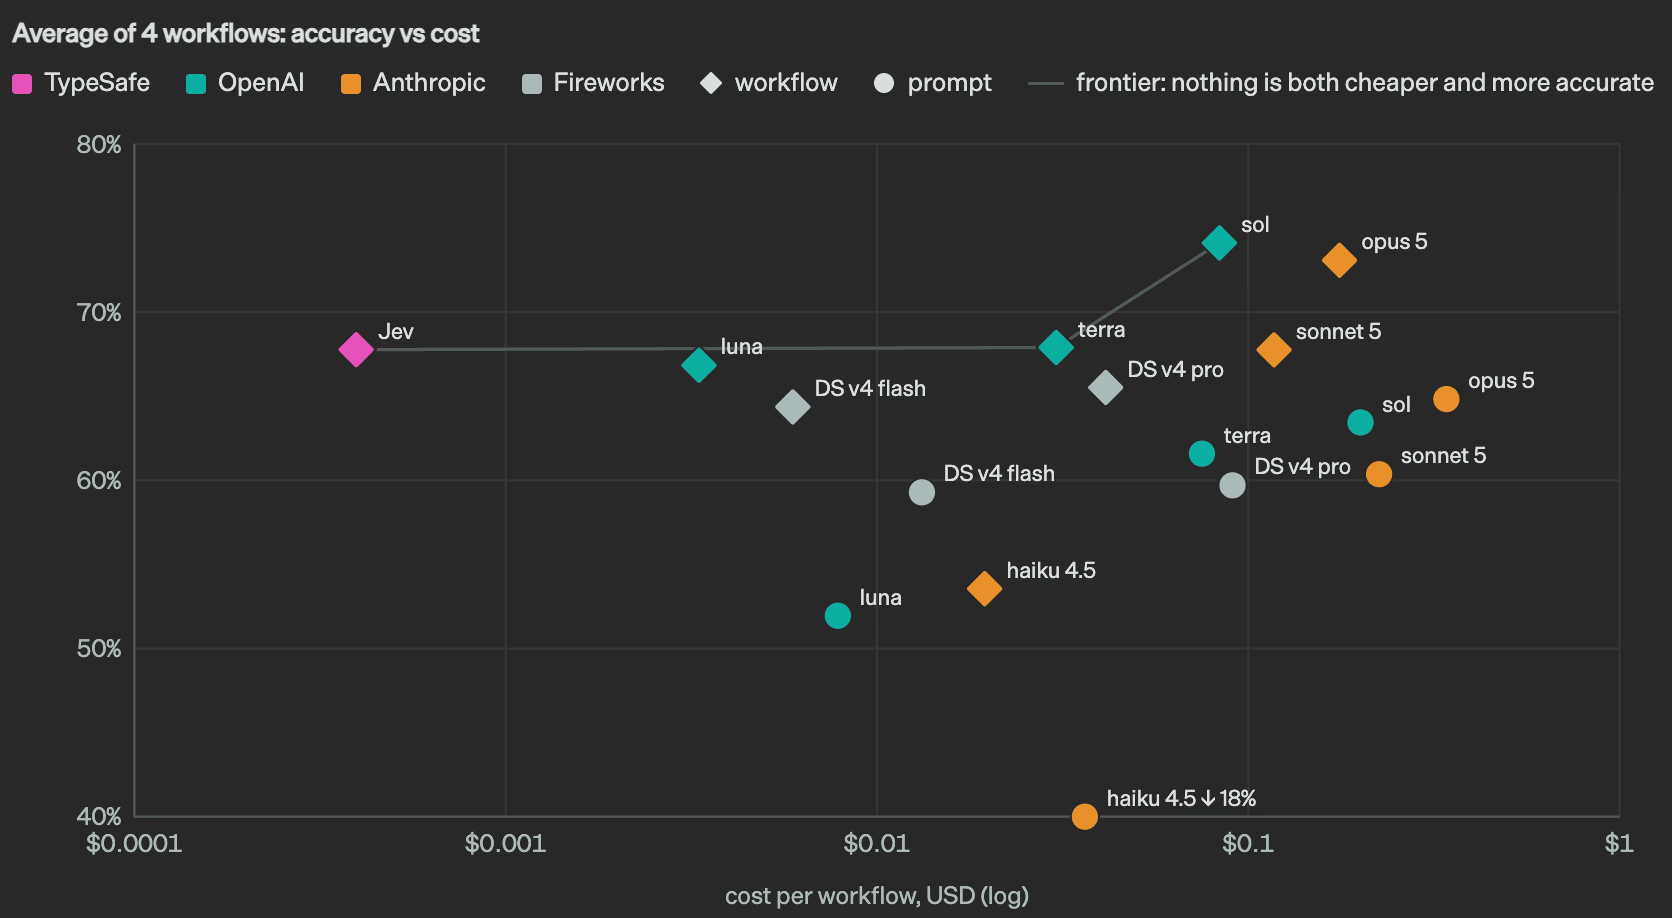
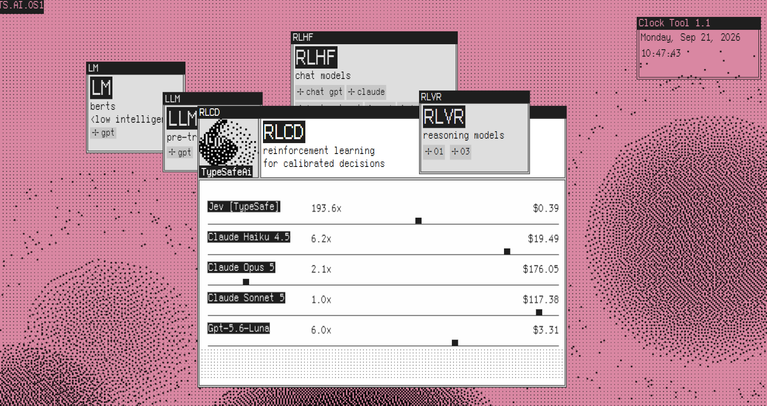
Una richiesta di assistenza entra nel sistema di ticketing e, prima che una persona la legga, il software deve già sapere se è urgente, a quale reparto va e quanto è grave, microdecisioni che molte aziende affidano oggi a un modello linguistico interrogato più volte, con una frase da interpretare a ogni passaggio. Dal 15 settembre, giorno in cui la startup TypeSafe ha presentato Jev, quelle risposte possono arrivare come numeri, in poche centinaia di millisecondi e a un costo che si misura in centesimi per milione di token, cioè per milioni di frammenti di testo letti dal modello.
In poco più di tre settimane la formula è stata ripresa da Cloudflare, da AWS e da Perplexity, poi da OpenAI e da Microsoft, e i decision model, modelli costruiti per scegliere tra risposte ammesse invece di generare frasi, sono diventati una categoria. Ai4business ha già raccontato Jev nel funzionamento e nei costi; quello che la categoria porta dentro le aziende riguarda l’organizzazione più della tecnologia, perché trasforma la fiducia di un modello in una soglia numerica, e una soglia numerica dentro un processo è una regola che qualcuno deve scrivere, firmare e rivedere.
Indice degli argomenti:
Sei decision model in ventiquattro giorni
TypeSafe è guidata da Diogo Almeida, che secondo l’azienda ha lavorato in OpenAI sui metodi di addestramento con feedback umano da cui è nato ChatGPT, e ha chiamato la propria famiglia System One Models, con un rimando esplicito al pensiero veloce descritto da Daniel Kahneman: ai grandi modelli linguistici il ragionamento lento e costoso, ai decision model le migliaia di scelte rapide che un software compie ogni ora.
Il nome Jev viene da William Stanley Jevons, l’economista che nell’Ottocento osservò come l’efficienza nell’uso di una risorsa finisca per farne crescere il consumo, e la citazione dice molto sulle ambizioni del prodotto.
Il 1° ottobre Cloudflare ha pubblicato Clef e Clef-flash, con pesi scaricabili sotto licenza Apache 2.0 e piena compatibilità con l’interfaccia di Jev, al punto che si possono sostituire l’uno all’altro senza riscrivere l’applicazione. Sotto c’è un dettaglio tecnico che spiega la velocità del contagio: Clef poggia su un modello Qwen da 27 miliardi di parametri tenuto congelato, cui Cloudflare ha aggiunto un piccolo strato addestrato a valutare le alternative invece di scrivere testo, e lo stesso schema, ridotto a 1,9 miliardi di parametri, è alla base di Strands Decider, rilasciato negli stessi giorni da Strands Labs, l’incubatore legato ad AWS.
Perplexity ha messo in rete pplx-decider con pesi aperti, e il 6 ottobre OpenAI ha aperto in beta pubblica la Decisions API, basata su GPT-6 Luna, e tre giorni dopo è arrivata Microsoft.
Venerdì 9 ottobre Satya Nadella ha presentato Microsoft-Decision-1, post-addestrato a partire da Qwen3.5 da 9 miliardi di parametri, disponibile su Foundry e OpenRouter e destinato, secondo l’azienda, a essere ricostruito su modelli propri e di OpenAI; lo stesso giorno a16z ha annunciato un investimento in TypeSafe.
Il lancio di Microsoft porta anche i primi casi d’uso interni dichiarati: Xbox Research lo ha usato per ricondurre oltre 10.000 commenti aperti a temi prestabiliti, con una qualità paragonabile a GPT-6 Sol a un costo duecento volte inferiore, e il team di Copilot per il controllo di qualità delle risposte dei propri agenti.
Ventiquattro giorni separano l’annuncio di Jev da quello di Redmond, e quando un’idea viene ripresa da Cloudflare e da AWS e adottata da OpenAI e Microsoft nello stesso mese, smette di essere la scommessa di una startup e diventa un componente dello stack, l’insieme di strumenti con cui si costruiscono gli agenti.
Tre primitive e l’output a costo zero
Al modello si passa uno stato, ossia il contenuto da valutare (un ticket, una transazione, l’esito di un passaggio di un agente), insieme a domande che hanno risposte ammesse. TypeSafe ha definito tre primitive che gli altri hanno adottato quasi senza variazioni:
- Choice sceglie una opzione da un insieme,
- Score colloca il caso su una scala ordinata,
- Noul restituisce la probabilità che un’affermazione sia vera.
Le domande vengono valutate in parallelo e la risposta arriva come struttura dati, pronta per un’istruzione condizionale del software, senza che nessuno debba estrarre il significato da una frase.
Mancando la generazione parola per parola, sparisce anche il costo dei token in uscita, ed è qui che i listini si fanno aggressivi: per milione di token in ingresso Jev costa 0,042 dollari, quanto Microsoft-Decision-1, Clef-flash 0,038 e Clef 0,24 su Workers AI, la Decisions API di OpenAI 0,10, mentre il modello di Perplexity compare su OpenRouter a 0,02.
A questi prezzi il paradosso di Jevons diventa una previsione di consumo, perché ogni passaggio che prima non valeva una chiamata a un modello linguistico ora la vale.
Sulle latenze, il tempo che passa tra domanda e risposta, i numeri dipendono da chi misura. TypeSafe dichiara tra 70 e 500 millisecondi, Microsoft una latenza mediana 35 volte inferiore a quella di GPT-6 Sol, Cloudflare nel proprio blog registra mediane di 209 millisecondi per Clef, 38,8 per Clef-flash e 524 per Jev, e nello stesso confronto Jev resta davanti soltanto su due benchmark, When2Call e BRIGHT. Sono misure di un concorrente su un indice costruito dal concorrente, buone per gli ordini di grandezza e poco altro.
La promessa più citata, un modello che non può allucinare, va letta nel senso ristretto che la stessa TypeSafe le attribuisce: Jev non può inventare una quarta risposta quando ne sono ammesse tre né produrre un formato sbagliato, ma può scegliere con sicurezza la risposta errata. Lo schema rigido elimina l’errore di forma e lascia intatto l’errore di merito, che per un’azienda è quello che costa.
La fascia tra 0,70 e 0,95 spetta al business
Una probabilità, da sola, non decide niente. Diventa utile quando sceglie un percorso. Lo schema che circola tra chi sperimenta questi modelli è a tre fasce: sopra 0,95 il software agisce da solo, tra 0,70 e 0,95 passa il caso a un modello linguistico più capace e più costoso, sotto 0,70 lo consegna a una persona. I valori sono esempi, e sceglierli spetta a chi risponde del processo prima che a chi scrive il codice, perché ogni spostamento cambia costi, tempi di risposta e responsabilità.
In un servizio clienti un falso allarme costa qualche minuto a un operatore, in un controllo antiriciclaggio una transazione sospetta lasciata passare costa una segnalazione mancata, e la stessa soglia di 0,95 produce nei due casi rischi che non hanno nulla in comune. Alzarla manda più casi alle persone e fa pagare più ore, abbassarla automatizza di più e lascia passare più errori non visti, e nessuna delle due scelte si fa bene senza conoscere il costo di ciascun tipo di errore, un dato che sta nei conti dell’azienda e non nei benchmark del fornitore.
Ne discendono conseguenze organizzative semplici da enunciare e rare da trovare applicate. La soglia ha un proprietario, che per buon senso è il responsabile del processo; cambiarla equivale a cambiare una procedura, quindi va versionata e approvata come una procedura; e poiché la distribuzione dei casi in ingresso si sposta nel tempo, anche la quota di decisioni che finisce in ciascuna fascia va controllata a scadenze fisse.
Chi lavora sulla supervisione umana che l’AI Act richiede per i sistemi ad alto rischio riconoscerà nella fascia tra 0,70 e 0,95 il punto esatto in cui quella supervisione si progetta, oppure si perde in un file di configurazione.
Calibrazione da rifare dopo i test di Arize
Tutto lo schema poggia su una proprietà, la calibrazione: un modello è calibrato quando, dichiarandosi sicuro al 90%, ha ragione circa nove volte su dieci. TypeSafe la persegue con un metodo di post-addestramento che chiama RLCD, apprendimento per rinforzo orientato a decisioni calibrate, ripreso anche da Cloudflare, e le prime verifiche esterne, arrivate a meno di un mese dal lancio, dicono che la proprietà va misurata caso per caso.
Arize, società che vende strumenti di valutazione ma non questi modelli, ha confrontato otto modelli su un compito di rilevazione delle allucinazioni: Jev e Clef sono appaiati intorno all’85% di accuratezza bilanciata, la Decisions API si ferma all’81,5% e Strands Decider al 69%, con Jev che ottiene l’errore di calibrazione più basso. Lo stesso test mostra quanto poco basti a rovesciare i risultati, perché una domanda formulata al contrario (chiedere se una risposta è fedele alla fonte invece che se è inventata) può invertire il giudizio senza che nulla segnali il problema.
L’8 ottobre un gruppo di ricercatori ha pubblicato su arXiv TypedBench, dove il modello ospitato di TypeSafe risulta sistematicamente sottostimato nella fiducia che dichiara e sensibile alla formulazione delle domande, al punto che usarne le probabilità quando i costi degli errori sono asimmetrici può dare risultati peggiori del prendere semplicemente la risposta più probabile.
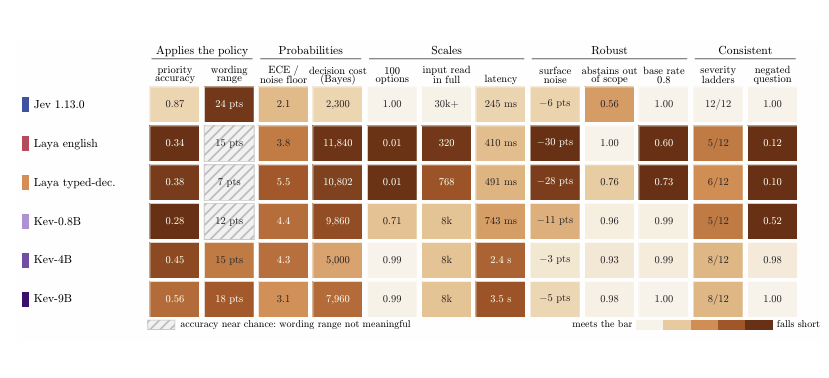
Microsoft, dal canto suo, dichiara che il proprio modello cambia decisione solo sull’1,3% degli input alterati e mai quando la domanda viene riformulata o le opzioni riordinate, un dato del produttore che va proprio nella direzione delle verifiche di Arize e che merita la stessa prova sul campo. Uno sviluppatore che ha fatto girare 9.081 decisioni di abbinamento prodotti spendendo 32 centesimi ha trovato una calibrazione debole, con errori commessi quasi sempre ad alta confidenza.
Le misure divergono perché i compiti divergono, e per chi deve adottare questi strumenti la conseguenza è pratica: la calibrazione dichiarata dal fornitore vale sul suo indice, quella utile si misura su qualche centinaio di casi del proprio processo, etichettati da chi lo conosce, prima di fissare qualunque soglia.
Jevons e le migliaia di soglie in arrivo
Il lavoro preparatorio non richiede tecnologia. Richiede carta e un responsabile di processo. Si prende un processo e si scrive ogni punto in cui qualcuno, o qualcosa, sceglie tra alternative definite, annotando le risposte ammesse, il costo di un errore e la possibilità di tornare indietro; le microdecisioni frequenti, reversibili e con risposte chiuse sono le candidate naturali, mentre quelle rare, irreversibili o che richiedono di motivare la scelta davanti a un cliente restano a un modello generativo o a una persona.
La stessa mappa serve a una domanda che molte aziende non si sono mai poste in modo esplicito: cioè chi ha il diritto di decidere cosa dentro un processo. Per ogni scelta conviene scrivere chi la prende oggi, con quali informazioni, chi ne risponde se va male e quanta autonomia si è disposti a concedere a un software: quando il documento esiste, introdurre un decision model significa spostare una riga della mappa, con una firma accanto; quando non esiste, la soglia di confidenza finisce per decidere al posto di un’organizzazione che non ha mai stabilito chi doveva farlo.
Su ciascuna candidata si costruisce un campione etichettato, si misurano accuratezza e calibrazione sui propri dati, si fissano le soglie con il responsabile del processo e si decide come monitorare la quota di casi che cade in ogni fascia. La compatibilità d’interfaccia tra Jev, Clef e Strands Decider, insieme alla concorrenza di OpenAI e Microsoft, lascia aperta la scelta del fornitore, e i pesi aperti permettono di far girare il modello sui propri server quando i dati non possono uscire, un’opzione che pesa per le aziende europee alle prese con la residenza dei dati e con i fornitori extra UE.
Jevons osservava che le macchine a vapore più efficienti non riducevano il carbone bruciato in Inghilterra, lo moltiplicavano. Con decisioni che costano qualche millesimo di centesimo le scelte automatizzate dentro un’azienda passeranno da decine a migliaia per processo, e ciascuna porterà con sé una soglia, una piccola regola aziendale scritta in un file di configurazione e letta ogni giorno da un software, che merita lo stesso posto delle altre procedure: nel registro, con un nome accanto e una data di revisione.



Partecipa alla community