


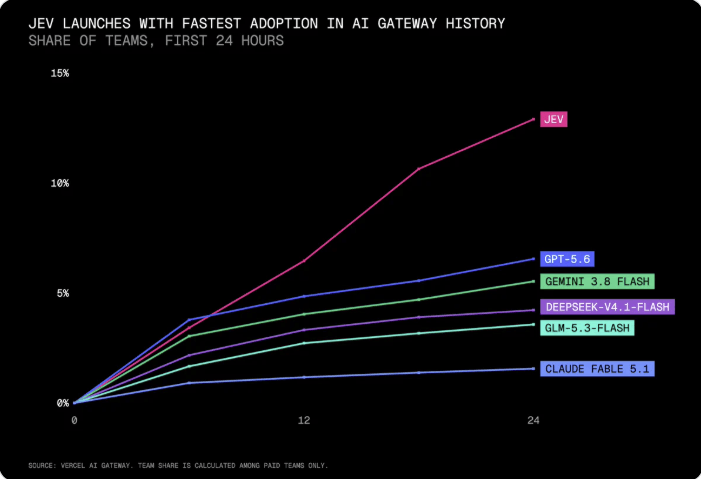
Un modello che non scrive nemmeno una parola ha raggiunto il 13% dei team paganti dell’AI Gateway di Vercel, il servizio che instrada verso i modelli le chiamate delle applicazioni, nelle prime ventiquattro ore, più del doppio della quota toccata al debutto dalla famiglia GPT-5.6, e in tre giorni è stato integrato da Cloudflare, LangChain e Langfuse. Si chiama Jev, è in accesso anticipato dal 15 settembre, e la domanda ha costretto TypeSafe AI a sospendere l’API per qualche ora.
Riceve un contesto e un elenco di domande chiuse, restituisce numeri, e a decidere resta il software che lo ha interrogato.
TypeSafe chiama questa famiglia System One model, dalla distinzione di Daniel Kahneman fra il pensiero veloce e automatico e quello lento e deliberato.
Chi lo ha costruito conosce bene il problema che dice di voler risolvere. Diogo Almeida ha passato quattro anni a OpenAI sul lavoro diventato InstructGPT e poi ChatGPT, ed è accreditato come co-inventore di RLHF, l’apprendimento per rinforzo da feedback umano che ha reso conversabili i modelli di linguaggio. Due anni fa se n’è andato. «Abbiamo un fulmine in bottiglia, e non è utile», ha raccontato a TechCrunch, «il problema è che stiamo ottimizzando per il linguaggio umano, e per l’automazione non serve, perché i computer parlano una lingua diversa».
Il seed è di 40 milioni di dollari guidato da DCVC, su una valutazione riportata di 200 milioni, e il modello costa 0,042 dollari per milione di token in ingresso, le unità minime in cui il testo viene spezzato, senza far pagare nulla sui token in uscita.
Indice degli argomenti:
Choice, Score, Noul: i tre primitivi
Il contratto di Jev sta in due parole: stato e domande. Si invia uno stato, cioè il contesto grezzo su cui decidere, un ticket di supporto o il testo di una fattura, e insieme un elenco di domande tipizzate, ognuna con le risposte ammesse dichiarate in anticipo. Tornano valori tipizzati e distribuzioni di probabilità, senza prosa e senza JSON da validare a valle.
Le domande possibili sono tre. Una Choice sceglie un’opzione dentro un insieme fornito dal chiamante, fino a 255, e restituisce l’opzione, la probabilità di ciascuna alternativa e un valore di confidence. Uno Score colloca lo stato su una scala ordinata di livelli descritti a parole, un Noul, crasi di no e null, restituisce la probabilità che un’affermazione sia vera.
I tre tipi si mescolano in una sola chiamata, e ogni domanda viene valutata in parallelo e in isolamento contro lo stesso stato, tanto che aggiungerne altre cambia poco il tempo di risposta. La documentazione lo scrive senza giri di parole: i modelli di linguaggio sono progettati per produrre testo che una persona legge, e quando serve un giudizio che il codice dovrà consumare quella progettazione diventa un disallineamento.
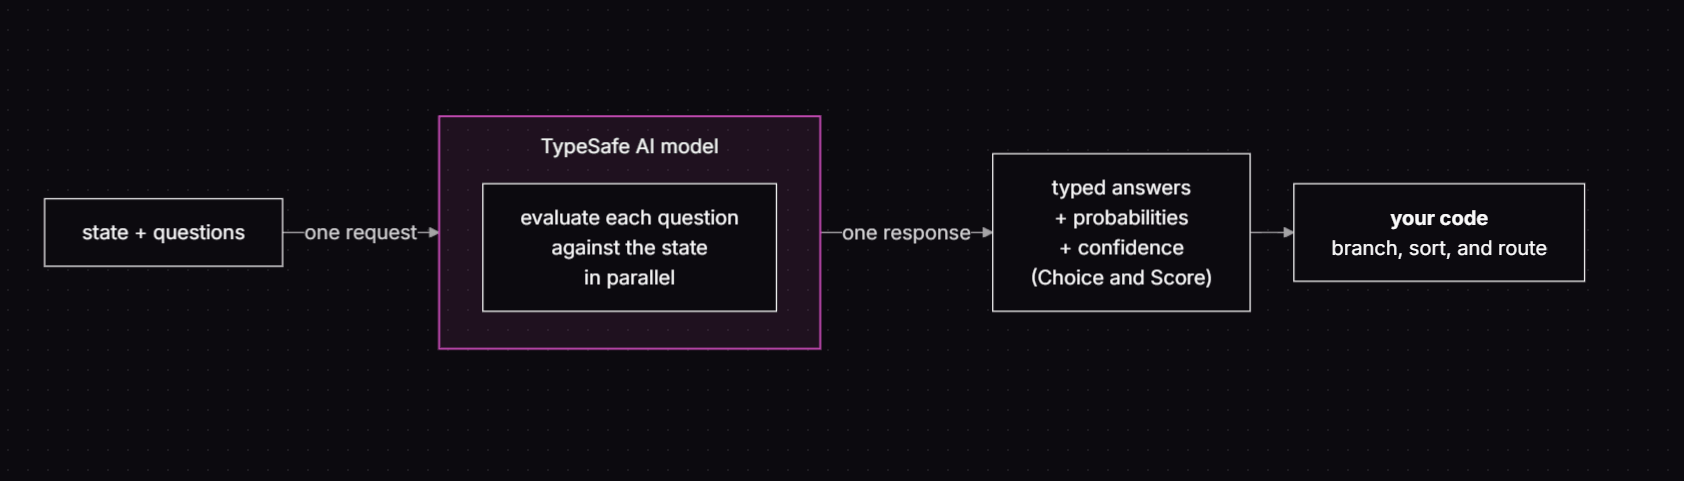
In pratica: dove oggi si chiede a un modello «leggi questo ticket e dimmi a chi va assegnato, e se è urgente», il codice passa il ticket una volta sola e riceve indietro due distribuzioni di probabilità separate, una sulla coda di destinazione e una sull’urgenza, su cui ramificare come farebbe con un normale if.
Da qui un modo di lavorare diverso, con domande atomiche e composizione lasciata al codice: al posto di «valuta questo pitch», tre domande separate su mercato, fattibilità e differenziazione, ricombinate con una formula nel repository, dove al cambiare delle priorità si modifica un coefficiente invece di riscrivere un prompt.
Archer Hume ha sondato Jev 10 mila volte
TypeSafe non ha pubblicato né un paper né i pesi, e sull’architettura Almeida risponde che per ora i dettagli restano riservati. Il vuoto lo ha riempito un ricercatore indipendente australiano, Archer Hume, con una ricostruzione basata su circa diecimila chiamate all’API e pubblicata insieme ai dati grezzi.
Il quadro che ne esce è un transformer causale riadattato, cioè la stessa architettura dei modelli di linguaggio privata della parte che scrive: lo stato viene codificato una volta sola, ogni domanda costruisce la propria rappresentazione in un ramo separato senza vedere le altre, e un readout numerico trasforma il vettore finale in probabilità sulle sole opzioni ammesse. Il parallelismo è la parte che i commenti sui social sbagliano più spesso. L’attenzione causale descrive quali posizioni possono leggere quali informazioni, non l’ordine in cui i token vanno eseguiti: durante il prefill, la fase in cui il modello elabora tutto l’input prima di produrre qualcosa, le posizioni sono già note e si calcolano insieme.
Chi finisce dopo il prefill e il readout non paga mai la dipendenza sequenziale del decoding, dove ogni token esiste soltanto dopo che il precedente è stato scelto.
L’economia segue dalla geometria. Chiamate separate rielaborerebbero lo stato una volta per ogni domanda, mentre condividendo la memoria intermedia che il transformer conserva sui token già processati lo stato si paga una volta sola: Hume misura 30 mila token in 160 millisecondi e 1.500 domande risolte, in un’unica richiesta, in qualche centinaio di millisecondi. Un codice segreto nascosto dentro una domanda e chiesto a un’altra resta a probabilità 0,00, mentre spostato nello stato condiviso sale a 0,90.
Un dettaglio il marketing lo lascia in ombra. Jev è un transformer, e l’84,6% che ottiene su MMLU-Pro, il test di conoscenza generale con cui si confrontano i modelli, richiede un preaddestramento di scala frontier: la formula «non è un LLM» descrive l’interfaccia e l’ultimo strato, mentre la conoscenza del mondo arriva esattamente da dove arriva quella di un modello di linguaggio.
RLCD al posto di RLHF
Il metodo di addestramento si chiama Reinforcement Learning for Calibrated Decisions. Nella presentazione TypeSafe lo mette in fila con i due che lo precedono: RLHF ottimizza per la preferenza umana, RLVR per output verificabili in automatico come un test che passa, RLCD per decisioni accompagnate da probabilità epistemicamente oneste.
L’accusa che Almeida muove al proprio lavoro precedente è circostanziata: la preferenza umana premia la sicurezza apparente. Un sistema che sbaglia il 5% delle volte e non sa dire quando si trova dentro quel 5% non automatizza nulla, perché ogni risposta arriva con lo stesso tono di certezza.
La calibrazione dovrebbe rimediare. Un modello calibrato, quando assegna 0,8 a una classe di casi, ci azzecca circa l’80% delle volte, e la proprietà riguarda gruppi di previsioni, non la singola risposta. Sui 1.200 item di MMLU raccolti da Hume l’expected calibration error, cioè la distanza media fra probabilità dichiarata e frequenza osservata, si ferma a 0,031.
Il resto della tabella invita però alla cautela: 990 delle 1.200 previsioni stanno nell’intervallo più alto, e su una famiglia di problemi generati da zero, l’esponenziazione modulare, il modello è corretto il 56% delle volte dichiarando in media il 35%.
Niente di tutto questo è nuovo sul piano statistico: le regole di scoring proprie formalizzate da Gneiting e Raftery nel 2007, cioè i criteri con cui si premia una previsione espressa in probabilità, dicono già che chi vuole minimizzare la penalità attesa ha convenienza a dichiarare la distribuzione vera, e il lavoro di Guo del 2017 aveva mostrato quanto le reti neurali moderne siano mal calibrate. RLCD è un’etichetta nuova su un apparato vecchio e solido, portato per la prima volta dentro un prodotto.
C’è un aspetto che quasi tutti i commenti stanno leggendo male, e riguarda il campo chiamato confidence. Quel numero non stima la probabilità che la risposta sia corretta: l’adapter ufficiale in Python lo calcola come distanza della probabilità di punta da una distribuzione uniforme, secondo la formula c = (pmax − 1/K) / (1 − 1/K), così con tre opzioni e una probabilità massima di 0,80 la confidence vale 0,70. Misura quanto la risposta in testa stacca le altre, e una distribuzione molto concentrata può essere concentrata sulla risposta sbagliata.
238 volte meno di Claude Fable 5.1
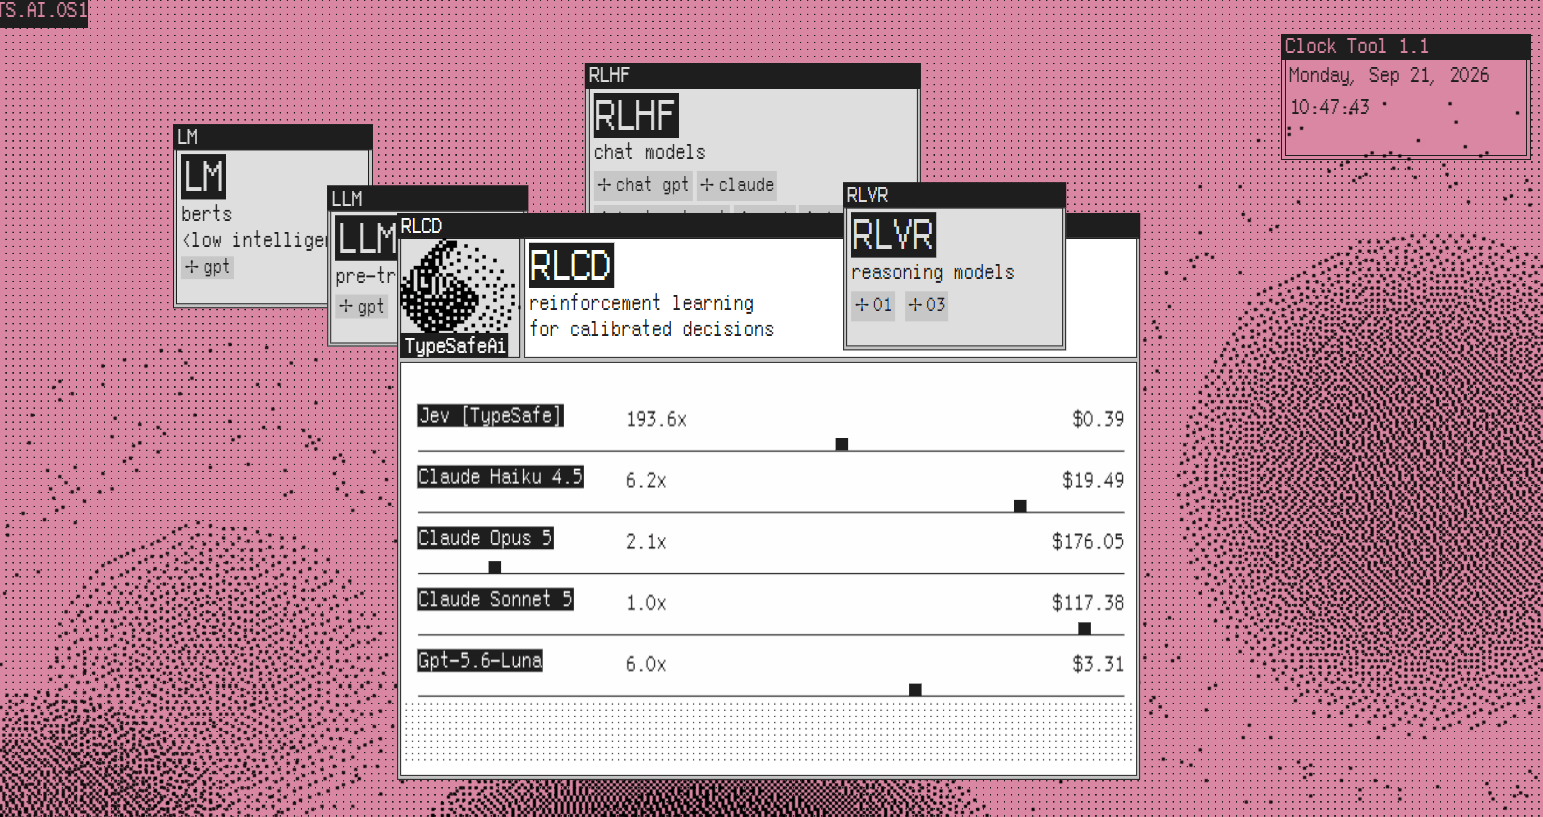
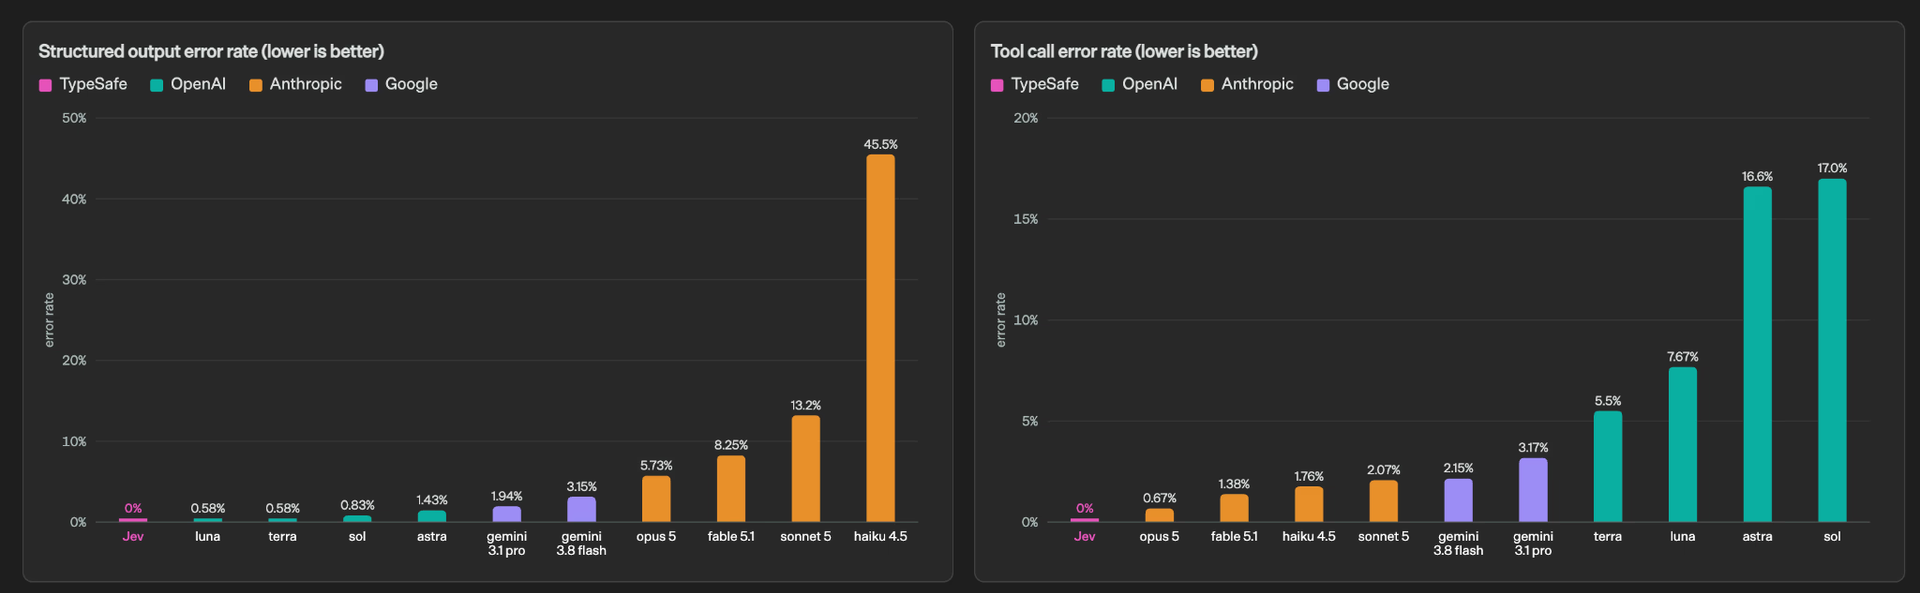
Il listino è di quelli che si rileggono: 42 dollari per miliardo di token in ingresso, zero su quelli in uscita, che TypeSafe definisce troppo economici per essere misurati. Il motivo è meccanico più che promozionale, visto che senza decoding autoregressivo non esistono token da contare in uscita. Claude Fable 5.1 parte da 10 dollari per milione in ingresso, e il rapporto arriva a 238 a uno. La latenza dichiarata va da 70 a 500 millisecondi, contro i 3-329 secondi che TypeSafe attribuisce alle chiamate ai modelli di frontiera.
Le cifre di punta del fornitore, 193,6 volte più veloce e 444,6 volte più economico, arrivano dalle sue quattro workflow interne e stanno, ammette l’azienda, sul limite alto di quello che un utente dovrebbe aspettarsi. La verifica esterna finora è una sola, di Every: 777 giudizi su 37 documenti in meno di sette decimi di secondo per circa un quarto di centesimo, con una mediana di 0,35 secondi per passaggio contro gli 8,83 di Fable 5.1 ad alto sforzo. Un ingegnere di Vercel, sostituendo con Jev il classificatore che valutava la pericolosità dei comandi, ha guadagnato da 5 a 18 volte in velocità e un po’ di precisione.
Il nome del modello è la tesi economica. Jev viene da William Stanley Jevons, l’economista che nell’Ottocento osservò come le macchine a vapore più efficienti facessero aumentare il consumo di carbone invece di ridurlo, e Almeida se lo aspetta per l’intelligenza, con software intelligente sparso ovunque, «molto più simile ai primi tempi di internet che alle mega app che tutti cercano di costruire adesso». Un caso cambia più degli altri, la verifica di ogni singolo turno di un agente, chiedersi a ogni passo se la chiamata a uno strumento contraddice la precedente, cosa tecnicamente possibile da sempre ed economicamente assurda fino a ieri.
Il costo però non sparisce, si sposta. Chi adotta Jev deve disegnare il grafo delle decisioni, scrivere le etichette, fissare le soglie, valutare gli errori sui propri dati: sparisce l’overhead dei token, compare lavoro di ingegneria e di valutazione.
La pagina «jaggedness» di jev-1.13
Nella documentazione c’è una pagina che nessun laboratorio di frontiera pubblica in quella forma. Si intitola jaggedness, frastagliatura, elenca nove modi in cui jev-1.13 sbaglia e per ciascuno indica cosa fare al suo posto. Il modello legge in modo letterale e risponde alla domanda scritta, non a quella intesa. Non conta in modo affidabile, legge le date come testo invece che come quantità ordinate, perde accuratezza quando lo stato si riempie di dettagli irrilevanti, e un’istruzione iniettata dentro lo stato può spostargli la risposta.
Una categoria rompe le aspettative di chi arriva dalla programmazione. La stessa domanda posta come Noul e come Choice non produce numeri confrontabili: su un ticket ambiguo il Noul restituisce 0,22 mentre la Choice assegna 0,01 al sì, con confidence 0,97. Una domanda e la sua negazione, poste come due Noul, sommano 1,19. Le identità aritmetiche non valgono, e una soglia tarata su un primitivo non si trasporta sull’altro.
Gli esperimenti di Hume aggiungono due effetti da mettere in conto in qualunque valutazione seria. Invertire l’ordine delle opzioni ha spostato la probabilità di una classificazione di supporto tecnico da 0,84-0,89 a 0,93-0,96, con etichette ed evidenza identiche. Aggiungere a un insieme di quattro una quinta opzione palesemente irrilevante ha cambiato il rapporto di probabilità fra due opzioni preesistenti, in tutti e dieci i blocchi randomizzati: è la violazione di un assioma classico della teoria della scelta, per cui un’alternativa che nessuno prenderebbe non dovrebbe alterare le preferenze fra le altre.
Una soglia posta a 0,9 può quindi far scattare o non far scattare un’azione a seconda di come è ordinato l’elenco.
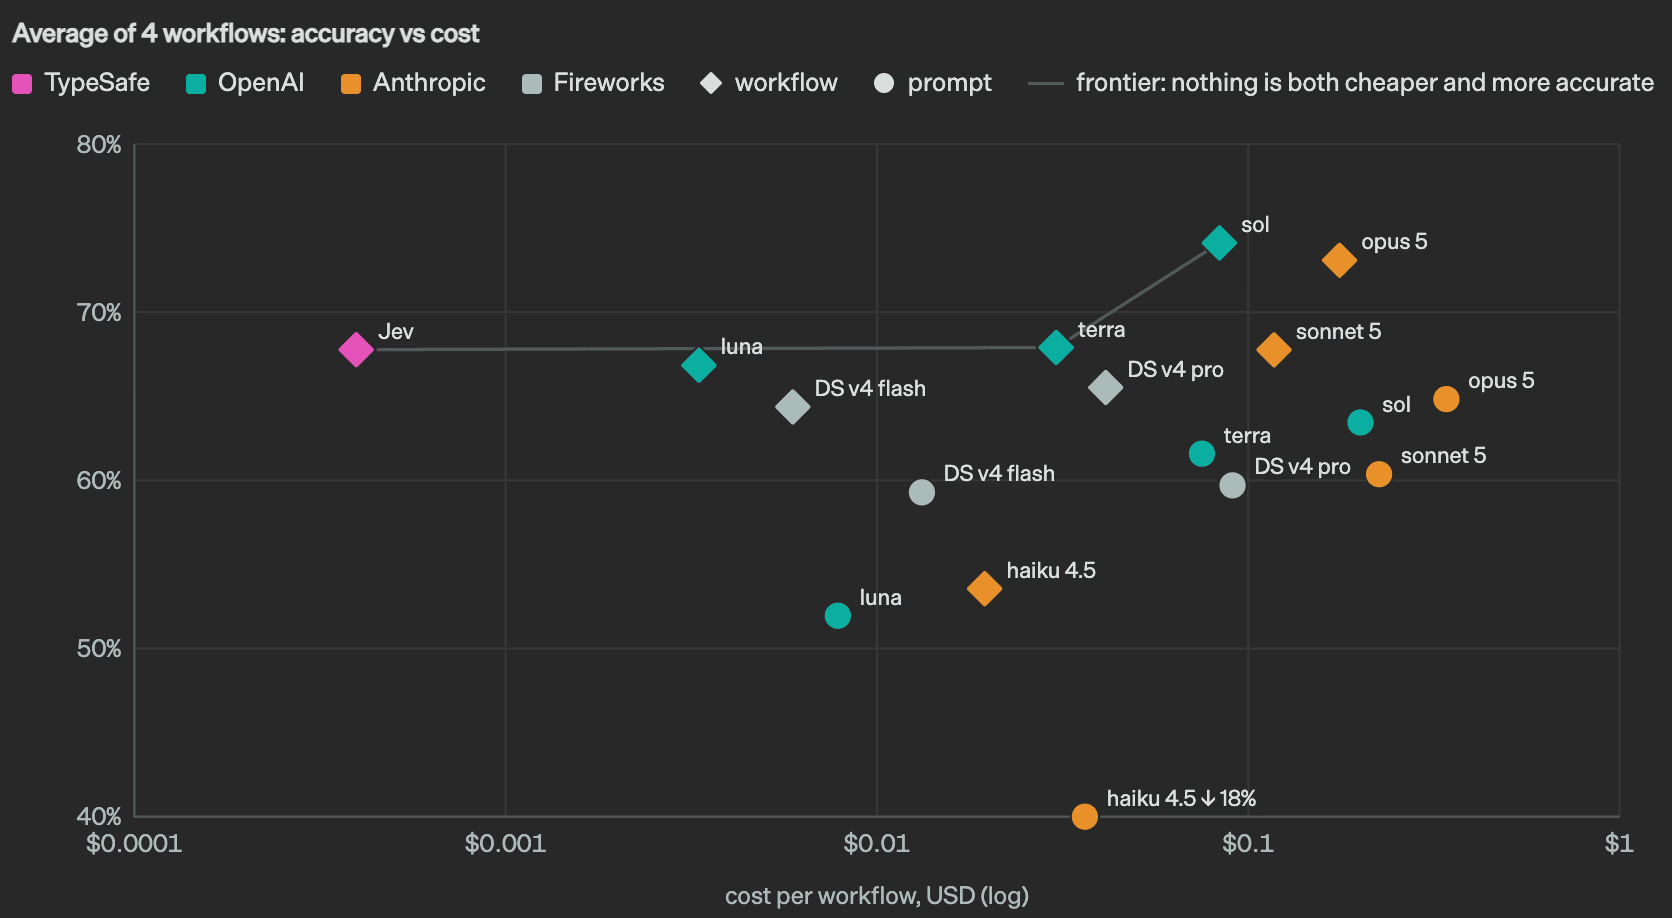
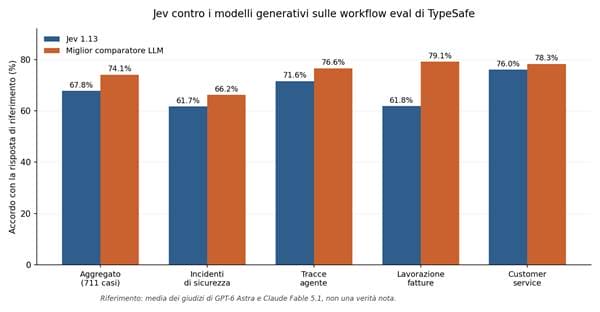
Sull’accuratezza il numero più utile lo pubblica TypeSafe stessa. Sulla sua dashboard, 711 casi su quattro workflow, Jev totalizza 67,8% contro il 74,1% del miglior comparatore, e sulla lavorazione fatture si ferma al 61,8% contro il 79,1% di Claude Opus 5. La risposta di riferimento, per costruzione, è la media dei giudizi di GPT-6 Astra e Claude Fable 5.1, quindi quella tabella misura l’accordo con altri modelli e non la correttezza rispetto a una verità nota. L’unico test indipendente pubblicato ha trovato sei difetti su sette piantati apposta in dodici passaggi, dove Fable 5.1 li ha trovati tutti.
L’espressione «zero allucinazioni» indica la garanzia di conformità allo schema, niente di più: una risposta valida sul piano del tipo può essere del tutto sbagliata nel merito, e Almeida lo ammette apertamente. Il modello resta in accesso anticipato dietro lista d’attesa, i limiti di frequenza cambiano senza preavviso, non ci sono clienti di produzione dichiarati, il contesto si ferma a 64 mila token e l’inglese è la lingua su cui l’accuratezza è migliore. La stessa pagina segnala che i compiti con più livelli di indirezione, quelli che Kahneman avrebbe chiamato di Sistema 2, restano fuori portata: il nome della categoria è già una dichiarazione di perimetro, e va preso sul serio.
Bespoke Nimble, SemIf e gli altri cloni
In due giorni dal lancio sono comparse sei riproduzioni aperte. Bespoke Labs ha rilasciato Nimble sotto licenza Apache 2.0 con dati, pesi e ricetta: un adattamento LoRA di Qwen3.5-9B, cioè un addestramento leggero che aggiorna una frazione minima dei parametri, su 2.676 esempi sintetici dove due casi differiscono per un solo fatto e la risposta si ribalta. Sul suo insieme di controllo Nimble ottiene 90,12% contro il 93,21% di Jev, mentre il modello di base non addestrato si ferma al 66,36%.
Laya monta 421 milioni di parametri su un encoder ModernBERT, una famiglia di modelli che legge il testo e ne costruisce una rappresentazione senza mai generarlo, mentre Kev-0.5B gira su un MacBook.
La domanda che circola da giorni, se Jev sia soltanto un classificatore rivestito, ha una risposta misurabile: un tentativo basato su un encoder ModernBERT da 151 milioni di parametri ha ottenuto 48,1% su 337 casi della suite pubblica di TypeSafe, dove Jev sta a 90,8%. La scala serve, e serve perché le etichette non vengono fissate in addestramento ma dichiarate a tempo di esecuzione dal chiamante, cosa che un classificatore allenato su una tassonomia chiusa non sa fare. Il compito in sé resta antico, con decenni di letteratura sulla classificazione con probabilità calibrate alle spalle.
Da qui esce il criterio pratico. Se le etichette sono stabili e i dati annotati esistono, un encoder addestrato sul proprio dominio resta più veloce, più economico, ospitabile in casa e verificabile riga per riga. Se le etichette cambiano a ogni chiamata, se la tassonomia vive nel codice applicativo e si modifica a ogni rilascio, allora un modello di questa classe fa qualcosa che nessun classificatore tradizionale fa.
Gli ambiti dove l’adozione regge si contano.
- Instradamento, cioè scegliere quale modello o quale gestore riceve una richiesta, decisione che con un modello generativo costa più di quello che risparmia.
- Barriere di sicurezza, dal tentativo di jailbreak, cioè di far aggirare al modello le proprie regole, al rischio di una chiamata a strumento valutato prima che venga eseguita, pattern che LangChain ha già impacchettato in un middleware, uno strato che si frappone fra l’agente e lo strumento.
- Riordino dei risultati di una ricerca, estrazione riformulata come scelta fra candidati che una regola di ricerca testuale ha già isolato, verifica di una citazione contro la fonte, feature probabilistiche per un modello supervisionato tradizionale.
Fuori restano il testo libero, il contesto lungo, l’aritmetica, le date e tutto ciò che richiede più salti di ragionamento.
Per un team europeo il calcolo si sposta ancora. Con un clone da 9 miliardi di parametri sotto licenza permissiva che gira su hardware proprio, residenza dei dati, vincolo a un’API non compatibile con lo standard di mercato e dipendenza da un fornitore in accesso anticipato diventano scelte, non condizioni.
Jevons non celebrava il carbone. Il suo argomento era che l’efficienza moltiplica il consumo invece di ridurlo, e la stessa aritmetica vale per le decisioni sbagliate: a duecento millisecondi l’una, dentro codice che nessuno rilegge, una decisione mal calibrata si moltiplica in silenzio. La curva di calibrazione sui propri dati, misurata sui casi ambigui invece che su quelli puliti, resta la prova che rende adottabile un modello di questa classe, e finora nessuno l’ha pubblicata.
A me interessa meno il destino industriale di TypeSafe e più quello che questo lancio rende visibile. L’architettura dominante degli ultimi tre anni fa passare qualunque decisione, anche un sì o un no dentro un ciclo di controllo, attraverso un modello che quella decisione la deve prima scrivere in una lingua umana, e nei sistemi che seguo il costo di quella scelta si vede sulla latenza e sull’imprevedibilità molto prima che sulla fattura di fine mese.
Il lavoro utile adesso è una mappa delle decisioni ricorrenti dentro i propri processi, che separi quelle riducibili a una scelta fra opzioni note, il Sistema 1 di un’organizzazione, da quelle che hanno bisogno di una frase scritta da qualcuno.
Su quella mappa si decide se serva un modello di questa classe, un classificatore addestrato in casa oppure niente di nuovo, e la mappa regge anche se fra sei mesi Jev sarà stato assorbito da un fornitore più grande o superato da un clone aperto.




Partecipa alla community