


Alibaba ha rilasciato Qwen4-Max, il nuovo modello AI proprietario della famiglia Qwen. La società dichiara 2,4 trilioni di parametri complessivi, 71 miliardi attivi per ogni token e una finestra di contesto da un milione di token. Il servizio è disponibile via API e combina input di testo, immagini e video con ricerca web, chiamate a strumenti e output strutturati.
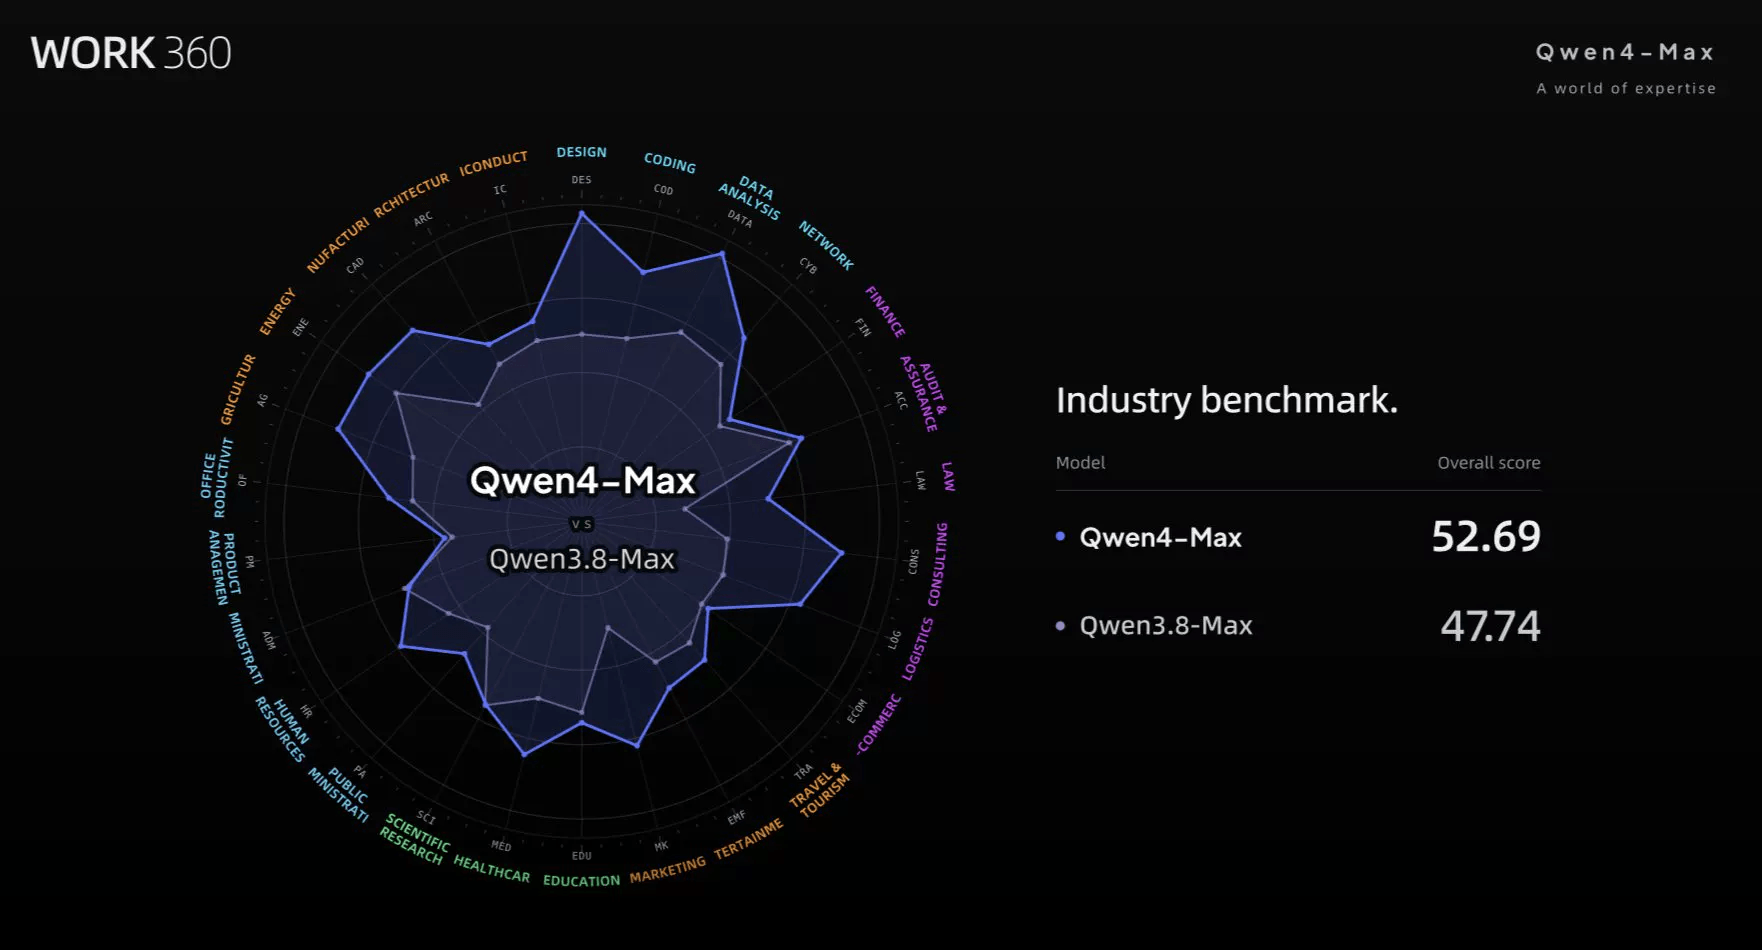
La presentazione punta soprattutto sull’efficienza: secondo Alibaba, nel benchmark interno Work360 il modello riduce del 60% il costo medio per attività rispetto a Qwen3.8-Max.
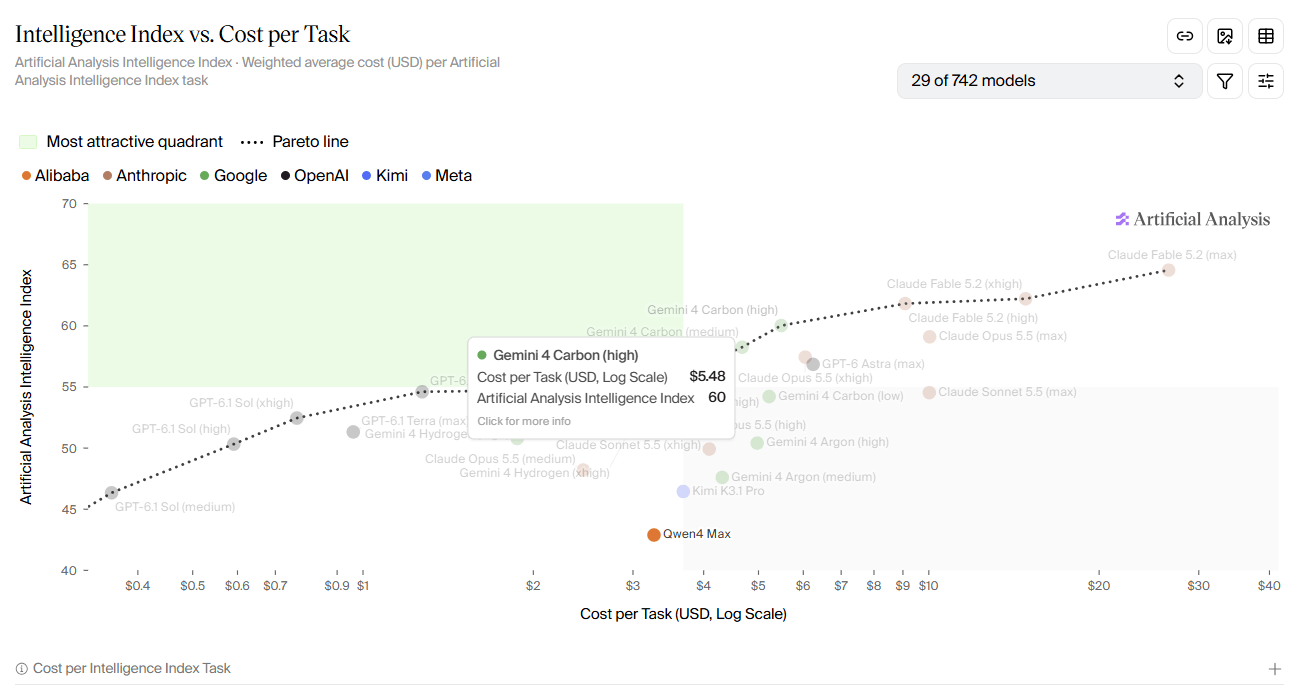
La valutazione indipendente di Artificial Analysis restituisce però un quadro più misurato: 43 punti nell’Intelligence Index, due sopra la mediana dei modelli di fascia di prezzo simile. Il salto riguarda quindi architettura e funzioni, mentre le prestazioni complessive restano da confrontare caso per caso.
Indice degli argomenti:
Un modello enorme, con una parte attiva più piccola
Qwen4-Max usa un’architettura Mixture of Experts (MoE): il modello contiene molti esperti specializzati, ma per generare ciascun token attiva soltanto una parte dei parametri. Alibaba indica 2,4 trilioni di parametri complessivi e 71 miliardi attivi per token, pari a circa il 3% della capacità totale. La società afferma che i parametri attivi sono il 25% in meno rispetto a Qwen3.8-Max, che ha la stessa dimensione complessiva.
Il dato aiuta a capire la tesi industriale di Alibaba: mantenere un modello molto capiente, riducendo il lavoro computazionale svolto a ogni passaggio. Il numero di parametri attivi, tuttavia, non basta da solo a prevedere latenza, costo reale o qualità. Questi risultati dipendono anche da hardware, servizio di inferenza, lunghezza delle richieste e quantità di ragionamento attivata.
I numeri sull’architettura restano inoltre dichiarazioni del produttore: Qwen4-Max è proprietario e i pesi non sono pubblici.
Un milione di token e strumenti per gli agenti
La finestra di contesto raggiunge un milione di token e consente di passare al modello grandi quantità di documenti, immagini e video in una singola interazione. La documentazione tecnica di Alibaba specifica un massimo di 991.808 token in ingresso in modalità senza ragionamento; quando il modello usa il thinking, il limite d’ingresso indicato scende a 983.616 token.
Un contesto ampio non implica quindi che l’intera finestra sia disponibile contemporaneamente per il prompt e per la risposta.
Qwen4-Max accetta testo, immagini e video e restituisce testo. L’API supporta ricerca web, function calling, chiamate parallele agli strumenti e formati strutturati come JSON Schema; gli sviluppatori possono accedere tramite interfacce compatibili con OpenAI e Anthropic. QwenCloud documenta anche strumenti quali interprete di codice, lettura di PDF e scraping web.
Queste funzioni permettono di concatenare recupero delle informazioni, analisi e produzione di un risultato, ma il modello rimane il componente che interpreta e genera: l’accesso a strumenti e dati dipende dalla configurazione dell’applicazione.
Qwen4-Max: funzioni e limiti documentati
| Funzione | Disponibilità dichiarata | Implicazione operativa |
|---|---|---|
| Testo, immagini e video in ingresso | Sì; output testuale | Analisi multimodale via API |
| Ricerca web e function calling | Sì; chiamate parallele supportate | Richiede strumenti e permessi configurati |
| Output strutturati | JSON Object e JSON Schema | Risposte più facili da integrare in software |
| Fine tuning, deployment dedicato e batch | Non supportati | Uso via servizio gestito; niente esecuzione batch documentata |
Fonte: documentazione Alibaba Cloud Model Studio e guida QwenCloud, consultate il 16 novembre 2026.
Il 60% di risparmio nasce da un test interno
Alibaba attribuisce a Qwen4-Max una riduzione del 60% del costo medio per attività rispetto a Qwen3.8-Max. Il confronto proviene da Work360, benchmark proprietario su compiti in 721 ambiti professionali: nel regime di ragionamento ad alto impegno, l’azienda dichiara anche un consumo di token inferiore del 35%. Sono risultati pubblicati dal produttore, non una stima indipendente della fattura di un’impresa.
Il listino API aiuta a separare il prezzo dei token dal costo di una prestazione completa. Per la distribuzione internazionale, Model Studio indica 1,50 dollari per milione di token in ingresso e 4,50 in uscita per Qwen4-Max, contro 2 e 6 dollari per Qwen3.8-Max: una riduzione del 25% su entrambe le tariffe standard.
La lettura dei token in cache costa 0,075 dollari per milione; il prezzo cambia quando entrano in gioco cache e modalità di utilizzo.
Il 60% dichiarato da Alibaba incorpora dunque anche il minor numero di token impiegati nel test, mentre il vantaggio di prezzo unitario è più contenuto.
La documentazione segnala inoltre che Qwen4-Max non supporta l’inferenza batch, cioè l’elaborazione in coda di molte richieste, né il fine tuning e il deployment del modello. Per attività massive non urgenti, l’assenza del batch può pesare sulla scelta; per adattare il modello ai dati o ai processi aziendali, il cliente deve affidarsi alle istruzioni, agli strumenti esterni e alle modalità offerte dal servizio gestito.
Il benchmark indipendente lo colloca poco sopra la mediana
Artificial Analysis assegna a Qwen4-Max 43 punti nell’Intelligence Index, contro una mediana di 41 per i modelli di fascia di prezzo simile. L’indice combina nove prove, distribuite in quattro aree con lo stesso peso: lavoro della conoscenza, coding, scienza e conoscenze generali.
Il risultato colloca il modello sopra il valore tipico del suo gruppo, ma resta distante dal punteggio più alto rilevato dalla piattaforma, 65.
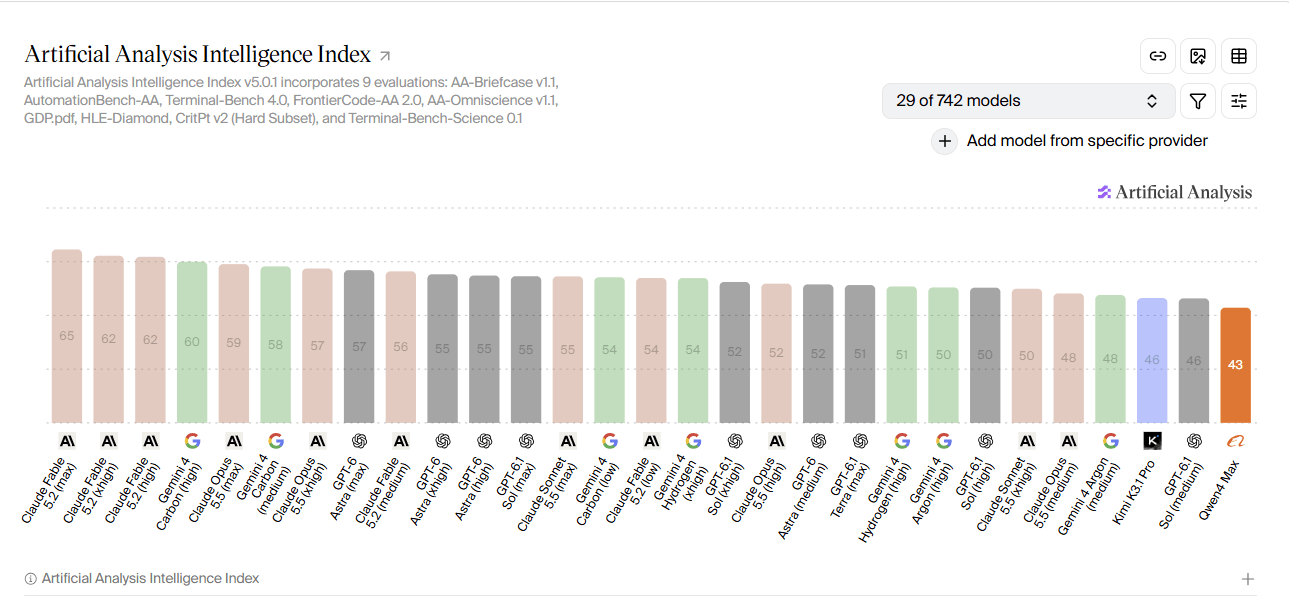
La valutazione non misura ogni capacità allo stesso modo: Artificial Analysis descrive l’indice come una batteria prevalentemente testuale e in lingua inglese; la copertura multimodale viene esaminata anche con valutazioni separate. Il punteggio offre quindi un riferimento comparabile sulle attività incluse, non una graduatoria universale di ogni caso d’uso.
Il confronto con Work360 non è diretto: i due sistemi usano compiti, pesi e procedure differenti.
La scelta dipende da controllo, carichi e prove sul campo
Qwen4-Max combina un contesto molto ampio, input multimodali e strumenti per costruire flussi agentici, mentre Alibaba punta su un’architettura che attiva una quota ridotta dei parametri a ogni token. Per un’impresa, l’accesso API e la compatibilità con interfacce note possono ridurre il lavoro di integrazione iniziale; il punteggio indipendente, invece, invita a misurare il modello sulle attività che generano davvero valore.
Un confronto operativo dovrebbe registrare qualità del risultato, token usati, latenza e costo per attività, con prompt e strumenti identici agli altri modelli in prova. La disponibilità dei pesi, del fine tuning e dell’inferenza batch va valutata insieme alle esigenze di controllo e ai volumi di lavoro.
Per ora Qwen4-Max è un’offerta proprietaria via servizio cloud; Alibaba annuncia per il futuro modelli Qwen4 più piccoli con pesi aperti, senza indicare nella nota di lancio una data di rilascio.





Partecipa alla community