


Quando si legge che un modello di intelligenza artificiale ha decine o centinaia di miliardi di parametri, il numero sembra descrivere una quantità di “conoscenza” accumulata. In realtà indica soprattutto quanti valori numerici apprendibili contiene il modello. Sono quei valori a trasformare i token in ingresso in una previsione: quale token ha più probabilità di venire dopo.
Un parametro non è una regola scritta da una persona né una risposta archiviata nel modello. È un coefficiente regolato durante l’addestramento. La sua funzione si capisce osservando il percorso del testo: il sistema lo divide in token, li rappresenta con vettori, li elabora attraverso strati di calcolo e produce una distribuzione di probabilità.
Il conteggio da solo dice poco sulle capacità: contano anche architettura, dati, obiettivo di addestramento e modalità d’uso.
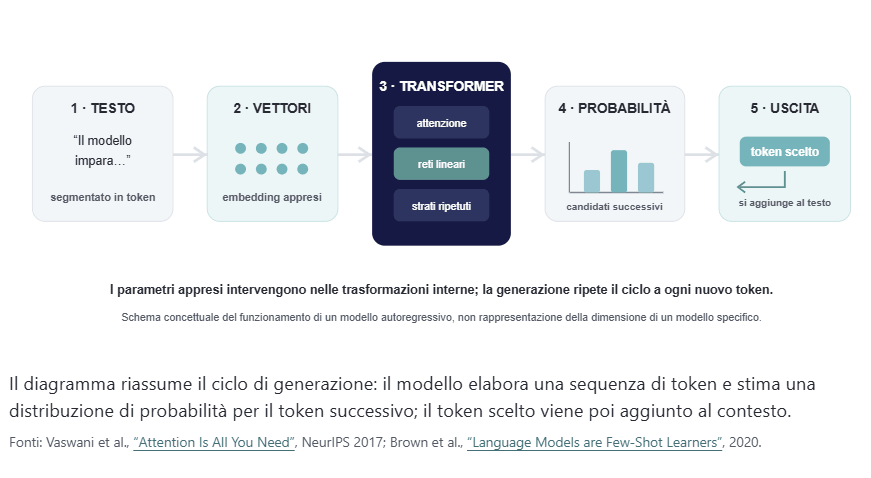
Fonti: Vaswani et al., “Attention Is All You Need”, NeurIPS 2017; Brown et al., “Language Models are Few-Shot Learners”, 2020.
Indice degli argomenti:
Che cosa significa “parametro” in un modello
In una formula come y = ax + b, i numeri a e b determinano come l’input x contribuisce al risultato y. In una rete neurale ci sono analoghi coefficienti, ma organizzati in grandi matrici e vettori e applicati attraverso molti strati. L’insieme dei valori appresi è spesso indicato con la lettera greca θ (theta); il modello calcola un’uscita in funzione dei dati in ingresso e di θ.
Il numero dei parametri è il conteggio di questi valori regolabili. Comprende, secondo l’architettura, matrici di pesi, vettori di bias e tabelle di embedding, oltre ad altri coefficienti. Non tutti i modelli usano gli stessi componenti: per esempio alcune proiezioni dei Transformer possono non avere un bias.
Perciò “un parametro per neurone” è una semplificazione fuorviante; un conteggio descrive la struttura matematica del modello, non una fila di unità identiche.
Come l’addestramento regola i valori
All’inizio i parametri partono da valori iniziali scelti dal metodo di addestramento, spesso casuali o derivati da una distribuzione controllata. Durante il pre-addestramento, un modello linguistico viene esposto a sequenze di token e impara, tra gli altri obiettivi possibili, a prevedere il token successivo. Confronta la previsione con il token effettivo, calcola una funzione di perdita e usa la retropropagazione del gradiente con un algoritmo di ottimizzazione per aggiornare molti parametri insieme.
Il processo si ripete su un’enorme quantità di esempi. Una previsione sbagliata non fa correggere una sola manopola identificabile: il gradiente distribuisce l’aggiornamento tra i coefficienti che hanno contribuito al risultato.
Con successive iterazioni, il modello riduce la perdita media sull’obiettivo di addestramento. In seguito possono esserci altre fasi, come l’addestramento supervisionato su esempi curati o l’ottimizzazione delle risposte secondo preferenze umane.
Addestramento e uso sono fasi diverse. Nell’uso normale, chiamato inferenza, i valori appresi restano fissi: il modello li applica all’input per produrre una risposta. Le impostazioni scelte per una singola generazione possono cambiare il modo in cui il sistema seleziona l’output, ma non riscrivono i parametri del modello.
Token ed embedding: numeri per rappresentare il testo
Prima di elaborare una frase, il modello la segmenta in token, non necessariamente parole intere. Un token può corrispondere a una parola, a una parte di parola, a un segno di punteggiatura o a una sequenza di caratteri. Il tokenizzatore converte ciascun elemento in un identificatore numerico; una tabella appresa associa poi quell’identificatore a un vettore, cioè a una lista di numeri chiamata embedding.
La lunghezza del vettore, spesso chiamata dimensione nascosta o dimensione del modello, dipende dall’architettura: non esiste una misura universale di 4.096 numeri. Ogni coordinata contribuisce alla rappresentazione, ma non corrisponde in modo semplice a un concetto umano come “ironia” o “sport”. Le regolarità si distribuiscono fra molte dimensioni e diventano utili attraverso i calcoli successivi.
L’embedding iniziale non contiene da solo il significato completo della parola. La rappresentazione viene trasformata strato dopo strato e dipende dal contesto: la parola “banca” assume una collocazione diversa in “banca del fiume” e “banca centrale”.
Per questo è impreciso immaginare il modello come un dizionario con definizioni già archiviate. I parametri codificano regolarità apprese dai dati, in forma distribuita, e non un archivio consultabile di frasi.
Pesi, bias e calcoli nei Transformer
I pesi (weights) sono coefficienti che moltiplicano i valori in ingresso e ne determinano il contributo alle trasformazioni. Nei Transformer, che sono alla base di molti LLM, le proiezioni calcolate con i pesi servono tra l’altro al meccanismo di attenzione: il modello valuta quali parti del contesto siano pertinenti per elaborare ciascun token. L’attenzione non consiste semplicemente nel moltiplicare l’embedding di una parola per i pesi di tutte le altre; confronta rappresentazioni derivate da query, key e value, combinandole poi nei diversi strati.
Un bias, quando presente, è un termine additivo in una trasformazione lineare. Può spostarne la soglia o l’uscita, ma non è un interruttore universale collegato a ogni “neurone”. L’analogia delle manopole aiuta a intuire che pesi e bias influenzano il calcolo; non descrive in modo letterale la complessa architettura di un LLM.
Il termine “neurone” deriva da reti più semplici e resta una metafora utile per alcuni componenti, ma un Transformer moderno è composto da operazioni su tensori: matrici, vettori, funzioni di attivazione, normalizzazioni e connessioni residue.
Un singolo valore numerico non ha di norma un significato interpretabile isolatamente. Il comportamento emerge dall’interazione di moltissimi parametri e dal modo in cui l’architettura li applica.
Dalla previsione del token alla risposta
Alla fine del calcolo, il modello produce punteggi, detti logit, per i token candidati. Una funzione matematica li converte in probabilità. Il sistema di generazione sceglie quindi il token successivo: può prendere quello con il punteggio più alto oppure campionare fra più candidati, in base alle impostazioni adottate.
Il token scelto viene aggiunto al testo e l’intero passaggio si ripete finché il modello non raggiunge un criterio di arresto o il limite di output.
Il testo generato, quindi, non viene estratto da una frase completa conservata nei parametri. È costruito un token alla volta sulla base del contesto precedente e delle regolarità apprese. Questo meccanismo spiega sia la fluidità del linguaggio sia un limite importante: una sequenza plausibile può essere generata anche quando il contenuto non è corretto, perché la previsione del token non equivale a una verifica dei fatti.
Temperatura, top-p e top-k: impostazioni, non parametri appresi
Nel linguaggio comune si chiamano spesso “parametri” anche temperatura, top-p e top-k. In senso tecnico sono impostazioni di campionamento o iperparametri della generazione: vengono passate al sistema al momento dell’inferenza e non fanno parte dei valori appresi durante il pre-addestramento. La temperatura modifica la distribuzione delle probabilità; top-k limita i candidati ai k token più probabili, mentre top-p restringe il gruppo finché la probabilità cumulativa raggiunge una soglia.
Questi controlli non sono disponibili o consigliati nello stesso modo per ogni modello. Nella documentazione per Gemini, Google descrive top-k e top-p come filtri di campionamento e avverte che per la famiglia Gemini 3 è preferibile mantenere le impostazioni predefinite, perché modificarle può peggiorare alcune prestazioni. La documentazione ufficiale chiarisce così la distinzione: i parametri interni sono appresi; le impostazioni di generazione controllano la selezione dell’output.
Perché più parametri non garantiscono un modello migliore
GPT-3, presentato nel 2020, aveva 175 miliardi di parametri secondo il paper dei suoi autori. È un dato documentato per quel modello, ma i conteggi non sono resi pubblici per tutti i sistemi recenti: stime non confermate su modelli proprietari non sono una base solida per confronti. Anche quando il dato è noto, il totale non dice quante informazioni utili siano state apprese né quanto bene il sistema si comporti in uno specifico compito.
Conta anche la quantità e la qualità dei dati. Lo studio Chinchilla di DeepMind ha confrontato modelli addestrati con budget di calcolo simili e ha mostrato che il modello da 70 miliardi di parametri, addestrato su più dati, superava Gopher da 280 miliardi su una serie di benchmark.
Il risultato non significa che un modello piccolo sia sempre migliore: mostra che dimensione e dati devono essere bilanciati rispetto al calcolo disponibile.
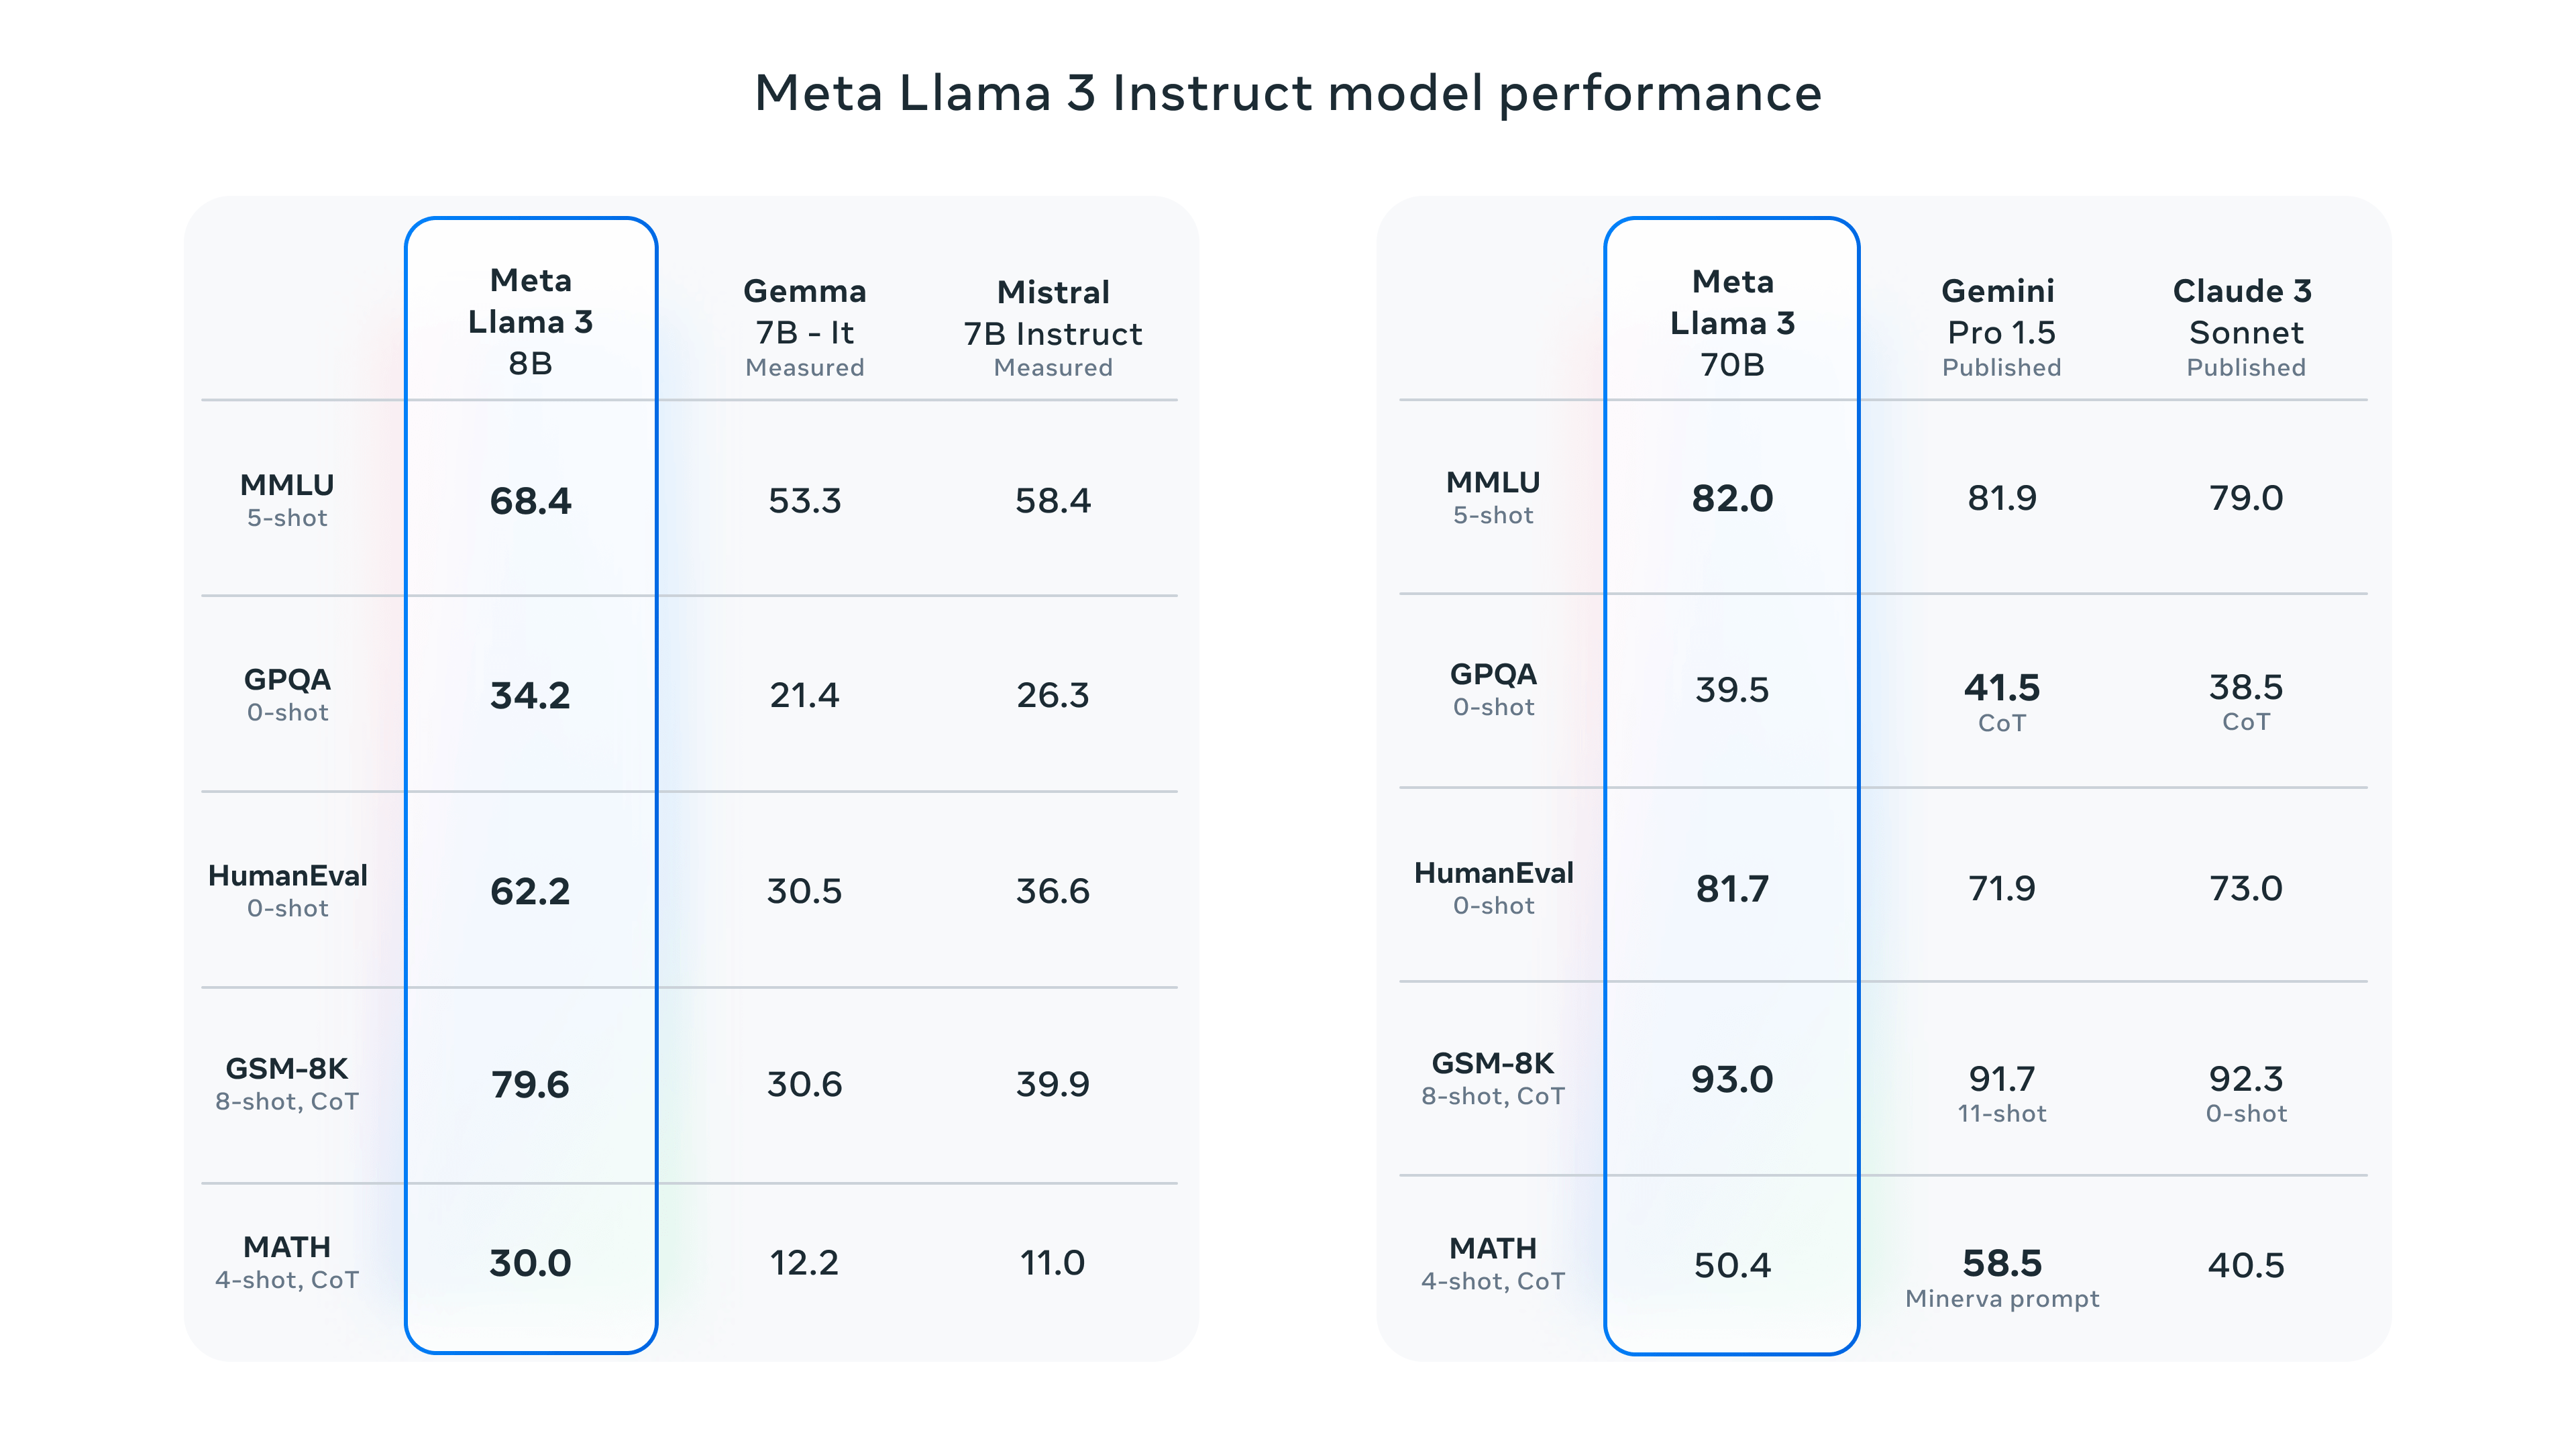
Un esempio successivo arriva da Meta: l’azienda ha dichiarato di avere addestrato i modelli Llama 3 su oltre 15mila miliardi di token e che le versioni da 8 e 70 miliardi di parametri continuavano a migliorare lungo l’addestramento descritto. Sono dati riferiti a quella famiglia e non una regola valida per ogni modello.
La presentazione tecnica di Llama 3 spiega inoltre che token, dimensione del modello e calcolo impiegato concorrono alle prestazioni.
Un altro metodo è la distillazione: un modello più piccolo viene addestrato anche sulle uscite o sulle distribuzioni di un modello più grande, così da apprendere una parte delle sue capacità con costi di esecuzione potenzialmente inferiori.
Esistono poi le architetture mixture of experts: hanno più gruppi di parametri specializzati, ma un meccanismo di instradamento ne attiva soltanto alcuni per ciascun token. In questi casi il numero totale e quello attivo per elaborazione sono grandezze diverse.
Il paper Switch Transformer descrive questa attivazione sparsa e i relativi compromessi di calcolo e comunicazione.
Il numero è una misura, non una pagella
Il conteggio dei parametri aiuta a descrivere la scala di un modello e può anticipare parte dei requisiti di memoria e calcolo. Non equivale però a un punteggio di intelligenza: due modelli con lo stesso numero possono differire per dati, architettura, ottimizzazione, post-addestramento e prestazioni. Nei modelli a esperti, inoltre, una parte dei parametri può restare inattiva per una singola richiesta.
Per valutare un LLM servono quindi prove sui compiti reali, affidabilità, latenza, costo e requisiti di esecuzione, oltre a informazioni sulla provenienza dei dati e sui limiti noti. I parametri sono i numeri che rendono possibile il calcolo appreso; non raccontano da soli che cosa il modello sa fare.


Partecipa alla community