


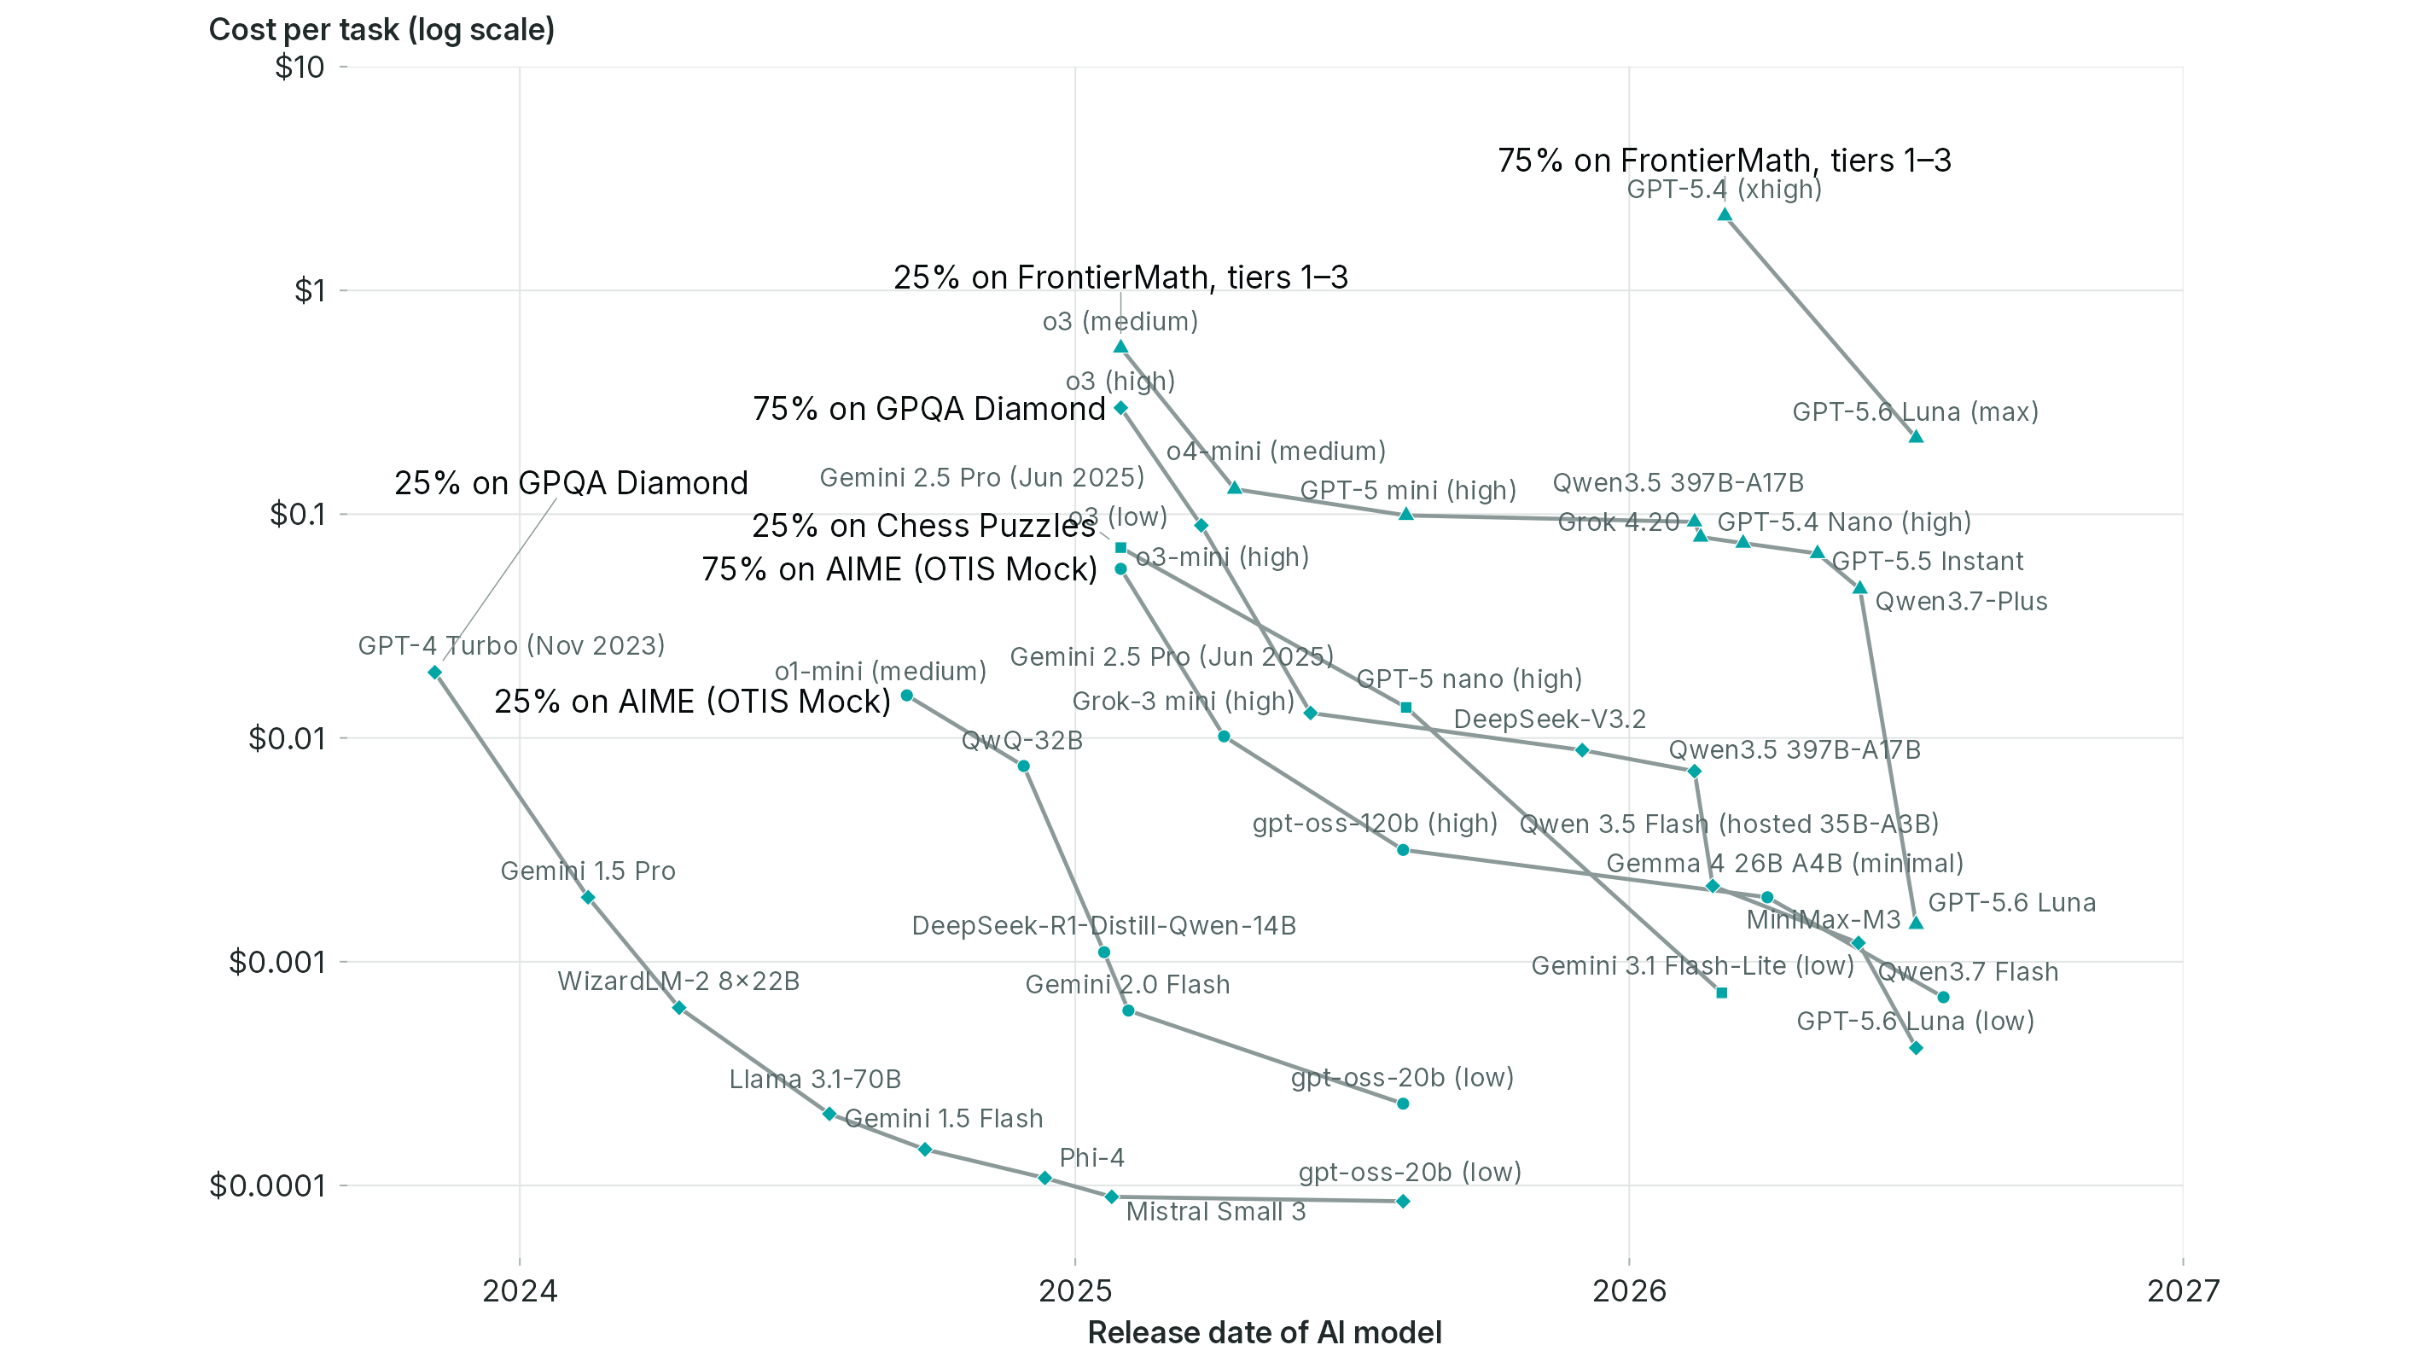
Un’automobile nuova che in diciotto mesi passa da 50mila a 69 dollari di listino non esiste, eppure è l’immagine scelta da Epoch AI per descrivere cosa è successo al costo dell’intelligenza artificiale. Nel report «The plunging price of thought», firmato da Luke Emberson e David Roodman e pubblicato il 22 settembre, l’istituto di ricerca misura quanto si spende per ottenere un certo livello di prestazione da un modello linguistico e quanto in fretta quella spesa si riduce, arrivando a una stima del 47% in meno ogni trimestre dal 2023, cioè un costo che si divide per tredici in un anno.
Nessuna delle tecnologie con cui il report la confronta, dalla corrente elettrica alle batterie al litio, si è mai deprezzata a questa velocità.
La conseguenza tocca la pianificazione aziendale più ancora della bolletta, perché un caso d’uso che oggi non ripaga l’investimento, a questi ritmi, può ripagarlo nel giro di pochi trimestri, mentre un contratto firmato a prezzo fisso su più anni rischia di invecchiare molto prima della scadenza.
Indice degli argomenti:
Lo stesso voto in scienze costa 725 volte meno
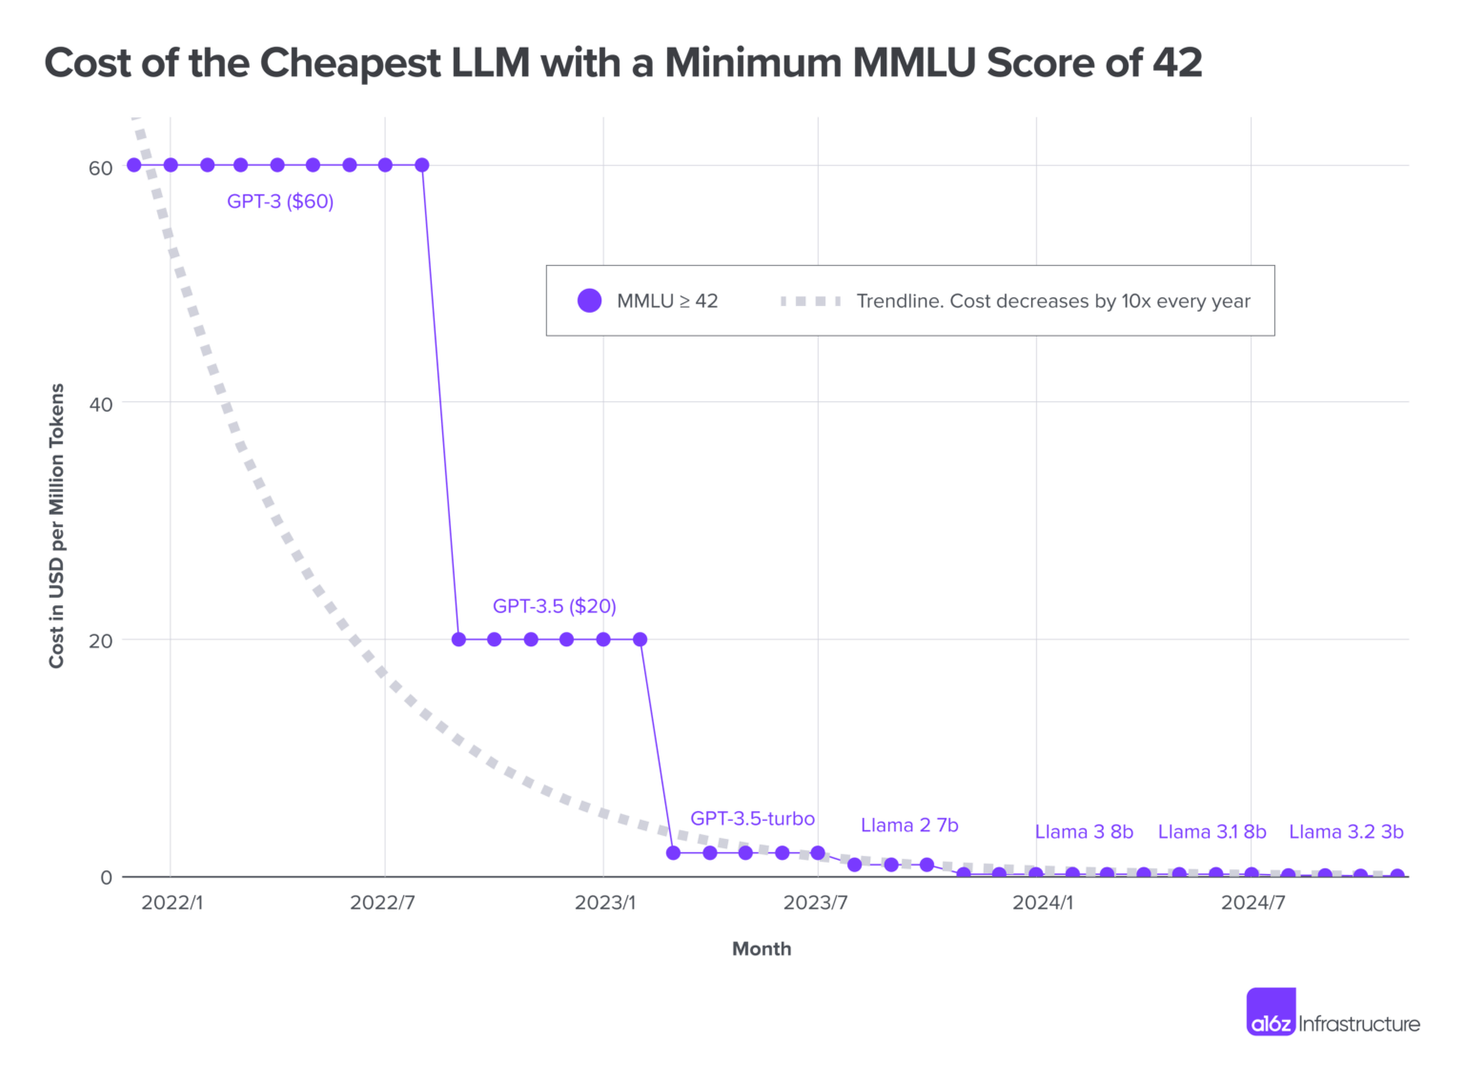
Epoch misura una grandezza diversa da quella dei listini. Diverse analisi precedenti, come quella pubblicata nel 2024 da Andreessen Horowitz sulla «LLMflation», che stimava un calo di dieci volte l’anno, guardavano al prezzo per token, ossia per frammento di testo elaborato, dei modelli capaci di superare una certa soglia in un test. Con l’arrivo dei modelli di ragionamento, che prima di rispondere producono lunghe catene di passaggi intermedi e quindi consumano molti più token, quel prezzo descrive sempre meno la spesa reale, perché un modello economico per token può costare di più per ogni singola risposta se ragiona più a lungo.
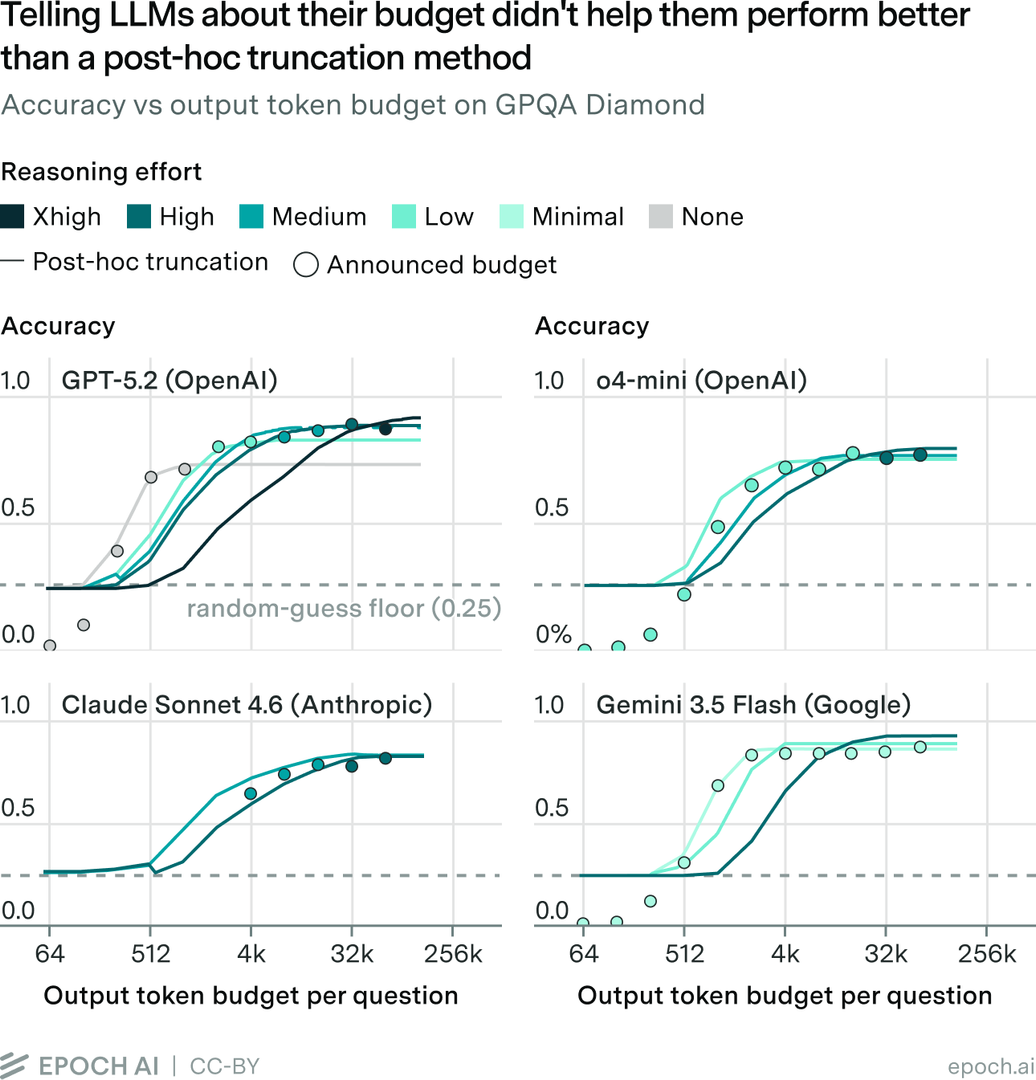
Il report misura quindi il costo per compito, come avevano iniziato a fare alcuni studi più recenti, cioè quanto si spende in media per rispondere a una domanda di un benchmark, la batteria standard di test con cui si confrontano i modelli, e lo fa su cinque prove: matematica da competizione, matematica di ricerca, scienze a livello di dottorato, problemi di scacchi e un gioco tenuto segreto per evitare che i laboratori addestrino i modelli proprio su quello.
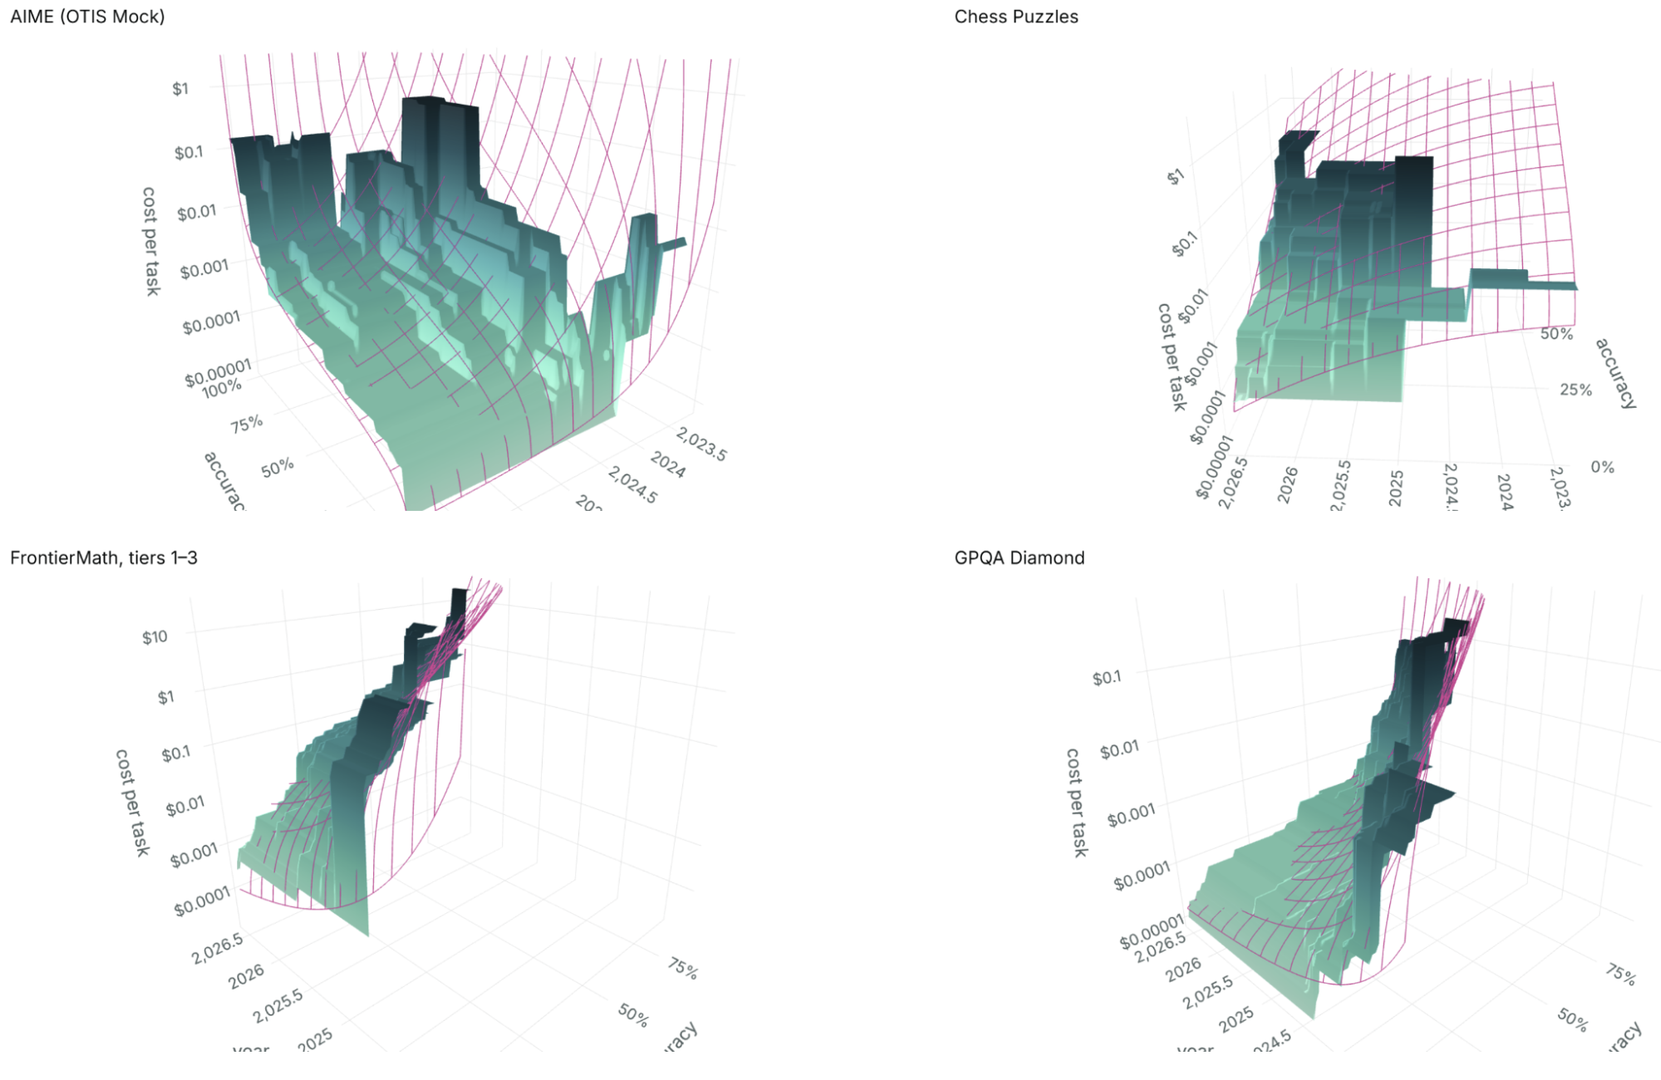
La novità del metodo è che per ogni modello ricostruisce l’intera curva tra spesa e punteggio simulando budget di token via via più stretti a partire dalle trascrizioni dei test, con una procedura messa a punto dal CAISI, il centro federale americano per gli standard sull’AI, e da lì traccia la frontiera di Pareto: in ogni momento, il modello più economico in grado di raggiungere un dato punteggio.
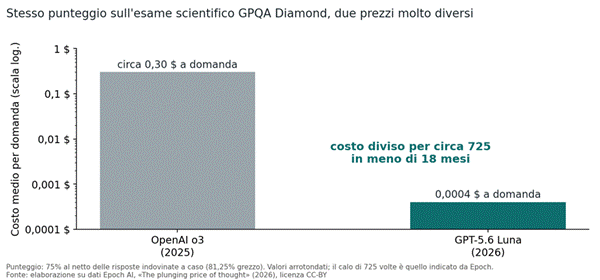
L’esempio più leggibile riguarda GPQA Diamond, un esame a scelta multipla di fisica, chimica e biologia di livello dottorale. Nel 2025, o3, uno dei modelli di ragionamento di OpenAI, raggiungeva secondo le stime di Epoch il 75% del punteggio utile (al netto delle risposte che si indovinerebbero tirando a caso) spendendo in media circa 30 centesimi di dollaro a domanda, mentre meno di un anno e mezzo dopo GPT-5.6 Luna, il modello economico di cui OpenAI ha tagliato il listino dell’80% a fine luglio, ottiene lo stesso risultato con quattro centesimi di centesimo. Epoch indica un calo di 725 volte.
L’AI si deprezza 54 volte più in fretta dell’elettricità
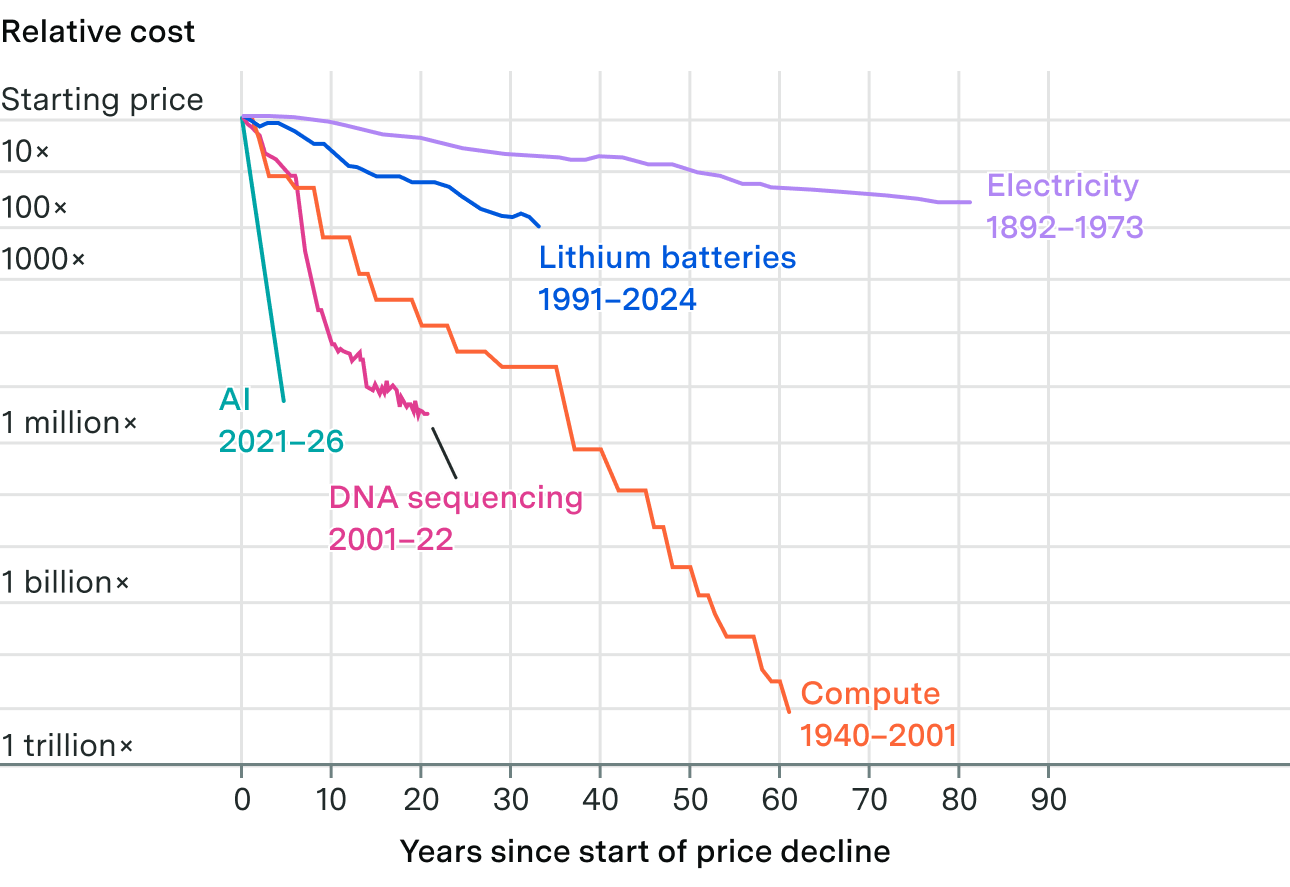
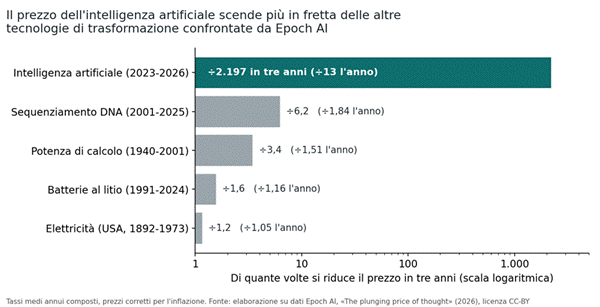
Per dare una scala a questi numeri Epoch confronta l’intelligenza artificiale con altre tecnologie di trasformazione, quelle che nel tempo hanno cambiato interi settori dell’economia. Il prezzo medio dell’elettricità domestica negli Stati Uniti è sceso tra il 1892 e il 1973 a un ritmo equivalente a 1,05 volte l’anno, le batterie agli ioni di litio di 1,16 volte l’anno dal 1991 al 2024, la potenza di calcolo di 1,51 volte tra il 1940 e il 2001, il sequenziamento del genoma di 1,84 volte dal 2001 in poi. Misurato in punti logaritmici, come fa il report per confrontare velocità di discesa così diverse, il prezzo dell’inferenza, vale a dire l’uso di un modello già addestrato per produrre risposte, cala quattro volte più in fretta del sequenziamento del DNA, sei volte più del calcolo, diciotto più delle batterie e cinquantaquattro più dell’elettricità.
Tradotto su un orizzonte di tre anni, a quei ritmi la corrente elettrica perdeva circa un settimo del proprio prezzo, mentre l’intelligenza artificiale lo divide per oltre duemila.
Una prova più grezza suggerisce che la discesa sia cominciata prima del 2023.
GPT-3, aperto all’uso commerciale nel novembre 2021, otteneva 43,9 punti sul test di conoscenze generali MMLU a 60 dollari per milione di token, e nel luglio 2023 Llama 2-7B di Meta superava quel punteggio a 20 centesimi, con un calo composto di 31 volte l’anno. Per gli autori è plausibile che il costo scenda almeno a tredici volte l’anno fin dagli esordi dell’inferenza commerciale.
Il report parte da un contrasto: che il boom dell’AI spinga in alto i prezzi di tutto ciò che consuma, chip ed energia fino alle ore di lavoro degli elettricisti, è ormai noto, mentre è molto meno riconosciuto che il prodotto in uscita da quei data center si stia deprezzando a una velocità senza precedenti tra le tecnologie messe a confronto.
Il nuovo stato dell’arte si svaluta del 66% a trimestre
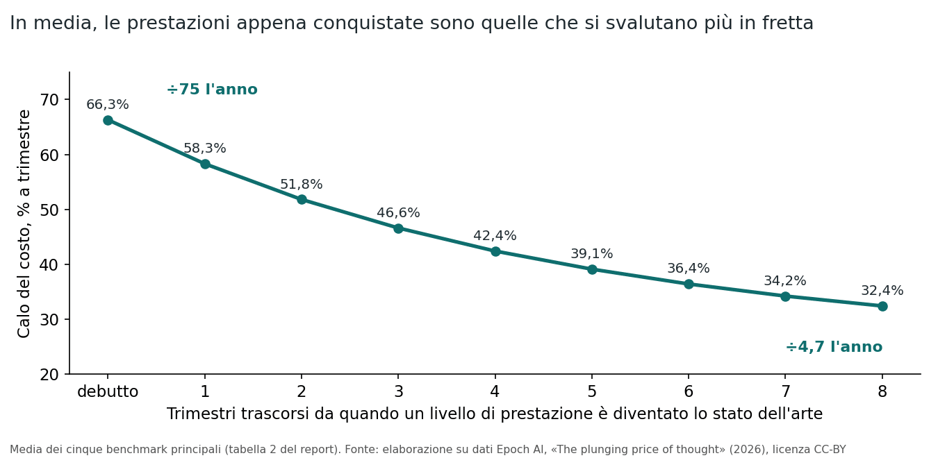
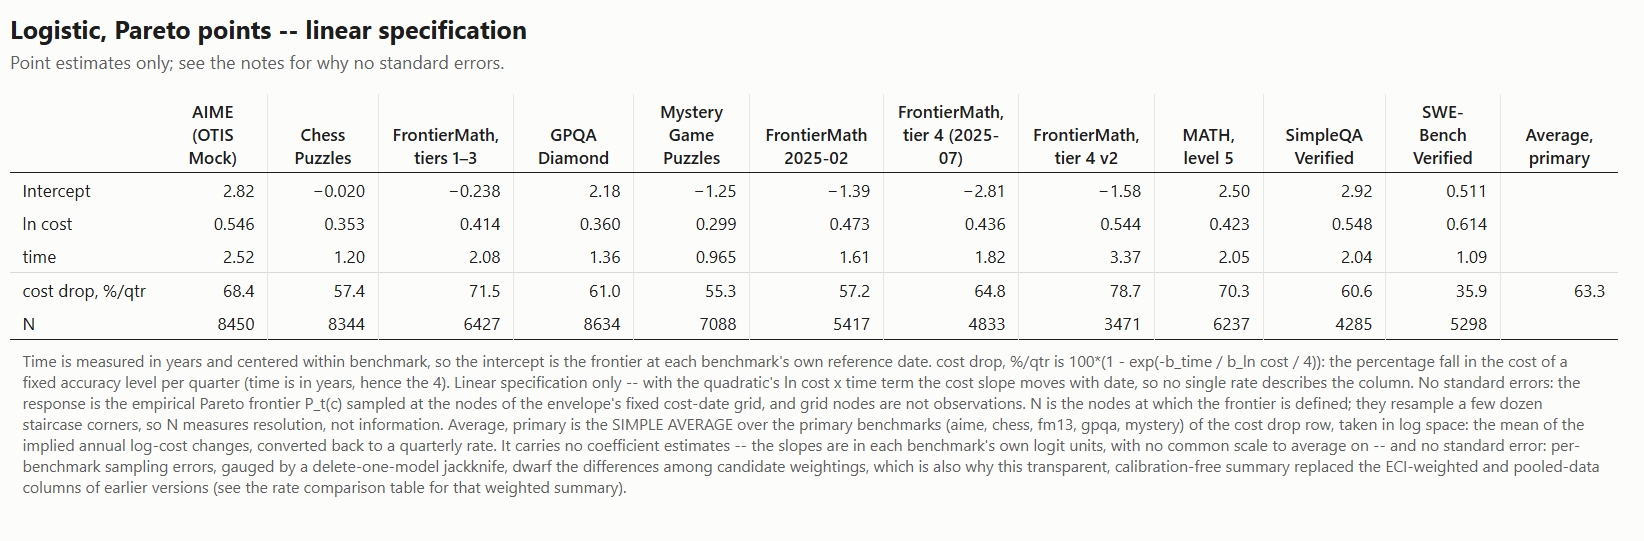
La media nasconde una dinamica temporale. Su tre dei cinque benchmark principali il costo di un livello di prestazione scende più rapidamente subito dopo che quel livello viene raggiunto per la prima volta, quando rappresenta lo stato dell’arte, il meglio disponibile sul mercato in quel momento, e mediando su tutti e cinque il calo è del 66% a trimestre al debutto, pari a una divisione per 75 in un anno, e del 32% a trimestre due anni dopo, quando il fattore annuo scende a 4,7.
La spiegazione avanzata dagli autori, come ipotesi, è commerciale. Chi porta per primo sul mercato una capacità nuova può farla pagare a premio per un breve periodo, poi concorrenti chiusi e aperti la raggiungono e il prezzo crolla, finché la competizione si assesta e la discesa rallenta anche in termini percentuali. Ne deriva, scrivono, che i profitti superiori alla norma nella vendita di inferenza possono durare poco per ciascun modello, una fugacità che è insieme causa e conseguenza della competizione serrata tra i laboratori.
Dai tracciati emerge un dettaglio che complica la lettura più diffusa della guerra dei prezzi: vicino allo stato dell’arte la concorrenza più accesa è avvenuta tra modelli chiusi, e in un solo caso il secondo modello capace di abbassare il costo di un traguardo aveva pesi aperti, scaricabili ed eseguibili da chiunque (QwQ-32B di Alibaba, sulla matematica da competizione di AIME).
Gli autori non escludono che la pressione dei modelli aperti alimenti indirettamente anche quella competizione. La stagione dei tagli di listino di luglio e agosto ha mostrato comunque che l’effetto più visibile dei modelli aperti, molti dei quali cinesi, si concentra sulla fascia dell’intelligenza sufficiente.
Sul piano degli acquisti la traduzione operativa va contro l’intuito, perché comprare lo stato dell’arte appena uscito significa pagare la fase più cara di una curva che nei trimestri successivi scende ai ritmi più rapidi, e conviene farlo solo dove quella capacità serve subito e il suo valore copre il sovrapprezzo.
Su SWE-bench il calo è più lento: i limiti delle stime
La velocità cambia anche con il tipo di compito. Sui cinque benchmark principali, nelle stime calcolate senza modello statistico, il calo va dal 43% a trimestre dei problemi di scacchi al 53% della matematica di ricerca di FrontierMath, mentre tra i benchmark secondari la forbice si allarga, dal 65% di una versione di FrontierMath Tier 4 al 26% di un’altra.
In fondo alla classifica si trova anche SWE-bench Verified, la prova che chiede di risolvere problemi reali di programmazione su progetti software esistenti, dove il calo si ferma al 27,5% a trimestre e il costo si divide per 3,6 in un anno invece che per 13. Il dato interessa chi spende in agenti di coding, i programmi che scrivono e correggono codice in autonomia, ma va maneggiato con cautela: la serie di SWE-bench parte solo da maggio 2024, e un’analisi di Håvard Tveit Ihle citata nel report, condotta su altre prove di programmazione, trovava al contrario costi dimezzati ogni 1,4-2 mesi.
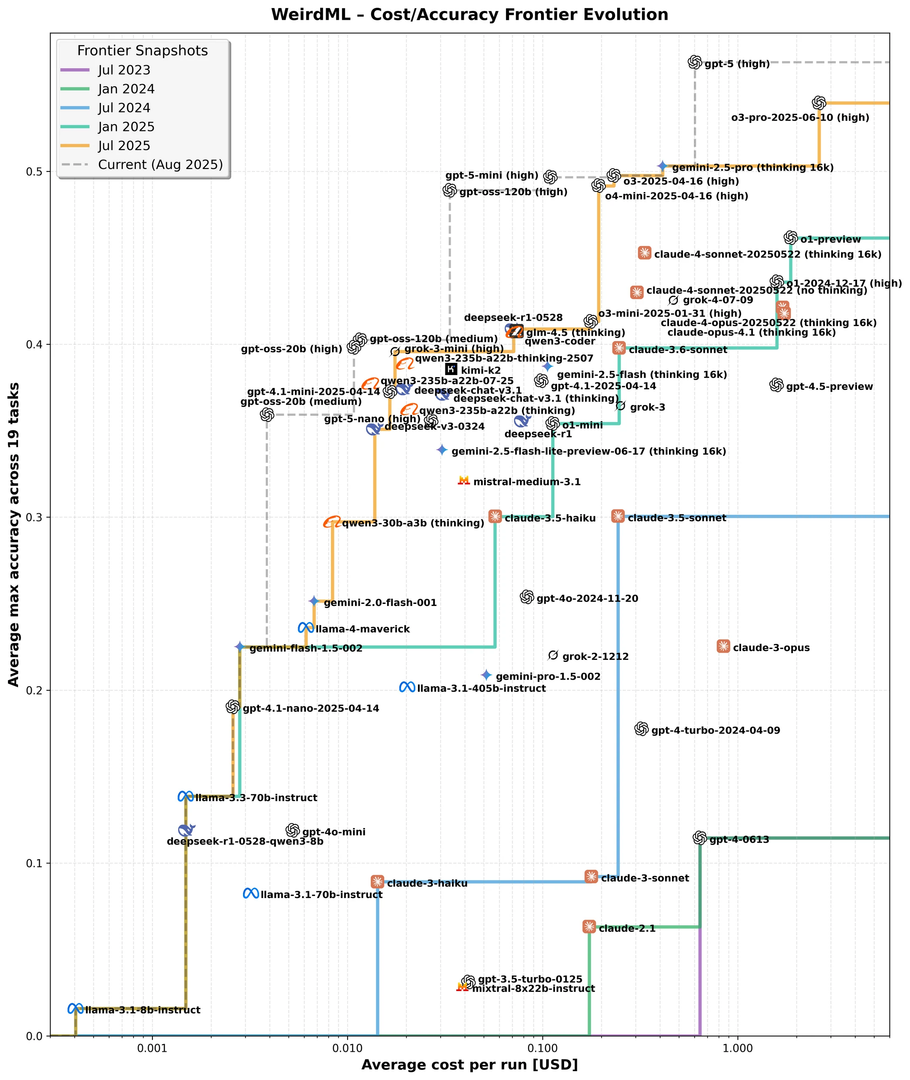
Gli stessi autori dedicano ai limiti una sezione intera. C’è il rischio del benchmaxxing, l’addestramento mirato dei modelli sui test più noti, che gonfierebbe i progressi misurati rispetto a quelli reali: il gioco segreto, pensato proprio per neutralizzarlo, mostra un calo del 44% contro il 47% medio, un segnale che la critica coglie qualcosa senza smontare il risultato. Un punteggio su un benchmark, poi, resta un indicatore imperfetto di lavoro utile, e i numeri descrivono un utente teorico che a ogni rilascio cerca il modello più conveniente per ogni compito, mentre le aziende cambiano modello di rado e incassano quindi risparmi minori.
Pesano anche l’orizzonte breve, appena tre anni di dati, e le scelte di calcolo: sul solo GPQA Diamond, modi diversi e tutti ragionevoli di fare la media sui livelli di punteggio portano la stima fra il 43 e il 58% a trimestre. Gli autori riconoscono che il «prezzo del pensiero» è un concetto meno univoco del prezzo di un chilowattora, perché l’inferenza è un paniere di servizi in continua trasformazione, e il loro indice somiglia più a un indice dei prezzi al consumo, aggiornato di volta in volta, che alla quotazione di una merce.
Lo studio che Epoch considera il più completo finora, firmato da Gundlach e colleghi nella versione di marzo, stima cali fra cinque e dieci volte l’anno, più lenti ma nello stesso ordine di grandezza, e un’analisi indipendente di Demirer, Fradkin e Tadelis sul Journal of Economic Perspectives, citata dagli stessi autori, arriva per altra via al confronto con le tecnologie del passato.
Tutti i dati e il codice sono pubblici, con una pagina interattiva che permette di esplorare i grafici benchmark per benchmark.
Dalla dinamo di Paul David: il vantaggio è organizzativo
L’elettricità, il termine di paragone più lento della serie, offre anche la lezione più utile per leggere questi numeri. Nel 1990 l’economista Paul David, nel saggio «The Dynamo and the Computer», ricostruì perché la corrente avesse impiegato circa quarant’anni a comparire nelle statistiche sulla produttività americana: le prime fabbriche sostituirono la grande macchina a vapore centrale con una grande dinamo, lasciando intatti alberi di trasmissione, cinghie e stabilimenti disposti su più piani, e i guadagni arrivarono solo negli anni Venti, quando gli imprenditori capirono che ogni macchina poteva avere il proprio motore e che la fabbrica andava ridisegnata su un solo livello, attorno al flusso dei materiali.
Con l’intelligenza artificiale il rapporto tra le due velocità si è rovesciato. Il prezzo della corrente scendeva di pochi punti percentuali l’anno e la riorganizzazione delle fabbriche richiese una generazione, mentre il prezzo del ragionamento automatico si divide per tredici ogni anno e il collo di bottiglia si sposta in larga parte sul lato organizzativo, sulla capacità di ridisegnare i processi invece di inserire un modello al posto di un passaggio manuale lasciando il resto identico.
Se la tendenza prosegue, un business case calcolato sui prezzi di oggi sottostima il proprio rendimento, perché con un calo del 47% a trimestre il costo di un compito, a parità di prestazione e per chi passa di volta in volta al modello più conveniente, scende a poco più di un quarto in sei mesi e a meno di un decimo in un anno, e i progetti scartati per ragioni di costo meritano una nuova valutazione a ogni trimestre. I contratti pluriennali a prezzo per token fisso diventano un rischio, a meno di clausole di revisione legate ai listini di mercato, e le architetture che permettono di spostare un carico di lavoro da un modello all’altro senza riscrivere il servizio valgono più dell’ottimizzazione spinta su un singolo fornitore.
La metrica da seguire in azienda è il costo per compito portato a termine, la stessa che usa Epoch, perché il prezzo per milione di token, con i modelli che ragionano, dice sempre meno su quanto si spenderà davvero.
Nella ricostruzione di David, il salto di produttività degli anni Venti venne dal modo di usare la corrente, dai reparti ridisegnati attorno ai motori elettrici, più che dal suo prezzo. Con un costo del ragionamento che cala di quasi la metà a ogni trimestre, quella stessa distanza può formarsi in pochi trimestri, tra le aziende che avranno ridisegnato il lavoro attorno a un’intelligenza sempre più economica e quelle che avranno solo aggiunto un modello a una catena di montaggio rimasta com’era.



Partecipa alla community