


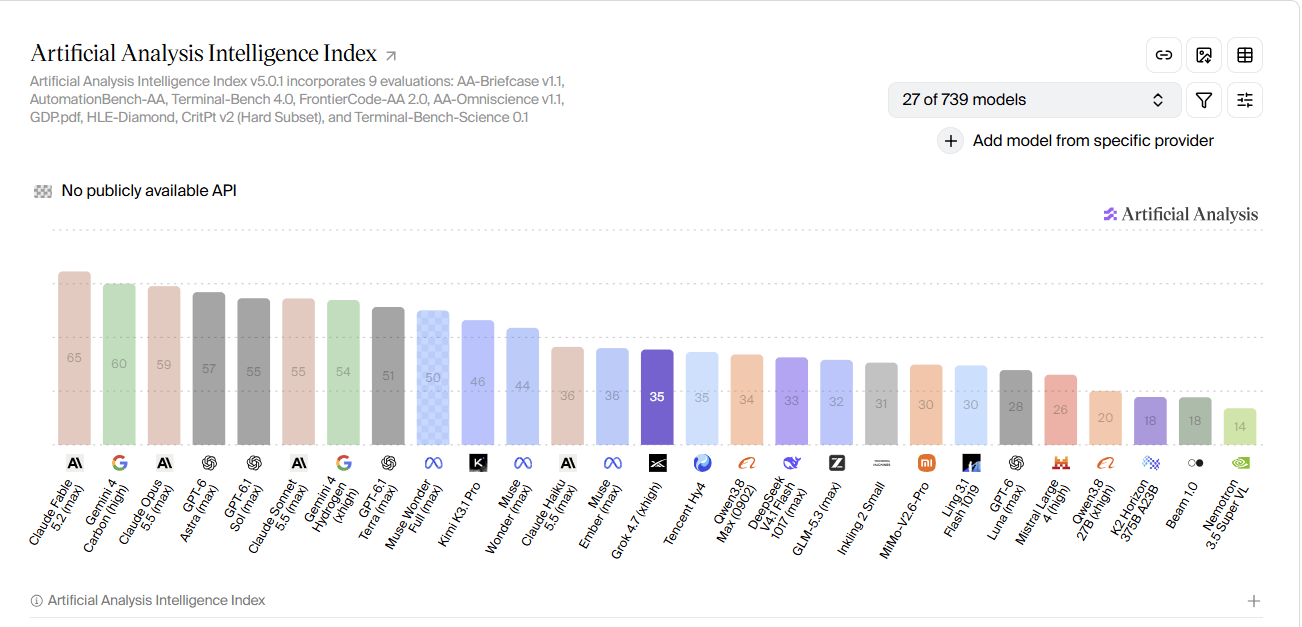
Google ha lanciato l’11 novembre Gemini 4 Hydrogen, un modello progettato per eseguire rapidamente compiti di programmazione, chiamate a strumenti software e attività delegate ad agenti AI. La novità per le imprese è il rapporto tra prestazioni, velocità e costo: Hydrogen raggiunge 51 punti nell’Intelligence Index di Artificial Analysis con ragionamento high e 54 con xhigh, pur costando 1,50 dollari per milione di token in ingresso e 7,50 in uscita.
Il modello è disponibile nelle API Gemini e in Google AI Studio, oltre che in servizi aziendali e consumer, con modalità di accesso diverse. Google propone Hydrogen per svolgere lavoro esecutivo ripetuto e lasciare a Gemini 4 Carbon e Argon le attività di ragionamento più impegnative. Il confronto indipendente mostra una distinzione utile: Carbon raggiunge 60 punti nello stesso indice, mentre Hydrogen può terminare più rapidamente numerosi compiti a un costo inferiore.

Indice degli argomenti:
Gemini Hydrogen, Carbon e Argon: tre ruoli diversi nell’offerta Google
Lo sviluppo software offre un esempio di come Google intenda usare i tre modelli. Carbon può affrontare un cambiamento architetturale complesso, Hydrogen può eseguire modifiche circoscritte al codice e verificare i test, mentre un modello più profondo interviene quando un errore resiste ai primi tentativi. Il sistema Orchestrator di Google Antigravity automatizza la scelta del modello durante la sessione.
Secondo prove diffuse dall’azienda su Terminal-Bench 4.0, la combinazione ha consumato il 24% di quota in meno e completato i compiti il 19% più rapidamente rispetto alla configurazione di riferimento utilizzata da Google.
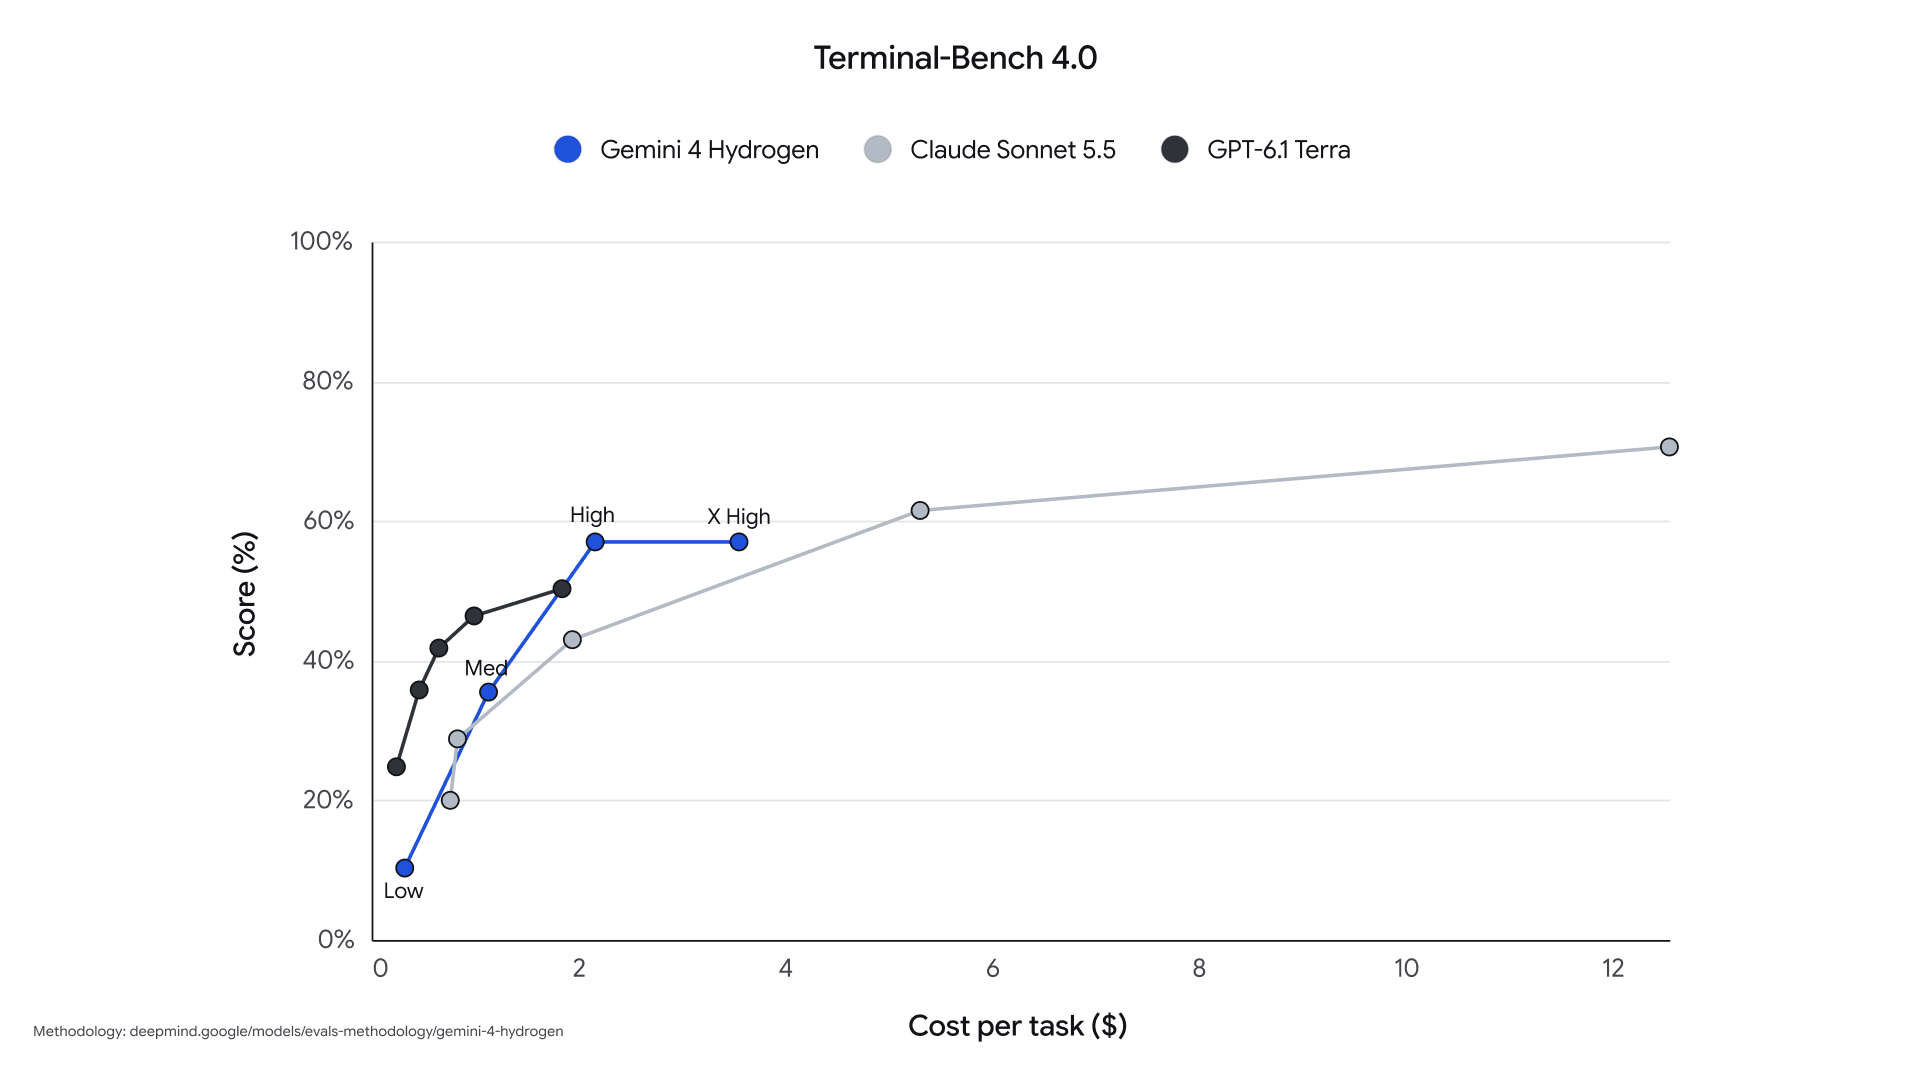
I risultati diffusi dal produttore confermano che Hydrogen è pensato soprattutto per coding agentico, ricerca sui documenti e uso coordinato di strumenti. In una prova Terminal-Bench 4.1 Google indica il 57% contro il 18,2% di Gemini 3.8 Flash; in altri test aziendali riferisce meno affermazioni inventate e tempi inferiori. Questi risultati vanno letti con il protocollo specifico della prova e con le configurazioni dichiarate dall’azienda.
La scheda tecnica di Google DeepMind riporta, per esempio, il 57% su Terminal-Bench 4.1, contro il 63,9% di Claude Sonnet 5.5, e il 77,6% sul sottoinsieme offline di OSWorld-2.1, contro l’83,9% dello stesso concorrente. Sono confronti del produttore su batterie definite, non primati universali.
Una revisione indipendente è disponibile nelle valutazioni di Artificial Analysis, che calcolano l’Intelligence Index da nove prove di lavoro, coding, scienza e ragionamento.
Che cosa dicono i benchmark indipendenti su Gemini Hydrogen
Nella fotografia del 12–13 novembre, Hydrogen high registra 51 punti e xhigh 54; Artificial Analysis attribuisce a Carbon high 60 punti e ad Argon high 50. Il divario tra i livelli di Hydrogen è accompagnato da maggiori tempi medi: per completare un compito del benchmark l’istituto misura circa 8,3 minuti con high e 13,5 con xhigh, contro 27,4 per Carbon high e 30 per Argon high. Sono tempi osservati nel test, non una previsione delle prestazioni di ogni applicazione.
Le aziende che devono scegliere un modello per processi frequenti possono testare più configurazioni sul medesimo insieme di richieste, misurando risultato corretto al primo tentativo, interventi umani, latenza e costo per operazione completata. Un indice aggregato può orientare la selezione iniziale, ma una procedura contabile, una pipeline di codice o un agente di supporto tecnico presentano errori e costi diversi.
Prezzi API di Hydrogen: quanto costa davvero un flusso di lavoro
Il listino della Gemini API indica 1,50 dollari per milione di token in ingresso e 7,50 per milione in uscita. Il prezzo è uniforme lungo la finestra contestuale supportata, fino a 1.048.576 token complessivi tra input e output. La voce di output comprende anche i token destinati al ragionamento.
Di conseguenza, il livello xhigh può costare di più sul singolo compito pur avendo le stesse tariffe unitarie, perché può produrre una quantità maggiore di token intermedi.
Per valutare l’ordine di grandezza, si può ipotizzare un volume mensile di richieste elaborato senza cache e senza strumenti esterni. Con 10 milioni di token in input e un milione in output, il conto teorico è di 22,50 dollari. Se i token in uscita salgono a cinque milioni mantenendo lo stesso input, il totale sale a 52,50 dollari.
La differenza dipende dal rapporto fra input, ragionamento e risposta, non dal solo numero di richieste.
Due scenari di spesa mensile per Hydrogen a tariffa standard
| Volume | Costo input | Costo output | Totale |
|---|---|---|---|
| 10 mln input + 1 mln output | $15,00 | $7,50 | $22,50 |
| 10 mln input + 5 mln output | $15,00 | $37,50 | $52,50 |
Fonte: Google AI for Developers, Gemini API pricing, 13 novembre 2026. Calcolo teorico sui prezzi di input e output; non include cache, chiamate di ricerca, strumenti, ritentativi, tariffe di priorità o imposte. I volumi sono aggregati su un mese e non riferiti a una singola richiesta.
Il confronto con Argon richiede una seconda precisazione commerciale. Google applica ad Argon una tariffa promozionale fino al 30 novembre di 2 dollari per milione di token in ingresso e 10 in uscita, destinata a salire dal primo dicembre a 4 e 20 dollari.
Carbon, invece, ha un diverso posizionamento di costo e capacità. Il listino non basta per stabilire quale modello convenga: un agente che ripete tre volte un lavoro costa più di uno che lo conclude al primo tentativo, anche quando il suo prezzo unitario è inferiore.

In Europa le condizioni cambiano tra API e applicazioni
Per un’impresa italiana la regione di esecuzione può determinare la possibilità di utilizzare il modello su determinati dati. La documentazione di Google Cloud per Agent Platform elenca Hydrogen come disponibile anche nella multiregione UE per elaborazione e servizi API, insieme ai relativi controlli di sicurezza.
La pagina dedicata alla residenza dei dati di Gemini Enterprise indica invece che, in alcune configurazioni dell’app, Hydrogen è accessibile soltanto tramite endpoint globale e può richiedere una specifica abilitazione dell’amministratore.
Questa distinzione interessa soprattutto servizi finanziari, amministrazioni e organizzazioni con impegni contrattuali sulla localizzazione dei dati. La residenza non va dedotta dal solo nome del modello: occorre verificare prodotto, endpoint, funzionalità attivate, strumenti richiamati e contratto del servizio utilizzato.
Limiti operativi e rischi degli agenti
Hydrogen offre quattro livelli di ragionamento, low, medium, high e xhigh. La scheda di Google Cloud documenta inoltre un limite unificato di circa un milione di token, procedure di continuazione per output lunghi e supporto alla cache implicita. Google Cloud classifica inoltre Hydrogen come versione generalmente disponibile ma di durata breve, soggetta a un preavviso minimo di 45 giorni prima del ritiro: per le applicazioni aziendali va quindi previsto un percorso di migrazione.
Google indica anche che una singola fase di generazione arriva a 65.536 token di output, con procedure di continuazione per risposte più lunghe, e colloca il limite delle conoscenze interne a marzo 2026. Il modello può analizzare testo, immagini, audio, video e documenti, ma non tutte le funzioni dell’ecosistema Google condividono le stesse condizioni tecniche.
Nelle API, alcuni parametri personalizzati di campionamento vengono ignorati e la cache esplicita non è supportata nella configurazione descritta.
La model card ufficiale ammette allucinazioni, rallentamenti, timeout e consumo superiore di token nei livelli più profondi. Descrive anche test dedicati a uso improprio cyber, prompt injection e azioni non autorizzate.
Google dichiara miglioramenti nella resistenza agli attacchi e nel rispetto dei permessi, ma per gli agenti aziendali servono autorizzazioni minime, ambienti di prova, registrazione delle operazioni, revisione delle modifiche al codice e controlli sugli output.
Il mercato sta passando a un’architettura in cui più modelli collaborano. Hydrogen amplia le opzioni per assegnare a sistemi diversi la progettazione, l’esecuzione e la verifica. Le imprese possono misurare il vantaggio soltanto sui processi effettivi, confrontando errori, durata, token consumati e lavoro umano residuo: è qui che un modello veloce può trasformarsi in produttività, oppure perdere il risparmio nominale in interventi correttivi.



Partecipa alla community