


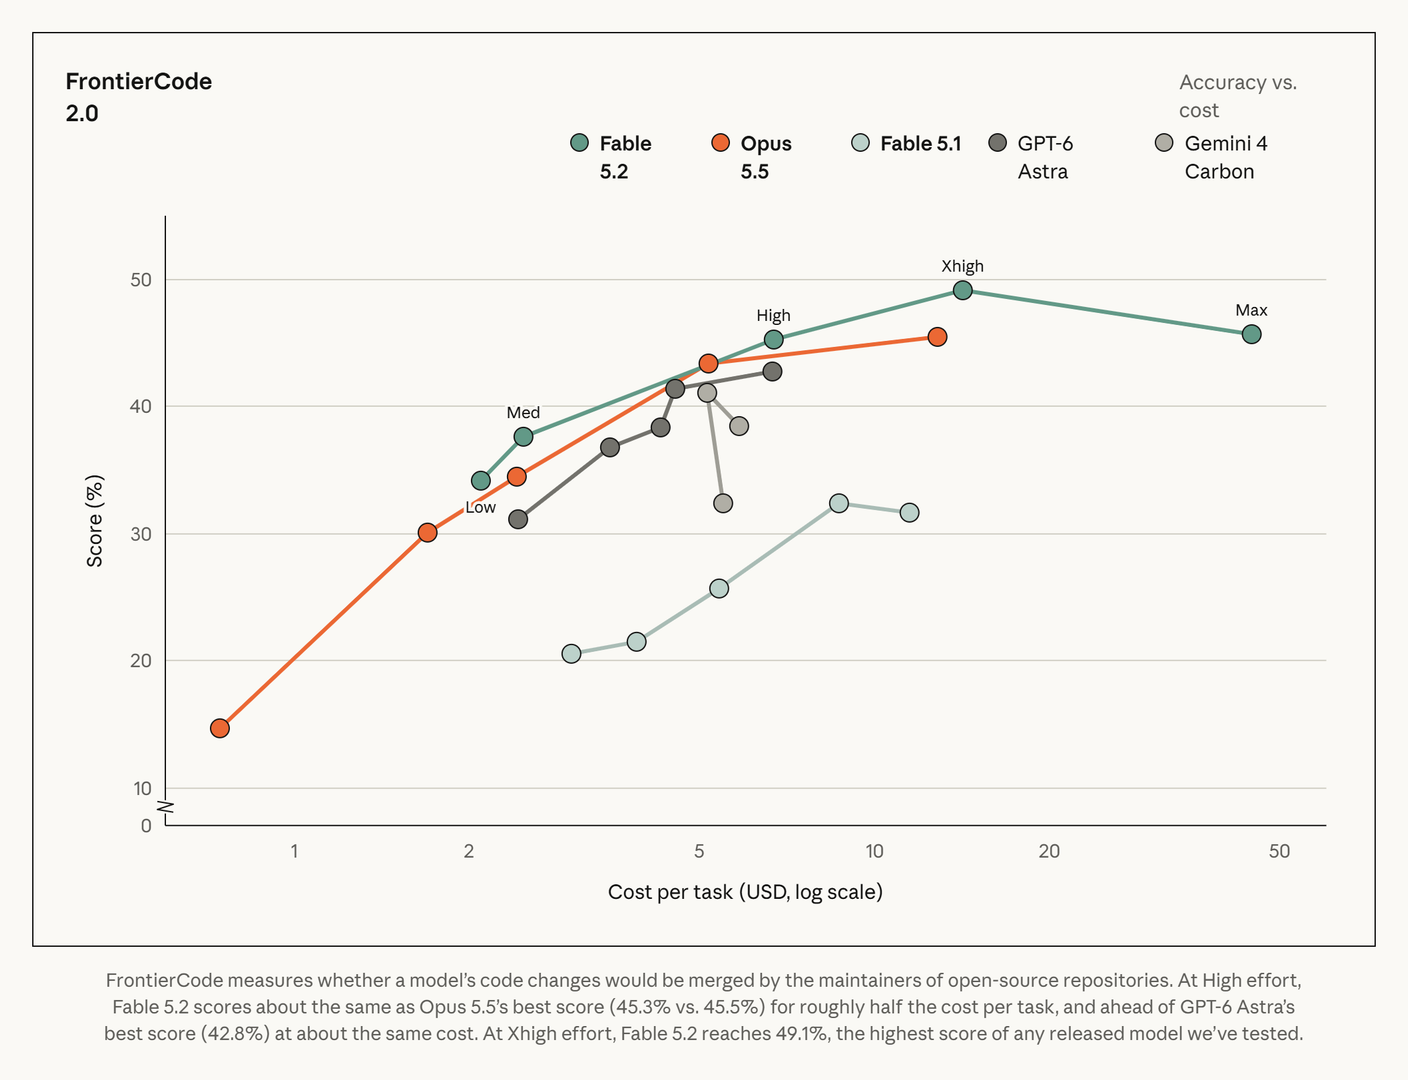
Anthropic ha lanciato il 9 novembre Claude Fable 5.2 e Claude Mythos 5.2, due versioni di uno stesso modello progettato per attività tecniche difficili e lavori affidati ad agenti AI. Nei test di programmazione pubblicati dall’azienda Fable 5.2 supera Claude Opus 5.5 e GPT-6 Astra: il suo punteggio su FrontierCode 2.0 è del 49,1%, contro il 45,5% e il 42,8%. L’API costa il 20% in meno della versione precedente, ma il doppio di Claude Opus 5.5 a parità di token.
Per le imprese, la vera novità è la possibilità di affidare ai modelli progetti lunghi e articolati, nei quali numerosi agenti scrivono codice, interrogano documenti e controllano i risultati. L’interrogativo economico è se il lavoro completato valga il costo e il tempo necessari.
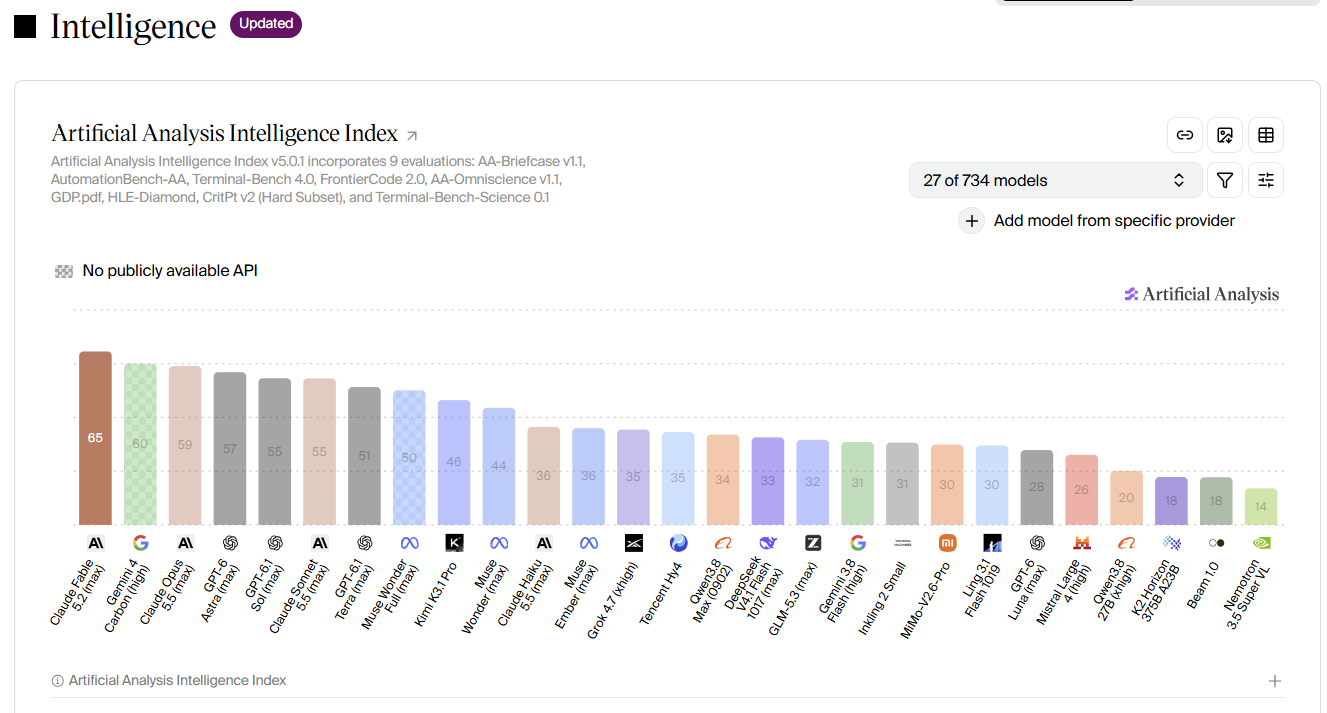
Una prima valutazione indipendente di Artificial Analysis mette Fable 5.2 al primo posto del proprio Intelligence Index nella configurazione Max, ma lo segnala anche tra i più lenti e costosi per attività.
Indice degli argomenti:
Claude Fable 5.2 nei benchmark: guida nel coding, ma non in tutto
Anthropic indica i progressi maggiori nel coding agentico, cioè nella capacità di modificare e collaudare software attraverso una successione di azioni autonome. FrontierCode 2.0 misura la qualità delle modifiche proposte a progetti open source, considerando se gli sviluppatori le integrerebbero. Il modello raggiunge il 49,1% con il livello di sforzo Xhigh, rispetto al 32,4% di Fable 5.1. Il risultato è prodotto nei test Anthropic, su configurazioni dichiarate dall’azienda.
Le prestazioni cambiano con il compito. Nel test FrontierSWE v2 Fable 5.2 arriva al 69,9% contro il 65,5% di GPT-6 Astra. Ma sul benchmark AutomationBench, dedicato ai processi aziendali, Gemini 4 Carbon è davanti: 53,9% contro il 51,4% di Fable 5.2. Non esiste quindi un primato valido per ogni applicazione. In particolare, i punteggi della tabella Anthropic dipendono da strumenti, livello di sforzo e protocollo adottati: alcuni confronti impiegano configurazioni differenti.
Il riscontro indipendente: più capacità significa più tempo e spesa
Artificial Analysis ha sottoposto Fable 5.2 alle proprie valutazioni e lo colloca a 65 punti nell’Intelligence Index con sforzo Max, in testa ai 74 modelli della classifica consultata il 10 novembre. Per completare mediamente un’attività dell’indice, però, questa configurazione impiega 46,4 minuti e spende 26,54 dollari. L’analisi è indipendente da Anthropic e comprende prove diverse, fra cui coding, ragionamento e attività professionali.
Un secondo dato spiega perché la scelta del livello di ragionamento è decisiva: con sforzo Medium il medesimo modello ottiene 56 punti, con un tempo medio di 8,3 minuti e un costo di 3,80 dollari per attività. Si tratta di medie sui test specifici di Artificial Analysis: non sono tempi d’attesa garantiti per un utente né preventivi per un progetto aziendale.
Lo stesso modello ai diversi livelli di sforzo: test indipendenti
| Configurazione | Intelligence Index | Tempo per attività | Costo per attività |
|---|---|---|---|
| Fable 5.2 Medium | 56 punti | 8,3 min | 3,80 $ |
| Fable 5.2 Max | 65 punti | 46,4 min | 26,54 $ |
Fonte: Artificial Analysis, Medium e Max, rilevazione consultata il 10 novembre 2026. Tempi e costi medi dei compiti dell’Intelligence Index, non di un generico processo aziendale.
Il confronto non contraddice l’annuncio Anthropic secondo cui Fable 5.2 genera testo fino al 30% più velocemente rispetto a Fable 5.1. La velocità di produzione dei token e il tempo complessivo richiesto per risolvere un problema sono due misure diverse: un sistema che ragiona più a lungo o avvia molti passaggi può completare un’attività dopo un tempo maggiore anche quando produce testo più rapidamente.
Agenti AI: da singole istruzioni a interi progetti software
Anthropic descrive una prova interna nella quale Fable 5.2 ha coordinato oltre mille agenti per otto giorni allo scopo di costruire un sistema operativo sperimentale, con avvio su un computer portatile, gestione di file e driver. In un altro caso un gruppo di agenti ha migrato un servizio da Python a Rust; secondo l’azienda, il nuovo software si avvia circa 26 volte più rapidamente. Sono esempi realizzati con infrastrutture e supervisione dedicate, non prestazioni automaticamente riproducibili da qualsiasi impresa.
Questi risultati mostrano come potrebbe cambiare il lavoro dei team tecnologici. Un agente può esaminare i requisiti, affidare sottocompiti a modelli economici, verificare risultati intermedi e riprendere dopo gli errori. Anthropic propone infatti Fable come Advisor, consultato da modelli più piccoli per problemi particolarmente difficili, oppure come Orchestrator, capace di distribuire il lavoro tra più agenti.
Per un’azienda che gestisce applicazioni complesse, l’opportunità è affidare all’AI migrazioni, analisi di anomalie o manutenzione di grandi codebase. La verifica resta indispensabile sui cambiamenti destinati alla produzione: test, autorizzazioni e revisione umana devono essere progettati come parte del processo, non aggiunti quando il codice è già pronto.
Prezzi API di Fable 5.2: il 20% in meno, ma Opus costa la metà
La nuova tariffa è di 8 dollari per milione di token in input e 40 in output, contro i 10 e 50 dollari di Fable 5.1. La documentazione ufficiale indica una finestra di contesto fino a un milione di token, un output massimo di 128mila token, ragionamento adattivo e input testuale o visivo con risposta testuale. Mythos ha lo stesso listino di Fable.
Prezzi API a listino per un milione di token
| Modello | Input | Output |
|---|---|---|
| Claude Fable 5.1 | 10 $ | 50 $ |
| Claude Fable 5.2 | 8 $ | 40 $ |
| Claude Opus 5.5 | 4 $ | 20 $ |
| Claude Sonnet 5.5 | 2 $ | 10 $ |
Fonte: documentazione Anthropic e comunicato del 9 novembre. Prezzi di listino in dollari, senza cache, fast mode, batch o condizioni commerciali specifiche.
Un esempio chiarisce il confronto: elaborare un milione di token in ingresso e 250mila in uscita costa 18 dollari con Fable 5.2, 9 con Opus 5.5 e 4,50 con Sonnet 5.5, applicando soltanto il listino ordinario. La simulazione usa lo stesso volume di token e non considera cache, sconti, strumenti e differenze nella quantità di ragionamento o di tentativi necessari; perciò non misura il costo di completare con successo un lavoro.
Con la modalità veloce, Anthropic dichiara una generazione fino a 2,5 volte più rapida, ma il prezzo sale a 16 dollari per milione di token in ingresso e 80 in uscita. La piattaforma offre anche il 50% di sconto sugli input e output della Batch API e tariffe dedicate alla cache dei prompt. Queste opzioni incidono sul conto finale quando l’agente rilegge molte volte gli stessi documenti o esegue un gran numero di attività.
Anthropic stessa consiglia Opus 5.5 come punto di partenza per la maggior parte delle attività di coding e conoscenza, riservando Fable ai casi più difficili. Un’impresa può quindi sperimentare un instradamento selettivo: richieste ordinarie a Sonnet o Opus, escalation a Fable quando il modello economico non riesce a concludere il lavoro. Il risparmio dipende dalla qualità dei risultati e dalla frequenza delle escalation.
Mythos 5.2: stesso modello, ma accesso selettivo per cyber e biologia
La distinzione fra i due nuovi Claude riguarda soprattutto le barriere contro gli usi pericolosi. Fable è la versione distribuita al pubblico con maggiori protezioni sulle richieste sensibili in cybersecurity e biologia. Mythos utilizza lo stesso modello sottostante, con protezioni differenti, ed è disponibile alle organizzazioni verificate attraverso i programmi Anthropic per la sicurezza informatica e le scienze della vita. I clienti Enterprise possono utilizzare capacità Mythos tramite Claude Security, secondo le condizioni del servizio.
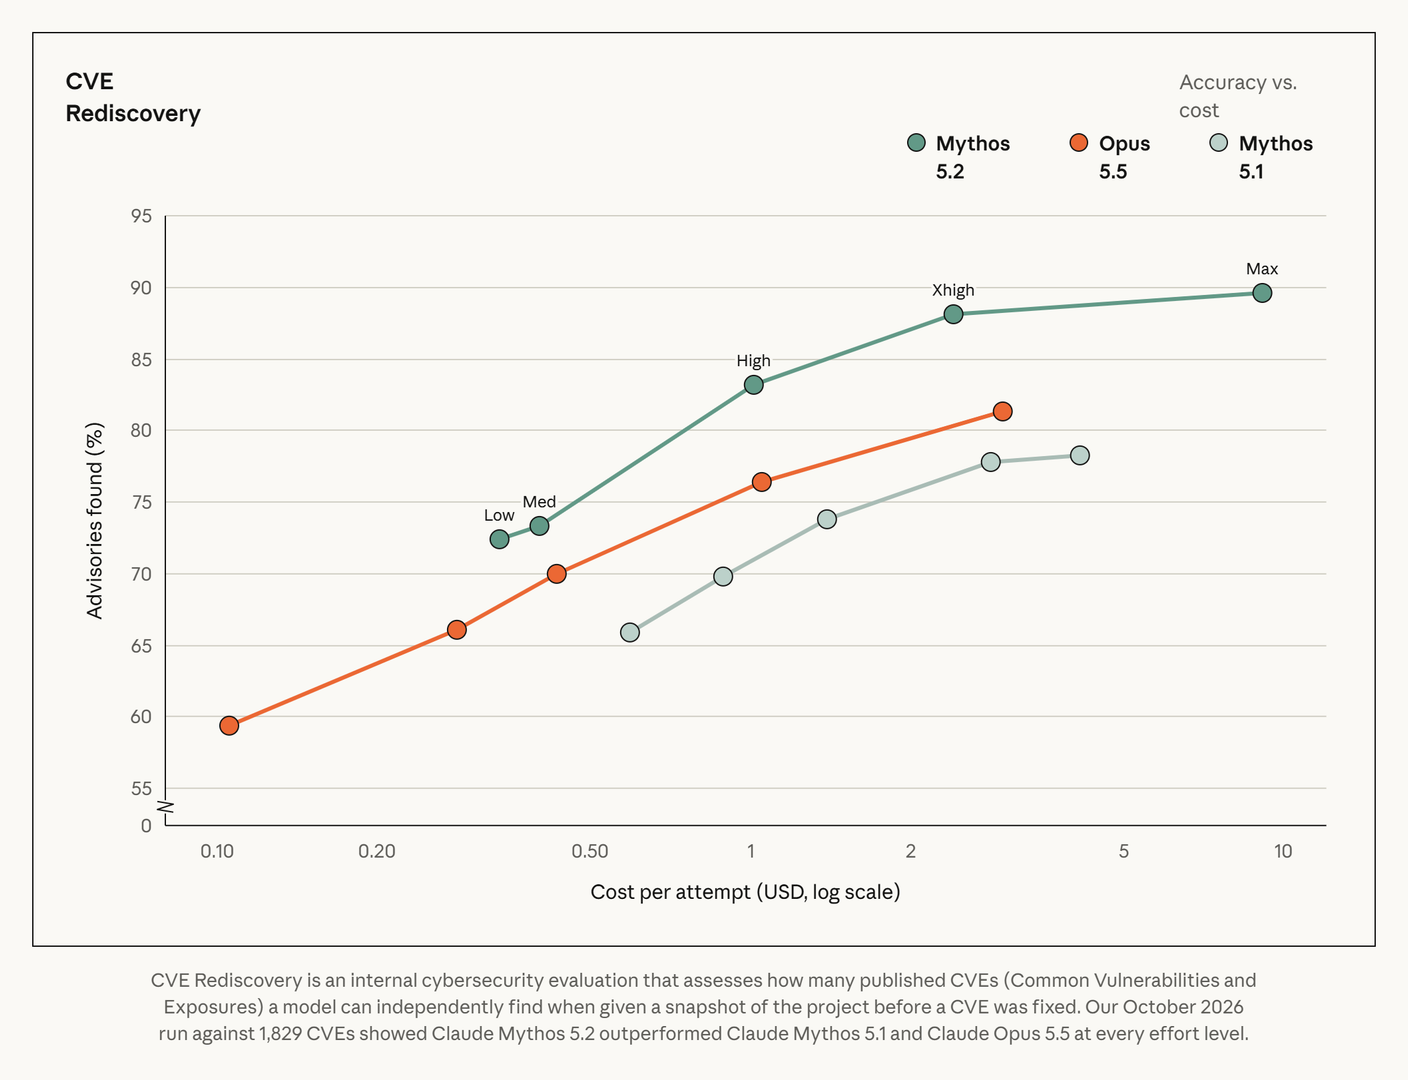
Nei test interni sulle vulnerabilità software, Mythos 5.2 ha individuato l’89,6% di 1.829 vulnerabilità note incluse nella prova CVE Rediscovery di ottobre, contro il 78,3% di Mythos 5.1. Sono risultati del fornitore su un insieme preciso di vulnerabilità pubblicate: per valutare un servizio di sicurezza aziendale servono prove su repository rappresentativi, falsi positivi, qualità delle correzioni e tempi degli analisti.
La crescita delle capacità rende importante anche il trattamento dei dati. Anthropic spiega che alcuni controlli sugli abusi analizzano gruppi di richieste e non solo la singola risposta. Per gli utenti che non rientrano nelle condizioni specifiche di conservazione zero, indica 30 giorni di conservazione a fini di sicurezza.
Il sistema Enterprise Frontier Safeguards, che permette controlli nella infrastruttura del cliente anche con conservazione zero, è ancora in beta privata. Per chi opera in settori regolamentati sono condizioni da esaminare nel contratto e nella valutazione privacy.
Secondo Anthropic, anche UK AI Security Institute e METR hanno effettuato valutazioni prima del rilascio. La società precisa però che questi organismi non hanno revisionato il comunicato né ne hanno necessariamente condiviso le conclusioni. Inoltre Anthropic afferma di aver limitato già durante l’addestramento alcune capacità di ricerca direttamente utili a migliorare modelli linguistici e acceleratori: su questi temi Fable e Mythos si fermerebbero circa al livello di Opus 5.5, con ricorso dichiarato a Opus 5 per una ristretta categoria di richieste.
Ricerca scientifica: che cosa è stato davvero dimostrato
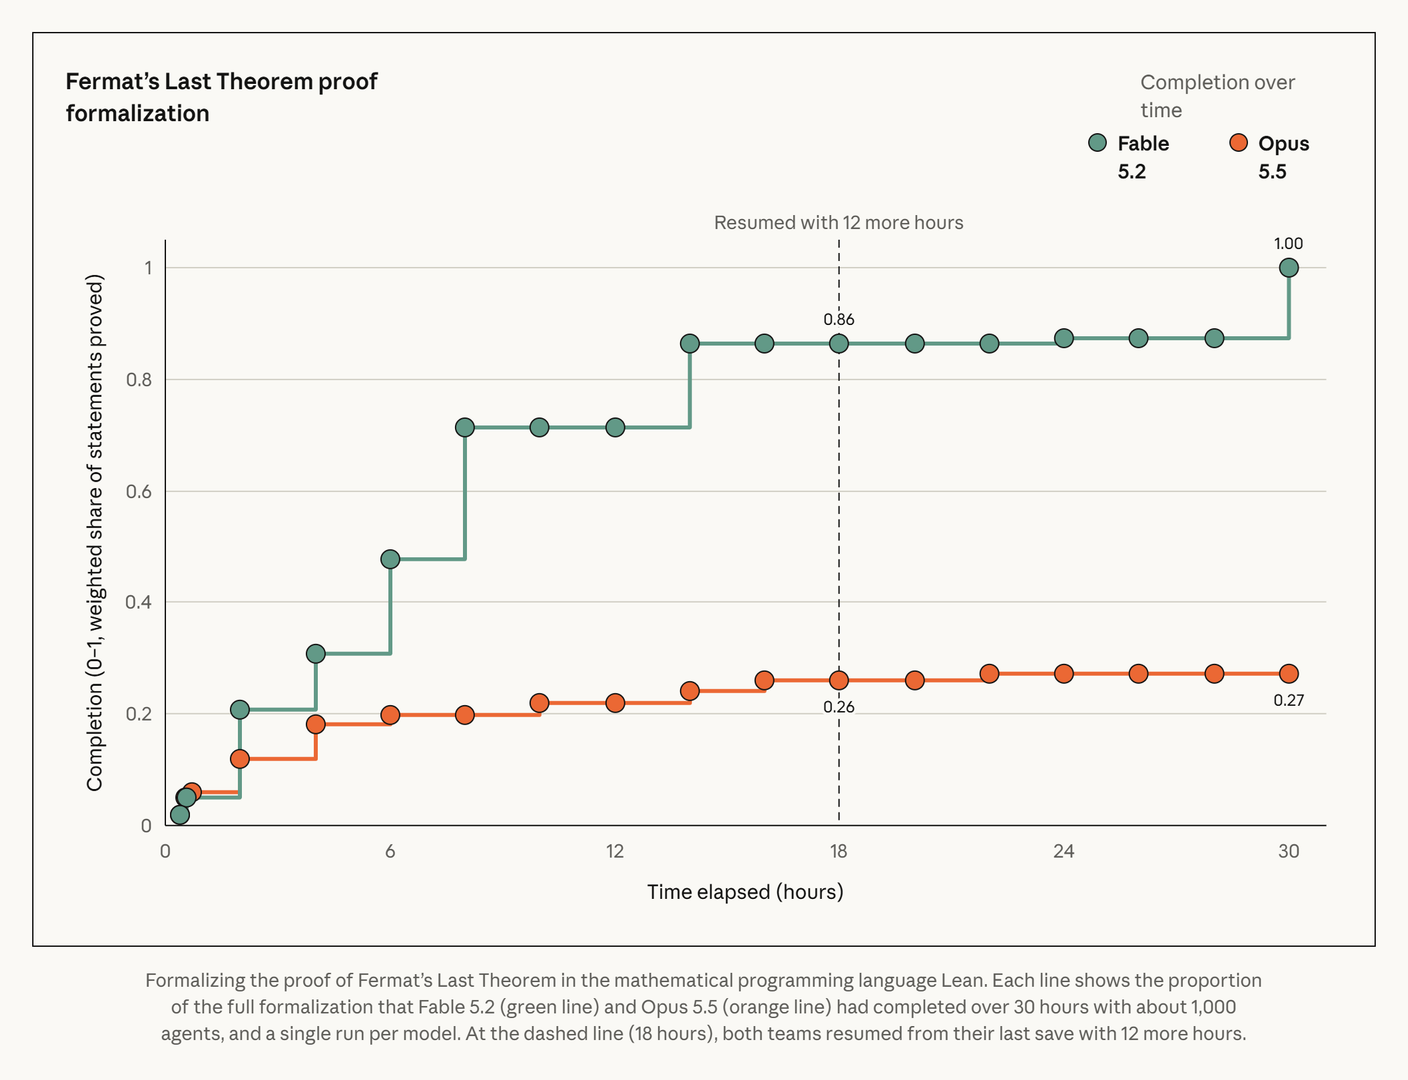
Anthropic documenta anche l’uso di Fable 5.2 per formalizzare in 30 ore una dimostrazione del teorema di Fermat, coordinando circa mille agenti. Formalizzare significa tradurre una dimostrazione già conosciuta in un linguaggio che un verificatore automatico può controllare: è diverso da scoprire per la prima volta il teorema. Il gruppo riporta inoltre progressi su due problemi di fisica teorica dei buchi neri e nella progettazione di tre dispositivi elettronici funzionanti, assemblati con il supporto di Diode.
Per la ricerca e l’ingegneria delle imprese, il segnale più promettente è la possibilità di automatizzare cicli lunghi di progettazione e verifica, dalla simulazione al controllo formale. Gli esempi Anthropic richiedono però replica e valutazione delle risorse impiegate prima di trasferire i risultati a processi industriali ordinari.
Come valutare Fable 5.2 in un’impresa italiana
La decisione pratica riguarda quali attività affidare al modello più potente. Ha senso partire da un gruppo limitato di casi complessi: migrazione di software, ricerca su grandi archivi, revisione di codice e analisi tecnico-finanziarie. Il confronto dovrebbe misurare almeno il tasso di completamento corretto, il tempo complessivo, i token consumati, le correzioni umane e gli errori che arrivano fino alla produzione.
Se il problema è risolvibile con Opus o Sonnet, il maggior prezzo di Fable difficilmente si giustifica. Se invece il modello più potente permette di chiudere una pratica che prima richiedeva molti tentativi o ore di lavoro specialistico, il costo per attività riuscita può diventare il parametro decisivo. Il lancio di Anthropic mostra un avanzamento misurabile delle capacità degli agenti, ma la convenienza emerge soltanto quando benchmark, consumo e risultati vengono misurati sul lavoro reale.



Partecipa alla community