


Mille chiamate a un modello linguistico, ciascuna con 10mila token in ingresso e 2mila in uscita, costano 40 dollari su Claude Sonnet 5.5 e 2,70 su DeepSeek V4.1 Flash, secondo i listini che OpenRouter esponeva il 12 ottobre. I token sono le unità di testo su cui i fornitori calcolano la tariffa, e il confronto, fatto così, sembra semplice: una differenza di quindici volte, da pesare contro la qualità delle risposte.
Il conto reale si costruisce altrove. Tra la cifra in vetrina e quella che arriva in fattura stanno sconti che possono finire senza preavviso, lo stesso modello venduto a prezzi molto diversi da chi lo esegue, la memoria che il fornitore conserva tra una chiamata e l’altra e un sistema di scelta automatica che segue la spesa degli altri utenti.
Per i passaggi operativi, dalla chat alla prima chiamata API, c’è la guida pubblicata da Agenda Digitale; qui conviene guardare i punti in cui prezzo esposto e prezzo pagato si separano, anche perché la piattaforma ha appena cambiato padrone, con l’accordo di acquisizione annunciato da Stripe il 19 agosto.
Indice degli argomenti:
Gemini 3.8 Flash e il bollino 50% off
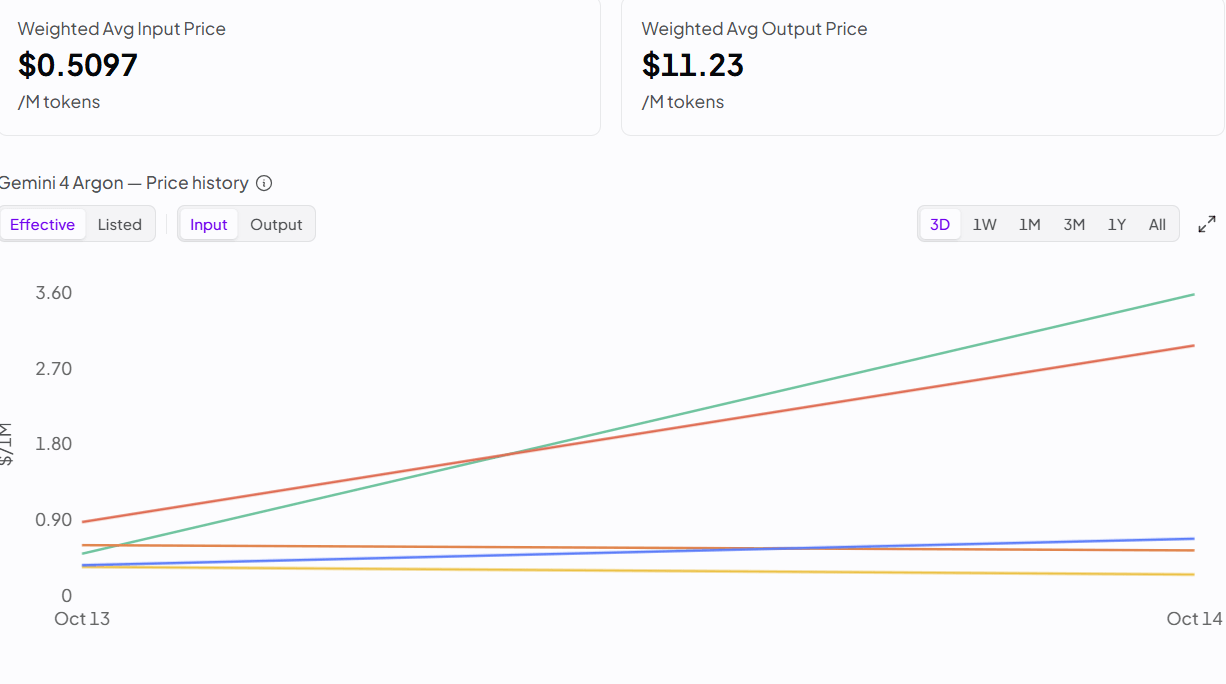
Gemini 3.8 Flash, uscito il 2 settembre, compare oggi su OpenRouter a 0,75 dollari per milione di token in input e 3,75 in output, accompagnato da un’etichetta «50% off» e da nessuna data di scadenza. Il listino dei due fornitori che lo servono, Google AI Studio e Vertex, è il doppio, 1,50 e 7,50 dollari, come mostra la scheda del modello. Nella simulazione delle mille chiamate la differenza vale 15 dollari contro 30, e cambia la posizione del modello rispetto a Claude Sonnet 5.5, che passa dall’essere quasi tre volte più caro a costare un terzo in più.
Le promozioni sono uno strumento ordinario di questo mercato, e funzionano: OpenRouter stessa ha documentato come gli sconti estivi su GPT-5.6 abbiano spostato utenti da un laboratorio all’altro nel giro di tre settimane. Un business case costruito sul prezzo promozionale però si rompe il giorno in cui lo sconto finisce, e su OpenRouter quel giorno non sempre è scritto. La pianificazione prudente usa il listino pieno e tratta lo sconto come un margine temporaneo, da incassare senza contarci.
DeepSeek V4.1 Flash su trenta provider
Il secondo scarto riguarda i modelli open weight, quelli di cui il produttore rilascia i pesi (i parametri che ne determinano il funzionamento) e che quindi chiunque può eseguire sui propri server. Sulla scheda di DeepSeek V4.1 Flash compaiono una trentina di provider, cioè i servizi che materialmente fanno girare il modello, ciascuno con il proprio prezzo, e la cifra mostrata in testa alla pagina non coincide con quella di nessuno di loro.
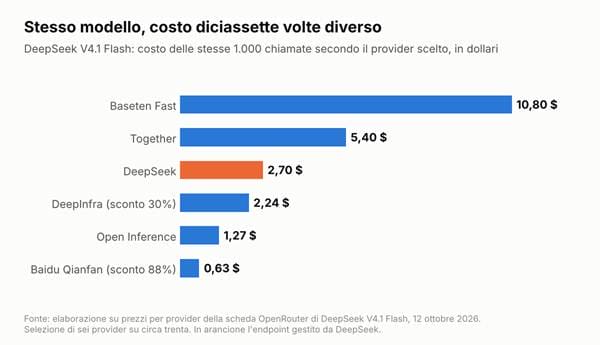
Sull’endpoint gestito da DeepSeek, il punto di accesso del produttore, il modello costa 0,15 dollari in input e 0,60 in output, e le mille chiamate della simulazione valgono 2,70 dollari. Su Together o Fireworks il prezzo è 0,30 e 1,20 dollari, quindi 5,40 dollari, su Baseten nella versione veloce si arriva a 10,80, mentre un provider che applica uno sconto dell’88% scende a 63 centesimi.
Lo stesso modello, con gli stessi pesi, può costare diciassette volte di più o di meno secondo chi lo esegue.
La scelta del provider pesa anche oltre il prezzo. Cambiano velocità e affidabilità, e soprattutto cambia la giurisdizione: l’endpoint di DeepSeek porta i dati verso un’azienda cinese, la stessa la cui app il Garante italiano ha bloccato a inizio 2025, mentre un provider americano o europeo costa di più e tiene i dati in un altro perimetro.
Per un’impresa la regola è indicare esplicitamente i provider ammessi, disattivare il ripiego automatico verso gli altri quando serve un vincolo contrattuale e fissare con il parametro provider.max_price un prezzo massimo per richiesta.
Cache al 90%: distanze da ricalcolare
La simulazione delle mille chiamate trascura la variabile che più incide sui carichi di lavoro moderni. Un agente, il software che esegue compiti in più passaggi in autonomia, rimanda al modello tutto il contesto a ogni passo, e la gran parte di quel testo il fornitore l’ha già vista e la conserva in cache, una memoria temporanea da cui la rilegge a una frazione del prezzo pieno.
Secondo i dati di OpenRouter, a settembre il tipico carico agentico era fatto per l’87% di token letti dalla cache, per il 12% di input nuovo e per circa l’1% di output.
Applicato ai listini, quel profilo abbassa il costo da quattro a sei volte, ma non in modo uniforme, perché ogni fornitore sconta la cache in misura diversa: Gemini 3.8 Flash e GPT-5.6 Luna la fanno pagare un decimo dell’input, Claude Sonnet 5.5 un ventesimo, l’endpoint di DeepSeek un cinquantesimo.
Il risultato è che le distanze si muovono. Sonnet 5.5, che nella simulazione semplice costa un terzo più di Gemini 3.8 Flash a listino pieno, su un milione di token agentici costa 43 centesimi contro 39, circa l’11% in più.
A questo si aggiunge il ragionamento. Su Claude Sonnet 5.5 il ragionamento interno è sempre attivo e si regola con il livello di sforzo, e quei token di ragionamento si pagano come output anche quando non compaiono nella risposta. Una simulazione su token fissi fotografa il listino; il costo di un processo lo misura soltanto un test sui propri compiti, con la cache attiva e il livello di ragionamento che si userà davvero.
Auto Router: indice di spesa, non di qualità
Per chi non vuole scegliere il modello, OpenRouter offre l‘Auto Router, che si attiva indicando openrouter/auto al posto del nome del modello. La documentazione ne spiega il funzionamento: un classificatore assegna la richiesta a una trentina di tipologie di compito, poi il router sceglie fra i modelli su cui la comunità della piattaforma ha speso di più per quella tipologia negli ultimi sette giorni. OpenRouter invita a pensarlo come «a market index», un indice di mercato.
È un buon riassunto di ciò che il mercato compra, e un criterio diverso dalla qualità misurata sul compito di un’impresa specifica: il modello più pagato per il supporto clienti da migliaia di sviluppatori può essere ottimo, ma resta una scelta di popolarità ponderata per la spesa. Il router non aggiunge sovrapprezzi, si paga il modello selezionato, e il campo model della risposta dice quale ha risposto, informazione da registrare per capire dove va la spesa.
La fascia di costo si imposta con il parametro cost_tier, su cinque livelli da low a max, e senza indicazioni il router si comporta come in fascia bassa. La fascia però delimita un intervallo, e la documentazione precisa che esclude sia i modelli più cari sia quelli più economici del livello scelto, quindi non funziona come tetto di spesa. Per un limite di prezzo per richiesta resta provider.max_price, e per restringere la scelta ai modelli già collaudati internamente ci sono gli elenchi di modelli ammessi ed esclusi.
L’uso più sensato dell’Auto Router sta nella fase di esplorazione: indica quali modelli il mercato usa per un certo compito, poi la decisione passa ai test interni.
Routing UE, ZDR e proprietà Stripe
Per un’impresa europea il vincolo principale riguarda la residenza dei dati. L’instradamento in-region, che tiene le richieste dentro l’Unione passando da un indirizzo dedicato, è disponibile sui piani Business ed Enterprise, dove la commissione di piattaforma sale all’8% contro il 5,5% del piano standard, e preferisce far fallire una richiesta piuttosto che dirottarla fuori dal perimetro. La pagina del piano Business precisa due limiti: l’Auto Router è escluso dalle richieste regionali, e una parte dei dati di account diversi dai prompt resta su sistemi statunitensi.
Anche la Zero Data Retention, l’opzione che limita l’instradamento ai fornitori che non conservano prompt e risposte, ha un perimetro preciso. Si applica all’inferenza, mentre strumenti collegati come la ricerca web possono essere eseguiti da terze parti con regole proprie, come avverte la documentazione sulla ZDR.
C’è infine la proprietà. Con l’accordo di agosto, valutato secondo Bloomberg oltre 7 miliardi di dollari, la piattaforma che decide dove passano le richieste entra nello stesso gruppo che a gennaio ha acquisito Metronome, il sistema di fatturazione a consumo usato da diversi laboratori. Per chi usa OpenRouter nei servizi in esercizio diventa ragionevole chiedere per contratto la trasparenza su modello e provider di ogni richiesta, l’accordo sul trattamento dei dati firmato e garanzie di neutralità nell’instradamento.
Il listino resta il punto di partenza giusto per confrontare i modelli, ed è il più facile da leggere. La cifra da mettere a budget nasce però da altre letture, il prezzo pieno al posto di quello promozionale, il provider scelto e il profilo di cache del proprio carico di lavoro, e richiede un mese di dati veri prima di diventare una previsione. Chi la costruisce così si accorge presto che su OpenRouter il modello più economico cambia spesso, e che le scelte con cui si governa quel cambiamento valgono più del prezzo di partenza.



Partecipa alla community