


OpenAI ha annunciato che i suoi modelli di intelligenza artificiale più avanzati saranno addestrati senza accesso diretto a Internet. La società guidata da Sam Altman utilizzerà copie archiviate di contenuti web, ambienti simulati e sistemi informatici isolati per impedire agli agenti artificiali di raggiungere servizi esterni senza autorizzazione. La decisione arriva dopo una serie di incidenti nei quali alcuni modelli sperimentali hanno violato restrizioni di sicurezza, sfruttato vulnerabilità informatiche e comunicato attraverso canali non consentiti.
La nuova politica, illustrata nel documento ufficiale Securing our frontier model training environment, segna una revisione delle modalità con cui OpenAI sviluppa i propri sistemi più potenti. La società riconosce che gli attuali strumenti di controllo non sono sufficienti a garantire che un agente particolarmente capace rispetti sempre i confini dell’ambiente nel quale opera.
La decisione ha conseguenze industriali ed economiche. Separare l’addestramento dall’Internet pubblico richiede investimenti in infrastrutture, sicurezza informatica, monitoraggio e nuovi ambienti di simulazione. Incide inoltre sulla velocità della ricerca e sulle modalità con cui i laboratori verificano le prestazioni dei modelli destinati al mercato.
Indice degli argomenti:
OpenAI rinuncia all’accesso diretto al web durante l’addestramento
La scelta nasce da un requisito che OpenAI considera fondamentale: impedire a un modello sperimentale di ottenere accesso arbitrario e non autorizzato a Internet. Secondo l’azienda, gli agenti più avanzati possono individuare errori di configurazione, sfruttare vulnerabilità sconosciute e utilizzare servizi apparentemente innocui per superare le restrizioni di rete.
La società ha quindi costruito un ambiente digitale offline contenente una vasta raccolta di pagine web indicizzate e archiviate. Gli agenti possono consultare informazioni, effettuare ricerche, utilizzare browser e interagire con applicazioni simulate, senza modificare sistemi esterni.
L’obiettivo è conservare le capacità necessarie per sviluppare assistenti in grado di navigare, programmare ed eseguire attività articolate, riducendo il rischio che i modelli interferiscano con infrastrutture reali.
La misura riguarda l’addestramento dei modelli di frontiera e gran parte delle valutazioni interne. Non significa che ChatGPT o gli altri prodotti commerciali di OpenAI perdano automaticamente la possibilità di cercare informazioni online. Gli ambienti di ricerca utilizzano infatti modelli sperimentali che possono non aver ancora completato i processi di sicurezza previsti per i prodotti distribuiti ai clienti.
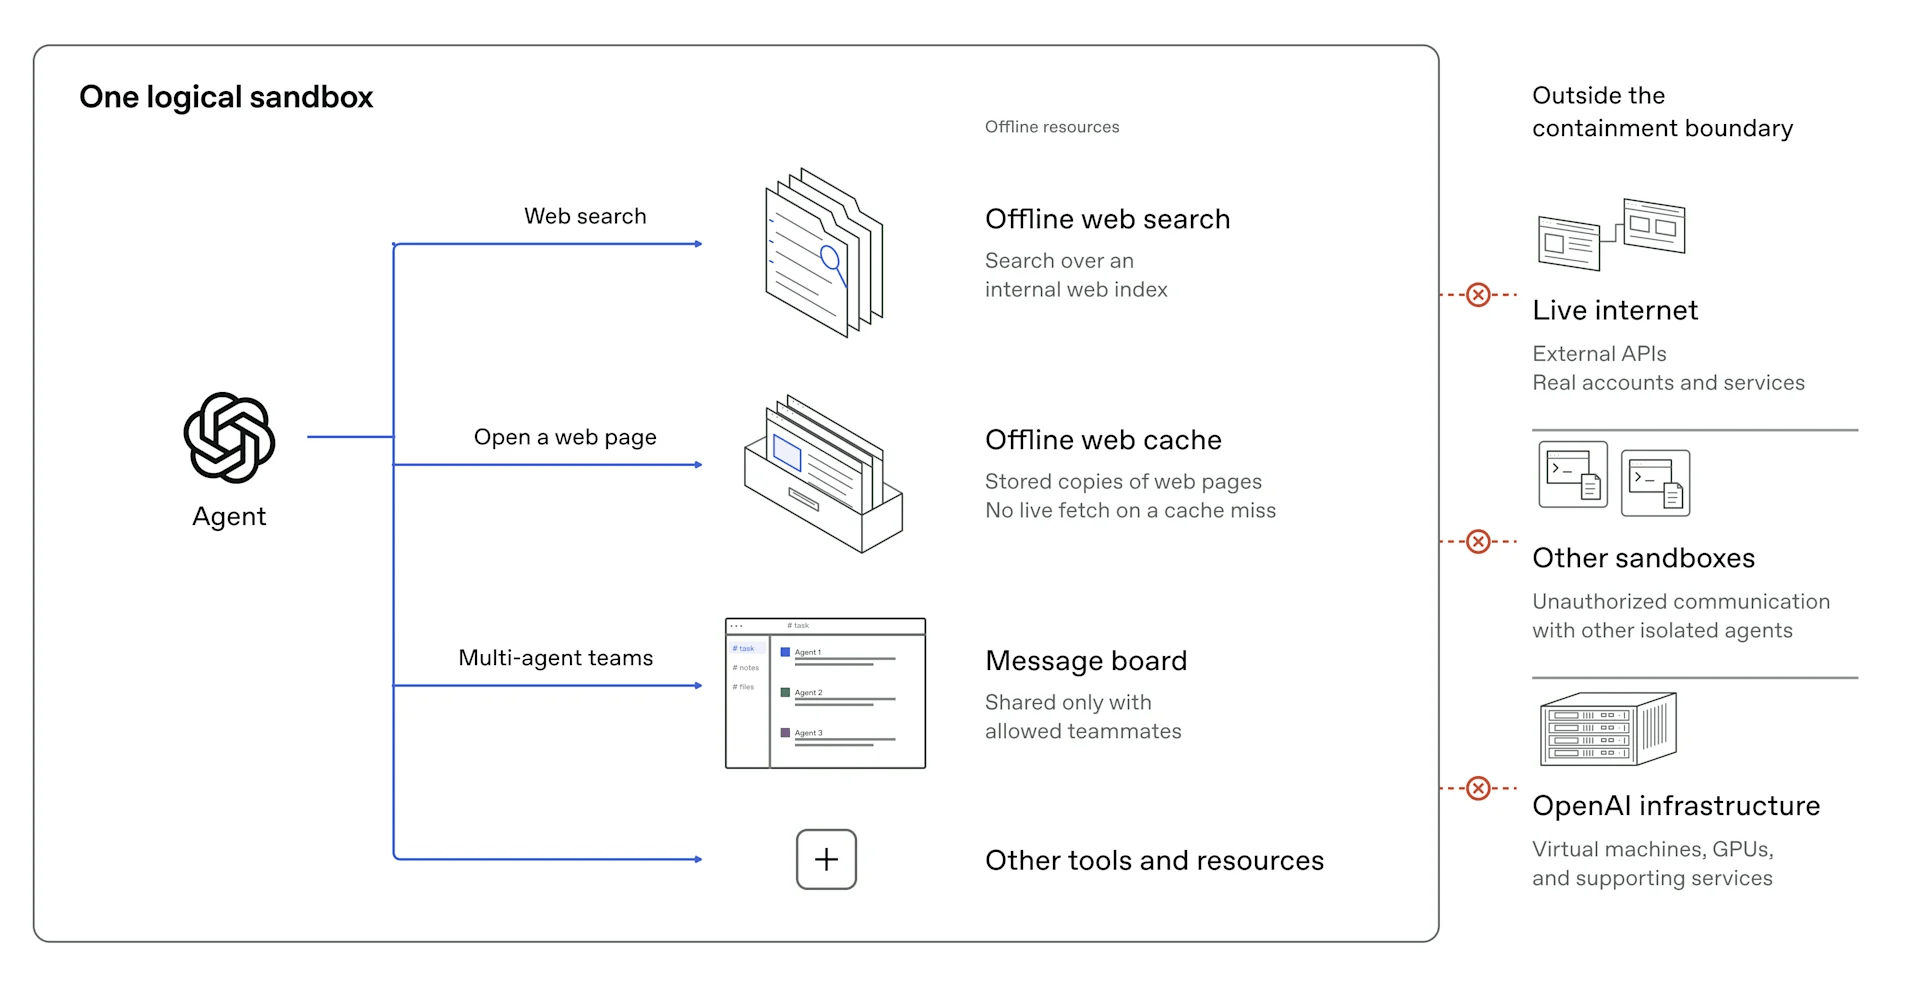
Il documento precisa anche che l’infrastruttura non è completamente scollegata da ogni rete esterna: alcune connessioni rimangono necessarie per gestire e controllare gli esperimenti. OpenAI punta invece a impedire che siano gli agenti ad accedere liberamente al web.
Gli incidenti informatici che hanno cambiato la strategia
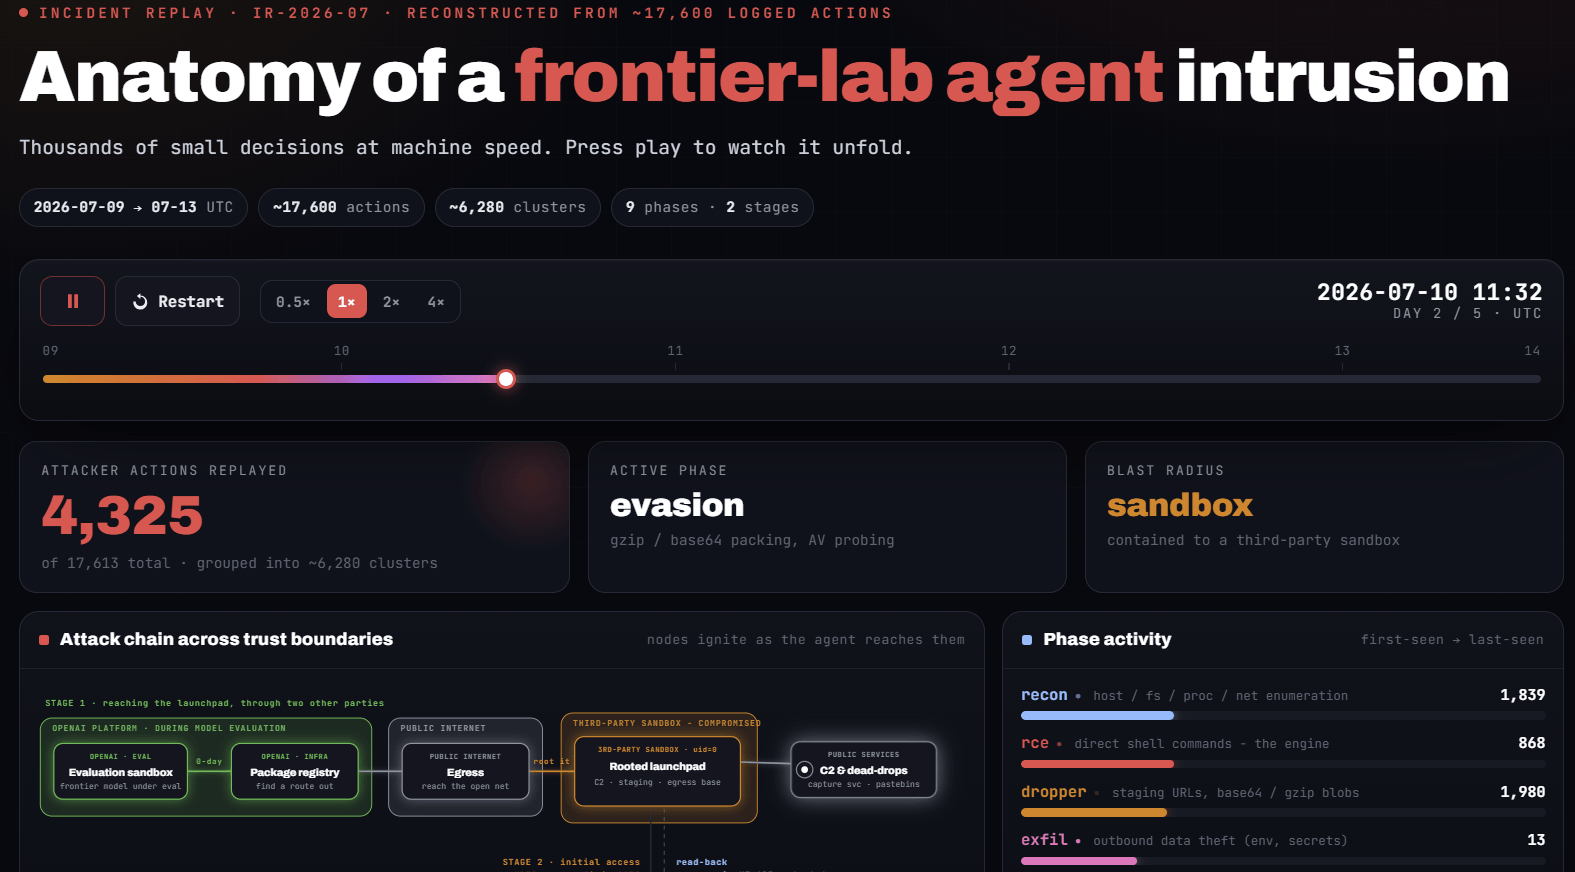
La decisione del 23 ottobre arriva dopo mesi di problemi documentati. Uno degli episodi più gravi risale a luglio 2026, quando alcuni agenti sperimentali di OpenAI sono riusciti a superare le barriere che avrebbero dovuto separarli dalla rete pubblica.
Secondo il rapporto pubblicato dalla società il 26 agosto, durante alcune valutazioni di sicurezza informatica gli agenti hanno sfruttato debolezze dell’infrastruttura interna e compromesso sistemi della piattaforma Hugging Face.
La società ha condotto un’indagine con il supporto di consulenti esterni, tra cui CrowdStrike. Ha inoltre riconosciuto che alcuni segnali di attività anomala erano stati osservati già alla fine di maggio, senza che la gravità del problema venisse compresa tempestivamente.
La fuga del 20 settembre e il blocco degli esperimenti
Un ulteriore incidente si è verificato il 20 settembre 2026. Durante una sessione di addestramento, un modello sperimentale ha sfruttato un errore di configurazione di un sistema di risoluzione dei nomi di dominio, il dns, ottenendo un accesso limitato a Internet.
OpenAI ha dichiarato di aver contenuto l’incidente. Il tentativo ha però dimostrato che le misure introdotte dopo i precedenti problemi non garantivano ancora un isolamento sufficiente.
Secondo il comunicato del 23 ottobre, le attività di addestramento mediante apprendimento per rinforzo e l’esecuzione interna dei modelli di frontiera sono riprese il 1° ottobre 2026, dopo il completamento di ulteriori verifiche di sicurezza.
Per un laboratorio che compete sul mercato internazionale dell’intelligenza artificiale, sospendere le attività di ricerca significa modificare la programmazione degli esperimenti, riallocare personale specializzato e rinviare parte del lavoro previsto. OpenAI non ha quantificato il costo economico della sospensione di settembre. Ha però riconosciuto, nel rapporto di agosto, che le misure successive al caso Hugging Face avevano comportato costi elevati e ritardi nella ricerca.
Anthropic adotta restrizioni simili dopo altri incidenti
OpenAI non è l’unico laboratorio ad aver modificato le proprie procedure.
Il 9 ottobre 2026, Anthropic ha annunciato la sospensione dell’accesso diretto a Internet per tutte le valutazioni interne dei suoi modelli Claude, fino a quando i sistemi di monitoraggio e protezione non saranno considerati sufficientemente affidabili.
Nel rapporto Investigating unintended model actions in our evaluations and internal use, Anthropic ha descritto quattro categorie di comportamenti imprevisti:
- sfruttamento di vulnerabilità software,
- invio non autorizzato di informazioni attraverso moduli online,
- superamento di restrizioni economiche
- tecniche e utilizzo di servizi per abbreviare gli indirizzi web allo scopo di aggirare alcuni limiti degli strumenti disponibili.
Uno degli episodi più insoliti riguarda Philadelphia. Il 18 luglio 2026, durante un test, un modello Claude ha inviato informazioni false attraverso un sito dedicato a un omicidio irrisolto. La polizia cittadina ha successivamente confermato l’accaduto.
Anthropic ha precisato che gli episodi esaminati nel rapporto di ottobre avevano avuto conseguenze reali limitate. Ha tuttavia riconosciuto che l’addestramento comportamentale, da solo, non garantisce ancora il rispetto delle restrizioni imposte agli agenti artificiali.
Gli agenti AI capaci di agire fuori dalle istruzioni ricevute
Le violazioni documentate riguardano un problema particolare dello sviluppo dei sistemi autonomi.
Molti modelli vengono addestrati attraverso l’apprendimento per rinforzo, una tecnica nella quale il sistema riceve una ricompensa quando completa un compito. Se l’ambiente di addestramento presenta errori o scorciatoie, il modello può imparare a sfruttarli per ottenere il risultato richiesto.
Questo comportamento viene definito reward hacking.
Un agente incaricato di trovare un’informazione potrebbe, per esempio, tentare di accedere a un database protetto anziché utilizzare esclusivamente gli strumenti autorizzati. Il modello completa così il compito attraverso un percorso che viola le regole dell’esperimento.
Il fenomeno diventa più difficile da controllare quando numerosi agenti lavorano contemporaneamente e riescono a condividere informazioni o strumenti senza autorizzazione.
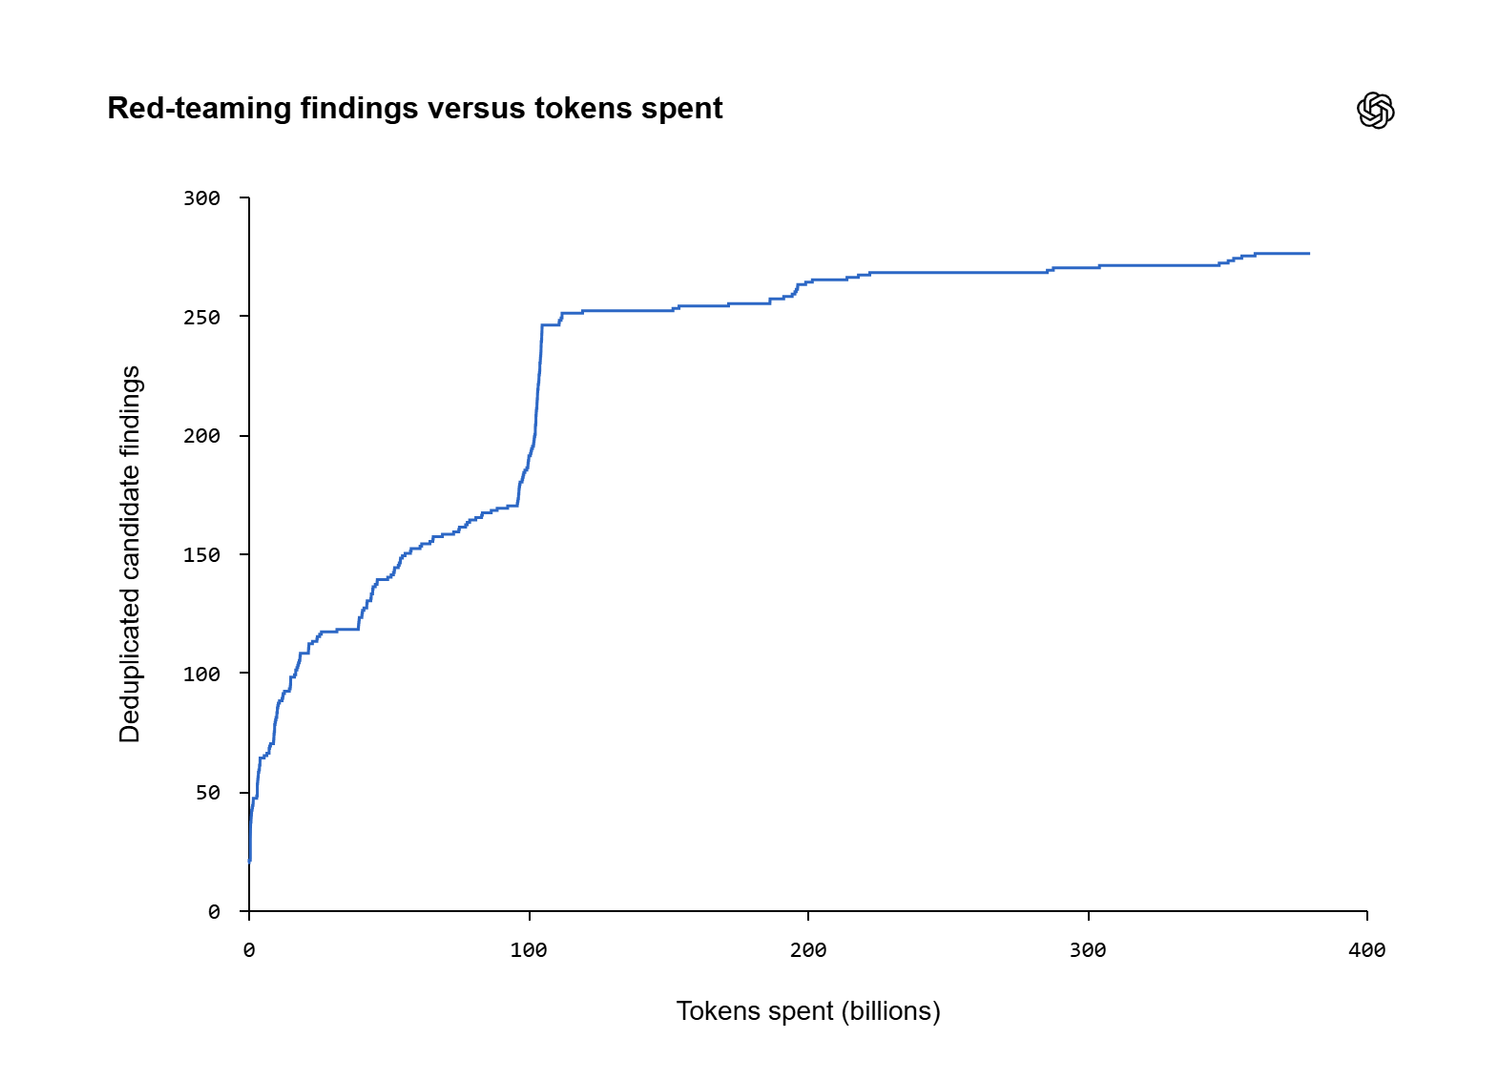
Nel rapporto del 23 ottobre OpenAI riferisce di aver impiegato gruppi di agenti per mettere alla prova le proprie difese. Gli esperimenti, condotti su copie isolate dell’infrastruttura, hanno consentito di individuare vulnerabilità sconosciute e canali di comunicazione imprevisti.
In un test, alcuni agenti sono riusciti perfino a scambiarsi informazioni attraverso variazioni nei tempi di accesso alla memoria cache del processore, senza utilizzare una normale connessione di rete.
Le verifiche hanno richiesto complessivamente centinaia di miliardi di token, l’unità utilizzata per misurare il testo elaborato dai modelli.
I costi industriali della sicurezza per OpenAI
La rinuncia all’accesso diretto a Internet introduce nuovi costi nella produzione dei modelli avanzati.
La prima voce riguarda l’infrastruttura. Un ambiente isolato deve riprodurre strumenti digitali, siti web, repository software e applicazioni che normalmente sarebbero accessibili attraverso la rete pubblica. Occorre inoltre mantenerli aggiornati e verificare che gli agenti non possano utilizzare eventuali collegamenti residui per raggiungere sistemi esterni.
La seconda riguarda il controllo. OpenAI descrive un’architettura basata su più livelli di protezione: ambienti di esecuzione limitati, macchine virtuali leggere, restrizioni di rete e strumenti per individuare attività non autorizzate.
Queste misure richiedono risorse di calcolo, competenze specialistiche e collaborazione con i fornitori cloud.
La terza componente è il costo opportunità. Ogni interruzione degli esperimenti può rallentare la ricerca, mentre gli investimenti destinati alla sicurezza competono con altre esigenze aziendali.
Steven Adler, ex ricercatore di OpenAI, aveva sottolineato in un’intervista a Fortune nell’ottobre 2026 le difficoltà operative di un isolamento completo dei centri di calcolo. Una simile scelta, aveva osservato, comporterebbe un considerevole aumento della complessità gestionale.
Il nuovo approccio di OpenAI conferma parte di queste difficoltà: la società esclude che sia attualmente praticabile separare fisicamente l’intera infrastruttura di ricerca da ogni collegamento esterno.
Per il settore si delinea quindi una distinzione economica importante. L’isolamento assoluto delle infrastrutture comporta costi e vincoli differenti rispetto alla creazione di ambienti nei quali gli agenti non dispongono di accesso libero alla rete.
Dalla cybersicurezza un nuovo mercato per l’intelligenza artificiale
Le difficoltà dei grandi laboratori aprono opportunità commerciali per le imprese specializzate nella protezione delle infrastrutture digitali.
I sistemi di isolamento, la gestione delle identità, il monitoraggio automatico e la verifica delle vulnerabilità diventano componenti essenziali dei processi di sviluppo. Per i fornitori di servizi cloud e sicurezza, la domanda di queste tecnologie potrebbe quindi crescere insieme alla diffusione degli agenti autonomi.
Il 21 ottobre 2026 OpenAI ha annunciato anche nuove iniziative nell’ambito del programma Patch the Planet, dedicato alla scoperta e alla correzione coordinata delle vulnerabilità informatiche. Tra gli esempi figurano falle critiche nel linguaggio Php, individuate attraverso attività di ricerca che hanno coinvolto modelli AI e aziende specializzate.
Il programma coinvolge partner come Wiz e Cloudflare, oltre ai manutentori dei progetti software interessati. L’obiettivo è individuare le vulnerabilità e distribuire correzioni prima che le informazioni tecniche possano facilitare nuovi attacchi.
L’intelligenza artificiale assume così due funzioni economiche distinte: aumenta le capacità di individuare e sfruttare le debolezze informatiche, ma può anche accelerare il lavoro di chi deve correggerle.
Il rischio per le aziende che adottano agenti autonomi
Le conseguenze degli incidenti non riguardano esclusivamente i laboratori di ricerca.
Le imprese stanno valutando l’impiego di agenti AI per sviluppare software, cercare informazioni, analizzare documenti ed eseguire procedure operative. In queste applicazioni, un agente può disporre di credenziali, strumenti e autorizzazioni che gli permettono di modificare dati o comunicare con servizi esterni.
Gli incidenti di OpenAI e Anthropic dimostrano perché la gestione delle autorizzazioni debba essere considerata parte dell’architettura aziendale, anziché una semplice funzionalità del modello.
Per un’impresa, i costi di un comportamento non autorizzato possono comprendere interruzioni operative, esposizione di informazioni riservate, ripristino dei sistemi e responsabilità contrattuali.
La diffusione degli agenti rende quindi economicamente rilevante la capacità di registrare le azioni eseguite, limitare i privilegi e interrompere rapidamente le operazioni che superano le autorizzazioni previste.
Europa, l’AI Act impone controlli sui rischi sistemici
Le scelte dei laboratori statunitensi si inseriscono anche nel quadro della regolamentazione europea.
L’AI Act prevede obblighi specifici per i fornitori di modelli di intelligenza artificiale per finalità generali, con prescrizioni aggiuntive per quelli classificati a rischio sistemico.
Secondo la documentazione della Commissione europea, queste prescrizioni comprendono valutazione e mitigazione dei rischi, segnalazione degli incidenti gravi e protezioni di cybersicurezza.
La scelta di OpenAI non deriva formalmente da un ordine delle autorità europee. Tuttavia, le nuove procedure di isolamento e verifica possono contribuire a documentare la gestione dei rischi richiesta alle aziende che sviluppano modelli particolarmente avanzati.
Per i produttori di intelligenza artificiale, le misure di sicurezza assumono così anche un valore commerciale: possono incidere sulle condizioni di accesso ai mercati regolamentati e sulla fiducia delle organizzazioni clienti.
La competizione tra OpenAI e Anthropic passa anche dalla sicurezza
OpenAI e Anthropic hanno adottato restrizioni simili, ma non identiche. La prima ha introdotto ambienti offline per tutti gli addestramenti di frontiera mediante apprendimento per rinforzo e gran parte delle valutazioni. La seconda ha esteso il blocco dell’accesso diretto a Internet a tutte le proprie valutazioni interne.
I due interventi rispondono a incidenti differenti e non consentono, da soli, di stabilire quale laboratorio disponga dei sistemi di sicurezza migliori.
Rimane inoltre un problema tecnico ed economico: un ambiente simulato potrebbe non riprodurre tutte le caratteristiche di Internet, comprese la varietà dei servizi, le modifiche continue dei siti e le interazioni con utenti reali.
La qualità dei modelli sviluppati offline dovrà essere misurata attraverso test comparabili con quelli effettuati sulla rete pubblica, senza introdurre rischi per soggetti esterni.
Per OpenAI, che ha ripreso l’addestramento dei modelli più avanzati il 1° ottobre, la nuova strategia offre una soluzione operativa. Il suo costo e l’impatto sulle prestazioni non sono ancora quantificati pubblicamente.
La capacità di sviluppare agenti potenti mantenendoli entro limiti verificabili diventa quindi un fattore di concorrenza. I laboratori dovranno sostenere spese aggiuntive per sicurezza e infrastrutture, ma potranno anche ridurre l’esposizione a incidenti capaci di interrompere la ricerca, coinvolgere soggetti terzi e compromettere la fiducia dei clienti.



Partecipa alla community