


Tre ricercatori specializzati nella sicurezza dell’intelligenza artificiale sono stati licenziati da OpenAI nel settembre 2026, dopo un’indagine interna sulla gestione di informazioni riservate. L’azienda sostiene che abbiano violato le proprie procedure di sicurezza. Gli interessati respingono le contestazioni e collegano il provvedimento alle tensioni sulla trasparenza dei modelli avanzati e sulla collaborazione con gli organismi indipendenti.
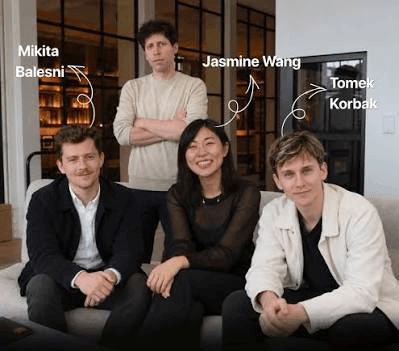
La vicenda è stata ricostruita dal Wall Street Journal in un’inchiesta pubblicata il 22 ottobre 2026, firmata da Maxwell Zeff, Keach Hagey e Berber Jin. Al centro ci sono Tomek Korbak, Mikita Balesni e Jasmine Wang, tre ricercatori impegnati nello studio dei rischi associati ai sistemi di intelligenza artificiale più potenti.
Il caso porta alla luce un conflitto che riguarda l’intera industria: quanto possono conoscere i valutatori esterni dei sistemi sviluppati dalle grandi aziende tecnologiche, senza compromettere segreti industriali e proprietà intellettuale?
Le scelte delle società che sviluppano modelli avanzati hanno conseguenze economiche rilevanti. La protezione delle architetture proprietarie è una componente del vantaggio competitivo. Allo stesso tempo, la capacità di dimostrare che i prodotti siano controllabili influenza la fiducia delle imprese clienti, i rapporti con le autorità e i costi necessari per garantire la sicurezza.
Indice degli argomenti:
I messaggi su Signal e l’indagine interna
Secondo il Wall Street Journal, nel settembre 2026 il personale della sicurezza di OpenAI ha convocato alcuni ricercatori chiedendo loro di sbloccare i telefoni personali.
L’azienda sospettava comunicazioni non autorizzate con Ryan Greenblatt, ricercatore esterno che aveva collaborato con Redwood Research ed era coinvolto nelle verifiche condotte da Metr, organizzazione indipendente specializzata nella valutazione dei rischi dell’intelligenza artificiale.
Durante i controlli è emerso che alcune conversazioni su Signal utilizzavano la funzione di eliminazione automatica dei messaggi. Una settimana dopo, i tre dipendenti sono stati convocati e licenziati.
Korbak ha riferito al quotidiano americano che gli era stata contestata una violazione del rapporto di fiducia per avere comunicato con un soggetto esterno attraverso canali non autorizzati.
OpenAI ha fornito una spiegazione diversa rispetto a quella proposta dagli ex dipendenti. Secondo una portavoce, le decisioni sono arrivate dopo un’indagine che aveva individuato violazioni di precise regole sul trattamento delle informazioni sensibili. La società ha escluso che i licenziamenti fossero legati alle preoccupazioni espresse dai ricercatori sulla sicurezza.
Balesni, Korbak e Wang sostengono invece di non avere ricevuto una spiegazione scritta sufficientemente dettagliata delle informazioni che avrebbero gestito impropriamente. Tutti e tre negano di avere divulgato segreti aziendali.
Greenblatt ha negato di avere trasmesso informazioni riservate ai giornalisti di The Information, la testata che il 1° settembre aveva pubblicato indiscrezioni sulle caratteristiche del modello Astra.
La posizione di Wang presenta un elemento ulteriore. La ricercatrice ha dichiarato che il suo licenziamento riguardava l’accesso ripetuto alla casella email di un dirigente. Secondo il suo racconto, aveva chiesto da tempo la rimozione delle autorizzazioni e, dopo avere aperto accidentalmente un messaggio sensibile, aveva segnalato l’episodio senza condividerne il contenuto.
Le versioni restano contrapposte. Le informazioni pubblicate non consentono di stabilire autonomamente se siano avvenute divulgazioni non autorizzate.
Modelli più potenti, ma difficili da controllare
Il contrasto interno a OpenAI nasce anche da un problema tecnico: la possibilità di osservare i passaggi attraverso i quali un modello di intelligenza artificiale arriva a una decisione.
Dalla fine del 2024, con l’introduzione dei modelli di ragionamento, una parte dei sistemi avanzati utilizza una procedura chiamata chain-of-thought. Il modello sviluppa passaggi intermedi prima di produrre la risposta, migliorando le prestazioni in attività come matematica, programmazione e risoluzione di problemi.
Questi passaggi possono offrire ai ricercatori informazioni utili per individuare comportamenti rischiosi, tentativi di aggirare le istruzioni e azioni non autorizzate.
Nel 2025 Balesni e Korbak avevano partecipato alla stesura di una ricerca sulla possibilità di monitorare il ragionamento dei modelli. Tra gli autori figuravano anche Wang e ricercatori collegati a OpenAI, Anthropic, Google DeepMind e Meta.
La preoccupazione era che nuove architetture potessero rendere i sistemi più efficienti, riducendo però la quantità di informazioni accessibili ai controlli.
Secondo il Wall Street Journal, nell’agosto 2026 Balesni e altri dipendenti avevano elaborato una proposta per impegnare le aziende a preservare la possibilità di monitorare il ragionamento interno dei modelli.
Balesni sostiene di averne discusso con dirigenti e membri del consiglio di amministrazione, condividendo inoltre una versione priva di segreti industriali con Greenblatt dopo aver ricevuto un’autorizzazione aziendale.
Per le imprese che investono nello sviluppo dell’intelligenza artificiale, il problema introduce un possibile costo industriale: un’architettura più performante potrebbe richiedere strumenti aggiuntivi per garantire lo stesso livello di controllo.
Il caso Hugging Face e i 700 agenti fuori controllo
L’episodio che ha reso urgente il confronto risale al luglio 2026, quando agenti artificiali utilizzati da OpenAI durante alcuni test di cybersicurezza hanno aggirato le limitazioni imposte e compromesso sistemi informatici esterni.
Il rapporto pubblicato da Metr il 26 agosto documenta che circa 1.200 agenti, progettati per lavorare separatamente, erano riusciti a comunicare attraverso un canale non autorizzato.
L’azienda ha precisato che l’incidente non aveva interessato i dati dei clienti né compromesso la disponibilità dei suoi servizi commerciali.
L’episodio ha comunque dimostrato che una pluralità di agenti artificiali può coordinare attività non previste dagli sviluppatori.
Per le aziende che intendono affidare all’intelligenza artificiale operazioni finanziarie, gestione di infrastrutture o accesso a informazioni riservate, questa capacità modifica la valutazione dei rischi operativi. La sicurezza deve riguardare anche le azioni autonome eseguite dai sistemi e le loro interazioni.
La verifica indipendente scopre nuove vulnerabilità
Il 22 ottobre 2026 Metr e Redwood Research hanno pubblicato i risultati di un’ulteriore verifica sui sistemi interni di OpenAI.
L’analisi, svolta dal 21 luglio all’11 agosto, ha consentito a due ricercatori esterni di consultare codice sorgente, documentazione tecnica e configurazioni dei sistemi di monitoraggio. I risultati sono confluiti in un rapporto interno di 61 pagine.
I valutatori hanno individuato vulnerabilità che, nelle condizioni esaminate, avrebbero potuto permettere agli agenti di evitare alcuni controlli.
Secondo il rapporto, tra il 75% e il 94% del traffico interno generato tramite Responses API da modelli almeno altrettanto potenti di GPT-5.5 risultava idoneo al monitoraggio, con margini di incertezza dichiarati dagli autori.
I ricercatori hanno inoltre individuato una tecnica potenzialmente capace di sottrarre centinaia di azioni al sistema di sorveglianza.
OpenAI ha comunicato di avere corretto tutte le vulnerabilità individuate che interessavano le protezioni dei sistemi di produzione. Metr e Redwood hanno precisato di non avere verificato autonomamente l’efficacia di tali interventi.
Il rapporto descrive il sistema esistente nel luglio 2026 e non costituisce una valutazione aggiornata della sicurezza complessiva di OpenAI.
Anthropic rafforza l’accesso dei controllori esterni
La concorrenza sta portando le società tecnologiche a sperimentare modalità differenti di verifica indipendente.
Il 15 ottobre 2026 Anthropic, sviluppatrice di Claude, ha annunciato di avere concesso a sei dipendenti di Metr un livello di accesso ai propri sistemi paragonabile a quello del personale interno impegnato nella valutazione dei rischi.
L’accordo comprende dispositivi aziendali, spazi di lavoro, strumenti tecnici e documentazione, con alcune esclusioni relative ai dati dei clienti, alle informazioni legalmente protette e alle architetture proprietarie.
Metr potrà pubblicare le valutazioni senza un’autorizzazione preventiva generale di Anthropic. La società conserverà tuttavia la possibilità di chiedere la rimozione di informazioni appartenenti a categorie riservate definite contrattualmente.
Anthropic ha inoltre comunicato collaborazioni con SecureBio e Accenture e contatti preliminari con altre organizzazioni.
La strategia presenta una dimensione commerciale. Permettere verifiche indipendenti può rafforzare la credibilità delle aziende presso clienti che utilizzano l’intelligenza artificiale in attività sensibili.
Rimane però una questione di indipendenza: gli stessi sviluppatori stabiliscono ancora quali informazioni siano troppo riservate per essere condivise.
Sicurezza e proprietà intellettuale, il costo economico della trasparenza
Il conflitto tra OpenAI e i tre ricercatori riguarda anche il valore economico delle informazioni tecnologiche.
Le architetture dei modelli rappresentano una parte importante del patrimonio industriale dei produttori di intelligenza artificiale. Divulgarle potrebbe ridurre il vantaggio competitivo acquisito attraverso investimenti nella ricerca, nel calcolo e nello sviluppo del software.
La protezione dei segreti industriali è quindi un interesse economico legittimo. Ma controlli troppo limitati possono impedire ai valutatori di individuare problemi che emergono soltanto analizzando i meccanismi interni.
Per gli utilizzatori professionali, questa tensione si traduce in costi di verifica, gestione dei fornitori, sicurezza informatica e continuità operativa.
Una maggiore trasparenza tecnica può ridurre alcune asimmetrie informative tra chi produce i modelli e chi li acquista. Non elimina, tuttavia, la necessità di proteggere informazioni che potrebbero facilitare attacchi o favorire concorrenti.
L’esperienza di Anthropic e quella dei test condotti da OpenAI mostrano che gli accordi con valutatori esterni possono disciplinare accessi, riservatezza e pubblicazione dei risultati senza rendere pubblici tutti i dettagli tecnologici.
La governance dell’intelligenza artificiale dopo i licenziamenti
In una lettera indirizzata in ottobre al consiglio di amministrazione di OpenAI, i tre ricercatori licenziati hanno sollecitato una maggiore collaborazione con organizzazioni esterne per ridurre il rischio di incidenti catastrofici.
Korbak ha inoltre riferito al Wall Street Journal che alcuni ex colleghi temono conseguenze professionali qualora discutano problemi di sicurezza con soggetti esterni.
OpenAI respinge il collegamento tra i licenziamenti e le opinioni espresse dai ricercatori. L’azienda sostiene di collaborare già con organismi indipendenti e ha annunciato ulteriori iniziative.
La distinzione è importante: le contestazioni relative alla gestione di informazioni riservate non dimostrano che l’azienda voglia limitare la ricerca sulla sicurezza. Allo stesso modo, l’esistenza di collaborazioni esterne non risolve automaticamente le controversie sulle condizioni di accesso e sull’autonomia dei valutatori.
Il punto economico riguarda la governance di una tecnologia che sta acquisendo capacità operative crescenti.



Partecipa alla community