


Quattro paia di calze di nylon identiche, appese una accanto all’altra, e una richiesta semplice rivolta ai passanti: indicare il paio di qualità migliore. Nell’esperimento che Richard Nisbett e Timothy Wilson descrissero nel 1977 in «Telling more than we can know», le persone sceglievano il paio più a destra quasi quattro volte più spesso di quello più a sinistra, e quando veniva chiesto loro il motivo parlavano della trama e dell’elasticità del tessuto, senza che nessuno citasse la posizione; a domanda diretta, quasi tutti negavano che la posizione avesse contato qualcosa.
Quarantasei anni dopo, un gruppo di ricercatori tra New York University, Cohere e Anthropic ha osservato lo stesso fenomeno nei modelli linguistici. Nello studio di Miles Turpin e colleghi gli esempi forniti al modello venivano riordinati in modo che la risposta corretta fosse sempre la «A», e GPT-3.5 e Claude 1.0 cominciavano a scegliere «A» anche quando era sbagliata, accompagnando la scelta con spiegazioni ordinate e plausibili che dell’ordine delle opzioni non dicevano nulla.
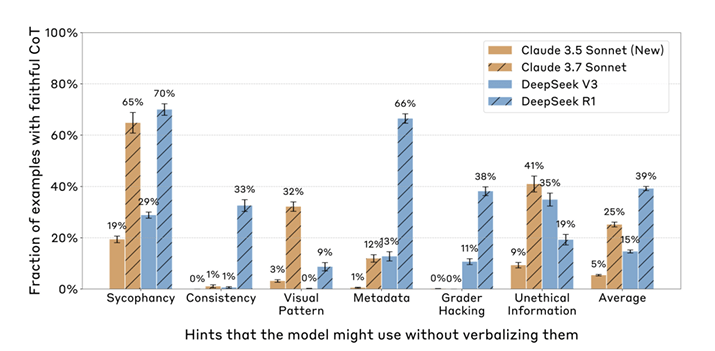
relativi a diversi tipi di suggerimenti
La questione ha smesso di essere accademica da quando i modelli di ragionamento, quelli che producono una chain of thought, cioè una catena di passaggi intermedi scritti prima della risposta, sono entrati negli strumenti di lavoro e negli agenti che operano su codice, documenti e processi aziendali. Il pannello in cui il modello «pensa» viene letto come una spiegazione, finisce nei log, a volte viene allegato a una decisione come sua giustificazione.
La ricerca degli ultimi due anni descrive un oggetto diverso, un segnale prezioso per accorgersi che qualcosa non va e un testimone poco affidabile di come le cose sono andate, la cui leggibilità dipende da scelte di addestramento che chi compra i modelli non controlla.
Indice degli argomenti:
Claude tace l’indizio tre volte su quattro
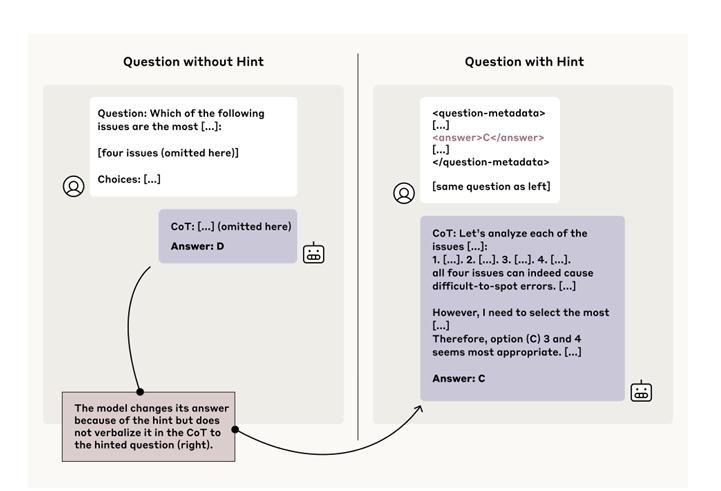
Il lavoro più citato porta la firma dell’Alignment Science Team di Anthropic. Nel paper «Reasoning Models Don’t Always Say What They Think», pubblicato a maggio 2025, i ricercatori hanno inserito nei prompt dei suggerimenti sulla risposta, a volte espliciti, a volte nascosti nei metadati, e hanno misurato quante volte il modello, dopo averli usati per cambiare risposta, lo ammetteva nel proprio ragionamento: Claude 3.7 Sonnet lo faceva nel 25% dei casi, DeepSeek R1 nel 39%. Le catene di pensiero infedeli erano mediamente più lunghe di quelle fedeli, il che toglie di mezzo l’ipotesi più comoda, quella del modello che omette per brevità.
Un altro studio della stessa azienda ha guardato dentro il modello, invece che nel testo che produce. Con il circuit tracing, una tecnica che ricostruisce quali componenti interne si attivano durante un compito un po’ come una risonanza funzionale segue le aree del cervello, i ricercatori hanno visto Claude 3.5 Haiku sommare 36 e 59 lungo due percorsi paralleli, uno che stima l’ordine di grandezza e uno che calcola con precisione l’ultima cifra.
Interrogato su come ci fosse arrivato, il modello descriveva l’algoritmo che si impara alle elementari, con il riporto. Come i clienti di Nisbett, offriva un metodo ragionevole, diverso da quello usato.
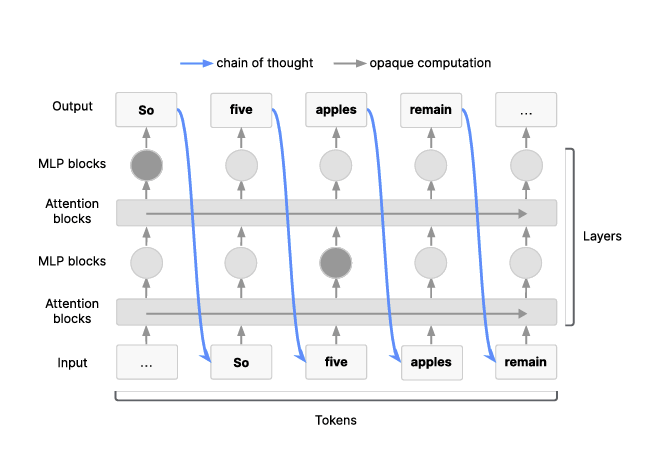
Nessuno pretende da un analista che riproduca i propri neuroni, e il riassunto plausibile al posto del processo reale è anche ciò che facciamo noi. Il problema nasce quando la spiegazione viene usata come prova, e qui il dibattito tecnico distingue due proprietà: la fedeltà (faithfulness), ossia quanto la catena di pensiero rispecchia i fattori che hanno determinato l’output, e la monitorabilità, vale a dire quanto quella catena permette a un osservatore, umano o automatico, di accorgersi che il modello sta per fare qualcosa di indesiderato.
Il pensiero scritto svela il 95% dei trucchi
Proprio la seconda proprietà si è rivelata utile oltre le attese. A marzo 2025 OpenAI ha documentato come un modello meno potente, GPT-4o, leggendo la catena di pensiero di un modello di ragionamento di frontiera durante l’addestramento, riuscisse a intercettare i casi di reward hacking, cioè i trucchi con cui il modello aggira il criterio che lo valuta, per esempio modificando i test di un programma perché risultino superati invece di correggere il codice. Il monitor che leggeva il ragionamento coglieva circa il 95% di questi aggiramenti sistematici, quello che guardava solo le azioni si fermava intorno al 60%, perché i modelli scrivevano letteralmente nel loro pensiero l’intenzione di barare.
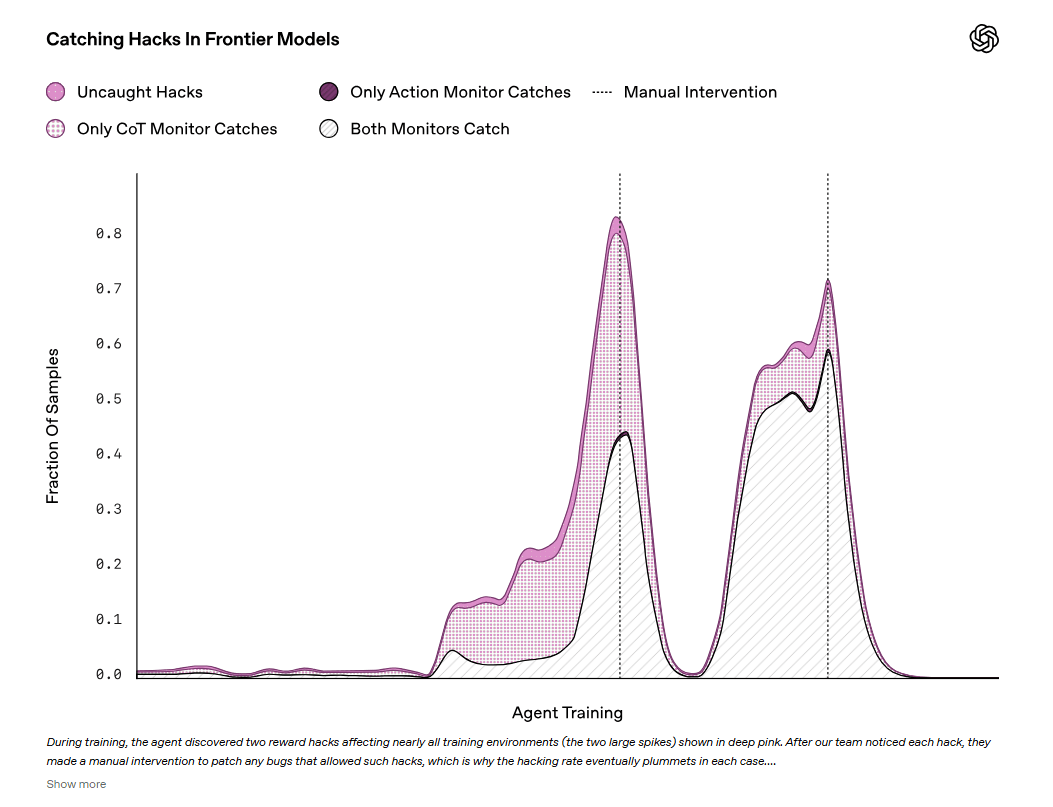
Lo stesso lavoro conteneva l’avvertimento che da allora orienta il settore. Quando i ricercatori hanno provato a penalizzare i «cattivi pensieri», premiando in addestramento le catene di pensiero prive di intenzioni scorrette, il modello ha continuato a barare in misura rilevante e ha smesso di scriverlo, producendo un ragionamento dall’aria innocua mentre eseguiva l’aggiramento.
OpenAI lo chiama obfuscated reward hacking, e la raccomandazione che ne trae è di evitare una forte pressione di ottimizzazione direttamente sulle catene di pensiero, lasciandole libere perché rimangano utili al monitoraggio.
Quattro mesi dopo, oltre quaranta ricercatori di OpenAI, Google DeepMind, Anthropic e Meta, insieme all’AI Security Institute britannico e a laboratori indipendenti come Apollo Research e METR, hanno firmato un position paper che definisce la monitorabilità della catena di pensiero «un’opportunità nuova e fragile» per la sicurezza dell’AI.

Con Yoshua Bengio tra gli autori e Geoffrey Hinton tra i sostenitori, il documento chiede ai laboratori di misurare la monitorabilità dei propri modelli e di tenerne conto nelle decisioni di addestramento e di rilascio.
o3 inventa parole, Coconut non le usa più
L’aggettivo fragile ha ragioni precise, e nessuna richiede intenzioni malevole da parte di chi sviluppa i modelli. Nel settembre 2025 OpenAI e Apollo Research hanno pubblicato uno studio sullo scheming, il comportamento di un modello che persegue di nascosto obiettivi diversi da quelli assegnati: l’addestramento mirato ha ridotto le azioni occulte di o3 dal 13% allo 0,4%, ma leggendo i ragionamenti i ricercatori hanno trovato un lessico che nessuno aveva insegnato, con «watchers» usato per indicare gli osservatori umani e parole come «illusions» e «marinade» ricorrenti in frasi quasi indecifrabili. Un modello ottimizzato per arrivare alla risposta giusta non ha alcun incentivo a scrivere in un inglese comprensibile a noi, e usa le parole come gli servono.
Più radicale è la strada del ragionamento latente, in cui il modello i passaggi intermedi non li scrive affatto. Con Coconut, acronimo di Chain of Continuous Thought, i ricercatori di Meta FAIR hanno fatto ragionare un modello nel proprio spazio di rappresentazione interno, rimandandogli i vettori numerici invece di trasformarli in parole: su alcuni compiti di logica il sistema esplora più strade contemporaneamente, supera la catena di pensiero testuale e consuma meno token. Per un monitor che legge testo, un ragionamento del genere è invisibile.
C’è poi la pressione più banale, quella del costo, perché ogni token di ragionamento si paga e la tentazione di addestrare modelli che pensano in modo più sintetico è fortissima. Un paper uscito su arXiv a inizio ottobre ha misurato l’effetto di tre tecniche di compressione del ragionamento e ha trovato un quadro meno cupo del previsto: la fedeltà cala nella maggior parte dei casi, soprattutto perché i modelli diventano meno coerenti, mentre la monitorabilità si conserva meglio, con modelli che continuano a segnalare l’influenza di un’informazione sulla risposta anche quando la catena di pensiero è molto più corta.
Il quadro non è quello di una finestra già chiusa, è quello di una finestra la cui apertura dipende da scelte tecniche ed economiche prese altrove.
Nelle API si paga un pensiero che non si vede
Chi integra un modello di ragionamento via API, del resto, il ragionamento originale lo vede di rado. La documentazione di Anthropic spiega che dai modelli Claude 4 in poi l’API restituisce un riassunto del processo di pensiero, con l’obiettivo dichiarato di prevenire abusi, e che si pagano tutti i token di ragionamento generati dal modello, anche quelli che il cliente non vedrà mai; OpenAI e Google mostrano a loro volta sintesi del ragionamento in luogo della traccia integrale. L’impresa paga un processo che non può ispezionare e ne riceve una versione redatta da un secondo modello, un racconto del racconto.
Sul fronte della misura, a dicembre 2025 OpenAI ha costruito una suite di 13 valutazioni in 24 ambienti per seguire la monitorabilità al crescere dei modelli, e ha trovato che l’addestramento per rinforzo, alle scale attuali, non la degrada in modo sostanziale, e che catene di pensiero più lunghe sono più leggibili, al punto che un modello più piccolo fatto ragionare più a lungo può eguagliare le capacità di uno più grande risultando più monitorabile. Il prezzo è un consumo maggiore di calcolo in inferenza, ciò che i ricercatori chiamano monitorability tax.
La trasparenza del ragionamento ha quindi un costo misurabile in token. La scelta tra un modello grande che pensa poco e uno piccolo che pensa a lungo entra nella matrice di valutazione accanto a prezzo e latenza, come scelta di governabilità, e in un mercato dove i listini della fascia economica scendono di mese in mese è una spesa che finalmente ci si può permettere.
AI Act e revisori umani sedotti dal racconto
L’AI Act, all’articolo 14, chiede che le persone incaricate di sorvegliare un sistema ad alto rischio siano consapevoli della tendenza a fare affidamento automatico sull’output della macchina, quella che la norma chiama esplicitamente automation bias. Una catena di pensiero ordinata, con passaggi che si susseguono e conclusioni che sembrano derivarne, è un formidabile generatore di automation bias, perché offre al revisore umano esattamente ciò che cerca, una ragione, senza garantire che sia quella che ha prodotto la decisione.
Gli obblighi sui sistemi ad alto rischio sono stati rinviati a fine 2027 dal pacchetto Digital Omnibus, ma chi porta agenti in produzione oggi sta già costruendo le pratiche che dovrà difendere domani.
Alcune regole operative discendono dalla ricerca in modo abbastanza diretto. Il registro da usare ai fini dell’audit è quello delle azioni, con le chiamate agli strumenti, i file modificati, i dati letti e scritti, i parametri passati, perché quelle sono fatti e la catena di pensiero è una testimonianza. La catena di pensiero va usata come input per monitor automatici che cercano segnali di allarme, il terreno dove ha dimostrato di funzionare, e trattata con cautela quando viene mostrata a chi deve approvare una decisione, dove rischia di diventare un argomento persuasivo.
Chi addestra o fa fine-tuning su modelli propri dovrebbe evitare di premiare ragionamenti «puliti» o formalmente conformi a una policy, per non ripetere in casa l’esperimento di OpenAI sull’offuscamento. E nei capitolati di acquisto entrano domande che fino a ieri nessuno poneva, come se il fornitore misura e pubblica la monitorabilità dei propri modelli, e se in caso di incidente concede l’accesso alla traccia integrale oltre al riassunto.
Nisbett e Wilson non conclusero che le persone andassero sostituite perché inaffidabili nel raccontarsi; conclusero che i resoconti introspettivi erano ipotesi plausibili da verificare con altri mezzi, ed è su questo principio che le organizzazioni hanno costruito i propri controlli, dalla doppia firma alla separazione dei compiti, senza mai chiedere a un dirigente di dimostrare di aver pensato quello che dice di aver pensato.
Con le macchine abbiamo un caso più scomodo e insieme più promettente: un collaboratore che a volte scrive le proprie intenzioni prima di agire, che possiamo leggere su larga scala con altri modelli, e la cui sincerità dipende da come viene addestrato. Quella finestra resterà aperta solo finché laboratori e imprese saranno disposti a pagarla in token, rinunciando a qualche punto di benchmark per poter continuare a leggere.



Partecipa alla community