


Meta ha presentato il 10 agosto 2026 Muse Glimmer, un modello di intelligenza artificiale da 30 miliardi di parametri progettato per eseguire agenti direttamente sui computer degli utenti. I pesi sono disponibili su Hugging Face con licenza Apache 2.0, una scelta che permette agli sviluppatori di scaricare, modificare e integrare il modello con vincoli molto inferiori rispetto a quelli applicati ai sistemi proprietari.
La novità riguarda soprattutto dove viene eseguita l’intelligenza artificiale. Muse Glimmer è stato ottimizzato per funzionare su un Mac o un pc dotato di una singola Gpu di fascia consumer, senza che ogni richiesta debba raggiungere i data center di Meta o di un altro fornitore. L’azienda indica tra gli impieghi principali gli agenti personali, le chiamate automatiche a strumenti e funzioni, la programmazione e la valutazione delle risposte prodotte da altri modelli.
Il lancio arriva mentre Meta rilancia pubblicamente la propria strategia sui modelli aperti. Nella stessa giornata Mark Zuckerberg ha difeso un approccio che distribuisca maggiormente l’accesso alle tecnologie di intelligenza artificiale avanzata e ha contestato la concentrazione dei modelli più potenti nelle mani di poche aziende e governi. Associated Press e Financial Times hanno collegato direttamente la pubblicazione di Glimmer a questa strategia.
Il nome non è stato spiegato da Meta, ma “glimmer” in inglese indica un bagliore o un barlume: una metafora che si adatta a un’AI più compatta, pensata per restare sempre attiva direttamente sul dispositivo dell’utente.
Indice degli argomenti:
Un modello da 30 miliardi di parametri sul computer
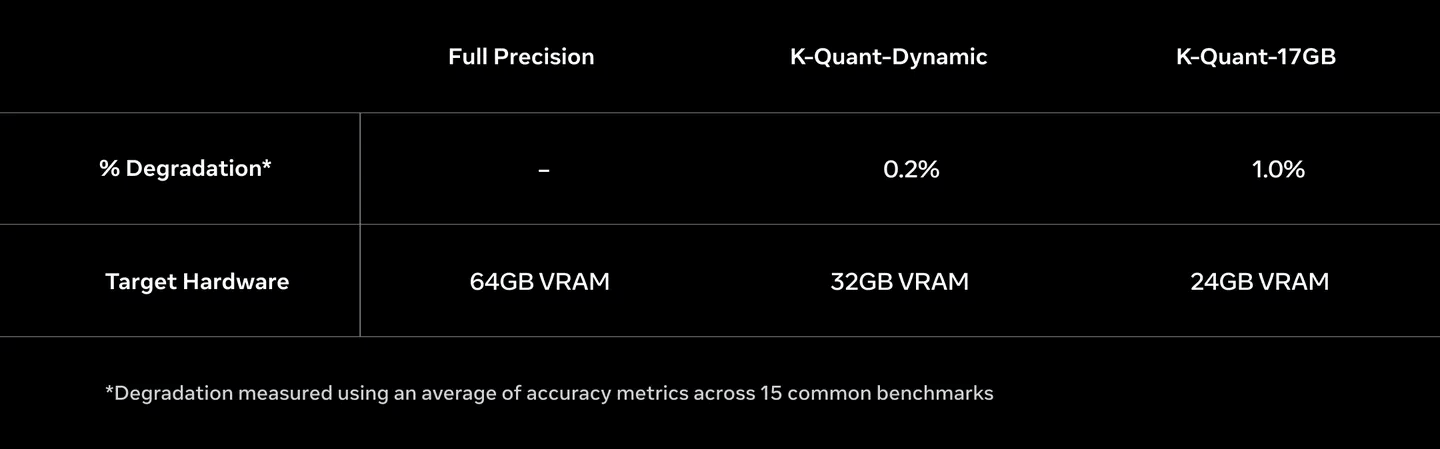
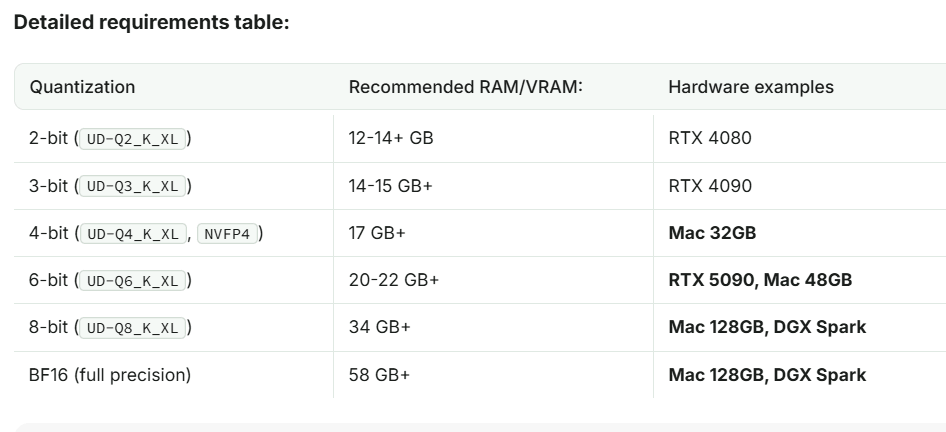
A piena precisione, secondo Meta, un modello da 30 miliardi di parametri richiederebbe più di 55 gigabyte di memoria. Una quantità che rende difficile l’esecuzione sulle normali schede grafiche installate sui computer personali.
Muse Glimmer affronta il problema attraverso la quantizzazione, cioè una riduzione della precisione numerica utilizzata per rappresentare i pesi del modello. Meta dichiara di aver compresso la componente linguistica a meno di 20 gigabyte utilizzando una precisione vicina ai 4 bit.
Questa riduzione dovrebbe consentire di lasciare memoria disponibile per altri elementi necessari all’esecuzione: la cache utilizzata dal modello mentre elabora sequenze lunghe, l’encoder destinato alla comprensione delle immagini e il modello ausiliario impiegato per accelerare la generazione.
La versione BF16 pubblicata su Hugging Face occupa circa 59,6 gigabyte, mentre nella raccolta ufficiale Meta sono previste anche varianti quantizzate e build dedicate a ExecuTorch. La pagina del progetto classifica Muse Glimmer come modello multimodale text-and-image-to-text e conferma la licenza Apache 2.0.
La distinzione è importante: i 20 gigabyte scarsi indicati da Meta non corrispondono alle dimensioni dei pesi originali alla massima precisione, ma alle versioni compresse pensate per l’uso locale.
Gli agenti diventano il terreno dello scontro
Muse Glimmer è stato costruito soprattutto per sistemi capaci di eseguire una sequenza di azioni invece di limitarsi a produrre una risposta testuale.
Un agente personale può, per esempio, consultare un calendario, individuare un appuntamento disponibile, preparare un messaggio, organizzare file o richiamare programmi esterni. Per completare operazioni di questo tipo un modello deve mantenere il contesto per più passaggi, utilizzare correttamente gli strumenti disponibili e reagire quando un comando produce un errore.
Meta afferma di aver addestrato Glimmer per la gestione di flussi di lavoro prolungati, il richiamo preciso delle funzioni, la comprensione congiunta di testo e immagini e il recupero dagli errori. Il modello può quindi esaminare screenshot, grafici o documenti insieme alle istruzioni scritte.
Supporta inoltre più di cento lingue e diversi livelli di intensità del ragionamento, in modo da scegliere tra tempi di risposta più rapidi e maggiore elaborazione.
L’interesse economico è immediato. Un agente eseguito localmente riduce il numero di inferenze acquistate da un servizio cloud e può continuare a operare senza connessione. Per aziende e sviluppatori significa la possibilità di trasferire almeno una parte dei costi computazionali dal fornitore del modello all’hardware dell’utente.
Il vantaggio potenziale è ancora maggiore nei compiti che coinvolgono informazioni riservate. Documenti, file e alcuni dati personali possono essere elaborati sul dispositivo invece di essere inviati continuamente a server remoti. La reale tutela della riservatezza dipende però dall’intera applicazione: un modello locale può comunque essere collegato a servizi esterni o utilizzare strumenti che trasmettono dati via internet.
Come Meta ha addestrato Glimmer
La società descrive un processo articolato in tre fasi. Nel pre-training Glimmer è stato addestrato sfruttando gli output di Muse Spark attraverso una tecnica di “logit distillation”. In sostanza, un modello più piccolo apprende parte del comportamento di un sistema più grande utilizzandone le distribuzioni di probabilità come riferimento.
Nella fase intermedia Meta ha aumentato il peso dei dati con contesti lunghi, attività agentiche e tracce di ragionamento più ricche. Il post-training ha poi combinato supervised fine-tuning, distillazione eseguita sulle risposte prodotte dal modello stesso e reinforcement learning su ragionamento, programmazione e uso degli agenti.
Muse Spark rappresenta il modello di fascia superiore della nuova famiglia sviluppata da Meta Superintelligence Labs. Meta lo aveva presentato l’8 aprile 2026 come primo grande modello nato dal nuovo laboratorio. A luglio è arrivato Muse Spark 1.1, accompagnato dall’apertura dell’accesso agli sviluppatori. Reuters descrisse quell’operazione come un ingresso più diretto di Meta nel mercato servito, tra gli altri, da OpenAI e Anthropic.
Glimmer segue una strada diversa: invece di spingere soprattutto sulla potenza disponibile attraverso i data center, riduce dimensioni e requisiti hardware per avvicinare il modello al dispositivo dell’utente.
I benchmark dichiarati da Meta
Meta confronta Muse Glimmer con modelli di dimensioni simili, tra cui Gemma4-31B e Qwen3.6-27B, su benchmark dedicati a ragionamento, programmazione, capacità multimodali e attività agentiche.
Tra i test citati figurano SWE-Bench, utilizzato per misurare la capacità di intervenire su problemi reali all’interno di repository software, e benchmark come DeepSearch QA, MCP-Atlas e τ-Bench, orientati all’esecuzione di attività attraverso più passaggi e strumenti.
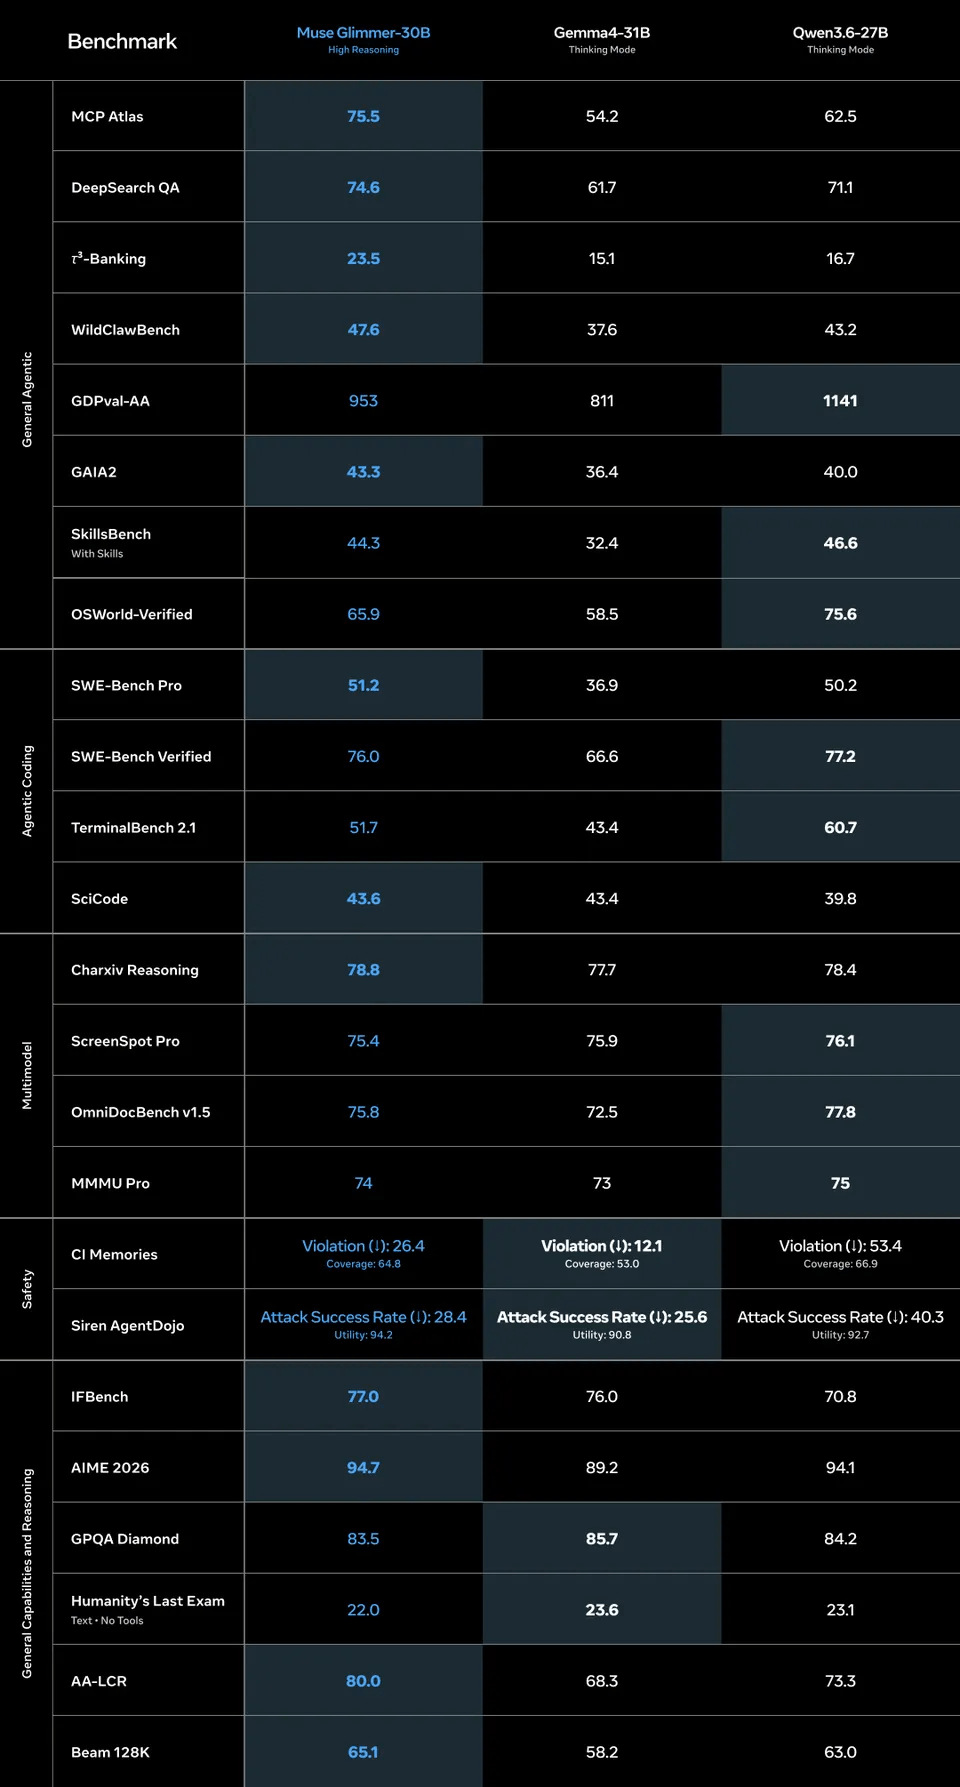
La società sostiene che Glimmer raggiunga risultati competitivi o superiori su diversi test della sua categoria. Si tratta, al momento del lancio, soprattutto di valutazioni pubblicate dal produttore. La disponibilità dei pesi consente ora a laboratori e sviluppatori indipendenti di verificare quanto i risultati si trasferiscano alle applicazioni reali.
La stessa Meta utilizza metodologie di confronto che richiedono attenzione nell’interpretazione. Nella documentazione relativa alla famiglia Muse Spark, per esempio, l’azienda spiega che per alcuni concorrenti considera il risultato più favorevole tra il punteggio dichiarato dal produttore e quello ottenuto nelle proprie riproduzioni attraverso le relative api.
Per Glimmer il test economicamente più significativo sarà quindi quello condotto fuori dai laboratori: quanti compiti può completare correttamente, con quale velocità e con quanta memoria su hardware realmente disponibile nelle abitazioni e negli uffici.
La generazione accelera con un secondo modello
La riduzione della memoria non risolve da sola il problema della velocità. I modelli linguistici generano normalmente la risposta un token dopo l’altro e le lunghe catene di ragionamento possono rallentare l’interazione.
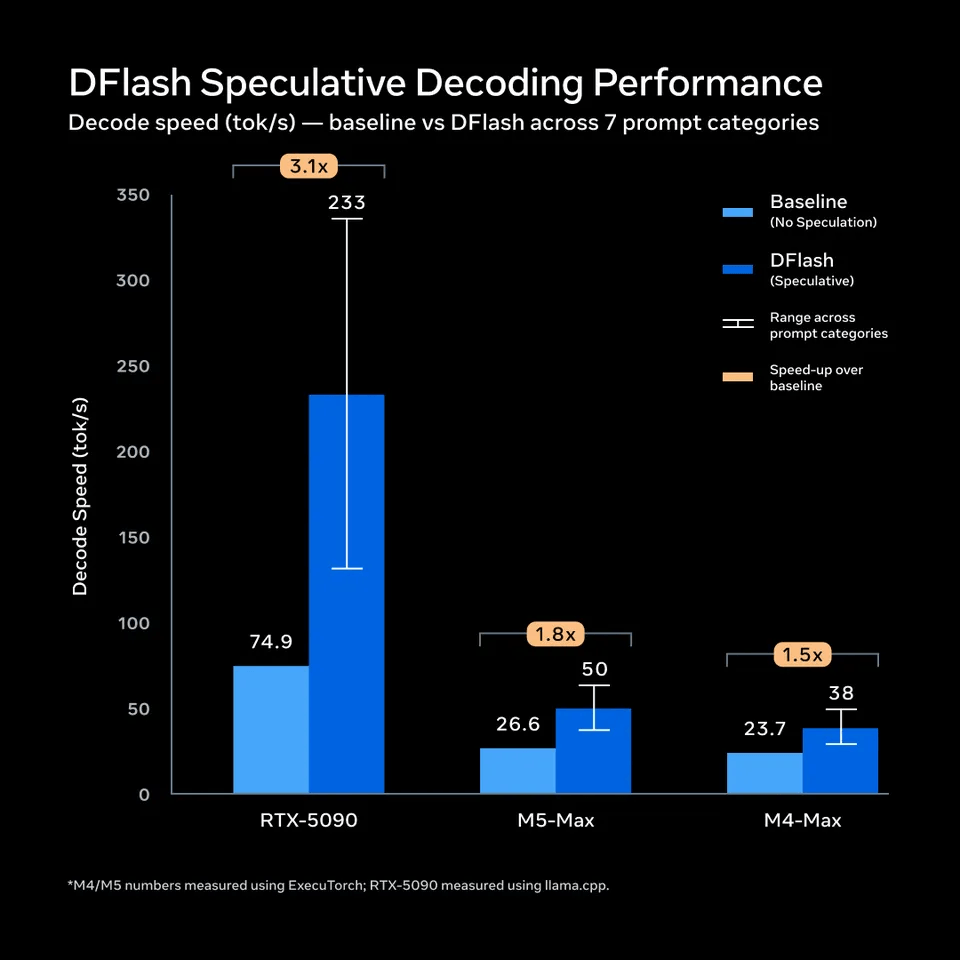
Meta ha integrato una tecnica di speculative decoding basata su DFlash. Un piccolo modello ausiliario, chiamato “drafter”, propone blocchi di token. Muse Glimmer controlla quindi le proposte in parallelo, accettando quelle corrette e sostituendo le altre.
Nei test comunicati dall’azienda, il sistema aumenta la velocità di decodifica di 3,1 volte su una Nvidia RTX 5090, di 1,8 volte su un MacBook con M5 Max e di 1,5 volte su un M4 Max.
Sono dati prodotti da Meta e non equivalgono ancora a una verifica indipendente delle prestazioni. Indicano però il tipo di compromesso su cui si sta concentrando il mercato dei modelli locali: memoria occupata, velocità, consumo energetico e perdita di qualità dovuta alla compressione.
Dall’AI nel cloud all’AI nel pc
Il modello economico dell’intelligenza artificiale generativa si è sviluppato soprattutto intorno ai data center. L’utente invia una richiesta, il calcolo viene eseguito su acceleratori remoti e il risultato torna attraverso la rete.
Portare una quota crescente dell’inferenza sui dispositivi modifica questa catena. Per i produttori di chip e computer, l’intelligenza artificiale locale crea una ragione per vendere sistemi con più memoria e maggiore potenza di calcolo. Per i fornitori di modelli può ridurre il costo necessario a servire ogni richiesta. Per gli sviluppatori rende possibile costruire software che continua a funzionare anche senza una connessione stabile.
Meta ha indicato AMD, Arm, Dell, Intel e Nvidia tra le società con cui sta lavorando all’ottimizzazione di Glimmer sui diversi dispositivi.
L’azienda prevede inoltre il supporto di ambienti molto utilizzati dalla comunità dei modelli locali, fra cui llama.cpp, MLX ed ExecuTorch. Sono previste integrazioni con Ollama, LM Studio e Unsloth, mentre vLLM e SGLang serviranno gli sviluppatori interessati all’esecuzione su infrastrutture di maggiore scala.
Unsloth ha già pubblicato il 10 agosto una guida per eseguire localmente Muse Glimmer, definendolo un modello multimodale denso da 30 miliardi di parametri dedicato ad agenti e programmazione.
Il ritorno di Meta sui modelli aperti
Il lancio ha anche un significato competitivo. Il Financial Times ha descritto l’operazione come il ritorno di Meta alla distribuzione di modelli aperti dopo una fase nella quale la società aveva concentrato molti investimenti sui sistemi proprietari della famiglia Muse Spark.
Zuckerberg ha accompagnato la pubblicazione con una difesa dell’AI aperta e con una critica ai sistemi più chiusi controllati da poche società. Associated Press ricorda che Meta sostiene da anni questa impostazione, pur avendo dovuto recuperare terreno rispetto a concorrenti come OpenAI, Anthropic e Google nello sviluppo dei modelli più avanzati.
La licenza Apache 2.0 distingue inoltre Glimmer da alcune precedenti pubblicazioni Meta. Il termine “open source” applicato ai modelli di intelligenza artificiale è oggetto di discussione quando vengono distribuiti i pesi ma non tutti i dati e il codice utilizzati nell’addestramento. Nel caso di Glimmer, gli sviluppatori ricevono comunque diritti ampi per l’utilizzo e la modifica dei pesi pubblicati.
Per Meta l’AI personale passa dal dispositivo
Muse Glimmer completa un’offerta che Meta sta rapidamente allargando. Muse Spark ha debuttato in aprile; a luglio Muse Spark 1.1 ha esteso le funzioni agentiche e l’accesso per gli sviluppatori. Nello stesso mese Meta ha presentato Muse Image e anticipato Muse Video, ampliando la famiglia ai contenuti visivi.
La società sta quindi separando due esigenze. I modelli più grandi restano collegati alla capacità di calcolo dei data center e ai servizi online. Glimmer punta invece sulle attività che possono essere eseguite continuamente sulla macchina dell’utente.
La disponibilità dei pesi rende il modello immediatamente sperimentabile e permette alla comunità di misurare prestazioni, limiti e requisiti hardware senza dipendere esclusivamente dai dati forniti da Meta.
Se gli agenti personali diventeranno una componente stabile di sistemi operativi e applicazioni, il controllo del luogo in cui avviene l’inferenza avrà conseguenze anche sulla distribuzione dei costi dell’AI. Con Glimmer, Meta prova a spostarne una parte dal data center al computer che si trova già sulla scrivania dell’utente.





Partecipa alla community