


Un modello da 501 miliardi di parametri che chiunque può scaricare, modificare e rivendere con licenza Apache 2.0, e una trattativa con il primo fornitore di chip per l’intelligenza artificiale per comprare il laboratorio che lo ha costruito. Reflection ha pubblicato i pesi di Beam, cioè i parametri numerici che costituiscono il modello addestrato, il 16 ottobre, sei giorni dopo che il Financial Times aveva raccontato i colloqui con Nvidia, e negli stessi giorni Thinking Machines Lab ha fatto il bilancio di un anno di Tinker mentre TypeSafe raccoglieva capitali su Jev, modello che restituisce decisioni tipizzate al posto delle conversazioni.
Sono i neolab, startup di ricerca guidate da scienziati usciti dai grandi laboratori, e alle imprese offrono pezzi di tecnologia molto lontani fra loro: modelli aperti da far girare sulla propria infrastruttura, servizi per specializzare un modello sui dati aziendali, motori di decisione, generazione per diffusione, ambienti tridimensionali.
Il capitale abbonda, i prodotti molto meno, e l’Economist, sui 29 neolab nati dal giugno 2024 secondo il conteggio di Radical Ventures, calcola 23 miliardi di dollari raccolti e meno del 35% di società con un’offerta commerciale, mentre poco più della metà ha pubblicato codice, spesso sotto forma di dimostrazioni di ricerca. Comprare da loro significa scegliere un componente, misurarlo sul proprio processo e mettere in conto che il fornitore, fra un anno, possa avere un altro proprietario.
Indice degli argomenti:
Otto laboratori, otto livelli di maturità
Radical Ventures, nella sua ricognizione The Rise of NeoLabs, conta più di 40 società di questo tipo e oltre 40 miliardi di dollari raccolti in tre anni. La definizione riguarda chi le fonda e cosa cercano, mentre per un’impresa la domanda utile è un’altra, cioè che cosa si possa usare oggi, con quale licenza e con quali prerequisiti.
Un neolab può vendere un’API, rilasciare i pesi del modello, lavorare soltanto con partner selezionati o non avere ancora nulla di pubblico, e la tabella mette in fila i casi prima di qualunque confronto fra prestazioni.
Neolab AI: disponibilità, impieghi e limite principale
| Prodotto | Stato pubblico | Applicazione aziendale | Limite principale |
| Beam, Reflection AI | Pesi Apache 2.0; API gestita | Agenti di programmazione, ragionamento, modello su infrastruttura privata | 501 miliardi di pesi totali; costo GPU elevato; solo testo, addestrato soprattutto in inglese |
| Tinker, Thinking Machines | API per post-training e campionamento | Modelli specialistici su dati e regole del dominio | Dati da preparare, valutazioni, costi di training; localizzazione dei dati da verificare |
| Inkling e Inkling-Small | Pesi aperti, personalizzabili | Multimodalità e applicazioni specialistiche | Grandi dimensioni; serve un’infrastruttura di inferenza |
| Jev, TypeSafe AI | API e accesso per sviluppatori | Instradamento, classificazione, decisioni tipizzate | Non genera testo; calibrazione e conservazione dei dati da configurare |
| Mercury 2.5, Inception | Modello commerciale per inferenza | Flussi a bassa latenza, voce, ricerca, codice | Vantaggi dichiarati dal produttore, da misurare sull’intera pipeline |
| Marble e Atlas, World Labs | Marble con API pubblica; Atlas ad accesso selezionato | Mondi 3D, prototipazione, scenari simulati | Plausibilità visiva diversa da validazione fisica |
| Latent-Y, Latent Labs | Accesso per partner selezionati | Progettazione di anticorpi e peptidi | Risultati di laboratorio, lontani dalla clinica |
| SSI | Nessun prodotto pubblico | Ricerca sulla superintelligenza | Fuori da qualunque procurement operativo |
Fonti: Reflection, Thinking Machines, TypeSafe, Inception, World Labs, Latent Labs, SSI. Stato al 18 ottobre 2026.
La prima scelta architetturale riguarda quale passaggio del flusso aziendale abbia bisogno di un modello diverso, prima ancora di chiedersi quale modello sia il più potente. Per classificare pratiche o decidere quale strumento interrogare può bastare un modello piccolo, a volte una regola scritta bene, mentre chi vuole insegnare a un modello i propri standard ha bisogno del post-training, ossia dell’addestramento aggiuntivo su un modello già pronto, e una semplice API di inferenza, l’accesso a un modello già pronto da interrogare, non gli serve a molto.
Beam e il terabyte di memoria in BF16
Beam interessa chi vuole controllare il modello e l’ambiente in cui gira. Nella model card Reflection lo descrive come un mixture-of-experts, un’architettura che divide la rete in 256 esperti e ne attiva solo una parte per ogni parola elaborata: 501,3 miliardi di parametri complessivi, 23,4 miliardi attivi, una finestra di contesto dichiarata di un milione di token (i frammenti di parola su cui lavorano i modelli) e varianti BF16, FP8 e NVFP4, cioè a 16, 8 e 4 bit per parametro.
Accetta e produce solo testo ed è stato sviluppato prevalentemente per l’inglese, quindi il rendimento in italiano va misurato prima di qualunque progetto, e accanto ai pesi Reflection offre anche un’API gestita.
I 23,4 miliardi di parametri attivi traggono spesso in inganno, perché durante l’inferenza tutti gli esperti devono restare raggiungibili in memoria anche se a ogni passaggio ne lavora soltanto una parte. Per un ordine di grandezza, i soli pesi occupano circa 1.003 GB in BF16, 501 GB in FP8 e 251 GB a quattro bit, ed è aritmetica sui pesi, a cui l’esercizio reale aggiunge la cache delle conversazioni in corso, le attivazioni e il runtime.
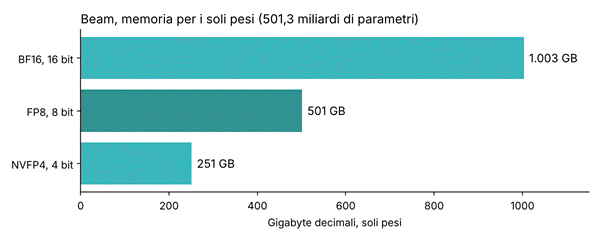
Chi lavora sull’inferenza locale, come faccio con LocalAI, sa che la licenza è la parte facile. Un nodo con otto H100 (Nvidia) da 80 GB somma 640 GB, abbastanza per i pesi in FP8 ma con poco margine per la cache quando gli utenti contemporanei crescono, e la variante NVFP4, il formato a quattro bit di Nvidia, rende al meglio sulle GPU Blackwell, ancora poco diffuse nei data center aziendali. Il modello aperto consente quindi un deployment privato o presso un fornitore scelto dall’impresa, senza però garantire da solo costi bassi o dati in Europa: il confronto va fatto fra API gestita, piattaforma di inferenza dedicata e gestione autonoma, guardando volumi, picchi, latenza e clausole contrattuali, e i benchmark di Reflection restano dati del produttore fino a quando qualcuno non li rifà sui propri compiti.

Da Tinker a Marble, componenti specializzati
Tinker e Inkling
Molti dipartimenti IT cercano un’AI che segua i criteri di giudizio dell’azienda, nella classificazione delle segnalazioni come nell’interpretazione di schemi SQL, nel controllo documentale come nelle priorità di assistenza. Tinker di Thinking Machines Lab fornisce GPU gestite e quattro funzioni API per il post-training di modelli con pesi disponibili (campionamento, calcolo dei gradienti, aggiornamento dei pesi, salvataggio degli stati) e supporta il fine-tuning supervisionato, l’adattamento LoRA, una tecnica che modifica solo una piccola frazione dei parametri, e l’addestramento per rinforzo.
Nell’aggiornamento del 15 ottobre l’azienda elenca le funzioni enterprise aggiunte nel 2026, dai permessi per progetto all’accesso unico con le credenziali aziendali, dagli audit log alla connessione attraverso una rete privata virtuale, e dichiara di non usare i contenuti dei clienti per addestrare i propri modelli, garanzia che però non dice dove i dati vengano trattati.
Il caso più citato è il text-to-SQL, la traduzione di domande di business in interrogazioni ai database: un modello realizzato da Bridgewater e University of Illinois raggiunge il 92,97% su un benchmark ripulito scegliendo fra 16 risposte candidate, con un costo di inferenza pari al 15% di quello di alcuni grandi modelli. Sono condizioni rese note dal fornitore, e replicarle richiede dati annotati e un processo di verifica degli errori.
Thinking Machines ha poi rilasciato Inkling e Inkling-Small con pesi aperti, 975 miliardi di parametri con 41 attivi il primo e 276 con 12 attivi il secondo: Tinker vende infrastruttura e strumenti, Inkling è uno dei modelli che su quella infrastruttura si possono adattare. Secondo una persona informata citata dall’Economist i ricavi annualizzati di Thinking Machines hanno superato i 200 milioni di dollari, molto più degli altri neolab e ancora poco rispetto ai circa 40 miliardi di valutazione che la società cercherebbe nel nuovo round.
Jev di TypeSafe
Jev restituisce decisioni tipizzate con un livello di confidenza, leggibili direttamente dal codice, per esempio se inviare una richiesta a un modello di programmazione, a un servizio di ricerca o a un operatore umano, con soglie e azioni fissate dall’applicazione. Così una microdecisione chiusa smette di passare da un paragrafo di testo da reinterpretare. TypeSafe dichiara velocità e costi molto inferiori ai grandi LLM per questa categoria di compiti e il 9 ottobre ha annunciato un round da 870 milioni di dollari a 7,5 miliardi di valutazione. Prima del rilascio, a settembre, aveva raccolto appena 40 milioni, e oggi Jev è l’unico modello di un neolab fra i 20 più usati su OpenRouter, il marketplace che mette a confronto i modelli, dove Inkling non compare; dal rilascio sono già spuntati diversi concorrenti, segno di quanto sia facile imitare un componente del genere.
Un pilot plausibile riguarda l’instradamento di 50mila ticket al mese, con classi di destinazione, casi ambigui e soglie di passaggio all’operatore definiti in anticipo, e lo stesso campione misurato con il modello in uso, con Jev e con un insieme di regole deterministiche. Il tempo medio dice poco, servono gli errori di instradamento, la calibrazione della confidenza, la latenza al 95° percentile (il tempo entro cui arriva il 95% delle risposte) e il costo per pratica conclusa.
La pagina enterprise dichiara che gli input non servono all’addestramento e presenta la conservazione zero dei dati come opzione da configurare, e dove finiscano dati e log resta una domanda da fare al fornitore.
Mercury e Marble
Inception cambia il meccanismo di generazione. Mercury 2.5 è un modello a diffusione, che costruisce e corregge molti token in parallelo invece di produrli uno dopo l’altro, e l’azienda riporta latenze minori in ricerca, voce e sviluppo software. I token al secondo misurati in laboratorio sono una cosa, il tempo totale di un flusso aziendale un’altra, perché in mezzo ci sono recupero dei documenti, chiamate agli strumenti, verifiche, rete e code.
World Labs ha aperto la World API di Marble, che genera ambienti tridimensionali esplorabili da immagini, testi e video, mentre Atlas, presentato a settembre, è in accesso iniziale per partner selezionati. Per il design e l’intrattenimento questi strumenti accorciano la prototipazione di spazi digitali; per chi costruisce robot un ambiente visivamente plausibile è ben lontano da una simulazione fisica capace di certificare movimenti e sicurezza, e servono dati reali e test nel mondo fisico.
Latent-Y e Periodic Labs
Nelle scienze della vita il neolab diventa un laboratorio vero. Latent Labs presenta Latent-Y come agente per progettare anticorpi e peptidi, disponibile per collaborazioni selezionate, e il rapporto tecnico documenta successi sperimentali su sei dei nove bersagli testati, un risultato di ricerca iniziale e lontano dalla validazione clinica. Periodic Labs, nata da ricercatori provenienti da OpenAI e DeepMind, punta a un ciclo chiuso fra ipotesi dell’AI, esperimento fisico e nuovi dati sui materiali, e per chi fa ricerca e sviluppo significa laboratori, campioni, protocolli e competenze di dominio prima ancora di una licenza software.
Nvidia e AMD nel capitale dei neolab
Le operazioni dell’ultimo anno disegnano una traiettoria precisa. Secondo Radical Ventures Nvidia ha fatto 32 investimenti in startup che sviluppano modelli, più di qualunque altra società o fondo, e a luglio ha versato altri 5 miliardi a SSI, che non ha prodotti, ne ha raccolti 8 in tutto e vale 32 miliardi.
A settembre ha firmato l’accordo per Hugging Face da 12,9 miliardi di dollari, con chiusura attesa nel primo semestre 2027 dopo il vaglio delle autorità, e nel dicembre 2025 aveva già usato con Groq la formula della licenza tecnologica accompagnata dall’assunzione della squadra, un’operazione riportata intorno ai 20 miliardi. Su Reflection, di cui aveva guidato il round da 2 miliardi dell’ottobre 2025, il Financial Times descrive tre ipotesi: acquisizione, quota più ampia con più capacità di calcolo, oppure acqui-hire, l’assunzione della squadra con la tecnologia in licenza, la strada che secondo le fonti eviterebbe una lunga revisione antitrust. AMD ha annunciato l’acquisizione di World Labs per 8,2 miliardi, non ancora chiusa al 18 ottobre, per progettare piattaforme più aderenti al calcolo dei nuovi modelli.
L’Europa entra nella mappa dallo stesso ingresso. A Parigi AMI Labs, la società presieduta da Yann LeCun che sviluppa world model, modelli che imparano come si comporta il mondo fisico, ha chiuso a marzo un seed da 1,03 miliardi a 3,5 miliardi di valutazione, e a Londra Ineffable Intelligence, fondata da David Silver, ha raccolto ad aprile 1,1 miliardi a 5,1 miliardi senza ancora un prodotto, con i primi risultati attesi a fine anno. In entrambi i casi fra i soci c’è Nvidia, così come nel round di Reflection, e il quadro che ne esce vede i produttori di chip comprare o finanziare i laboratori prima che questi abbiano ricavi, per avere vicino i modelli che consumeranno le prossime generazioni di hardware.
Per chi adotta queste tecnologie la conseguenza è contrattuale. I pesi di Beam già rilasciati restano sotto Apache 2.0 qualunque cosa accada alla società, mentre API, prezzi, roadmap, assistenza e licenze delle versioni future seguono il nuovo proprietario, e un acqui-hire può lasciare in piedi una società con la tecnologia in licenza e senza più la squadra che la sviluppava.
Clausole di cambio di controllo, esportazione dei checkpoint dei modelli personalizzati, cioè gli stati salvati dopo l’addestramento, e piani di migrazione verso un’altra API diventano voci da negoziare prima, insieme al rischio di controparte: i 23 miliardi dei 29 neolab contati dall’Economist e gli oltre 40 della ricognizione più ampia di Radical sono due fotografie diverse dello stesso fenomeno, in cui il capitale non garantisce manutenzione né esistenza futura dell’API.
Beam davanti all’AI Act
Gli obblighi dell’AI Act per i modelli di uso generale si applicano dal 2 agosto 2025, e dal 2 agosto 2026 l’AI Office ha pieni poteri di richiesta di informazioni e di sanzione. Un modello si presume a rischio sistemico quando il calcolo cumulativo usato per addestrarlo raggiunge 10²⁵ operazioni in virgola mobile, e la soglia guarda al calcolo, non al numero di parametri. Per Beam la stima è al confine: con la regola empirica delle sei operazioni per parametro attivo e per token, 23,4 miliardi di parametri attivi per i 23,8 mila miliardi di token di pre-addestramento dichiarati da Reflection danno circa 3,3 × 10²⁴, un terzo della soglia, ma la fase di rinforzo ha impegnato 10.500 GPU GB300 per quattro settimane contro le 6.144 del pre-addestramento, e Reflection non pubblica un valore complessivo.
Le esenzioni per i modelli aperti coprono poco. L’articolo 53, comma 2, solleva i modelli con licenza aperta soltanto dagli obblighi di documentazione tecnica verso l’AI Office e verso chi integra il modello, mentre la politica sul diritto d’autore e la sintesi pubblica dei contenuti di addestramento restano dovute, e per i modelli a rischio sistemico l’esenzione decade del tutto.
Beam rilascia i pesi ma non i dataset né la pipeline di addestramento, e Reflection non ha ancora detto come intende offrirlo in Europa: chi lo distribuisce o lo integra in un servizio per il mercato europeo deve chiedere al fornitore stima del calcolo e documentazione.
Le linee guida della Commissione tranquillizzano invece chi personalizza. Un’impresa diventa fornitore del modello solo se la modifica impiega almeno un terzo del calcolo originale, e un adattamento LoRA fatto con Tinker sui ticket aziendali ne resta lontanissimo, per cui gli obblighi arrivano dall’uso del sistema, per esempio quando entra in un processo classificato ad alto rischio. Ecco perché la licenza aperta non trasferisce la conformità: quella va verificata sul fornitore e scritta nel contratto.
Cinque verifiche prima della firma
Una selezione industriale parte dai requisiti aziendali e rende confrontabili le alternative, senza premiare il laboratorio con più capitale o con il punteggio più alto in un test pubblico.
Cosa chiedere al fornitore e quali errori evitare
| Cosa verificare | Dato da richiedere | Errore da evitare |
| Qualità sul compito | Test ciechi sullo stesso dataset, errori critici, tasso di correzione umana | Usare il benchmark del venditore al posto del campione aziendale |
| Latenza e throughput | p50 e p95 end-to-end, concorrenza, retry, code, SLA | Guardare i soli token al secondo |
| Privacy e localizzazione | Flusso di prompt, output, log, training e telemetria; regione e subfornitori | Confondere pesi aperti, assenza di training e conservazione zero |
| Licenza, portabilità e cambio di controllo | Licenza dei pesi, export dei checkpoint, clausole di uscita e di change of control, documentazione AI Act | Firmare senza sapere cosa resta al cliente se il fornitore viene comprato |
| Costo per pratica riuscita | Training, inferenza, cache, GPU, storage, integrazione, personale | Confrontare carichi o livelli di qualità diversi |
Elaborazione metodologica per un pilot aziendale, ottobre 2026. Soglie da definire in base a rischio, processo e contratti
La procedura può partire da un esperimento di quattro settimane su un flusso reale, con un campione storico separato dai dati di addestramento e una baseline già funzionante come termine di confronto, che siano regole, software tradizionale o un grande modello via API, misurando su ogni sistema qualità delle decisioni, interventi umani, errori gravi, tempi completi e costi computazionali effettivi. Il conto economico cambia con l’architettura: per un modello via API servono prezzi dei token in ingresso e in uscita, cache, chiamate agli strumenti e minimi contrattuali, per un modello aperto in casa ammortamento o noleggio delle GPU, memoria, rete e gestione operativa, per il post-training le sessioni di addestramento, i checkpoint, la preparazione dei dati e il costo di rivalidare tutto a ogni nuova versione. Un instradamento specializzato consuma pochi token ma va confrontato con una regola software a costo quasi nullo, un modello grande costa di più per richiesta ma può ridurre verifiche e ripetizioni, e la metrica che mette d’accordo i casi è il costo per risultato accettabile a parità di carico e di qualità.
Fra un anno alcuni di questi nomi saranno divisioni di Nvidia o di AMD, altri avranno chiuso, uno o due saranno diventati fornitori con bilanci veri. L’impresa che oggi prova Beam o Jev su un flusso reale, con una baseline, il costo per risultato e una clausola di uscita già scritta, si ritrova in mano un pilot misurato, con numeri suoi che valgono anche quando il laboratorio cambierà proprietario.


Partecipa alla community