


Due Mac Studio con chip M5 Ultra, 512 gigabyte di memoria unificata ciascuno, collegati in Thunderbolt: è la configurazione su cui Meta fa girare in locale un modello da 816 miliardi di parametri. Si chiama Muse Spark Open, i suoi pesi, cioè i valori numerici che ne determinano il comportamento, sono scaricabili dal 15 ottobre da chiunque accetti la licenza, e l’annuncio di Meta Superintelligence Labs lo presenta come il modello open weight più capace mai rilasciato da un laboratorio americano, con una qualifica geografica che pesa più dell’aggettivo.
Nella tabella che la stessa Meta pubblica nella model card, l’indice sintetico di Artificial Analysis assegna a Muse Spark Open 39 punti, contro i 45 di GLM 5.3 di Z.ai, i 44 di Kimi K3 di Moonshot e i 40 di Qwen3.8 di Alibaba. Il primato vale dentro i confini degli Stati Uniti, dove i rivali diretti, Inkling di Thinking Machines Lab e Nemotron 3 Ultra di Nvidia, si fermano a 26 e 23.
Fuori da quei confini il modello di Meta arriva quarto nella sua stessa tabella, e si fa valere su terreni precisi, dall’uso di strumenti al ragionamento senza aiuti esterni, fino alla sicurezza e al costo effettivo di ogni compito.
Indice degli argomenti:
MoE da 816 miliardi su due Mac Studio
Muse Spark Open è un mixture of experts, un’architettura in cui ogni strato contiene molte sottoreti specializzate e un router ne attiva solo alcune per ciascun token, l’unità di testo su cui i modelli lavorano e i fornitori calcolano la tariffa. Gli esperti sono 256 per strato e se ne accendono 8 alla volta, per cui a ogni passaggio lavorano 42 miliardi di parametri sugli 816 totali, distribuiti su 62 strati.
Il contesto, vale a dire la quantità di testo che il modello tiene presente in una sola richiesta, arriva a un milione di token, e l’ingresso accetta testo, immagini, audio e video grazie a un codificatore visivo da 1,8 miliardi di parametri, mentre l’uscita è soltanto testuale.
Meta lo descrive come costruito per il coding e per gli agenti, i programmi che pianificano ed eseguono compiti in più passaggi chiamando strumenti esterni, con un ragionamento regolabile su quattro livelli, da low a xhigh, e il massimo impostato come valore predefinito. Il dettaglio ha un prezzo: chi non abbassa il livello sui compiti semplici paga un ragionamento che non gli serve.
Il fatto che lavori solo una parte del modello per ogni token rende le risposte rapide, ma non riduce la memoria necessaria, perché tutti gli esperti devono stare caricati. Meta indica almeno 700 gigabyte di memoria GPU per la versione NVFP4, un formato a 4 bit che comprime i pesi a circa un terzo, e 2 terabyte per la versione a piena precisione BF16, mentre la guida per sviluppatori parla di quattro GPU Blackwell Ultra o otto H200 in un data center.
I due Mac Studio dimostrano che lo stesso modello entra su una scrivania, con un’avvertenza: sullo store di Apple la memoria da 512 gigabyte risulta in arrivo a fine ottobre e senza prezzo, mentre quattro macchine da 256 gigabyte, per la stessa memoria complessiva, una soluzione che la stessa guida Meta prevede, costano a listino 10.799 dollari l’una nella versione con un terabyte di disco, oltre 43mila dollari in tutto.
Chi non vuole comprare hardware trova il modello dal primo giorno via API, l’interfaccia con cui un software lo interroga a consumo, su Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter e Together AI, e può scaricare i pesi da Hugging Face, Amazon SageMaker, Google Cloud e Microsoft Foundry.
Le condizioni cambiano da un fornitore all’altro: su GroqCloud, ancora in anteprima limitata, la documentazione di Meta citata da VentureBeat indica un contesto di 131.072 token anziché un milione.
Indice Artificial Analysis: 39 contro 45
La storia recente di Meta spiega il peso della bandiera. Ad aprile la società aveva lanciato il primo Muse Spark come modello chiuso, accessibile solo dalle proprie app e da un’API in anteprima, interrompendo la tradizione dei pesi aperti cominciata con Llama nel 2023; ad agosto è arrivato Muse Glimmer, 30 miliardi di parametri con licenza Apache 2.0, e Mark Zuckerberg ha accompagnato il rilascio chiedendo meno barriere per l’open source americano, per competere con i laboratori cinesi. Muse Spark Open è il secondo passo di quella promessa, e il più pesante.
Nel frattempo il terreno dei modelli aperti è diventato cinese. Hugging Face stima che nell’ultimo anno i modelli cinesi abbiano raccolto il 41% dei download, e su OpenRouter, il marketplace che smista le richieste di decine di migliaia di sviluppatori verso centinaia di modelli, a settembre il 69% dei token andava a laboratori cinesi. Il grafico fotografa la posizione di partenza nella tabella di Meta.
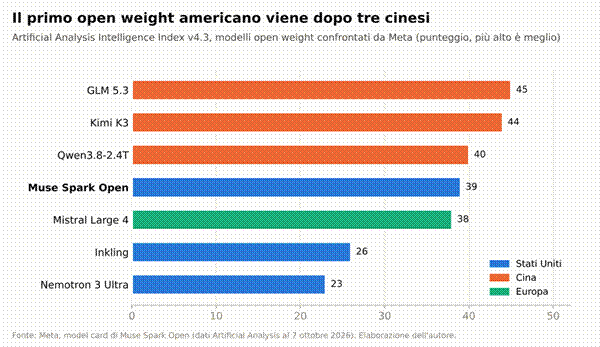
Il 39 viene dalla tabella di Meta, che lo riprende da Artificial Analysis al 7 ottobre, e il valutatore lo ha poi confermato con una propria scheda, 38,9 punti, che vale il primo posto tra gli open weight americani. La stessa classifica, come ricorda VentureBeat, mette sopra quella soglia altri modelli cinesi assenti dal confronto di Meta, da MiMo-V2.6-Pro di Xiaomi, a 46, fino a GLM-5.3-Flash e Qwen3.8-Flash-Next, e DeepSeek V4.1 Flash la eguaglia.
Un solo punto più in basso c’è Mistral Large 4, a 38, e per un’impresa europea che cerca un’alternativa ai pesi cinesi, il confronto rilevante passa anche da Parigi.
MCP-Atlas a 89,2, Terminal-Bench a 76,4
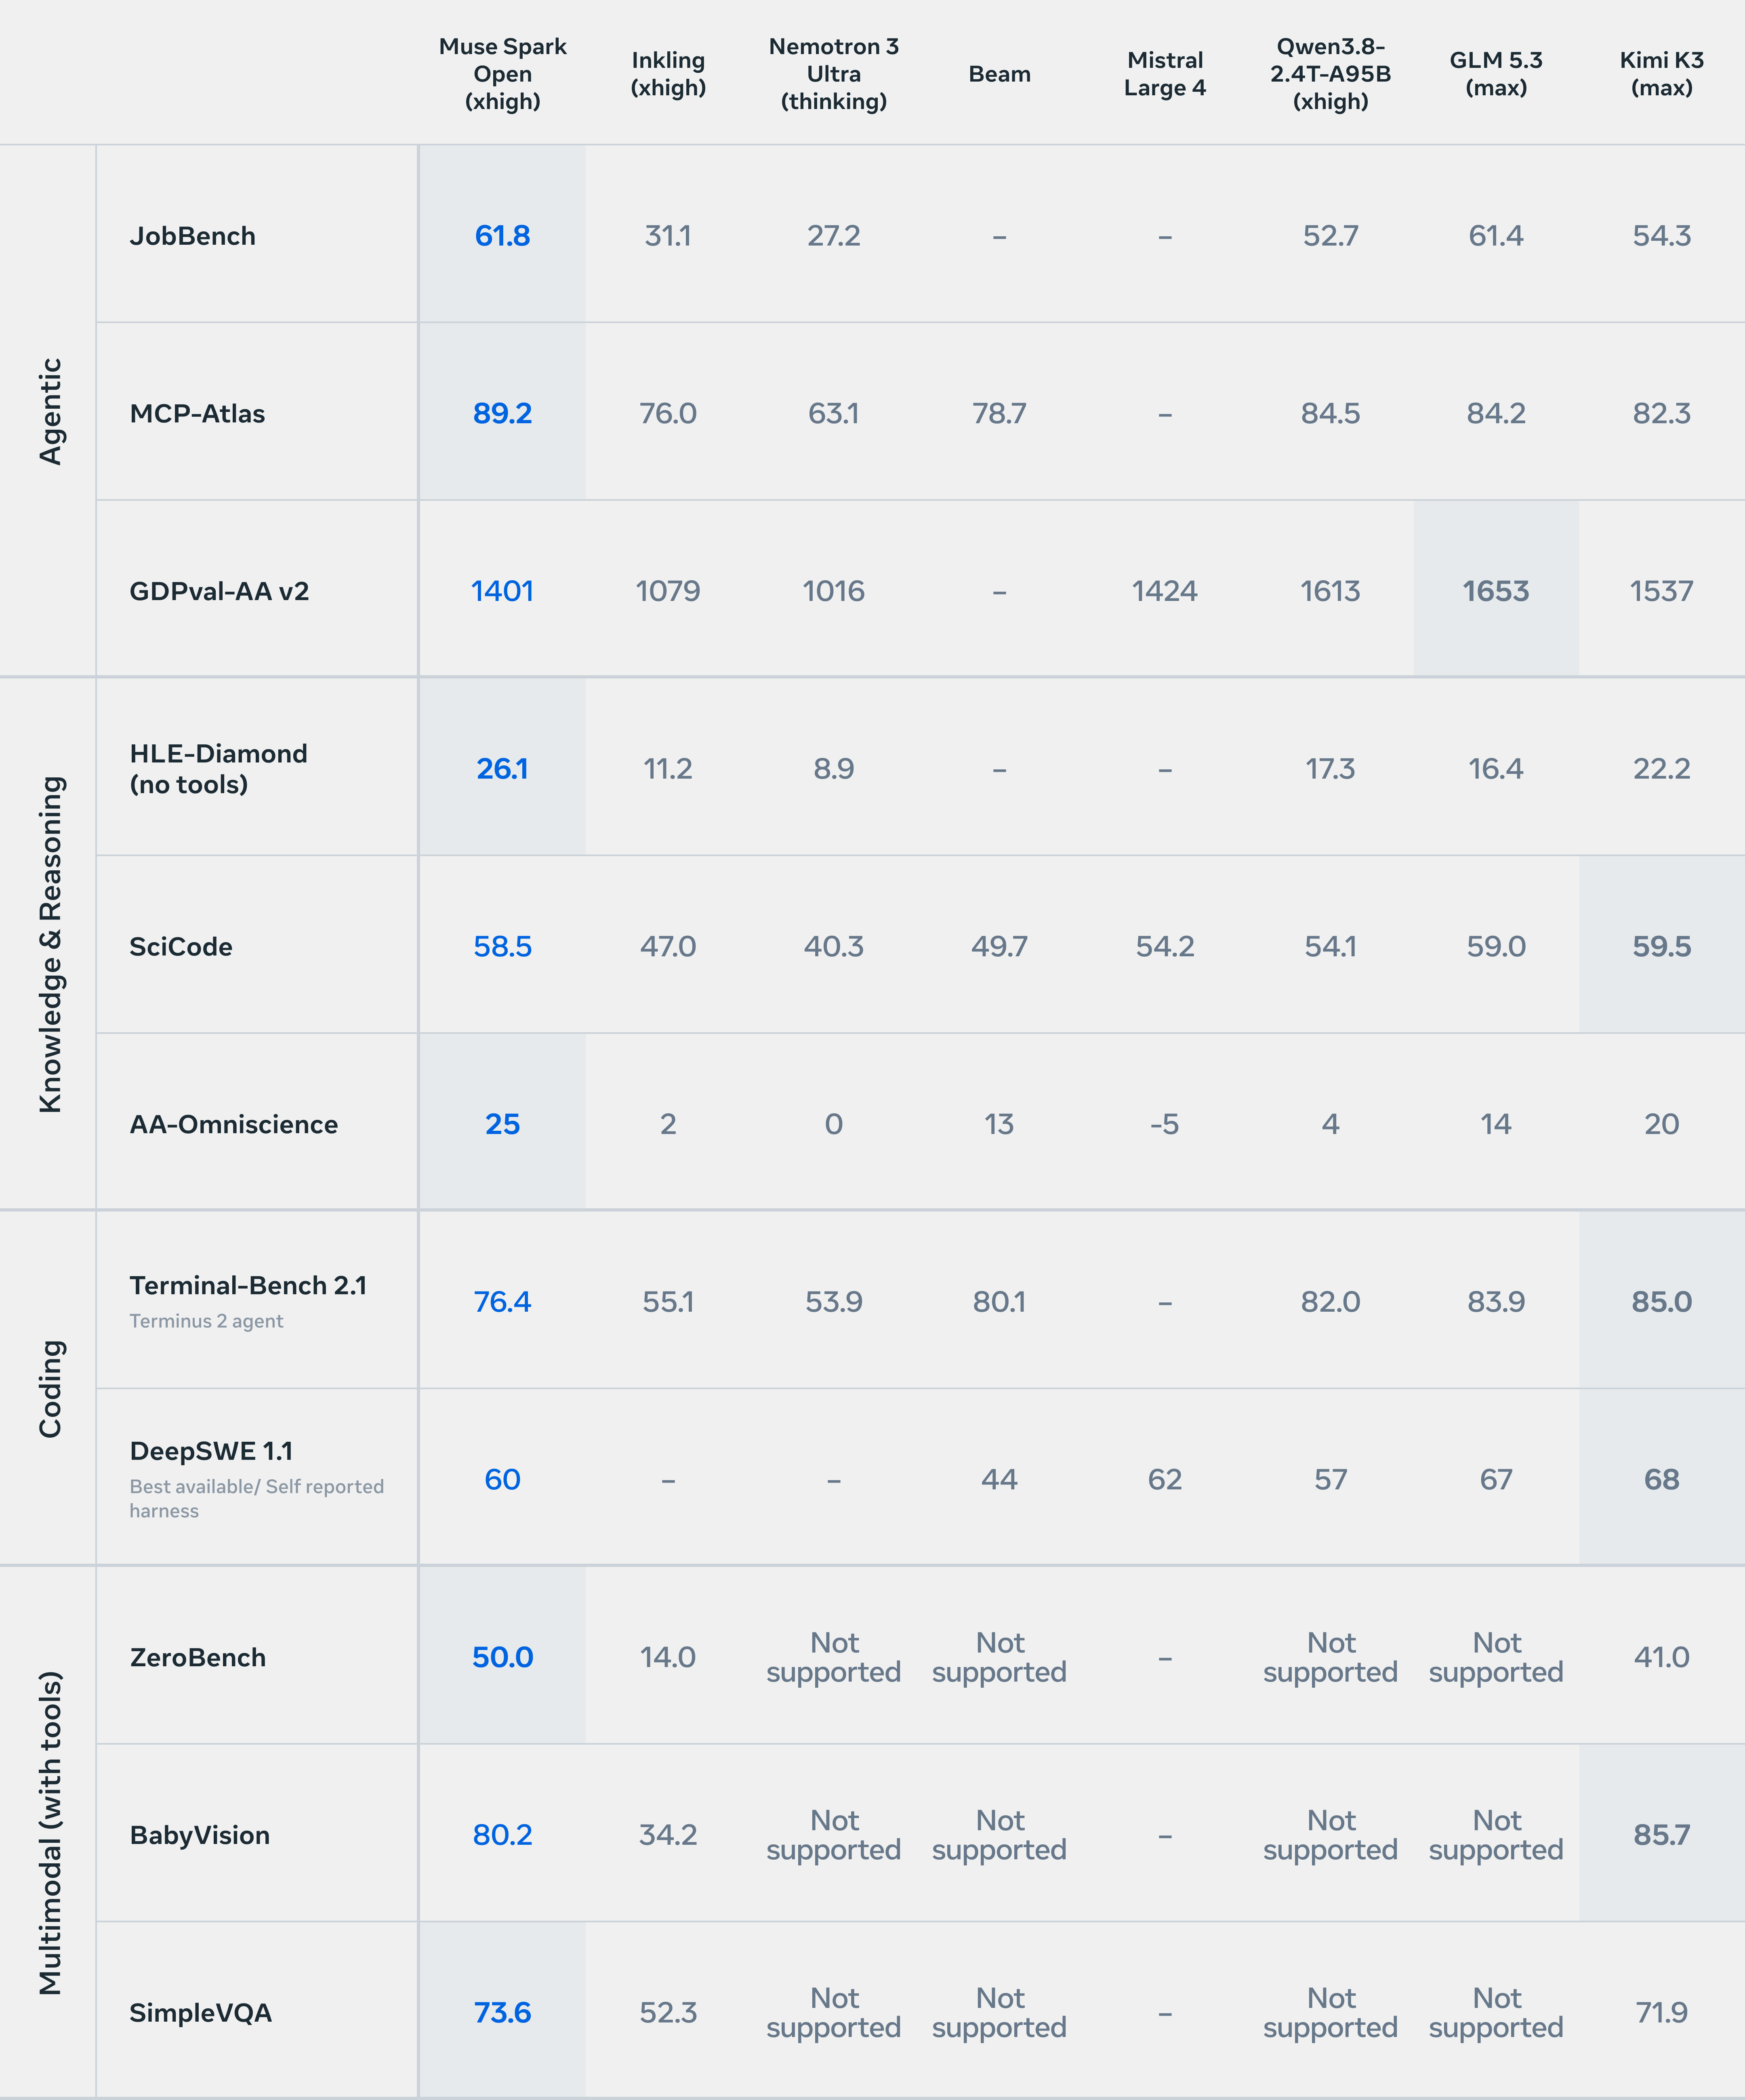
La media dell’indice nasconde un profilo molto irregolare. Muse Spark Open è primo su MCP-Atlas, mille compiti scritti da persone su 36 server Model Context Protocol, lo standard con cui gli agenti si collegano a strumenti e servizi esterni, con 89,2 punti contro gli 84,5 di Qwen3.8; è primo anche su JobBench, 65 compiti professionali in 35 mestieri d’ufficio, sia pure con quattro decimi di vantaggio su GLM 5.3.
Guida su HLE-Diamond senza strumenti, un sottoinsieme di Humanity’s Last Exam che misura il ragionamento a libro chiuso, e su AA Omniscience, l’indice che penalizza le risposte sbagliate date con sicurezza e premia l’astensione, dove ottiene 25 punti contro i 20 di Kimi K3: in proporzione a quello che sa, inventa meno. Sulla visione il bilancio è in pari, avanti su ZeroBench e IntPhys2, dietro su BabyVision e VideoMME, sempre nel confronto con il solo Kimi K3, l’unico cinese della tabella che legge immagini e video.
Sul codice il quadro si rovescia. Su Terminal-Bench 2.1, 89 compiti da eseguire in un terminale tra sviluppo, amministrazione di sistema e sicurezza, il modello di Meta ottiene 76,4 contro gli 85,0 di Kimi K3 e gli 83,9 di GLM 5.3, e su SWE-Atlas-QnA, che verifica la comprensione del codice in undici grandi progetti open source, si ferma a 58 contro 66. Sul lavoro professionale misurato da GDPval-AA, 220 compiti con file da consegnare in 44 mestieri, si piazza sotto Mistral Large 4 e i tre cinesi, con 1.401 punti Elo contro i 1.653 di GLM 5.3. Mettendo il modello di Meta accanto al migliore dei tre cinesi, benchmark per benchmark, la linea di frattura diventa evidente.
Di seguito la tabella completa in formato testuale Markdown, con tutti i benchmark, i valori numerici e le evidenziazioni originali. Il simbolo «–» indica un dato non disponibile.
| Benchmark | Muse Spark Open (xhigh) | Inkling (xhigh) | Nemotron 3 Ultra (thinking on) | Beam | Mistral Large 4 | Qwen3.8-2.4T-A95B (xhigh) | GLM 5.3 (max) | Kimi K3 (max) |
|---|---|---|---|---|---|---|---|---|
| GENERAL | ||||||||
| Artificial Analysis Intelligence Index | 39 | 26 | 23 | – | 38 | 40 | 45 | 44 |
| AGENTIC | ||||||||
| JobBench | 61.8 | 31.1 | 27.2 | – | – | 52.7 | 61.4 | 54.3 |
| MCP-Atlas | 89.2 | 76.0 | 63.1 | 78.7 | – | 84.5 | 84.2 | 82.3 |
| GDPVal-AA v2 | 1401 | 1079 | 1016 | – | 1424 | 1613 | 1653 | 1537 |
| OSWorld Verified | 80.4 | 40.1 | – | – | – | – | – | 84.8 |
| Toolathlon Verified | 72.8 | 45.5 | 34.3 | – | – | 72.5 | 73.0 | 76.5 |
| KNOWLEDGE & REASONING | ||||||||
| HLE-Diamond (no tools) | 26.1 | 11.2 | 8.9 | – | – | 17.3 | 16.4 | 22.2 |
| AA Omniscience | 25 | 2 | 0 | 13 | -5 | 4 | 14 | 20 |
| SciCode | 58.5 | 47.0 | 40.3 | 49.7 | 54.2 | 54.1 | 59.0 | 59.5 |
| HLE (w/ tools) | 61.0 | 46.0 | 37.4 | 51.2 | – | 56.2 | 62.5 | 56.0 |
| GPQA Diamond | 89.0 | 87.2 | 86.7 | 90.5 | – | 93.5 | 91.7 | 93.5 |
| CODING | ||||||||
| DeepSWE 1.1 – Preferred harness | 60 | – | – | 44 | 62 | 57 | 67 | 68 |
| SWE-Atlas-QnA – Preferred harness | 58 | – | – | 35 | 59 | 62 | 59 | 66 |
| Terminal-Bench 2.1 – Terminus 2 agent | 76.4 | 55.1 | 53.9 | 80.1 | – | 82.0 | 83.9 | 85.0 |
| MULTIMODAL | ||||||||
| ZeroBench (w/ tools) | 50.0 | 14.0 | – | – | – | – | – | 41.0 |
| BabyVision (w/ tools) | 80.2 | 34.2 | – | – | – | – | – | 85.7 |
| SimpleVQA (w/ tools) | 73.6 | 52.3 | – | – | – | – | – | 71.9 |
| WorldVQA (w/ tools) | 49.4 | 18.0 | – | – | – | – | – | 51.0 |
| IntPhys2 | 68.3 | 55.2 | – | – | – | – | – | 60.3 |
| VideoMMEv2 | 61.5 | 36.9 | – | – | – | – | – | 65.4 |
| SAFETY | ||||||||
| FORTRESS adversarial (static) – lower is better | ARS: 5.8 / ORS: 17.4 | ARS: 25.0 / ORS: 7.4 | ARS: 26.4 / ORS: 13.3 | – | – | ARS: 21.6 / ORS: 12.8 | ARS: 28.2 / ORS: 3.2 | ARS: 26.7 / ORS: 2.7 |
| StrongREJECT v2 (adaptive) – lower is better | 0.5 | 86.4 | 80.7 | – | – | 65.6 | 62.9 | 66.6 |
Sui numeri dei concorrenti pesa il metodo. La metodologia di valutazione pubblicata da Meta dichiara che l‘harness, il software che circonda il modello con strumenti e istruzioni durante il test, non è stato ottimizzato per i modelli di terzi, e una parte dei valori è autodichiarata dai produttori o misurata in casa da Meta.
Separando le righe per fonte, i vantaggi più ampi del modello, su ZeroBench e IntPhys2, vengono da prove interne, mentre MCP-Atlas, JobBench, HLE-Diamond e AA Omniscience, misurati da Scale AI, dalle classifiche ufficiali o da Artificial Analysis, confermano il primato sugli strumenti e sull’affidabilità, e lo svantaggio sul coding di Terminal-Bench e SWE-Atlas-QnA viene anch’esso da Artificial Analysis. Su Terminal-Bench, con gli ambienti scelti dai produttori anziché con l’agente Terminus 2 usato da Meta, le schede ufficiali dichiarano 88,2 punti per GLM 5.3 e 88,3 per Kimi K3, misurato da Moonshot nel proprio Kimi Code: il modello è lo stesso, cambia l’ambiente intorno, e chi deve scegliere farebbe bene a ripetere il confronto dentro l’agente che usa ogni giorno.
1,25 dollari a milione, metà token di GLM
Sui listini Muse Spark Open sta nella parte alta dei modelli aperti, pur restando sotto i chiusi. Together AI, Fireworks, Baseten e Nebius lo offrono a 1,25 dollari per milione di token in input, 0,15 per l’input già in cache, cioè il testo che il fornitore conserva e rilegge a prezzo ridotto, e 4,25 in output, le stesse tariffe che Meta applica ai suoi Muse Spark ospitati. È appena sotto GLM 5.3, a 1,40 e 4,40, molto sotto Kimi K3, a 3 e 15, e costa circa la metà dei modelli chiusi di fascia media come Claude Sonnet 5.5 e GPT-6 Sol, entrambi a 2 e 10 dollari.
Il grafico applica i listini a un carico di riferimento di mille chiamate da 10 mila token in ingresso e 2 mila in uscita.
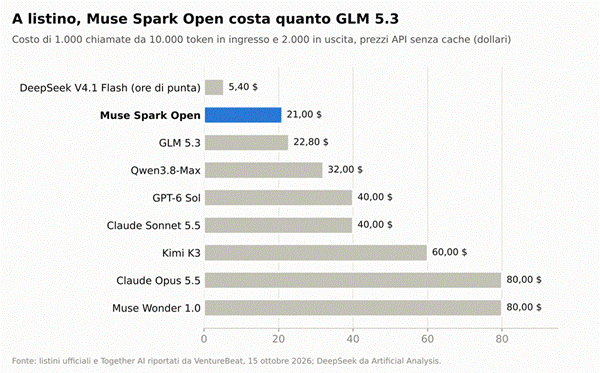
Il listino però dice poco sul costo di un compito, che dipende da quanti token il modello scrive per arrivare alla risposta, ragionamento compreso. Per completare l’intero indice, secondo la scheda di Artificial Analysis, Muse Spark Open ha generato 110 milioni di token di output, contro i 210 di GLM 5.3 e i 160 di Kimi K3, con un costo medio di 0,84 dollari per compito contro 2,01 e 2,00.
È un tratto che il valutatore aveva già osservato nel primo Muse Spark di aprile, l’economia nell’uso dei token, mentre il listino lo stesso valutatore lo giudica caro per un open weight di queste dimensioni, con prezzi mediani della categoria a 0,43 e 1,59 dollari.
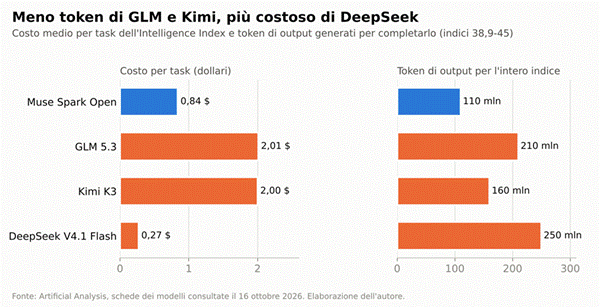
Il vantaggio vale contro GLM 5.3 e Kimi K3, molto meno contro i cinesi più economici. DeepSeek V4.1 Flash, rilasciato a settembre con licenza MIT, ottiene lo stesso 39 sull’indice scrivendo più del doppio dei token, 250 milioni, ma con un listino da 0,30 e 1,20 dollari nelle ore di punta il suo compito medio costa 27 centesimi, circa un terzo, e MiMo-V2.6-Pro di Xiaomi, anch’esso con licenza MIT e primo della classifica degli open weight a 46 punti, si ferma a 13 centesimi.
Su un carico dominato dagli agenti, dove gran parte dell’input è contesto ripetuto letto dalla cache, conta anche la tariffa di 15 centesimi per i token già visti, che in quel profilo d’uso incide più del prezzo in vetrina.
Fortress e StrongREJECT: blindato ma rigido
Meta ha aggiunto alla versione aperta un addestramento di sicurezza supplementare, pensato per un modello che verrà usato anche senza le protezioni di sistema delle API, e i risultati sono netti. Su StrongREJECT v2, un benchmark interno di 202 comportamenti vietati attaccati con tecniche di jailbreak, ossia di aggiramento dei filtri, la quota di attacchi riusciti è dello 0,5%, contro valori tra il 62,9% e l’86,4% per i concorrenti misurati da Meta.
Su Fortress, la classifica indipendente di Scale AI con oltre mille prompt avversariali su armi, terrorismo e attività illecite, il punteggio di rischio scende a 5,8, quando gli altri stanno tra 21 e 28. Lo stesso benchmark misura anche il costo di questa prudenza, la percentuale di richieste lecite che il modello rifiuta: 17,4% per Muse Spark Open, contro il 2,7% di Kimi K3 e il 3,2% di GLM 5.3.
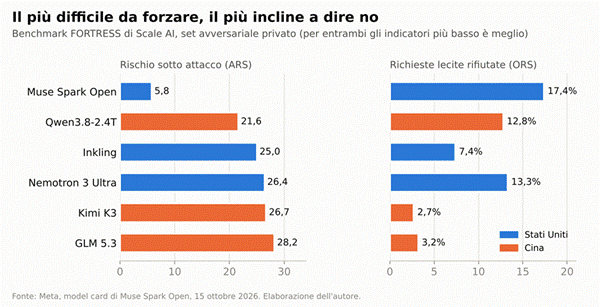
Per un’applicazione rivolta al pubblico in un settore regolato, un modello difficile da forzare alleggerisce il lavoro dei guardrail, i filtri che controllano ciò che entra ed esce; per un assistente interno che deve rispondere a tutto, il rifiuto di più di una richiesta lecita su sei è un attrito da misurare prima dell’adozione.
Meta raccomanda in ogni caso di inserirlo in un sistema con protezioni proprie e una conferma umana prima delle azioni irreversibili, e avverte che qualunque modifica successiva, a partire dal fine-tuning, cioè l’addestramento aggiuntivo su dati propri, può degradare quei risultati.
Muse Model License e la soglia dei 20 milioni
La Muse Model License parte con una formula simile alla MIT, che concede gratis uso, modifica, fine-tuning, distillazione, ossia l’addestramento di altri modelli sulle sue risposte, e redistribuzione, poi aggiunge le condizioni. Ogni prodotto che usa il modello o un suo derivato deve mostrare la dicitura «Built with Muse Spark Open» nell’interfaccia, nella documentazione o nelle impostazioni, e tra i derivati rientrano anche i modelli addestrati sugli output di Muse Spark Open.
Chi offre modelli come servizio a terzi, via API, con ricavi lordi di gruppo oltre 20 milioni di dollari in dodici mesi deve firmare un accordo separato con Meta prima di farlo, mentre uso interno, ricerca e funzioni integrate nei propri prodotti sono esclusi dalla clausola. La policy d’uso incorporata vieta le applicazioni militari e nucleari e la gestione di infrastrutture critiche, e dichiara il modello non destinato ai minori di 18 anni.
Sul piano contrattuale Meta è meno aperta del suo concorrente cinese più forte: la licenza di GLM 5.3 chiede una verifica di sicurezza di Z.ai soltanto a chi ospita il modello come servizio con ricavi di gruppo oltre i 10 miliardi di dollari. Per le imprese europee la controparte è Meta Platforms Ireland, e per scaricare i pesi da Hugging Face servono nome legale completo, data di nascita e ragione sociale. Il vantaggio rispetto ai pesi cinesi è geopolitico più che tecnico, perché i modelli cinesi girano già anche su server americani, come Kimi K3 nell’instradamento statunitense di OpenRouter, ma la provenienza è ancora una voce nei questionari di acquisto e nelle verifiche di conformità, e Muse Spark Open la chiude in partenza.
L’offerta di Meta a metà ottobre è fatta a strati: Glimmer piccolo e con licenza Apache, Muse Spark Open grande e con condizioni, i Muse Spark ospitati a 1,25 dollari per milione di token, Muse Wonder chiuso, a 4 dollari in input e 20 in output, per il lavoro più impegnativo.
Muse Spark Open sta in mezzo, come porta d’ingresso per chi vuole un modello americano da far girare in casa, e la dicitura obbligatoria nei menu delle impostazioni di ogni prodotto che lo adotta è il modo in cui Meta si fa pagare un modello regalato: con la visibilità del proprio nome, in un mercato degli open weight dove finora, dietro i prodotti di migliaia di startup, giravano soprattutto modelli cinesi.




Partecipa alla community