


Mistral Large 4, il modello più grande mai addestrato in europa, nome in codice “Le Chonk“, un riferimento al meme del “Chaton Fat” che circolava sui social da giugno. Si tratta di un’architettura da 1,05 mila miliardi di parametri, accessibile da subito tramite API in anteprima pubblica, e in open weight entro la fine del mese per permettere a chiunque abbia un hardware abbastanza potente di fare inferenza locale.
È il primo prodotto finanziato dal round di Serie D da 3 miliardi di euro chiuso a settembre, Mistral lo presenta come il miglior modello open sviluppato fuori dalla Cina. Le prime impressioni confermano in parte questa collocazione, anche se per una valutazione completa bisognerà ancora testare a fondo le capacità di questa nuova intelligenza artificiale.
Indice degli argomenti:
Le dimensioni del modello
I parametri sono i valori numerici che il modello apprende durante l’addestramento. Rappresentano a grandi linee la sua memoria e la sua capacità di elaborazione. Più parametri significano in genere più conoscenza e più capacità di ragionamento, a fronte di costi maggiori per farlo funzionare.
Large 4 usa un’architettura detta Mixture-of-Experts (MoE), il modello è suddiviso in molti sottoinsiemi specializzati, per ogni porzione di testo da elaborare, un meccanismo di instradamento sceglie quali esperti attivare. Dei 1,05 mila miliardi di parametri totali, ne lavorano così 49 miliardi alla volta, circa il 4,7%.
La documentazione ufficiale parla di MoE granulare, termine con cui nel settore si indica un modello con esperti numerosi e di dimensioni ridotte, un’impostazione pensata per favorire la specializzazione.
Al momento parte dei dettagli architetturali è ancora riservato, Mistral ha promesso di svelare più informazioni insieme ai pesi entro Settembre.
Il predecessore, Mistral Large 3, uscito a dicembre 2025, aveva soltanto 675 miliardi di parametri totali e 41 miliardi attivi. Il nuovo modello aggiunge circa il 56% di capacità complessiva e un quinto in più di parametri attivi.
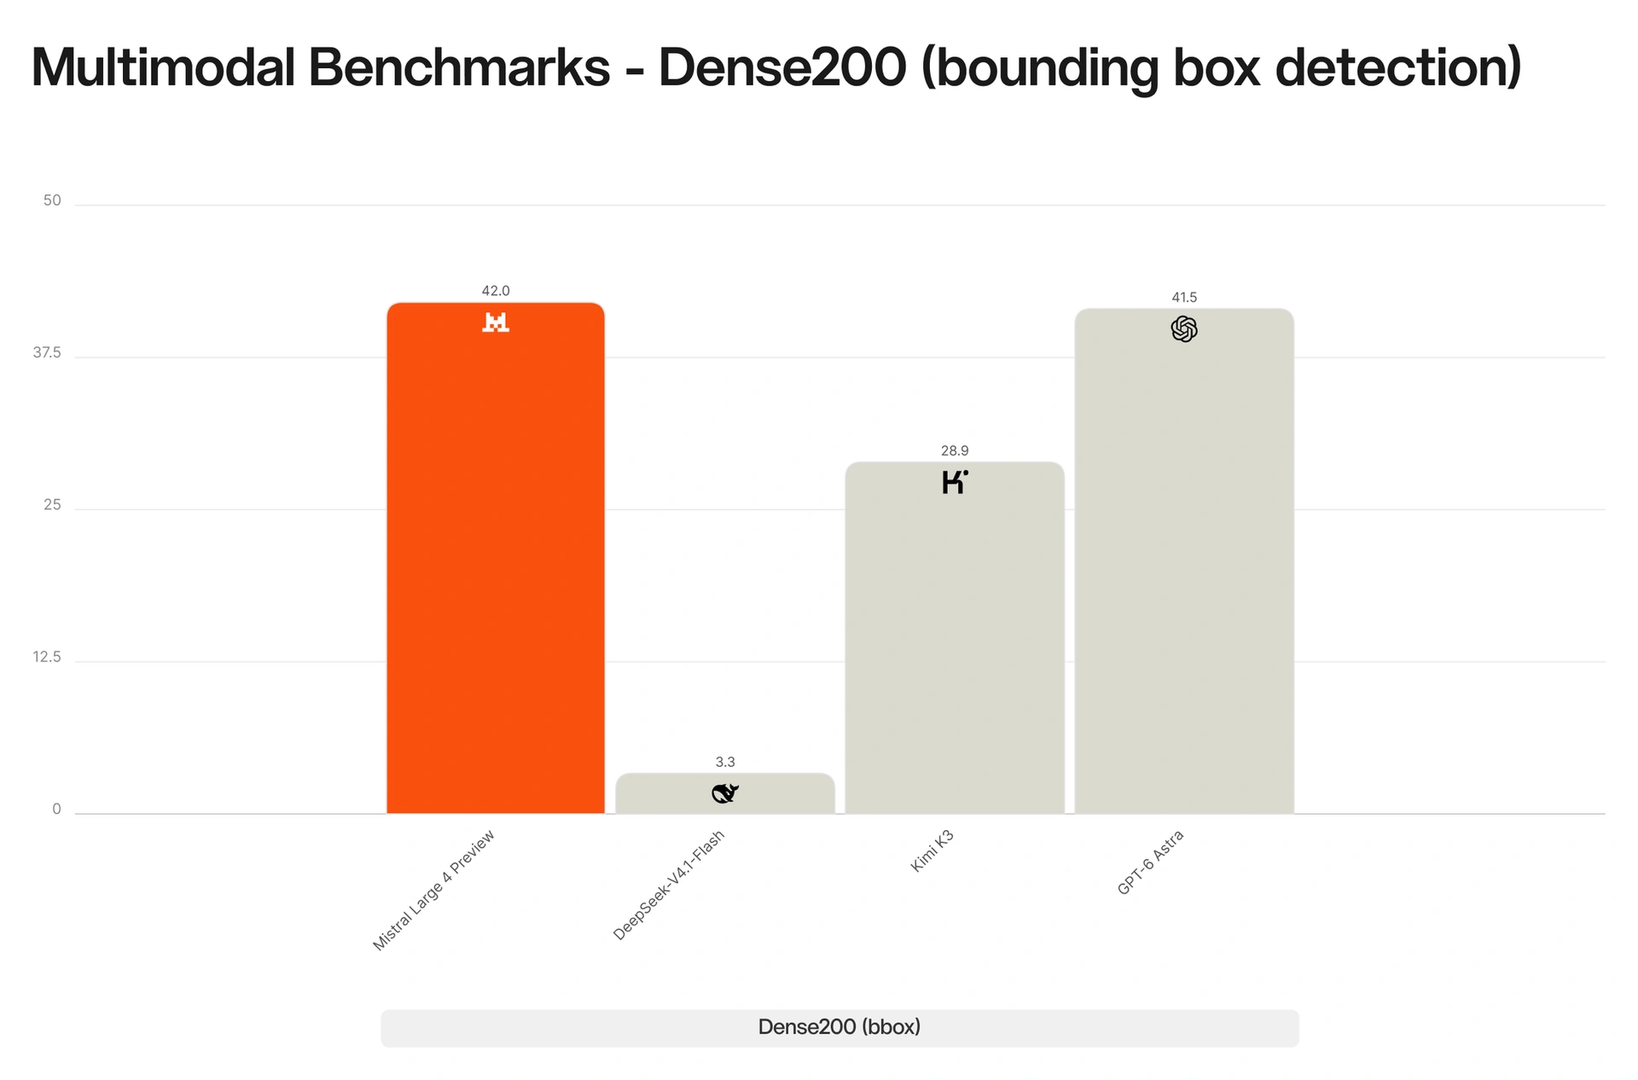
Large 4 è nativamente multimodale in ingresso, accetta testo e immagini grazie a un codificatore visivo da 1,6 miliardi di parametri e restituisce solo testo. Il modello è inoltre ibrido, lo stesso sistema può rispondere in modo diretto oppure attivare una fase di ragionamento esteso, regolabile via API con un parametro che ne fissa l’intensità.
La finestra di contesto secondo la scheda tecnica di Mistral è di un milione di token, ma al momento le API prevedono un limite di 24.288 token di contesto (512K) e 262.144 token in uscita (256K). Dai primi test sembra che il modello regga bene fino a circa 250k token di contest, per poi iniziare a perdere efficacia e coerenza. Un contesto comunque ampiamente sufficiente per la maggior parte delle attivitá reali per le quali si usa l’AI.
Large 4 è stato addestrato da zero su 3.800 GPU Nvidia Grace Blackwell nei data center europei di Mistral. L’addestramento è durato circa due mesi e potrebbe aver assorbito circa 10 megawatt di energia. L’anteprima pubblica gira sulla stessa infrastruttura usata per l’addestramento.
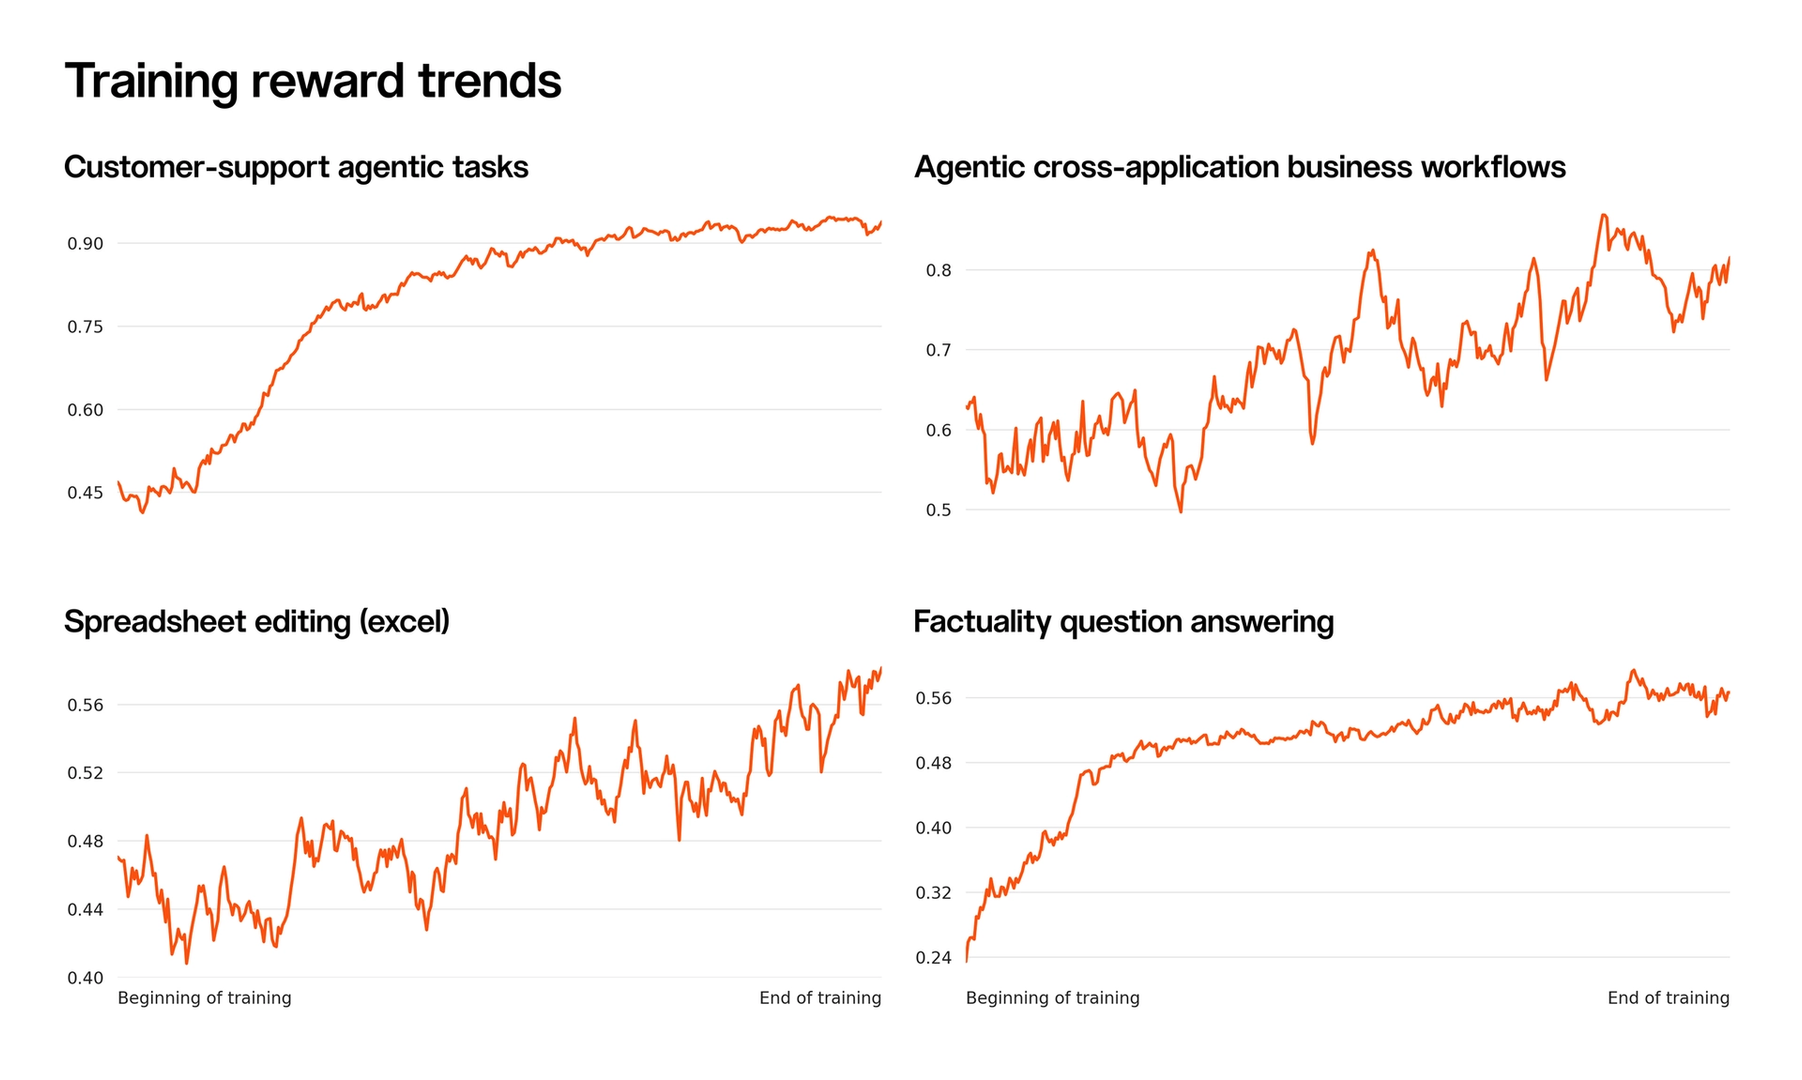
Mistral usa in modo estensivo il reinforcement learning, il modello prova a risolvere compiti, riceve un punteggio sul risultato e corregge il proprio comportamento.
Benchmark e performance sul campo
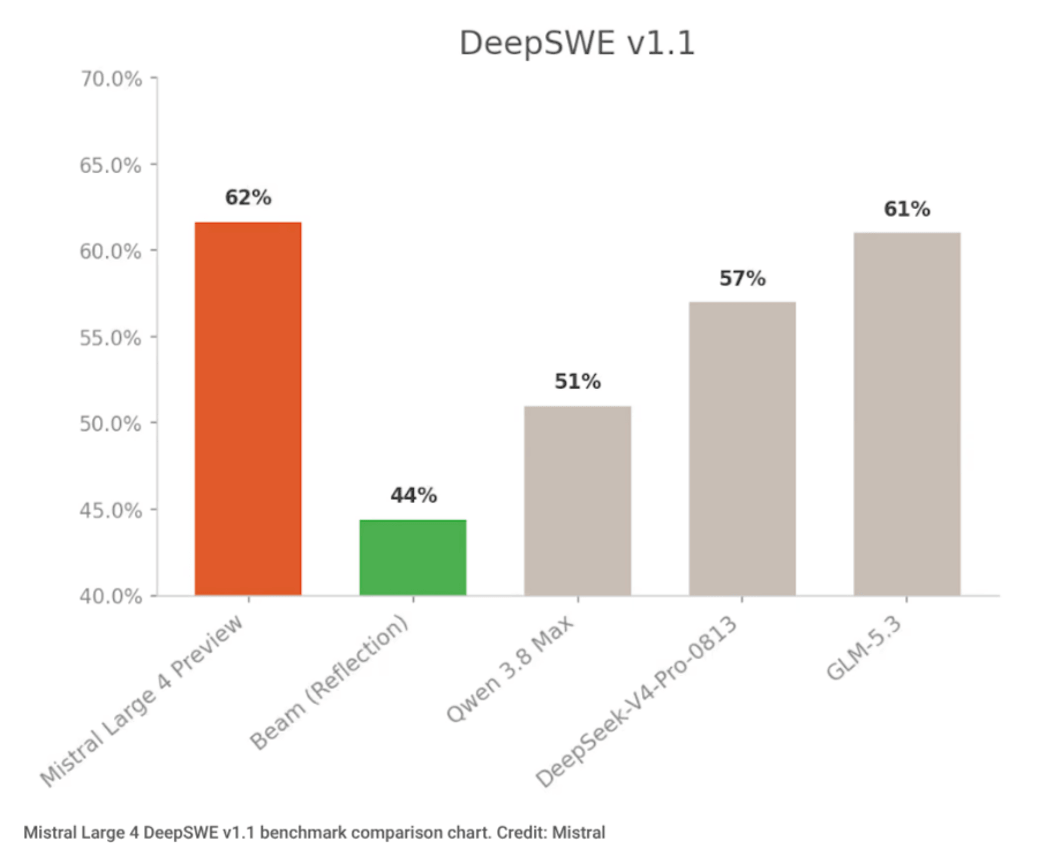
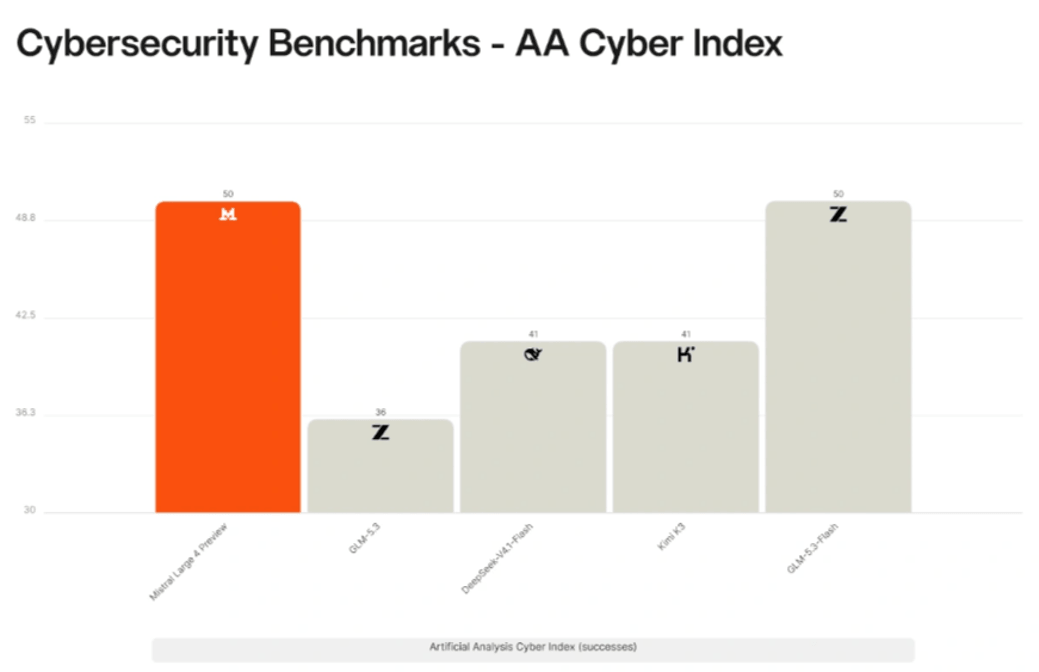
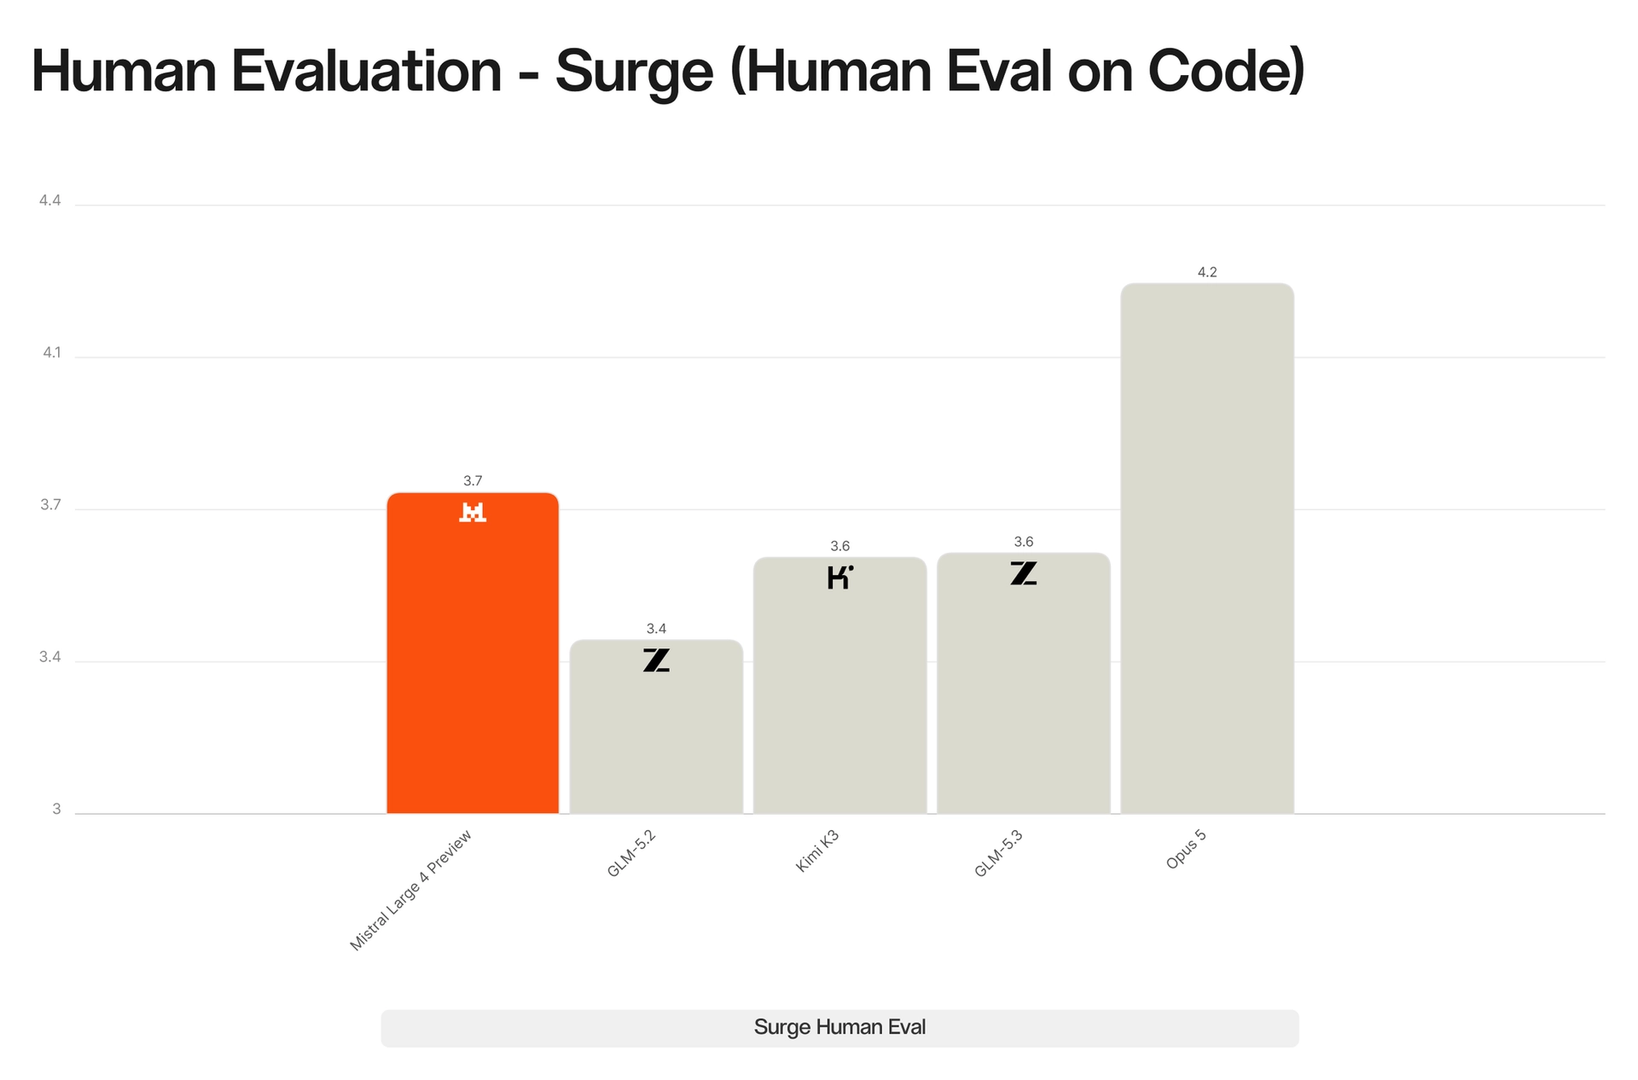
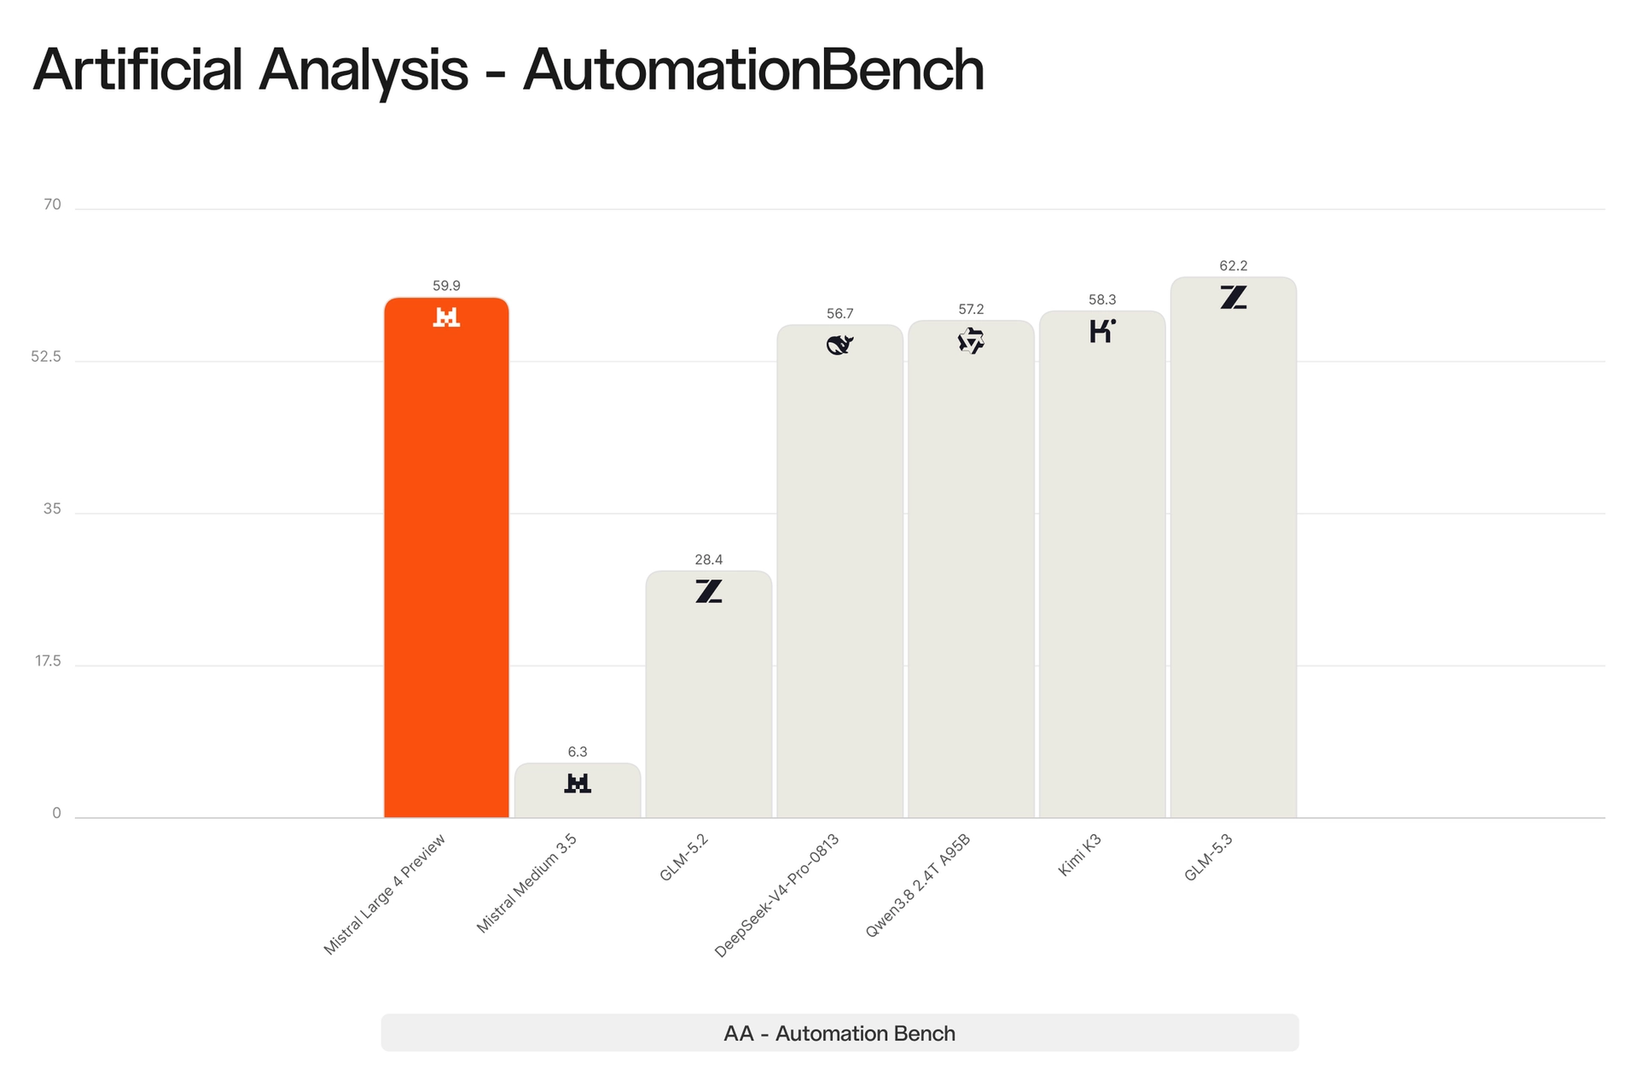
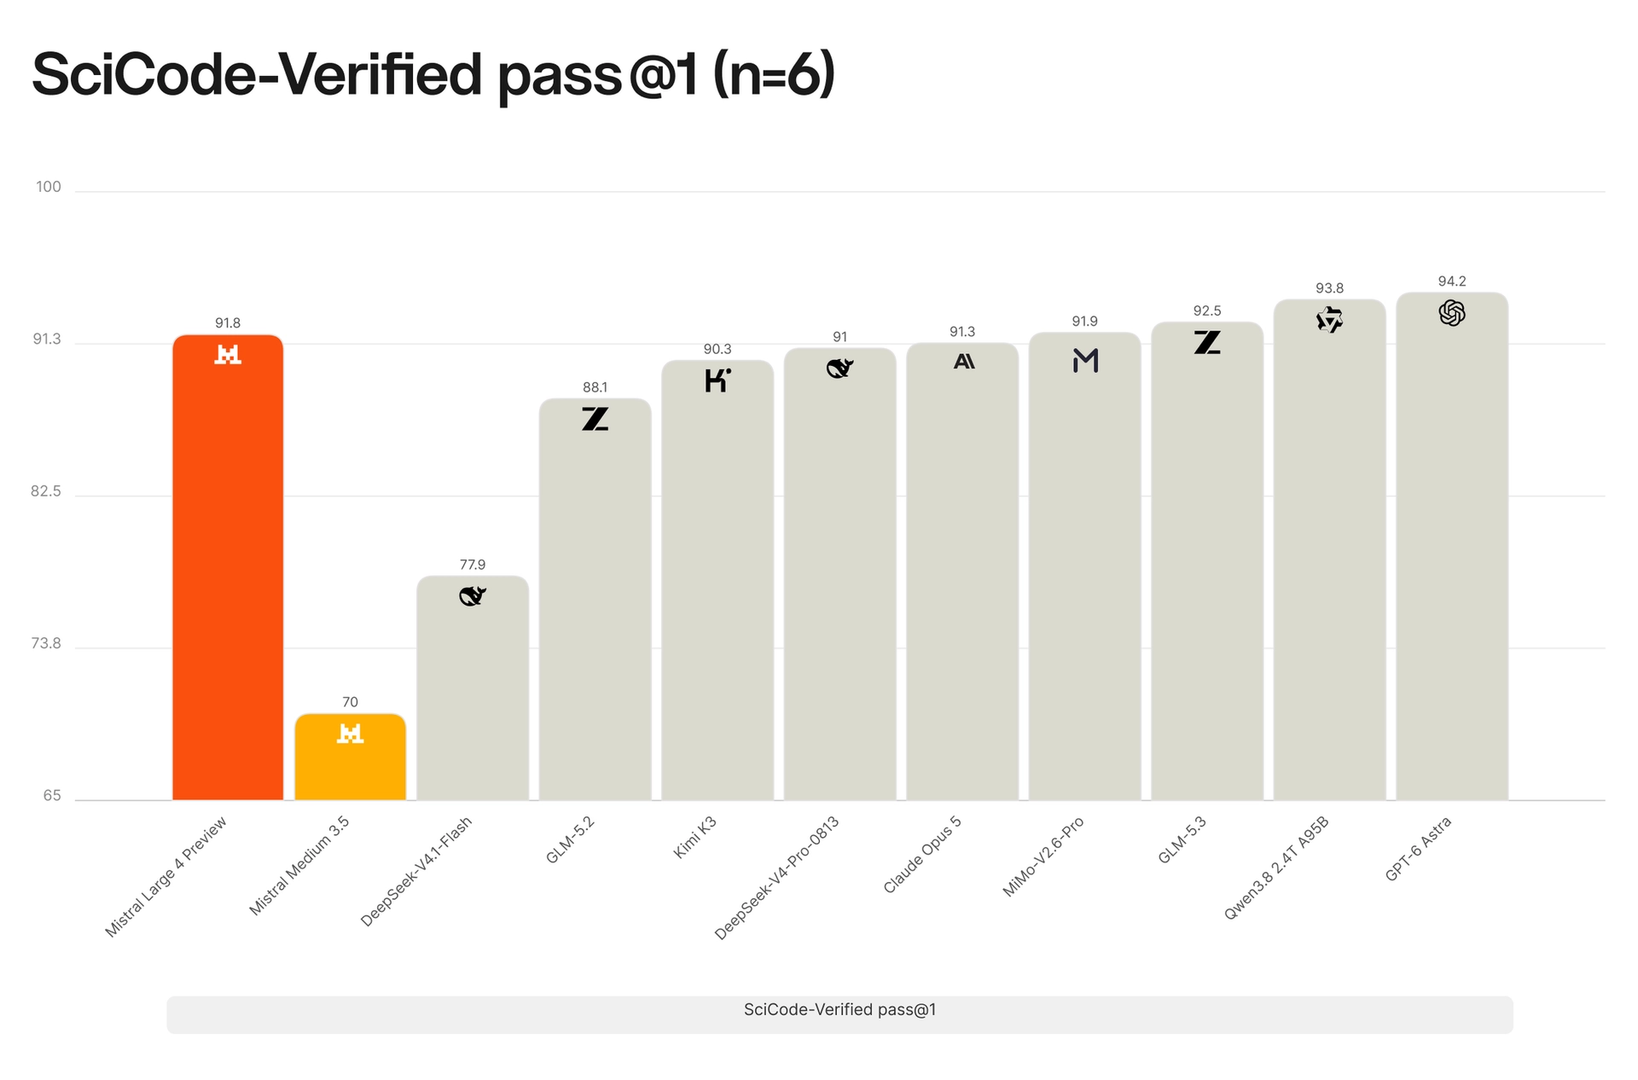
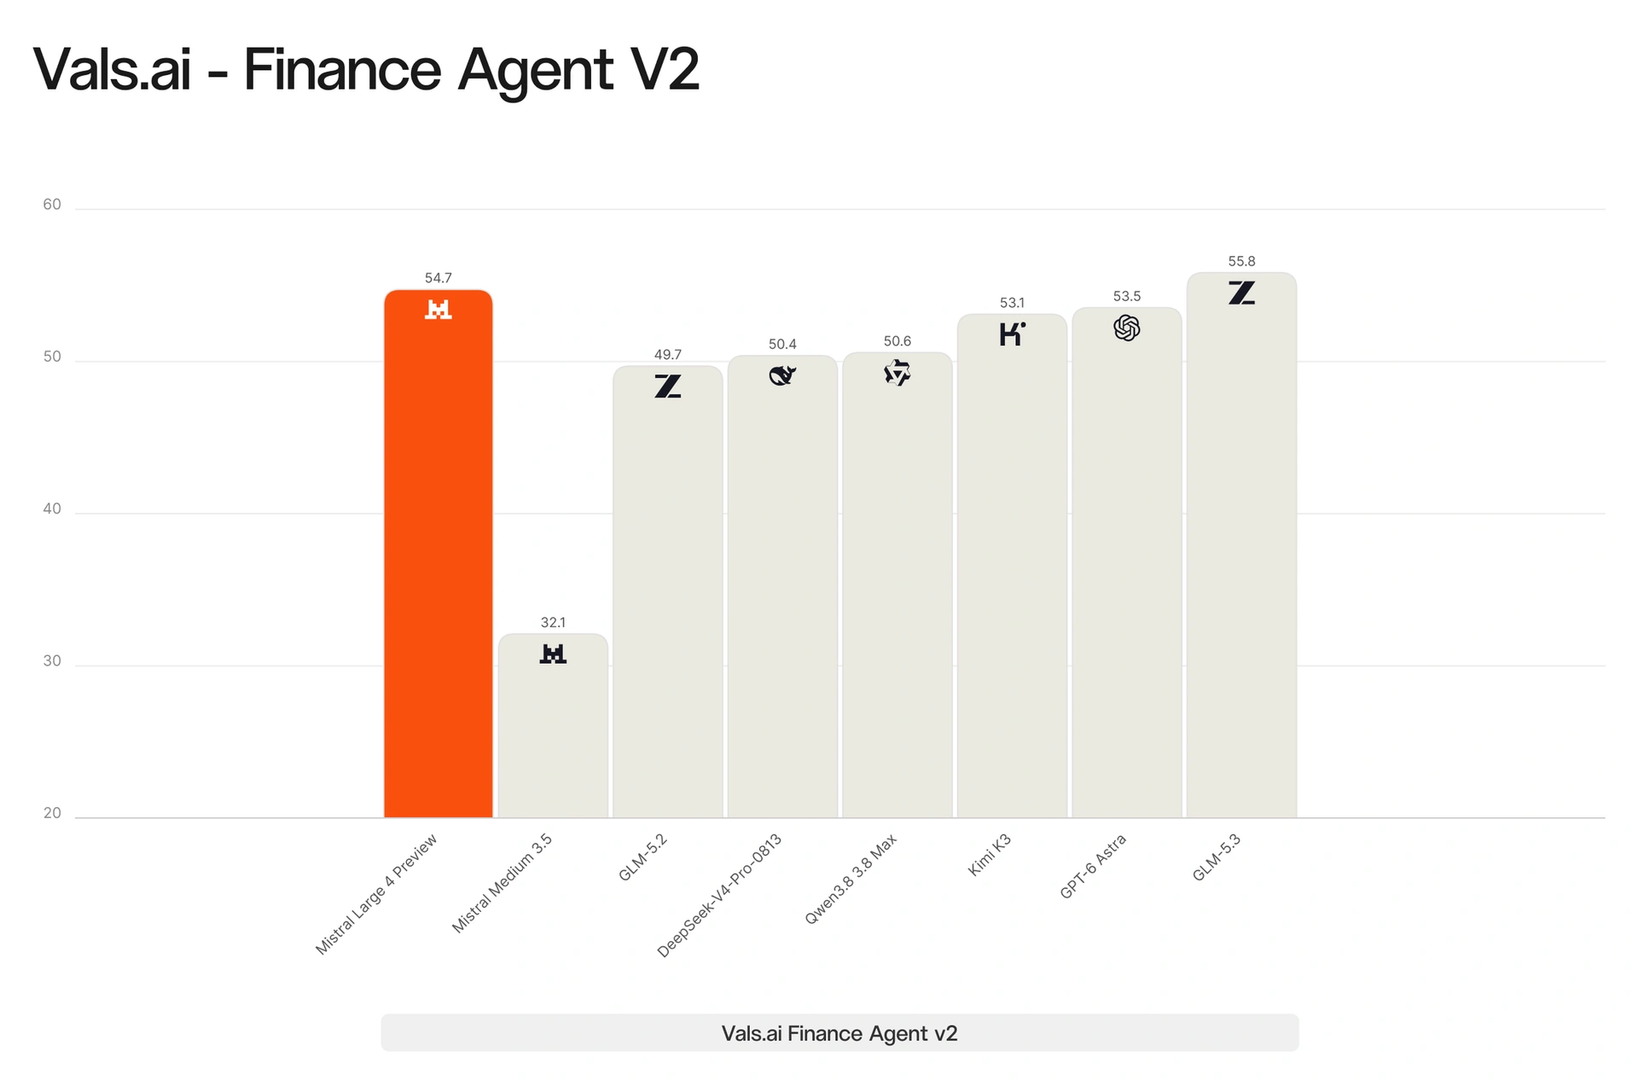
I benchmark sono valutazioni sintetiche ben lontane dall’utilizzo reale di un modello, ma nonostante i noti limiti, sono utili a paragonare per grandi linee capacitá specifiche di LLM diversi. Dai risultati pubblicati da Mistral, nei test di coding il nuovo modello europeo si comporta egregiamente, mettendosi davanti a competitors di rilievo come GLM 5.3 e Qwen 3.8 Max.
Uno dei punti forti della nuova architettura sembra essere proprio la cybersicurezza, in cui il modello riesce ad eccellere. Questa abilitá è particolarmente importante per garantire l’indipendenza europea in uno degli ambiti più delicati e temuti, dato l’attuale assetto geopolitico. Anche in questo caso Large 4 supera il test con un punteggio uguale o superiore a quello della concorrenza open-weight più performanti, e non troppo distante dai modelli di frontiera americani.
Artificial Analysis assegna a Large 4 un punteggio di 38 nel proprio Intelligence Index, che aggrega dieci valutazioni su lavoro d’ufficio agentico, programmazione, conoscenze, ragionamento e contesti lunghi. È il miglior risultato tra i modelli aperti occidentali in classifica, otto punti sotto MiMo-V2.6-Pro di Xiaomi, primo tra i modelli aperti.
I benchmark, comunque, raccontano solo una parte della storia, perché non riescono a valutare efficacemente come si comporta il modello quando ha a che fare con un problema aperto, con un contesto complesso o con un prompt scarno e indicazioni poco profonde.
Un test indicativo è la progettazione di un’architettura software complessa a partire da un prompt volutamente minimalista. È un esercizio che premia la capacità di astrazione, l’AI deve capire dove stanno i punti critici, come separare le responsabilità tra i componenti, dove concentrare l’attenzione su concorrenza, consistenza dei dati e scalabilità.
Large 4 produce una struttura di base sensata e scrive codice pulito, ma fa fatica proprio nelle parti più delicate del progetto. Tende a fermarsi a soluzioni corrette ma generiche, che diventano poco efficaci quando si ragiona su prestazioni e manutenibilità nel lungo periodo. Quando un esperto interviene, segnala il problema e orienta le scelte, il modello recupera bene e propone alternative valide. Lasciato da solo, però, raramente arriva a quelle soluzioni di sua iniziativa.
Nello stesso confronto GLM 5.2 ha fatto leggermente meglio, mostrando un po’ più di autonomia nelle decisioni architetturali, mentre Kimi K3 ha commesso qualche errore in più di Large 4.
Il quadro, insomma, è quello di un modello competitivo nella sua fascia, ma un passo indietro nei compiti che richiedono astrazione. Lo scarto è contenuto, ma si è ripresentato in modo coerente in tutte le prove di questo tipo.
Velocità e resistenza al prompt injection
C’è poi la questione della velocità. Nelle sessioni di lavoro reali Large 4 si è dimostrato abbastanza lento, sia nel tempo che impiega a iniziare a rispondere sia nella generazione delle risposte lunghe. Nelle interazioni brevi pesa poco, ma nei flussi agentici, dove il modello esegue molti passaggi in sequenza, i tempi si sommano e l’esperienza ne risente in modo concreto. Queste prime impressioni possono anche dipendere dal carico sull’infrastruttura hardware, che potrebbero essere state anche più elevate della media a poche ore dall’annuncio ufficiale di lancio.
Dove invece il modello francese convince pienamente è la robustezza al prompt injection. Ingannarlo e ottenere uno steering rilevante si è rivelato molto difficile, sia attaccandolo direttamente in chat sia nascondendo istruzioni malevole nei documenti passati come sorgenti dati durante una sessione. Questo secondo scenario è il più insidioso, perché è quello che si verifica nell’uso reale, quando un agente legge pagine web, email o file di terze parti.
Large 4 ha distinto con costanza i contenuti da elaborare dalle istruzioni da seguire, ignorando i comandi iniettati senza perdere il filo del compito originale. In questo è in linea con il resto dei modelli di nuova generazione, che su questo fronte hanno segnato un netto passo avanti rispetto al passato e si dimostrano oggi decisamente più resistenti ad attacchi di questo tipo.
Prezzi e disponibilità
Il listino ufficiale di Large 4 è di 1,36 dollari per milione di token in ingresso, 0,14 dollari per i token in ingresso già presenti nella cache e 4,18 dollari per milione di token in uscita. Alla data di pubblicazione dell’articolo la pagina prezzi di Mistral mostra questi valori barrati e applica uno sconto del 50%: 0,68, 0,07 e 2,09 dollari. Mistral non ha indicato una data di scadenza della promozione.
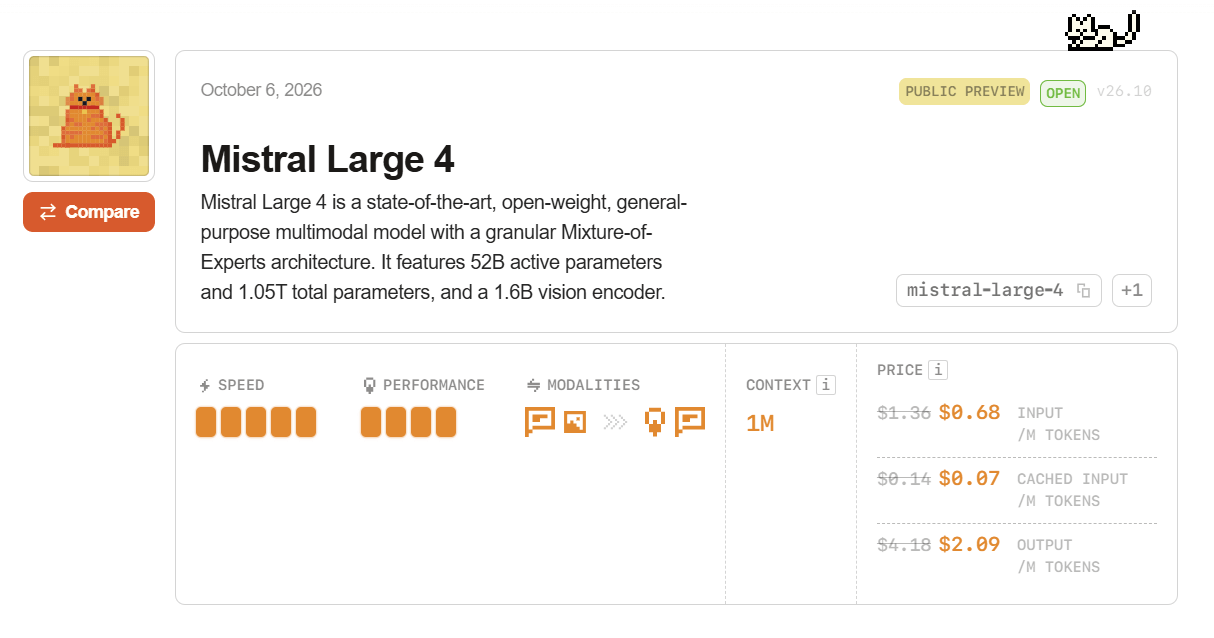
Il modello si usa oggi via API su Mistral Studio, con supporto a output strutturati (risposte in formato JSON, utili per alimentare altri software), chiamata di funzioni esterne, domande su documenti, elaborazione in batch e agenti.
A breve avremo accesso libero ai weights, significa che i parametri del modello vengono pubblicati e chiunque può scaricarli, eseguirli sui propri server, adattarli ai propri dati e ispezionarli. È una condizione diversa dall’open source in senso stretto, che comprende oltre ai pesi anche i dati e il codice di addestramento. Comunque la possibilitá di fare inferenza locale resta un vantaggio molto interessante.
Restano due incognite. La prima è la licenza, che Mistral deve ancora comunicare. La seconda incognita riguarda la versione, non sappiamo se i pesi in arrivo a fine mese corrisponderanno a un modello con un ciclo di addestramento più lungo, quindi con perfomance superiori alla preview che al momento abbiamo a disposizione.
Il contesto geopolitico
Large 4 arriva in una fase in cui la sovranità tecnologica è diventata un criterio d’acquisto, e un tema chiave della politica industriale. Mistral usa la formula forgiato in Europa, ripetuta più volte, per sottolineare che addestramento, infrastruttura e servizio interamente europei.
A settembre 2026 il governo francese ha concluso un accordo con l’azienda per rafforzare la sicurezza informatica dei ministeri. L’amministratore delegato Arthur Mensch ha sostenuto in più occasioni che l’Europa è in grado di competere sui modelli di frontiera e ha messo in guardia dalla dipendenza da strumenti statunitensi per la sicurezza dei sistemi critici.
Il lancio cade in giorni affollati per i modelli aperti occidentali.
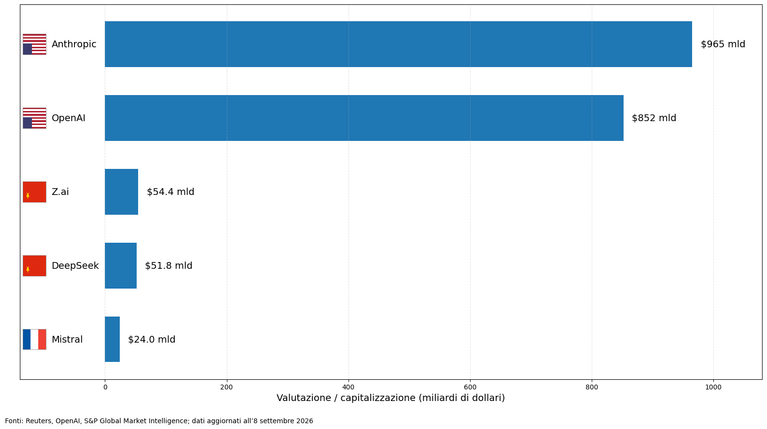
Reflection AI, sostenuta da Nvidia, ha presentato Beam da pochissimo, e la tedesca Aleph Alpha ha rilasciato Kolibri. Ma Large 4 gioca una partita diversa, il confronto decisivo è con i laboratori cinesi, che dall’inizio dell’anno padroneggiano le classifiche dei modelli aperti. Per le organizzazioni che per scelta o per obbligo escludono i modelli cinesi, Large 4 diventa l’opzione aperta più capace disponibile.
Mistral Large 4 riporta l’azienda francese in prima fila tra i produttori di modelli aperti. Le prime misurazioni confermano il primato tra le alternative occidentali open weight, con un prezzo per token competitivo quando si accede all’AI programmaticamente via API. Il divario dai modelli di frontiera made in USA è ancora molto ampio, sia per la qualitá del risultato sia per la velocitá con la quale lo si ottiene.
Per il giudizio definitivo bisogna attendere la pubblicazione dei pesi e i test di integrazione in flussi di lavoro reali, situazioni concrete che faranno emergere potenzialità e lacune della nuova frontiera europea dell’intelligenza artificiale.




Partecipa alla community