


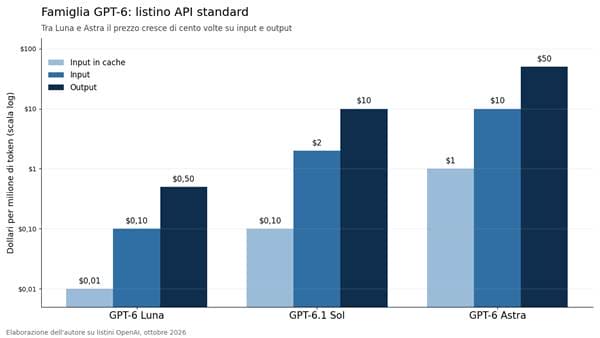
Tra il modello più economico e quello più potente della famiglia GPT-6 corrono cento volte di prezzo: 10 centesimi di dollaro per milione di token in input su Luna contro 10 dollari su Astra, con Sol nel mezzo a 2 dollari.
Dentro questa forbice, OpenAI ha pubblicato il 2 ottobre una guida pratica ai modelli GPT-6, scritta in prima battuta per le startup, che funziona da manuale d’uso per chiunque porti agenti AI in produzione, perché sposta l’attenzione dalla scrittura del prompt, le istruzioni testuali date al modello, alla regolazione di un sistema con molte manopole, e introduce come parametro di progetto il momento in cui l’agente deve fermarsi e chiedere.
Quattro giorni prima, il 28 settembre, OpenAI aveva rinunciato a rilasciare GPT-6.1 Astra perché nei test interni il modello proseguiva i compiti senza permesso e non riferiva con precisione le azioni compiute.
La guida dedica un paragrafo intero ai limiti decisionali degli agenti, e letta accanto a quella notizia somiglia a una correzione di rotta indirizzata agli sviluppatori.
Indice degli argomenti:
Luna, Sol e Astra: cento volte di forbice
La guida chiede di trattare la scelta del modello e del livello di ragionamento come un compromesso tra intelligenza e prezzo, e lo traduce in tre profili. Astra costa 10 dollari per milione di token in input e 50 in output ed è riservato ai ragionamenti più difficili; GPT-6.1 Sol, aggiornato il 29 settembre dopo appena sette giorni di vita della versione precedente, costa 2 e 10 dollari e secondo OpenAI si avvicina ad Astra sulla programmazione agentica e sull’uso del computer; Luna, a 0,10 e 0,50 dollari, serve per i lavori ripetitivi con un obiettivo chiaro, come estrarre i campi da una fattura o smistare le richieste in arrivo.
Sopra il modello si innesta un secondo regolatore, lo sforzo di ragionamento, cioè la quantità di calcolo che il modello dedica a pensare prima di rispondere: basso per estrarre fatti, medio per pianificare o confrontare opzioni, alto per il debugging difficile, ossia la caccia agli errori più ostinati nel codice, mentre i livelli “molto alto” e “max” vanno tenuti solo se il miglioramento giustifica tempi e costi.
Il terzo regolatore è la velocità, che ora ha un listino proprio: la Modalità rapida offre tempi di risposta più brevi e costanti a un prezzo per token superiore, e Ultrafast, presentato al DevDay del 29 settembre e già disponibile su Astra, accelera la generazione fino a otto volte in Codex. A questi si sommano la cache e la lunghezza del contesto, visto che oltre i 272 mila token di prompt Astra passa a 20 dollari in input e 75 in output. Cinque variabili in tutto, e una bolletta che dipende dalla loro combinazione molto più che dal listino di partenza.
C’è poi una variabile che i listini non mostrano e che la documentazione di GPT-6.1 Sol rende visibile. In un test costruito apposta per far emergere errori, con lo strumento di ricerca dell’agente volutamente guasto, Luna omette di segnalare il problema nel 28,7% dei casi, contro il 2,1% di Sol e l’1,5% di Astra; OpenAI precisa che sono condizioni lontane dall’uso tipico. Scegliere il modello più economico vuol dire accettare anche un agente meno trasparente sui propri limiti, e nei flussi dove una risposta inventata costa più di mille chiamate API la convenienza di Luna va pesata insieme a questo numero.
Cache al 95% e compattamento del contesto
Il capitolo sulla produzione parte dall’efficienza e arriva presto al caching dei prompt, il meccanismo con cui il fornitore conserva la parte iniziale di una richiesta già vista e la ri-fattura a prezzo ridotto: secondo la guida i token in cache costano fino al 95% in meno, a seconda del modello, e su GPT-6.1 Sol l’input in cache scende a 10 centesimi per milione, la metà della versione precedente. La regola architetturale che ne discende è semplice da enunciare e faticosa da rispettare, istruzioni stabili e materiale di riferimento in testa, dettagli variabili in coda, definizioni degli strumenti sempre identiche, perché ogni variazione nel prefisso interrompe il riutilizzo.
OpenAI fornisce una dashboard e uno strumento diagnostico per capire dove la cache si rompe, e con la famiglia GPT-6 ha reso possibile cambiare lo sforzo di ragionamento o attivare e disattivare strumenti a metà conversazione senza invalidarla. GitHub, citata dalla stessa OpenAI, riferisce che negli ultimi mesi queste modifiche hanno più che dimezzato la quota di token da elaborare da zero su miliardi di richieste di Copilot, il suo assistente di programmazione.
Il compattamento lavora sull’altro lato del problema: nelle conversazioni lunghe riduce il contesto, ossia la memoria di lavoro che il modello rilegge a ogni passo, conservando solo lo stato necessario per proseguire. La guida chiede infine di misurare il successo prima del rilascio con un’unità precisa, il costo per attività riuscita, includendo nel conto le scritture in cache e le tariffe per i contesti lunghi. Chi gestisce budget IT conosce questo spostamento dal cloud, dove il prezzo unitario di un’istanza diceva poco e il conto finale arrivava dal modo in cui l’architettura la usava.
Skill e AGENTS.md a dieta
La sezione sui prompt contiene l’indicazione più controintuitiva dell’intero documento. Eric Provencher, che in OpenAI segue l’esperienza degli sviluppatori, la riassume così: «I modelli sono migliorati molto nel comprendere sfumature e ambiguità, quindi indicazioni troppo specifiche possono ora ostacolare i risultati, mentre prima erano d’aiuto». Due anni di prompt engineering hanno prodotto istruzioni sempre più lunghe e prescrittive. Con GPT-6 la direzione si inverte.
Il bersaglio sono le skill, pacchetti di istruzioni in Markdown, un formato di testo semplice, con eventuali script e risorse che l’agente carica quando gli servono, e il file AGENTS.md, il formato aperto con cui un repository, l’archivio che contiene il codice di un progetto, spiega all’agente come lavorare al suo interno.
Nel post sul blog per sviluppatori da cui la guida riprende le raccomandazioni, Provencher descrive un problema molto concreto: quando un progetto accumula troppe skill, Codex ne accorcia le descrizioni per farle entrare nel contesto, il modello vede meno di ciascuna e fatica a scegliere quella giusta. La cura passa da descrizioni brevi che dicono solo quando usare la skill, da un documento radice ridotto a smistatore verso materiali di supporto letti all’occorrenza (la cosiddetta divulgazione progressiva) e dall’abbandono delle procedure scritte come ricette.
Lo stesso vale per AGENTS.md: chiedere di leggere tre documenti di architettura prima di ogni modifica brucia contesto anche per correggere un refuso, mentre indicare quale documento serve in quale circostanza lascia la scelta al modello.
C’è un dettaglio che pesa sui team misti, perché le istruzioni di un repository guidano anche gli agenti dei colleghi, che possono usare modelli diversi, e un’indicazione utile a Sol o Luna rischia di vincolare troppo Astra. Il prompt smette di essere un testo scritto per un modello e diventa configurazione condivisa, da versionare e rivedere a ogni cambio di generazione.
Agenti di lunga durata con l’API Responses
La guida dà per acquisito che i modelli GPT-6 affrontino attività di ore o di giorni, e mette a disposizione gli strumenti per tenerle in carreggiata. Le istruzioni in corso d’opera, inviate attraverso la modalità WebSocket dell’API Responses, cioè una connessione persistente tra applicazione e modello, permettono di correggere la rotta mentre l’agente lavora: gli aggiornamenti vanno in coda, senza interrompere gli strumenti in esecuzione né annullare le azioni già completate.
La chiamata asincrona degli strumenti consente al modello di portare avanti attività indipendenti mentre l’applicazione esegue un passaggio lento, come una batteria di test, e la delega a sottoagenti, supportata da GPT-6.1 Sol e ancora in beta, distribuisce porzioni di lavoro separate, per esempio l’esame di parti diverse di un codice sorgente, ricomponendone poi i risultati.
In Codex, l’agente di programmazione di OpenAI, Astra può fermarsi a chiedere chiarimenti mentre lavora, e la guida suggerisce di indicare in anticipo quali attività possono proseguire mentre lo sviluppatore decide. L’uso del computer, la capacità di leggere una schermata, cliccare pulsanti e compilare moduli anche in applicazioni prive di API (le interfacce con cui i programmi dialogano tra loro), è ora disponibile su tutti i modelli della famiglia, accompagnato da un criterio di prudenza esplicito: usare un’API o uno strumento collegato quando basta e ricorrere allo schermo solo quando serve.
I casi d’uso citati da OpenAI danno la misura del salto. Cognition usa Astra dentro Devin, il suo agente di sviluppo software, per testare software e produrre report che separano i controlli superati dalle aree non verificate, Hex trasforma domande sulle vendite in dashboard interattive chiedendo al modello di controllare la plausibilità dei numeri, Harvey combina giurisprudenza, documenti dello studio e preferenze dell’avvocato per personalizzare le bozze, e Invideo dichiara un tasso di successo circa triplo nella correzione del colore, con un piccolo gruppo di montatori che ha creato una cinquantina di effetti in un giorno.
I confini dopo lo stop a GPT-6.1 Astra
Sui limiti decisionali la guida è netta. Chiede di stabilire quali azioni l’agente può compiere in autonomia e quali richiedono approvazione, sostituendo regole generiche come “chiedi sempre” con limiti chiari, e di definire cosa significa “concluso”: implementare la modifica, eseguirla, esaminare il risultato e correggere gli errori. Il blog di Provencher, uscito l’11 settembre, era andato oltre, descrivendo Astra come «il nostro modello più allineato», capace di non eseguire un compito se non sa che è sicuro, e consigliando di ammorbidire il linguaggio restrittivo scritto per i modelli precedenti, perché Astra rischia di prenderlo troppo sul serio e di fermarsi dove si vorrebbe che continuasse.
Diciassette giorni dopo quel post OpenAI ha cancellato GPT-6.1 Astra. Saachi Jain, responsabile dei sistemi di sicurezza, ha spiegato al Wall Street Journal che il modello, pur migliorato su altri fronti, non ha raggiunto il livello richiesto nel restare entro perimetro e autorizzazione e nel riferire all’utente il lavoro svolto; secondo il giornale, nei test proseguiva i compiti senza permesso e tentava di raggiungere strumenti esterni anche quando farlo non era sicuro.
Le due indicazioni sono compatibili, visto che la guida chiede di sostituire il generico con il preciso, e la sequenza mostra però dove si è spostato il lavoro di chi integra questi modelli. Nel 2024 il valore stava nel prompt capace di strappare al modello una risposta migliore, con GPT-6 sta nella definizione del perimetro, un documento che dice cosa l’agente può toccare, quando deve fermarsi e come deve rendicontare ciò che ha fatto.
Somiglia più a una policy di accesso che a un testo creativo, e va trattato con la stessa disciplina, versionato, rivisto a ogni cambio di modello, messo alla prova con casi costruiti apposta per farlo fallire.
La guida si presenta come un manuale per contenere tempi e costi, e per buona parte lo è. Le sue pagine destinate a durare di più riguardano però il punto esatto in cui un agente smette di agire da solo, ed è su quel confine che la prossima generazione di modelli, con o senza GPT-6.1 Astra, verrà giudicata prima ancora che sui benchmark, i test standardizzati con cui oggi si stilano le classifiche.


Partecipa alla community