


OpenAI porterà un watermark invisibile nei testi prodotti da ChatGPT e Codex nell’Unione europea. La società lo ha annunciato il 5 ottobre 2026, poco più di due mesi dopo l’applicazione delle nuove regole sulla trasparenza previste dall’Ai Act. La tecnologia si chiama textGrain e modifica in modo impercettibile la distribuzione statistica delle parole scelte dal modello, lasciando un segnale che un apposito rilevatore può cercare nel testo.
L’intervento riguarda gli utenti europei idonei di ChatGPT e Codex e sarà introdotto nelle prossime settimane. Per i clienti delle Api, invece, OpenAI ha aperto in tutto il mondo la possibilità di attivare volontariamente il watermark su alcuni modelli: l’opzione rimane disabilitata per impostazione predefinita. L’accesso al detector sarà inizialmente riservato a ricercatori e organizzazioni specializzate autorizzate dall’azienda.
La scelta mostra anche quanto sia ancora incompleta la tecnologia per identificare l’origine dei testi sintetici. I test pubblicati da OpenAI indicano che modifiche relativamente limitate possono rendere molto più difficile riconoscere il watermark. Ne deriva un problema economico e regolatorio: le imprese devono rispettare obblighi di trasparenza europei attraverso strumenti che, per ammissione degli stessi fornitori, non permettono ancora una verifica infallibile.
Indice degli argomenti:
L’AI Act impone una marcatura leggibile dalle macchine
Il riferimento normativo è l’articolo 50 dell’AI Act. Il regolamento stabilisce che i fornitori di sistemi capaci di generare contenuti sintetici audio, immagini, video o testi devono fare in modo che gli output siano marcati in un formato leggibile dalle macchine e riconoscibili come prodotti o manipolati artificialmente. Le soluzioni devono essere efficaci, interoperabili, robuste e affidabili nella misura tecnicamente possibile, tenendo conto dello stato dell’arte, dei costi e delle caratteristiche del contenuto. Gli obblighi sono applicabili dal 2 agosto 2026.
Il 10 giugno 2026 la Commissione europea ha pubblicato anche il Codice di pratica sulla trasparenza dei contenuti generati dall’AI. L’adesione è volontaria, mentre gli obblighi dell’articolo 50 sono vincolanti. L’8 luglio la Commissione ha valutato il Codice come uno strumento adeguato per facilitare l’applicazione delle regole, valutazione successivamente condivisa dall’Ai Board.
A fine luglio circa 190 organizzazioni avevano aderito al Codice. Tra i firmatari della sezione dedicata ai fornitori figurano OpenAI, Google, Microsoft, Meta, Anthropic, Mistral e Cohere. La Commissione presenta l’adesione come un percorso che può ridurre l’onere amministrativo e offrire maggiore prevedibilità nell’applicazione delle regole nei diversi Stati membri, senza trasformare la firma in una prova definitiva di conformità.
Come funziona textGrain
textGrain non aggiunge scritte visibili, caratteri nascosti o spazi invisibili al testo. Interviene durante la generazione, modificando leggermente le probabilità che portano il modello a scegliere una parola o un token invece di un altro. Su una sequenza sufficientemente lunga, queste scelte formano uno schema statistico che il detector di OpenAI può cercare.
È un principio simile a quello utilizzato da altre tecnologie di watermarking linguistico. Google DeepMind, per esempio, ha sviluppato SynthID anche per i testi generati dall’Ai: il sistema modifica le probabilità assegnate ai token senza inserire un segno percepibile dal lettore. Google ha inoltre reso open source la componente di watermarking testuale di SynthID e dal 2025 sperimenta un sistema di verifica dedicato ai contenuti generati dai propri modelli.
OpenAI sostiene che, nelle proprie valutazioni, textGrain abbia eguagliato o superato le prestazioni degli altri metodi testati, compreso SynthID per il testo. L’azienda prevede inoltre di rendere disponibile la tecnologia in open source.
I risultati diffusi il 5 ottobre, tuttavia, mostrano quanto la rilevabilità dipenda dalla lunghezza, dal tipo di testo e dalle modifiche effettuate dopo la generazione.
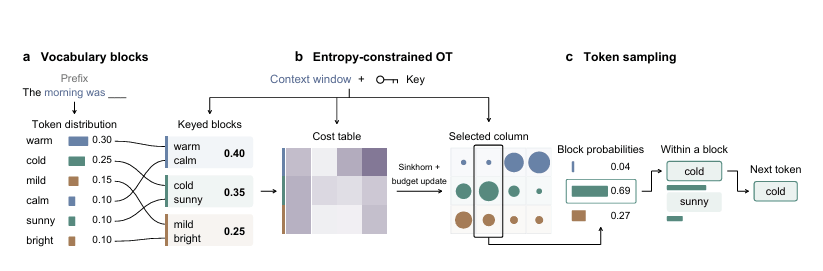
Le aree cerchiate mostrano le probabilità di accoppiamento. c, La finestra chiave e quella di contesto selezionano una colonna. Le sue voci normalizzate determinano le probabilità del blocco; un token viene quindi campionato all’interno di questo blocco selezionato utilizzando le probabilità relative originali. I token blu illustrano una finestra di contesto di due token, mentre il modello utilizza il prefisso completo. Le probabilità visualizzate sono arrotondate.
Testi brevi ed editing fanno crollare il rilevamento
Nei test di OpenAI, fissando all’1% il tasso obiettivo di falsi positivi, il detector riconosce il watermark in circa l’80% dei testi di psicologia lunghi 200 token. Portando la lunghezza a 400 token, la percentuale sale a circa il 95%.
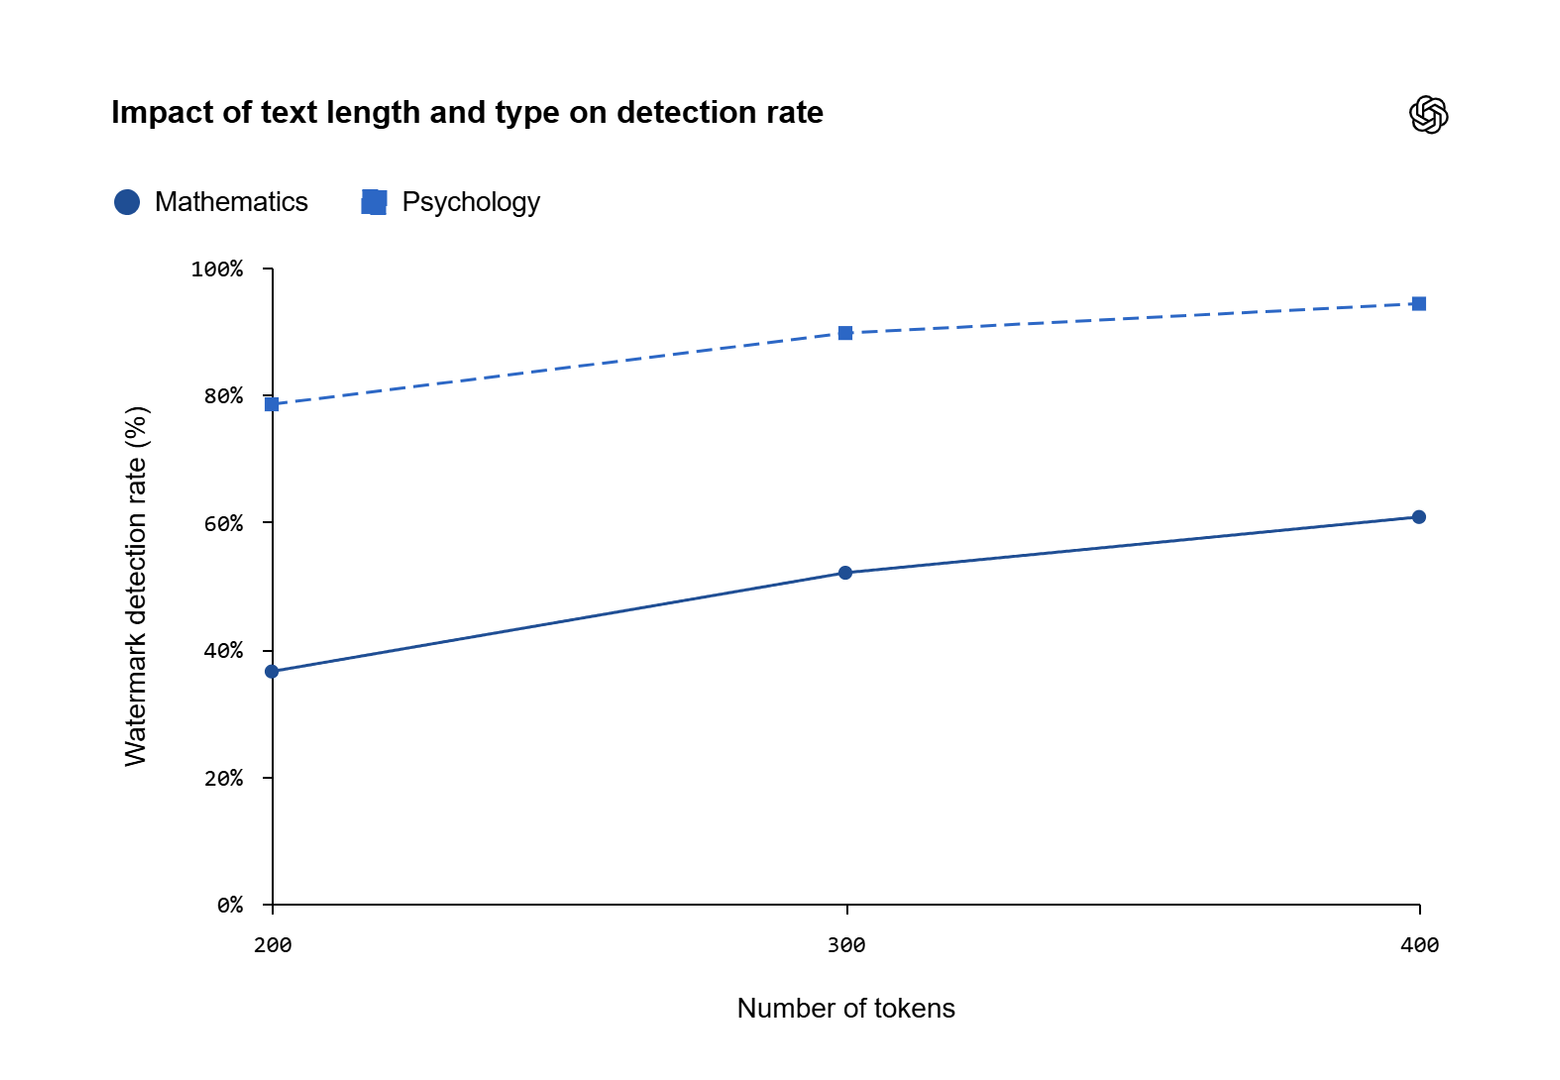
Il risultato cambia quando il modello ha meno libertà nella scelta delle parole. Nei contenuti matematici, caratterizzati da formulazioni più vincolate, la capacità di rilevamento risulta sensibilmente inferiore. Il meccanismo ha infatti bisogno di una quantità sufficiente di alternative linguistiche per incorporare il proprio schema statistico.
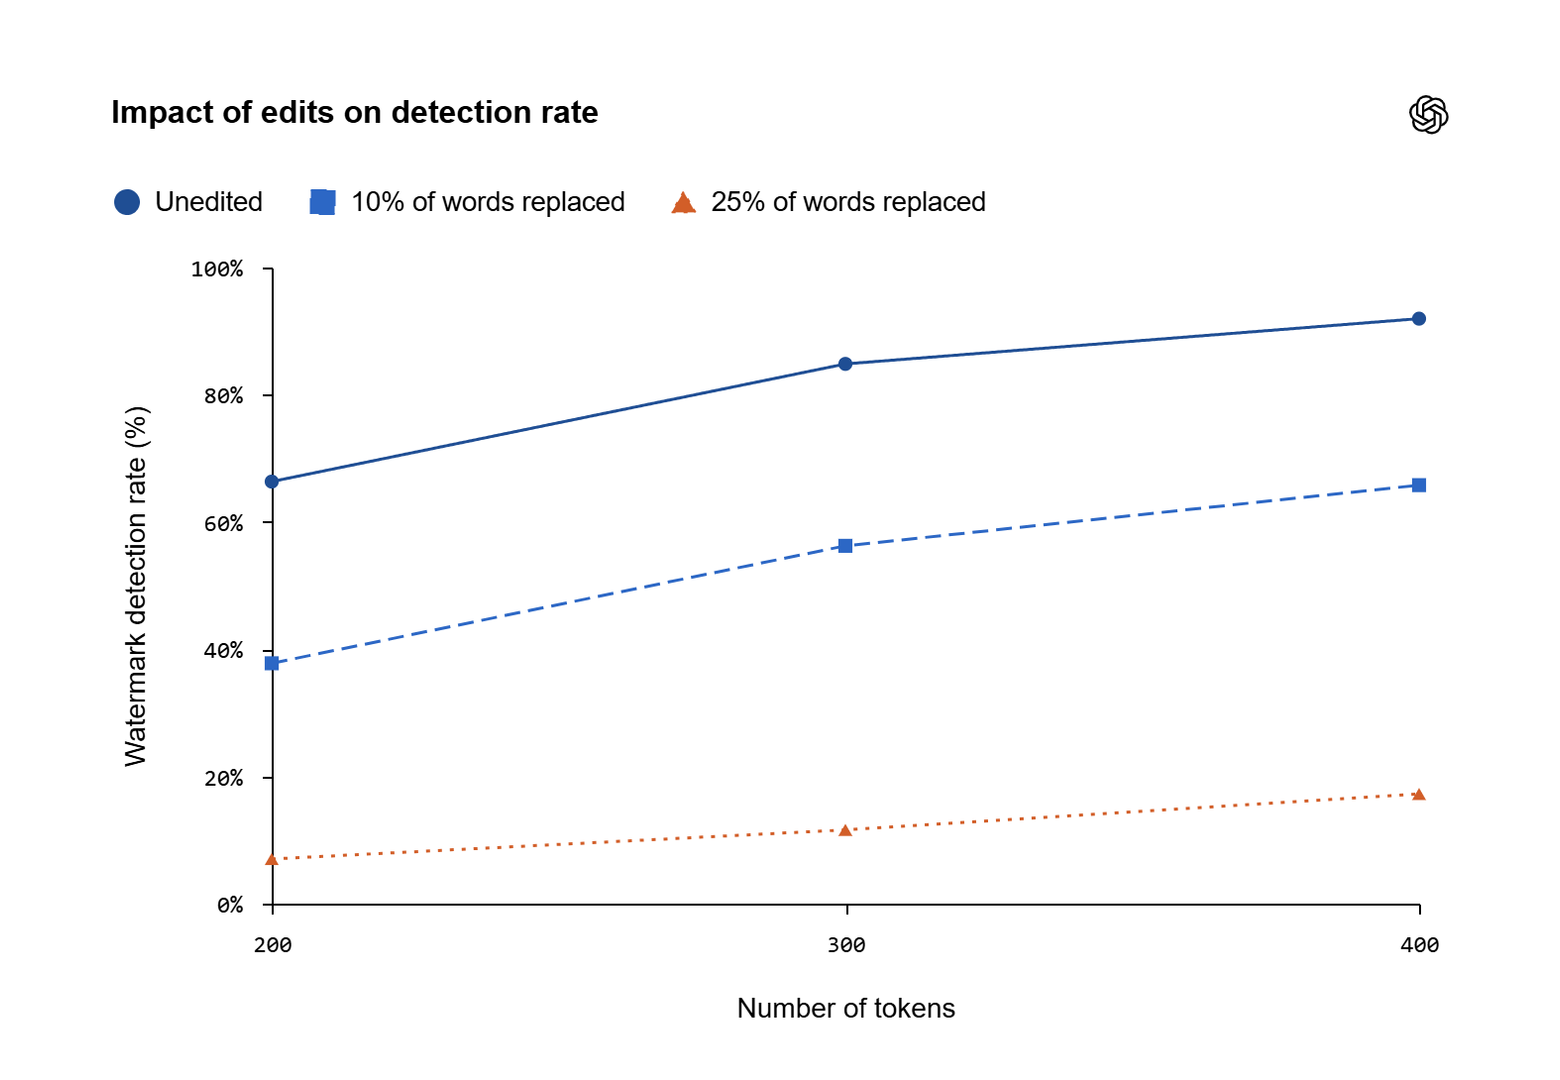
Il problema maggiore arriva con l’editing. In una prova su testi di 400 token, OpenAI ha sostituito il 10% delle parole con sinonimi: il tasso di rilevamento è sceso da circa il 92% al 66%. Sostituendo un quarto delle parole, il detector ha riconosciuto il watermark soltanto nel 17% dei casi.
Parafrasi, riscritture e traduzioni diventano quindi variabili decisive. Un documento può nascere da un modello OpenAI e successivamente perdere una parte sufficiente del segnale da non essere più identificato. Per la stessa ragione, un risultato negativo del detector non dimostra che il testo sia stato scritto da una persona.
Il watermark non sembra ridurre la qualità dei modelli
Uno dei problemi commerciali del watermarking è il possibile impatto sulle prestazioni. Condizionare la scelta dei token potrebbe, almeno in teoria, limitare la capacità del modello di produrre la risposta considerata migliore.
OpenAI afferma di non avere osservato differenze significative sui benchmark utilizzati per valutare Astra, indicato dalla società come il proprio modello frontier più recente nel documento pubblicato il 5 ottobre.
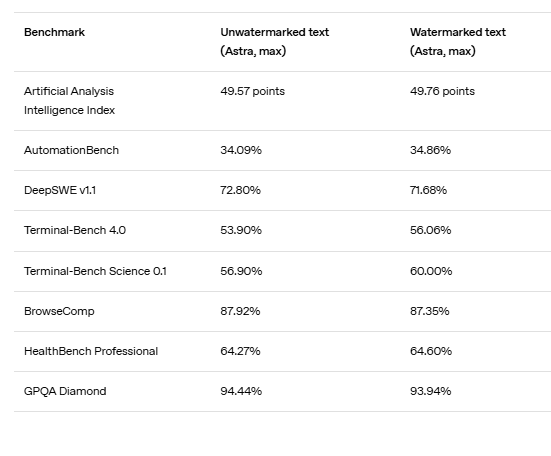
Sull’Artificial Analysis Intelligence Index il risultato passa da 49,57 punti senza watermark a 49,76 con watermark.
Su DeepSWE v1.1 scende dal 72,80% al 71,68%, mentre su Terminal-Bench Science 0.1 sale dal 56,90% al 60%.
BrowseComp passa dall’87,92% all’87,35%. Sono dati prodotti da OpenAI e riguardano i benchmark scelti dall’azienda.
Non dimostrano che il watermark sia privo di effetti in qualunque applicazione, lingua o modello. Indicano però che, nelle prove pubblicate, il costo prestazionale dell’introduzione di textGrain non appare sistematicamente negativo.
Per i fornitori di AI è un aspetto economico rilevante. Se gli obblighi europei potessero essere rispettati soltanto accettando un deterioramento delle risposte, la regolamentazione produrrebbe un costo diretto sulla qualità dei servizi. I primi risultati di OpenAI indicano invece che il problema principale è la robustezza del rilevamento dopo la generazione.
Un watermark non dimostra chi ha scritto il testo
OpenAI insiste sui limiti di ciò che può essere dedotto dal risultato del detector. Il watermark segnala che un sistema dell’azienda ha generato o elaborato almeno una parte del testo, ma non misura il contributo umano. Non consente quindi di stabilire se un documento sia stato scritto interamente dall’AI, revisionato da un professionista oppure prodotto attraverso decine di interventi successivi.
Non stabilisce neppure proprietà intellettuale o responsabilità giuridica. Un rilevamento positivo non dice chi possiede il contenuto, se il suo utilizzo sia legittimo o quale persona debba risponderne. Il segnale non contiene l’identità dell’utente e non collega il testo a un account, a un prompt o a una conversazione.
Il detector non è neppure uno strumento di fact-checking. Un testo può avere un watermark ed essere corretto oppure falso. Può non averlo ed essere comunque prodotto da un sistema generativo, perché è stato modificato, tradotto, creato prima dell’introduzione della tecnologia o generato con uno strumento di un altro fornitore.
Questa distinzione è essenziale per editori, imprese e amministrazioni che intendano utilizzare i segnali di provenienza nei propri processi: identificare una possibile origine tecnica non equivale a valutare attendibilità, attribuzione o responsabilità.
Per editori e imprese la regola europea è più articolata
L’AI Act distingue anche il ruolo dei fornitori da quello di chi utilizza professionalmente i sistemi. Il Codice europeo dedica una sezione ai provider che devono implementare marcatura e rilevamento e una seconda ai deployer, cioè ai soggetti che impiegano i sistemi generativi nelle proprie attività.
Per le pubblicazioni testuali destinate a informare il pubblico su questioni di interesse pubblico intervengono specifici obblighi di disclosure. La Commissione precisa però che l’obbligo non opera nello stesso modo quando il contenuto ha attraversato un processo di revisione umana ed è sottoposto a responsabilità editoriale.
Per il settore dell’informazione questo passaggio separa due problemi differenti: la marcatura tecnica inserita dal fornitore del modello e la responsabilità del soggetto che decide di pubblicare. Un watermark può accompagnare il testo lungo la catena produttiva, ma non sostituisce il controllo redazionale.
Per le aziende che integrano i modelli attraverso Api, OpenAI ha scelto per ora un modello volontario. I clienti di tutto il mondo possono attivare textGrain su alcuni modelli e decidere come inserirlo nei propri processi di conformità. La società sta lavorando anche con i partner cloud per estendere la funzione agli output dei modelli distribuiti attraverso le loro infrastrutture.
Immagini e audio hanno già strumenti di provenienza
Il testo rappresenta la parte più difficile di una strategia che OpenAI ha già esteso alle altre tipologie di contenuto. Per le immagini supportate l’azienda usa i Content Credentials basati sullo standard C2PA e watermark SynthID. Per l’audio utilizza watermark SynthID non udibili. La verifica di immagini e file audio è disponibile attraverso uno strumento pubblico e attraverso una Content Provenance Api.
I due meccanismi rispondono a problemi differenti. I Content Credentials possono registrare informazioni sull’origine e sulla storia di un file attraverso metadati firmati. Un watermark incorporato nel contenuto può invece conservare un segnale anche quando alcuni metadati vengono eliminati.
Anche lo standard C2PA continua a evolversi. La versione 2.4, pubblicata nell’aprile 2026, ha introdotto tra l’altro una specifica AI Disclosure Assertion, pensata per rappresentare informazioni di trasparenza sull’uso dell’intelligenza artificiale in formato leggibile dalle macchine.
La direzione industriale è quindi quella di combinare più livelli di provenienza, anziché affidarsi a un unico detector.
La prova più difficile sarà l’uso quotidiano
Il lancio europeo di textGrain trasferisce il watermarking del testo dai test controllati all’impiego su larga scala. L’Unione europea diventa il primo mercato in cui OpenAI applicherà questa tecnologia come impostazione ordinaria agli output idonei di ChatGPT e Codex, mentre nel resto del mondo l’azienda mantiene per ora un approccio volontario attraverso le Api.
La questione economica riguarda l’interoperabilità. Un ecosistema nel quale ogni grande fornitore usa un proprio watermark e un detector separato rischia di aumentare i costi di verifica per piattaforme, editori, imprese e amministrazioni. L’AI Act chiede per questo soluzioni interoperabili e robuste, mentre il Codice europeo punta a trasformare requisiti generali in pratiche condivise.
I numeri diffusi da OpenAI mostrano allo stesso tempo il limite tecnico da affrontare. Una sostituzione del 25% delle parole può portare il rilevamento dal 92% al 17%. Un segnale tanto sensibile alla riscrittura può essere utile per documentare l’origine di un testo rimasto relativamente intatto, ma è molto meno affidabile quando quel testo passa attraverso traduzioni, editing umano e successive elaborazioni automatiche.
Il successo del sistema dipenderà quindi dalla capacità di rendere questi segnali più resistenti e interoperabili senza degradare la qualità dei modelli. Per le imprese europee, il watermark non chiude il problema della trasparenza: diventa una nuova componente tecnica della conformità all’AI Act, da integrare con procedure editoriali, responsabilità organizzative e controlli sull’uso dei contenuti generativi.


Partecipa alla community