


Un’impresa può scegliere un modello AI aperto per tenere i propri dati sotto controllo. Una scelta che però deve affrontare una domanda: sta usando un modello meno sicuro di uno chiuso?
L’azienda in questione non è da sola con questo dubbio, che in effetti in questo momento divide l’industria. In un campo c’è Nvidia secondo cui i modelli open sono essenziali; in un altro Anthropic, secondo cui sono invece più pericolosi. Entrambi hanno interessi economici per sostenere la propria tesi.
Vediamo qualche elemento di base per capirci di più.
Il modello open è a pesi aperti, conoscibili, e può essere riaddestrato. Da questo fatto deriva spesso una critica: chi può modificarne i pesi dispone di possibilità di manomissione aggiuntive, che il normale cliente di un servizio chiuso non ha. Questa però è al limite una prova che il modello aperto può essere facilmente usato a fin di male. Non dimostra però che ogni modello aperto sia più rischioso, per chi lo usa, di ogni modello proprietario.
Al tempo stesso, la ricerca sta cercando di ridurre proprio questa distanza: rendere le protezioni più resistenti anche quando il modello esce dal controllo del produttore.
Indice degli argomenti:
Modelli open e chiusi: chi controlla davvero il sistema
Per capire che cosa si può proteggere bisogna prima chiarire che cosa viene aperto. Un modello open-weight permette di scaricare i pesi e, secondo le condizioni della licenza, eseguirli e modificarli. Non significa necessariamente avere accesso ai dati e all’intero procedimento con cui è stato addestrato. La Open Source AI Definition 1.0 dell’Open Source Initiative richiede anche codice e informazioni sui dati sufficienti a studiare e modificare il sistema. Usare “open source” come sinonimo di “pesi scaricabili” nasconde quindi differenze importanti.
Nel servizio chiuso, invece, l’utente interroga un modello attraverso un’applicazione o un’interfaccia software, senza poter intervenire direttamente sui suoi parametri. Il fornitore può controllare l’accesso, aggiornare i filtri e sospendere account. La pubblicazione dei pesi modifica questo rapporto: una copia già scaricata non può essere richiamata a distanza dal produttore. Un aggiornamento più sicuro può essere distribuito, ma non obbliga chi possiede una vecchia copia a sostituirla.
Per l’impresa, quella stessa autonomia può essere un vantaggio. Eseguire il modello in un ambiente proprio consente di progettare un trattamento dei dati che non richieda l’invio dei contenuti a un servizio esterno. Occorre però controllare anche applicazioni, registri, connessioni e fornitori coinvolti: scaricare i pesi non rende privata l’intera applicazione. La distinzione utile è tra ciò che l’azienda può governare direttamente e ciò che affida a un terzo.
Il caso GLM-5.3: capacità offensive e protezioni sono due misure diverse
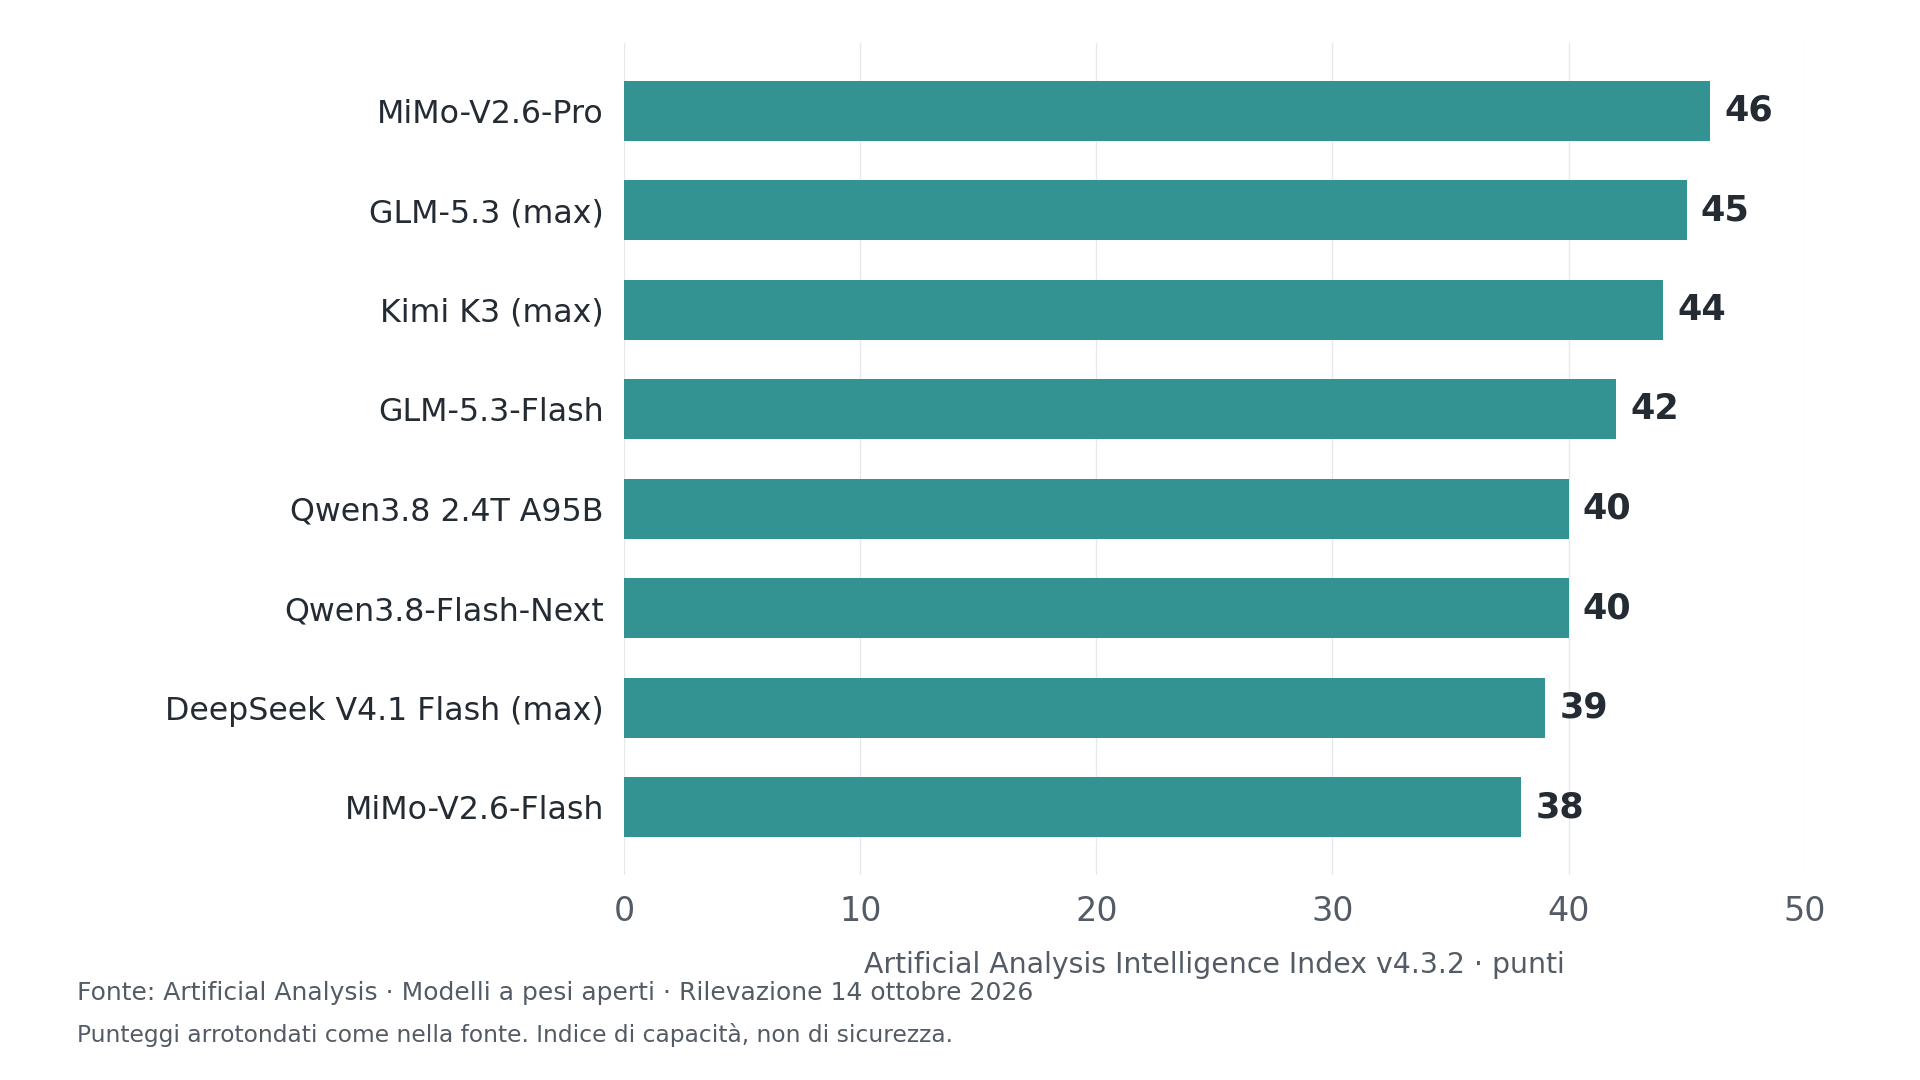
Questa differenza di controllo è diventata più rilevante con modelli capaci di svolgere compiti informatici complessi. Nella valutazione pubblicata il 17 settembre 2026, il centro Caisi del Nist descrive GLM-5.3 di Z.ai come il modello a pesi aperti con le maggiori capacità cyber tra quelli valutati e rilasciati fino a quella data. Nell’indice aggregato del centro resta circa quattro mesi dietro la frontiera statunitense. È una misura delle capacità, non della probabilità di un attacco reale: il confronto comprende modelli ad accesso riservato e, dove applicabile, sistemi statunitensi provati con le protezioni cyber disattivate.
La domanda successiva è quanto facilmente quelle capacità possano essere impiegate contro le regole. Nel rapporto del 29 settembre, Anthropic ha sottoposto GLM-5.3 a ordini malevoli in un ambiente simulato: 50 prove per condizione. Il modello non avvia azioni con la richiesta diretta; lo fa nel 64% dei casi con un pretesto ingannevole, nel 92% con ragionamento precompilato e nel 100% dopo una modifica dei pesi. Il grafico misura l’avvio di azioni simulate, non la riuscita di intrusioni: il codice generato non veniva eseguito su sistemi reali.
Nei test applicabili, i Claude protetti non hanno eseguito le richieste dannose; le modifiche ai pesi non sono disponibili attraverso il loro servizio. È un risultato rilevante, da leggere come valutazione di un concorrente in condizioni definite, senza trasformarlo in una classifica universale della sicurezza. Il confronto documenta anche una differenza di accesso, oltre al comportamento dei modelli.
Che la chiusura non elimini gli abusi emerge dalla stessa Anthropic. Il suo rapporto sulle minacce di settembre 2026 descrive operazioni malevole assistite da Claude e gli interventi adottati per interromperle. La possibilità di reagire è un vantaggio del servizio controllato, ma la reazione può arrivare dopo che un abuso è iniziato. D’altra parte, la capacità di individuare vulnerabilità può servire anche ai difensori: limitarne l’accesso comporta una scelta su quali organizzazioni possano utilizzarla.
Perché le protezioni di un modello aperto possono cedere
Il caso cyber rende visibile un problema più generale. Un modello può imparare a rifiutare una richiesta senza perdere le conoscenze necessarie a soddisfarla. Imparare a dire di no non equivale a dimenticare. Se un successivo addestramento cambia quel comportamento, capacità prima bloccate possono tornare accessibili. È una difficoltà diversa dal convincere un chatbot con una formulazione ingannevole: qui si interviene sul modello stesso.
La ricerca raccolta in Open Technical Problems in Open-Weight AI Model Risk Management, di Stephen Casper e coautori, individua sedici problemi aperti, dai dati alle valutazioni e al monitoraggio dell’ecosistema. Il suo punto di partenza è che la difesa deve reggere anche fuori dal servizio del produttore. Filtri e registri rimangono utili per chi gestisce correttamente un’installazione, ma un utilizzatore ostile che controlla tutto il sistema può rimuoverli.
Per questo le sperimentazioni si concentrano anche su difese incorporate nei pesi. Le strategie agiscono in momenti diversi: prima che il modello acquisisca certe conoscenze, dopo che le ha apprese oppure durante l’addestramento delle protezioni. Ogni momento offre possibilità e limiti differenti, e nessuno dei risultati disponibili autorizza a considerare risolto il problema.
La ricerca per rendere più sicuri i modelli open
Deep Ignorance: evitare che alcune capacità vengano apprese
La strada più anticipata consiste nel selezionare i dati di partenza. Il progetto Deep Ignorance, di ricercatori di EleutherAI, dell’AI Security Institute britannico e dell’Università di Oxford, presentato nel 2025 e accettato a Iclr 2026, ha addestrato modelli da 6,9 miliardi di parametri filtrando contenuti biologici a duplice uso. L’obiettivo è ridurre l’acquisizione delle conoscenze rischiose, anziché affidarsi soltanto al rifiuto di comunicarle.
Nei test, i modelli filtrati hanno mantenuto le capacità generali misurate e mostrato una resistenza al successivo addestramento avversario, spinto fino a 300 milioni di token e 10.000 passi. Sono però prove su conoscenze usate come indicatore del rischio biologico, non una certificazione di innocuità. Le informazioni possono arrivare anche durante l’uso: se vengono fornite nel contesto, il filtro iniziale non basta. Gli autori riconoscono che gli attacchi combinati di riaddestramento e recupero di informazioni superano le difese esaminate. Il risultato va quindi verificato su altre scale e altri domini.
Unlearning: ridurre conoscenze già presenti
Quando il modello è già stato addestrato, filtrare i dati originari non modifica automaticamente i pesi esistenti. Da qui l’interesse per il machine unlearning: tecniche che cercano di ridurre o rimuovere specifiche conoscenze apprese, preservando il resto delle capacità. Il lavoro The WMDP Benchmark: Measuring and Reducing Malicious Use With Unlearning, del 2024, propone una valutazione delle conoscenze pericolose e un metodo per ridurle.
La difficoltà è stabilire quanto sia profondo il cambiamento. Se un modello sbaglia un questionario su un argomento, si è osservato un calo della prestazione in quel test; non si è ancora dimostrato che ogni via di accesso alla conoscenza sia scomparsa. Occorre verificare che cosa succede cambiando le domande, fornendo informazioni aggiuntive o modificando ancora il modello. È il motivo per cui la valutazione dell’unlearning deve includere tentativi di recupero delle capacità.
Circuit breakers: intervenire sulle rappresentazioni interne
Una seconda famiglia di interventi sul modello già addestrato punta al percorso che produce la risposta. Il lavoro Improving Alignment and Robustness with Circuit Breakers, di Andy Zou e coautori, pubblicato nel 2024, introduce un addestramento che modifica le rappresentazioni interne associate a comportamenti dannosi. Il nome richiama gli interruttori di sicurezza: deviare la generazione prima dell’output pericoloso, anziché filtrare soltanto la domanda o la risposta finale.
Questo approccio amplia gli strumenti disponibili, ma la prova contro una famiglia di attacchi non vale per tutte. Nel successivo Revisiting the Robust Alignment of Circuit Breakers, ricercatori hanno contestato la robustezza rispetto ad attacchi sulle rappresentazioni numeriche in ingresso. Il tipo di accesso concesso all’attaccante conta: una difesa efficace quando si possono inviare soltanto messaggi può risultare insufficiente quando si interviene all’interno del sistema.
Protezioni resistenti al riaddestramento: il metodo TAR
Per affrontare direttamente la modifica dei pesi, il lavoro Tamper-Resistant Safeguards for Open-Weight LLMs, di Rishub Tamirisa e coautori, presentato a Iclr 2025, propone il metodo TAR. Durante la costruzione della difesa vengono simulati tentativi di riaddestramento ostile; il modello viene poi ottimizzato perché le protezioni sopravvivano. Si cerca così di allenare la resistenza alle modifiche future, oltre al comportamento corretto nelle richieste immediate.
Gli autori riportano miglioramenti della resistenza mantenendo capacità utili. Il risultato apre una direzione di ricerca, ma dipende dalle modifiche provate e dalle risorse assegnate all’avversario. Una difesa testata contro un certo insieme di tentativi non offre una garanzia per un attaccante che cambi strategia o aumenti il budget. La resistenza è una proprietà da misurare sotto condizioni esplicite, non un attributo assoluto del modello.
TamperBench: mettere le promesse alla prova
Per confrontare queste promesse servono test riproducibili e sufficientemente severi. TamperBench, di Saad Hossain e coautori, nella versione aggiornata il 2 giugno 2026 valuta 21 modelli a pesi aperti, comprese varianti con difese aggiuntive, attraverso nove minacce di manomissione. Varia sistematicamente le impostazioni degli attacchi e misura sia sicurezza sia capacità: un modello reso inutilizzabile non costituisce una difesa riuscita.
La conclusione della versione aggiornata è severa: le difese della fase di allineamento esaminate cedono largamente a questa ricerca sistematica di attacchi efficaci. Non significa che ogni possibile protezione sia inutile. Significa che i risultati favorevoli devono sopravvivere a verifiche indipendenti, con avversari che non si limitino alle configurazioni scelte dagli autori della difesa. La tabella distingue le diverse promesse, senza assegnare punteggi di sicurezza non confrontabili.
Le strade della ricerca e i limiti da verificare
| Intervento | Progetto | Obiettivo | Limite |
|---|---|---|---|
| Filtro dei dati | Deep Ignorance | Riduce l’apprendimento di conoscenze selezionate | Non blocca ogni uso di informazioni fornite nel contesto |
| Unlearning | WMDP | Riduce conoscenze già apprese | Il calo in un test non prova la rimozione irreversibile |
| Rappresentazioni interne | Circuit breakers | Devia generazioni associate a comportamenti dannosi | Robustezza dipendente dal tipo di attacco |
| Resistenza alle modifiche | TAR | Allena le difese contro il riaddestramento ostile | Risultati vincolati ad attacchi e risorse provati |
| Valutazione sistematica | TamperBench | Confronta sicurezza e utilità dopo manomissioni | È un banco di prova, non una protezione |
Fonti: Deep Ignorance (2025–2026); WMDP (2024); Circuit breakers (2024); TAR (Iclr 2025); TamperBench (versione giugno 2026). Sintesi qualitativa, non classifica di efficacia.
Che cosa cambia per chi deve adottare l’AI in azienda
Questi risultati spostano la decisione aziendale su una domanda verificabile: quali parti del sistema controlliamo, e contro quali errori o abusi dobbiamo proteggerle? Un modello aperto gestito dall’impresa può avere filtri, monitoraggio e limiti operativi. Il fatto che un altro soggetto possa rimuoverli dalla propria copia non impedisce all’azienda di applicarli alla sua. Occorre distinguere il rischio della distribuzione pubblica dal rischio della singola installazione, come detto.
Consideriamo un assistente interno che consulta documenti riservati. In questo esempio, il vantaggio dell’esecuzione locale si concretizza soltanto se l’applicazione rispetta i permessi dei documenti e controlla dove finiscono richieste e registri. Se invece l’assistente può eseguire comandi o modificare sistemi, bisogna valutare anche le conseguenze di un’azione sbagliata. I permessi dell’agente determinano il danno possibile: la scelta open o closed, da sola, non descrive questo perimetro.
La stessa logica vale quando si personalizza il modello. Poiché il riaddestramento può cambiare anche il comportamento di sicurezza, la verifica pertinente riguarda la versione effettivamente messa in produzione, con i suoi strumenti e i suoi dati. Le prestazioni del modello originale sono un punto di partenza, non una prova del comportamento del sistema modificato. Per un servizio chiuso, resta invece da valutare quali controlli il fornitore applica e quali dipendono dall’integrazione costruita dal cliente.
Aprire per gradi, rendere verificabili le difese
Per i produttori la scelta ha un’ulteriore difficoltà: una volta distribuiti i pesi, non si può ritirare ogni copia. Una delle opzioni è il rilascio graduale, descritto anche nel rapporto Ntia del 2024 sui modelli a pesi disponibili: accesso iniziale più ristretto, valutazioni esterne e apertura successiva. Il tempo può permettere di individuare problemi e preparare difese, ma non trasforma l’ultima fase in un’operazione reversibile.
Questo percorso pone anche una questione di accesso alla ricerca. Per verificare una difesa incorporata nei pesi, gli studiosi devono poterla esaminare e tentare di modificarla; una dimostrazione filtrata dal produttore non offre lo stesso controllo. L’apertura rende possibili sia le manomissioni sia verifiche più profonde. La ricerca sulla sicurezza dei modelli open nasce esattamente da questa tensione.
E quindi, che fare? L’autonomia offerta dai pesi aperti può essere utile, ma richiede capacità di gestione e prove sulla propria installazione. Per chi sviluppa i modelli, la sfida è dimostrare quanto costa superare una protezione, quali attacchi essa regge e quali capacità utili preserva. È su queste prove che può avanzare una sicurezza verificabile, senza scambiare la chiusura per una garanzia o l’apertura per una soluzione automatica.


Partecipa alla community