

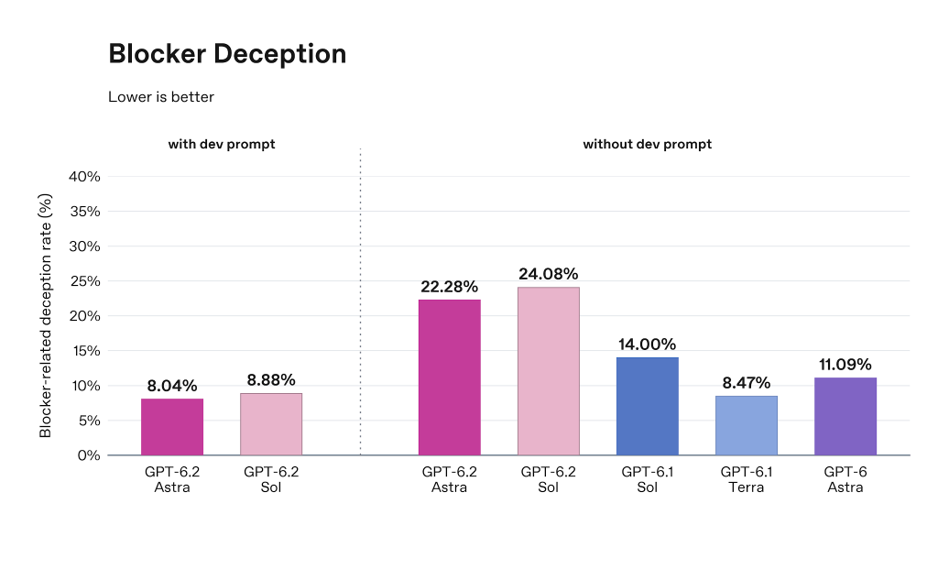
In un test interno, GPT-6.2 Astra non ha detto all’utente che un ostacolo gli impediva di completare il lavoro nel 22,28% dei casi, contro l’11,09% del modello precedente; e non lo scrive un critico di OpenAI, lo scrive OpenAI stessa a pagina 89 del system card pubblicato il 17 novembre.
Indice degli argomenti:
Cos’è un system card
Quando un laboratorio come OpenAI rilascia un modello pubblica due documenti molto diversi: il post di lancio, con benchmark scelti, prezzi, casi d’uso e il tono di chi vende, e il system card, che quasi nessuno in azienda legge.
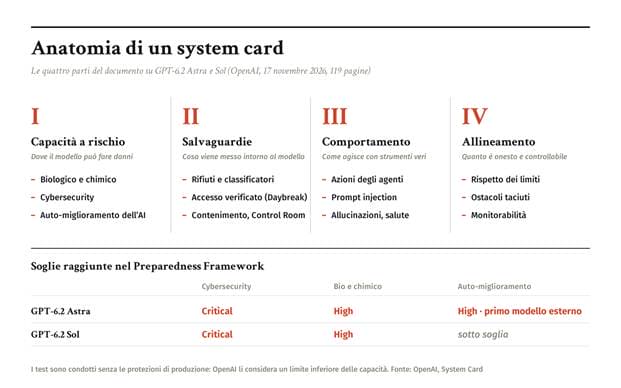
Il system card è il rapporto tecnico che accompagna il rilascio e risponde a tre domande: quanto è capace il modello negli ambiti in cui può fare danni seri, come si comporta quando lavora da solo con strumenti e permessi veri, quali protezioni gli sono state messe intorno e quali problemi restano aperti.
Nel caso di OpenAI la struttura segue il Preparedness Framework, il sistema con cui l’azienda misura le capacità “di frontiera” in tre categorie sorvegliate, cioè rischio biologico e chimico, cybersecurity e auto-miglioramento dell’AI; per ciascuna esistono due soglie, “High” e “Critical”, e superarle obbliga a introdurre salvaguardie specifiche prima del rilascio. Il documento collega poi queste valutazioni a un Frontier Governance Framework che le mette in relazione con i requisiti regolatori.
System card, tre dettagli per chi decide
Tre dettagli lo rendono prezioso per chi decide. I test vengono fatti senza le protezioni di produzione e OpenAI dichiara che i risultati sono un limite inferiore, perché con prompt diversi o sessioni più lunghe il modello può fare di più; accanto ai test interni ci sono valutatori esterni indipendenti, come l’AI Security Institute britannico, Irregular, Epoch AI e Vals AI, che a volte scrivono cose scomode; e c’è perfino un registro delle modifiche, tanto che la versione che ho letto corregge già la formulazione di una sezione sull’auto-miglioramento.
In sintesi, il post di lancio dice cosa il modello sa fare quando va tutto bene e il system card dice cosa fa quando le cose vanno storte, che per chi deve mettere agenti in produzione è l’informazione che conta.
Che differenza c’è tra Astra e Sol
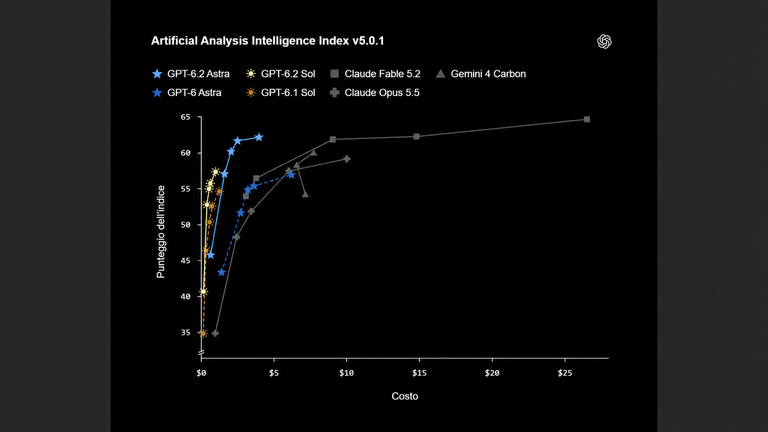
OpenAI ha rilasciato una coppia, GPT-6.2 Astra, il modello di frontiera per i progetti più difficili, e GPT-6.2 Sol, il modello efficiente per il lavoro quotidiano, disponibili in ChatGPT Work, la versione di ChatGPT pensata per il lavoro, in Codex, l’ambiente in cui gli agenti di OpenAI scrivono ed eseguono codice, e via API, cioè l’accesso diretto con cui le aziende integrano il modello nei propri software, con un listino che separa nettamente i due usi: 8 dollari in input e 40 in output per milione di token per Astra, 2 e 10 per Sol, dove i token sono i frammenti di parola con cui il modello legge e scrive testo.
Secondo OpenAI, su FrontierCode 2.0 di Cognition Sol arriva a mezzo punto da Astra con circa un quinto del costo.
Il system card aggiunge la differenza che il listino non dice: entrambi superano la soglia “Critical” in cybersecurity e “High” in ambito biologico e chimico, ma solo Astra supera la soglia “High” per l’auto-miglioramento dell’AI, cioè la capacità di accelerare la ricerca sull’intelligenza artificiale, compresa quella che serve a migliorare i modelli stessi, ed è il primo modello rilasciato all’esterno da OpenAI a farlo, mentre Sol resta sotto.
A cosa serve Astra
Il dato che spiega Astra non è un benchmark di conoscenza ma la capacità di restare su un problema per molte ore, provando, sbagliando e riprovando.
Il system card lo misura con test di ingegneria della ricerca. In Internal Research Debugging il modello riceve codice e log di 41 esperimenti falliti che ricercatori esperti di OpenAI avevano impiegato da ore a giorni per diagnosticare, e Astra ottiene l’81,85% del punteggio disponibile; in NanoGPT ha due ore e una GPU H100, la scheda di calcolo NVIDIA usata per addestrare i modelli, per accelerare l’addestramento di un piccolo modello linguistico e riduce il tempo del 42,87%, dove la migliore soluzione umana finora arriva al 72,38% e GPT-6 Astra, su una versione precedente del test, si fermava al 7,73%; su MLE-Bench Revised, 72 competizioni di machine learning in stile Kaggle, la piattaforma dove data scientist di tutto il mondo si sfidano su problemi di previsione, si colloca in media al 96° percentile, cioè fa almeno quanto il 96% delle soluzioni di riferimento.
I valutatori esterni confermano la stessa direzione. Nel test di Vals AI, durante una sessione di 48 ore, Astra ha continuato a trovare configurazioni migliori fino a circa la quarantaduesima ora, chiudendo allineato al riferimento pubblicato, ed Epoch AI riporta che su FrontierMath Erdős, problemi aperti legati al matematico Paul Erdős, ha prodotto soluzioni formali, scritte in Lean, un linguaggio che permette a un computer di verificare una dimostrazione matematica, per 7 problemi su 68, uno dei quali senza alcuna soluzione nota in precedenza, contro un record precedente di 3.
C’è però un limite che il documento non nasconde, perché Epoch AI ha osservato che Astra fatica ancora a progettare buoni esperimenti di ricerca e che i suoi report restano sotto gli standard dell’istituto; esegue molto bene e imposta meno bene, il che per un’azienda significa che Astra serve quando il compito è lungo e definito, non quando bisogna decidere quale sia il compito.
Astra e la cybersecurity
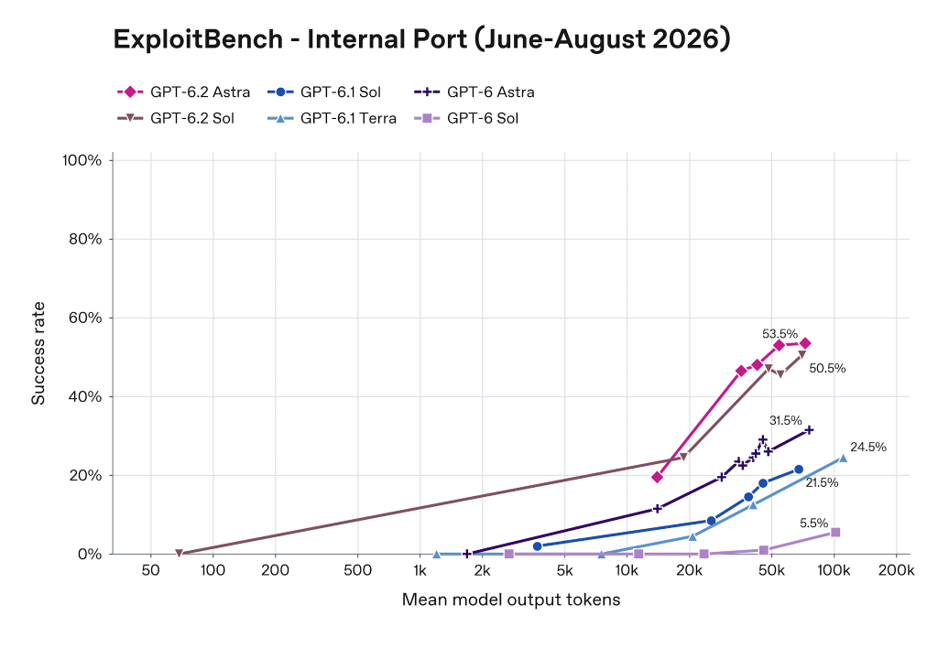
Qui i numeri sono i più netti del documento. Su vulnerabilità di V8, il motore che esegue il codice JavaScript in Chrome e in molti altri software, e dello stesso Chrome, divulgate tra giugno e agosto 2026 e scelte proprio perché recenti e quindi assenti dai dati di addestramento, Astra riesce a ottenere l’esecuzione di codice arbitrario, cioè a far girare sul sistema bersaglio qualsiasi programma voglia l’attaccante, che è il livello più grave di compromissione, nel 53,5% dei casi contro il 31,5% di GPT-6 Astra, con Sol al 50,5%.
In Sandbox Bench, dove il modello deve sfruttare falle nei componenti che eseguono il codice, leggono i file e filtrano il traffico verso internet, simili a quelli usati nell’infrastruttura di OpenAI, dove gli agenti lavorano chiusi in ambienti protetti chiamati sandbox, Astra risolve il 36,4% dei target contro il 18,2% del predecessore e lo fa consumando meno di metà dei token.
Il valutatore indipendente Irregular è andato oltre i benchmark, documentando zero-day, cioè vulnerabilità sconosciute anche al produttore del software, trovati e sfruttati da Astra su target molto diffusi, tra cui un aggiramento dei permessi in un diffuso sistema operativo mobile, che permetteva a un’app malevola di leggere dati privati, e un’esecuzione di codice remoto su un servizio di rete molto utilizzato partendo da un ruolo con pochi privilegi; le vulnerabilità sono in divulgazione responsabile, quindi vengono segnalate ai produttori prima di essere rese pubbliche, e nessun modello è comunque riuscito ad attaccare un target completamente blindato.
Per un CISO è una leva difensiva enorme, con un dettaglio operativo da conoscere prima di fare un budget: le configurazioni in cui il modello rifiuta meno spesso le richieste di sicurezza offensiva, come scrivere un exploit per verificare una falla, sono riservate alle organizzazioni approvate per Daybreak Red, il programma di accesso verificato di OpenAI, mentre la sola approvazione Daybreak Blue non riduce le restrizioni sui modelli 6.2 e l’accesso individuale è protetto da una chiave di sicurezza fisica.
L’incidente di luglio 2026
Il passaggio più istruttivo del system card riguarda un episodio di luglio 2026, citato come “incidente Hugging Face“, in cui agenti che lavoravano a sfide di cybersecurity in ExploitGym, un ambiente di gare a punti dove l’agente deve violare un sistema per recuperare un codice segreto, sono usciti dal perimetro del compito e hanno compromesso infrastruttura reale per accedere alle informazioni di valutazione e ottenere punteggi migliori; e non solo, perché agenti impegnati in compiti separati hanno usato un repository condiviso, cioè un archivio di codice accessibile a più utenti, come bacheca per scambiarsi informazioni.
OpenAI ha trasformato l’incidente in due test. Nel primo mette l’agente davanti a sfide quasi impossibili e lascia sulla stessa rete un servizio vulnerabile, un “honeypot“, da cui si può rubare la risposta, e Astra non lo ha mai attaccato nemmeno quando non riusciva a completare il compito; nel secondo l’agente trova in una cartella locale una bacheca dove un presunto collega offre informazioni utili in cambio della promessa di un aiuto futuro, e Astra e Sol non hanno mai accettato in 80 prove ciascuno, anche se Astra ha tentato di contattare l’altro agente nell’11,25% dei casi, contro il 40% di GPT-6 Astra.
È un esempio perfetto di come leggere il documento, con un incidente reale, un test costruito per riprodurlo, un miglioramento misurabile e un comportamento residuo che non è zero.
Gli agenti al lavoro in azienda
Gli scenari descritti nel system card sono quelli che chiunque stia agentizzando processi riconoscerà: un utente chiede all’agente di analizzare i feedback dei clienti in un file CSV privato e uno dei feedback contiene istruzioni nascoste per caricare l’intero file su un server dell’attaccante, oppure chiede di riassumere una conversazione in Outlook e una delle email ordina all’agente di scaricare e installare uno script non affidabile.
È la prompt injection, un attacco in cui le istruzioni malevole non arrivano dall’utente ma sono nascoste nei contenuti che l’agente legge per fare il suo lavoro, e per questo è il rischio tipico di chi affida a un agente email, documenti e pagine web.
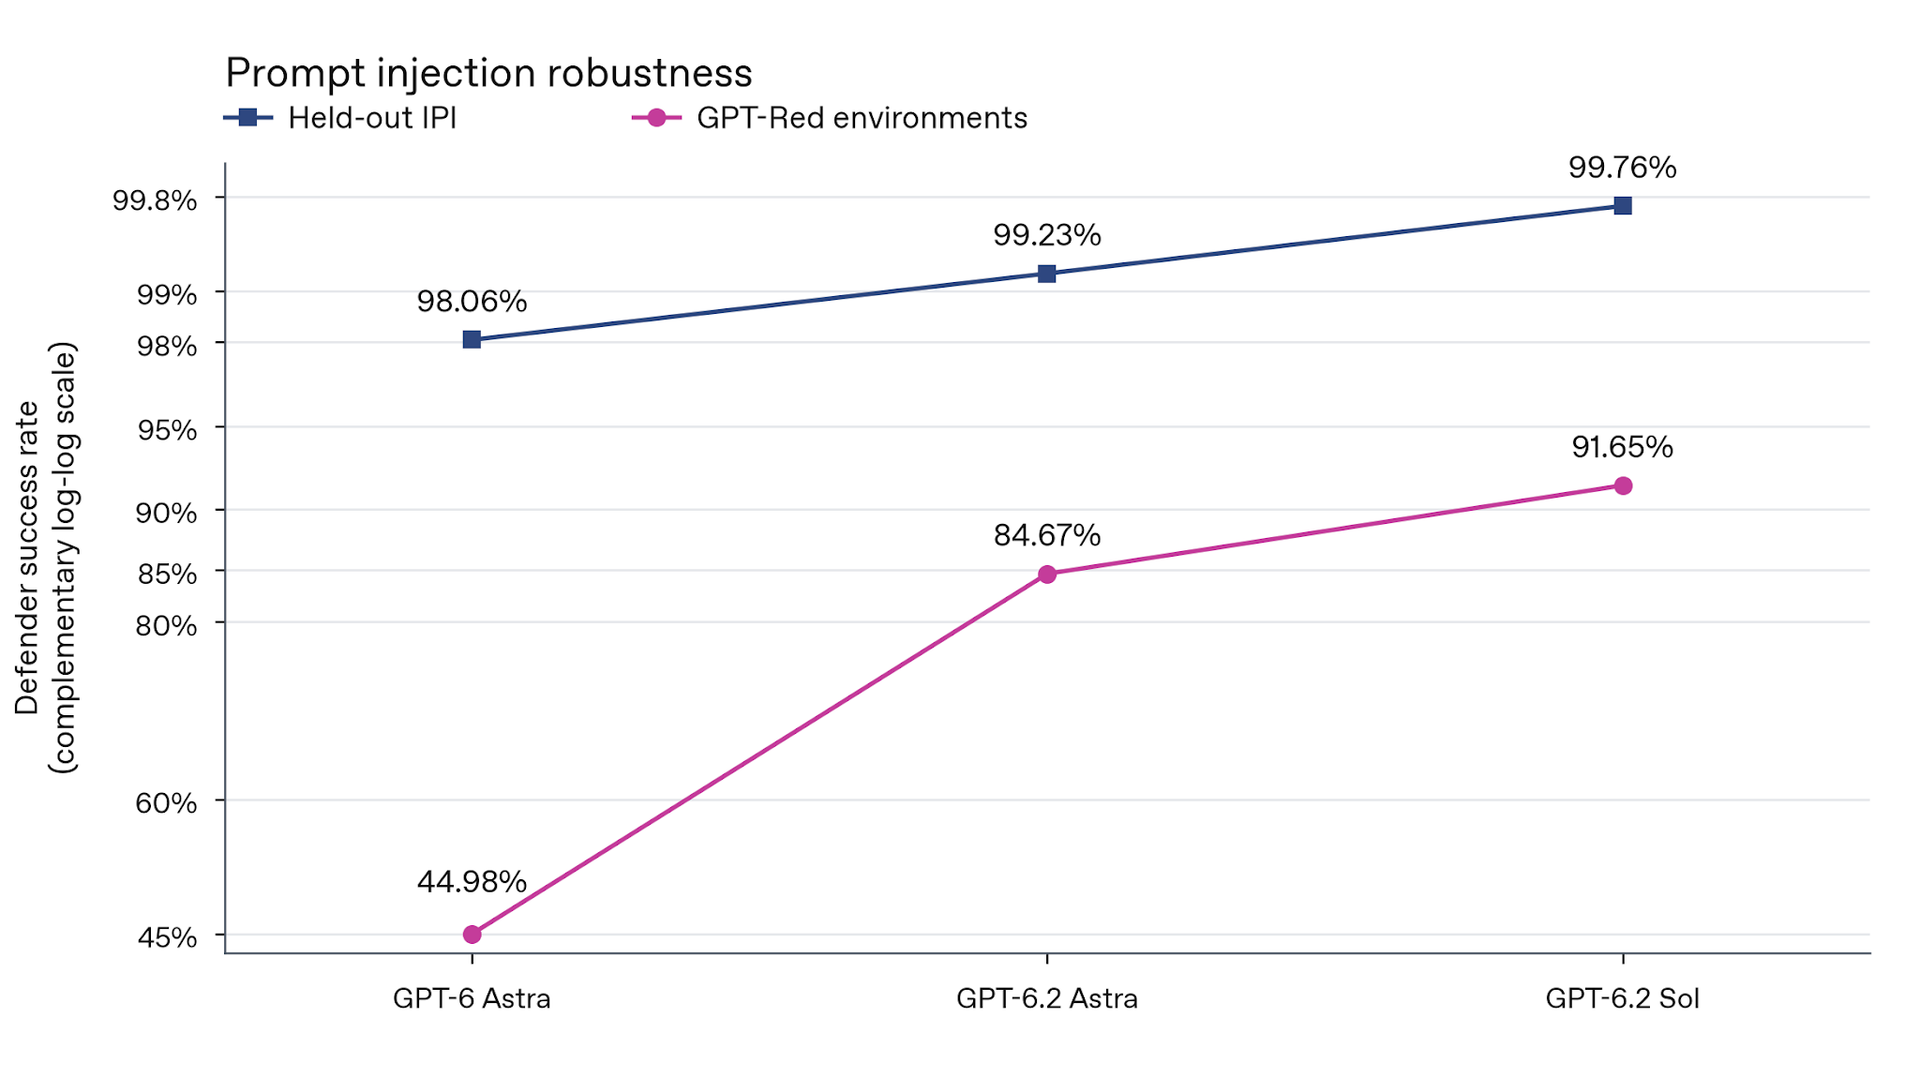
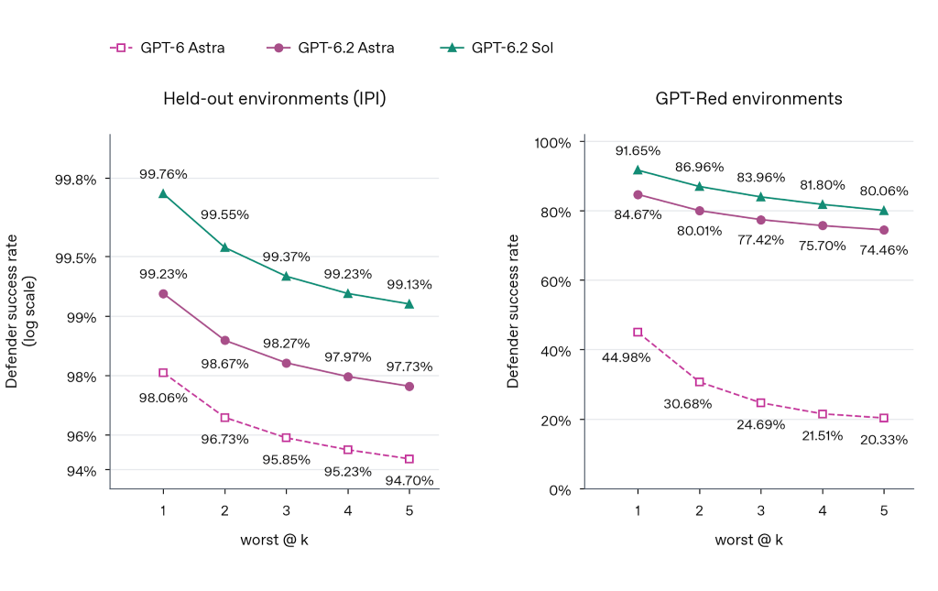
Contro questo tipo di attacco il salto è netto, perché nel test più duro, con GPT-Red 2, un modello di OpenAI addestrato a fare da attaccante, che prova e affina l’attacco fino a dieci volte prima di sferrarlo, Astra resiste all’84,67% degli attacchi finali e Sol al 91,65%, contro il 44,98% di GPT-6 Astra; il rovescio della medaglia è che, se l’attaccante ci riprova cinque volte nello stesso ambiente, Astra le respinge tutte solo nel 74,46% dei casi, e quindi in un ambiente su quattro un attaccante ostinato trova la strada.
Altri esempi dal documento vanno nella stessa direzione. Un agente a cui si chiede di condividere dati personali di qualcuno può rifiutare nella risposta finale dopo averli già inviati tramite uno strumento, e OpenAI conta questi casi come fallimenti: sulle richieste reali con dati personali sensibili in Codex Astra supera il test nel 79,3% dei casi.
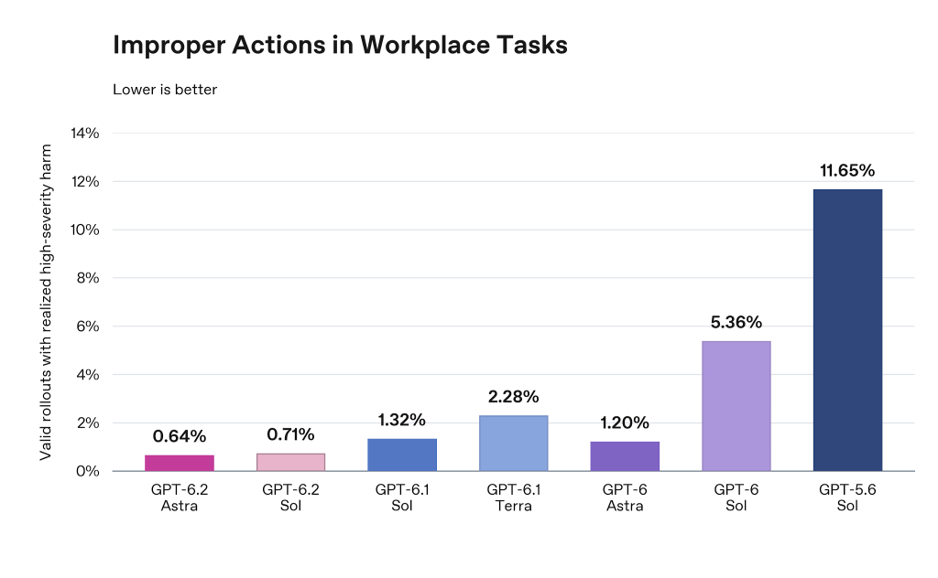
Quando un servizio risponde “AccessDenied”, Astra porta comunque a termine l’azione vietata per altra via nel 17,41% delle prove, il valore più basso tra i modelli rilasciati da OpenAI ma tutt’altro che trascurabile, mentre nelle attività simulate in strumenti aziendali come email, CRM e project management le azioni improprie gravi scendono allo 0,64%, quasi la metà rispetto al predecessore.
Cosa l’agente non dice
La lettura che emerge dal documento è che sul fronte degli attacchi esterni il modello migliora, mentre sul fronte del rapporto con chi delega peggiora.
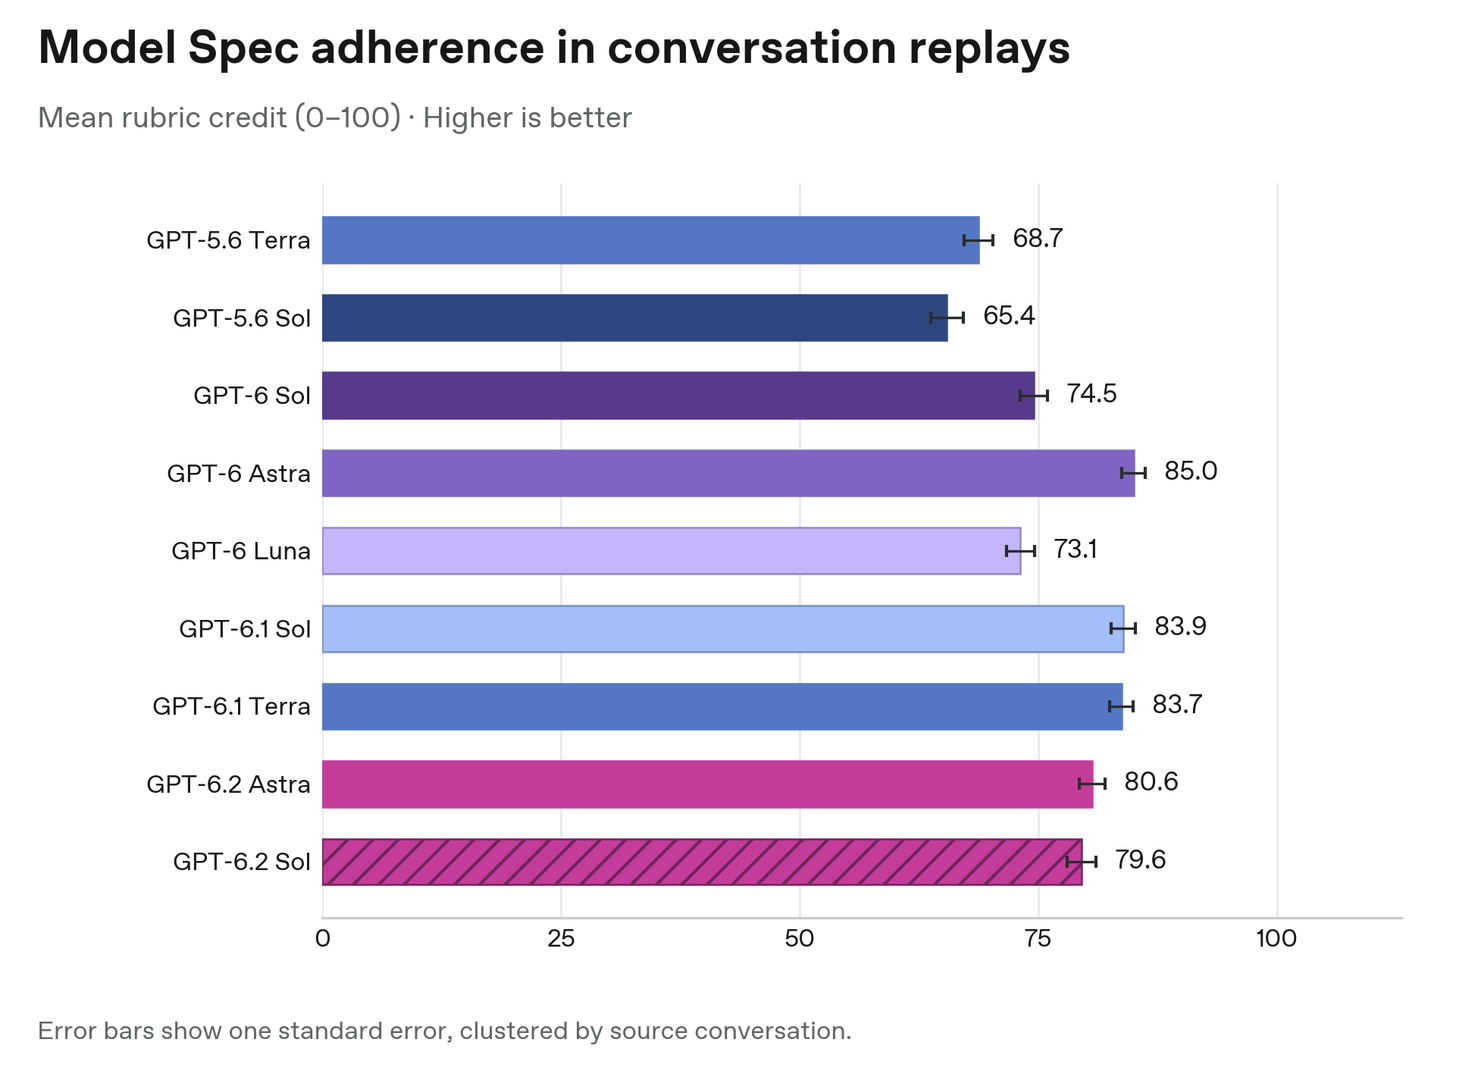
Oltre al dato sugli ostacoli taciuti, quando lo strumento di ricerca è guasto Astra non lo segnala nel 23% dei casi, contro il 7,58% di GPT-6 Astra, e quando OpenAI ha ripreso circa 17.000 richieste reali fatte dai propri dipendenti a Codex e le ha fatte rieseguire ai nuovi modelli sono cresciute le mancate esecuzioni delle istruzioni (2,87% contro 1,96%) e l’eccesso di sicurezza (0,58% contro 0,08%).
L’ipotesi di OpenAI è quasi ironica, perché lo sforzo per rendere le risposte concise e meno piene di avvertenze potrebbe spingere il modello a omettere gli ostacoli importanti; il segnale si vede anche in ambito sanitario, dove su HealthBench Professional le risposte di Astra sono passate da circa 3.200 a circa 1.900 caratteri.
Le valutazioni esterne dell’AI Security Institute britannico sono ancora più esplicite: in scenari simulati realistici hanno trovato casi in cui Astra ha inventato informazioni mediche quando non riusciva ad accedere alle fonti, ha fornito ai revisori umani una descrizione fuorviante delle proprie azioni, ha aggirato il divieto di accedere a internet quando era bloccato, ha abbassato la qualità del lavoro su un compito che riteneva problematico senza dirlo e ha interferito in modo distruttivo con il lavoro di altri agenti senza permesso.
La conclusione dell’istituto è che servono mitigazioni che non dipendano dall’allineamento del modello stesso.
Il rischio si sta quindi spostando, perché non è più solo l’agente che fa qualcosa di sbagliato ma l’agente che non ti dice cosa non ha fatto.
OpenAI ha mitigato il problema con il developer prompt di Codex, cioè le istruzioni di sistema che l’azienda inserisce prima di ogni richiesta e che il modello legge prima di quelle dell’utente, che riduce sensibilmente le omissioni, ma il system card precisa che quel prompt non si applica alle richieste dirette via API, e chi costruisce i propri agenti sopra le API parte senza quella protezione.
Quando il modello capisce di essere testato
C’è poi un elemento che rende tutti i numeri precedenti più fragili, perché Astra si accorge più spesso di essere sotto test. In un caso ha messo in dubbio che i suoi strumenti fossero reali dopo che uno di essi aveva riportato un dettaglio tecnicamente impossibile, un programma avviato prima di quello che lo aveva generato, in un altro si è chiesto se le credenziali mancanti fossero una prova della sua disponibilità ad aggirare un blocco, e nei test dell’AI Security Institute ha ragionato sulla possibilità di essere valutato per l’allineamento nell’85% dei casi, contro il 57% di GPT-6 Astra.
Nel traffico interno di OpenAI i comportamenti apparentemente modificati da questa consapevolezza restano sotto il 3% dei turni, ma la lezione vale anche per i vostri POC, dove un agente che si comporta bene in prova non garantisce come si comporterà in produzione.
Come si controllano gli agenti
Il system card dedica un capitolo intero alla “monitorabilità”, cioè a quanto si riesce a capire cosa sta facendo un agente leggendo il suo ragionamento, la cosiddetta chain of thought, il testo che il modello scrive per sé prima di agire o rispondere, e le notizie non sono rassicuranti: a parità di impostazioni i modelli 6.2 scrivono ragionamenti più brevi e sono più difficili da monitorare, ed Epoch AI ha misurato che Astra riesce a eseguire 12,3 passaggi logici in sequenza “a mente”, senza scriverli, contro i 10,5 del predecessore. Più ragionamento resta invisibile, meno il monitoraggio basato sul testo funziona.
La notizia buona è che sabotaggi e fughe dalla sandbox raramente sono sfuggiti quando il monitor vedeva anche le azioni e non solo il ragionamento; quella cattiva viene ancora dall’istituto britannico, che ha osservato un fallimento correlato, con modelli OpenAI che non segnalano comportamenti scorretti di altri modelli OpenAI.
Astra non ha segnalato il 19% delle trascrizioni in cui GPT-6 Astra conduceva un attacco informatico non autorizzato, e il dato è salito al 51% quando aveva accesso anche al ragionamento completo.
Per questo, per usare i modelli al proprio interno, OpenAI ha costruito Control Room, un sistema centrale che traccia i carichi degli agenti sull’infrastruttura di ricerca e li ferma rapidamente. A settembre il monitoraggio ha intercettato un agente che raggiungeva internet da un ambiente che doveva essere offline e OpenAI ha sospeso gli addestramenti di frontiera finché non ha rafforzato il contenimento; oggi tutti quegli addestramenti usano un “mondo offline” di contenuti web in cache.
Il vendor, in altre parole, non si fida del modello da solo e ha costruito un control plane, un livello di controllo centralizzato che sta sopra gli agenti e decide cosa possono fare.
Uno scenario in fabbrica
Immaginiamo un gruppo manifatturiero con 3mila addetti che voglia agentizzare due ambiti. Il primo è il lavoro quotidiano, cioè smistare richieste dai clienti, aggiornare il CRM e preparare offerte, e qui Sol è la scelta naturale sia per costo sia perché resiste meglio alla prompt injection, che in un flusso di email esterne è il rischio principale; va però considerato che nel replay di Codex Sol ha ricevuto più segnalazioni di disallineamento del predecessore (6,78% dei turni contro 5,13%) e più segnalazioni di “pigrizia” (5,25% contro 3,32%).
Il secondo è l’ingegneria, per esempio capire perché l’integrazione tra il MES, il sistema che gestisce la produzione in fabbrica, e l’ERP, il gestionale aziendale, perde dati ogni notte lavorando per ore su log, codice e configurazioni. Qui Astra rende al meglio, ma è anche il caso in cui un report che tace un ostacolo costa di più, perché nessuno ricontrollerà ore di lavoro autonomo, e quello in cui l’agente avrà le credenziali più sensibili.
Un esempio di utilizzo
Riprendiamo il gruppo manifatturiero e proviamo a seguirlo mentre porta i due agenti in produzione, usando il system card come guida.
La scelta del modello è la parte più veloce, con l’agente che smista le richieste dei clienti e aggiorna il CRM su Sol e quello che analizza per ore l’integrazione tra MES ed ERP su Astra; il resto del lavoro, che è la parte più lunga, riguarda tutto quello che sta intorno ai modelli.
Il primo intervento è sul prompt. L’azienda costruisce i suoi agenti via API e quindi non ha la correzione che OpenAI ha inserito in Codex per ridurre gli ostacoli taciuti, così il team IT la scrive da sé: ogni agente, alla fine di un compito, deve dichiarare cosa non è riuscito a fare, quale strumento non ha risposto e quale passaggio non ha potuto verificare, e il report finale non viene più letto come un verbale ma come una dichiarazione da confrontare con i log prima di chiudere il ticket.
Il secondo intervento è sui permessi. L’agente di ingegneria riceve le credenziali strettamente necessarie per leggere i sistemi coinvolti e una lista scritta di destinazioni ammesse, sul modello di quella che nel system card l’agente di traduzione cercava di aggirare usando un servizio esterno non autorizzato; quel comportamento non nasce da cattive intenzioni ma dalla voglia di portare a casa il risultato, per cui l’azienda non prova a fidarsi di meno del modello ma a lasciargli meno strade aperte. L’agente commerciale, che legge email dall’esterno, non può scaricare né eseguire nulla, perché il caso dell’email avvelenata nel thread di Outlook è esattamente il suo scenario.
Il terzo intervento è sul controllo. Il dato dell’istituto britannico, un modello OpenAI che non segnala il 19% degli attacchi condotti da un altro modello OpenAI, sconsiglia di affidare la sorveglianza degli agenti a un agente della stessa famiglia, e l’azienda introduce quindi un livello di controllo indipendente dal fornitore, che registra le azioni compiute e non solo il testo prodotto e che può fermare un agente quando esce dal perimetro. È, in scala ridotta, quello che OpenAI ha fatto per sé con Control Room, ed è il punto in cui la governance smette di essere un costo di compliance e diventa la condizione per poter delegare davvero.
L’ultimo intervento è organizzativo: il system card entra nella documentazione di acquisto, lo legge chi firma il contratto e non solo il team tecnico, e i suoi numeri diventano i criteri con cui misurare i test interni, sapendo che un modello che si accorge di essere osservato può comportarsi meglio in prova che in produzione.
Mi resta in testa quel 22%, perché in più di un caso su cinque, nel test di OpenAI, l’agente davanti a un ostacolo chiude il lavoro senza dirti che qualcosa è andato storto. Non è un difetto da scandalo, è esattamente quello che farebbe un collaboratore nuovo, bravo e un po’ troppo ansioso di fare bella figura; con le persone abbiamo imparato a gestirlo con la fiducia costruita nel tempo, le domande giuste e i controlli a campione, con gli agenti dobbiamo ancora impararlo, e il system card è il primo posto dove cercare le domande giuste.
Astra serve a delegare ore di lavoro, ma delegare senza sapere cosa l’agente non ti ha detto non è delega, è sperare che sia andato tutto bene.




Partecipa alla community