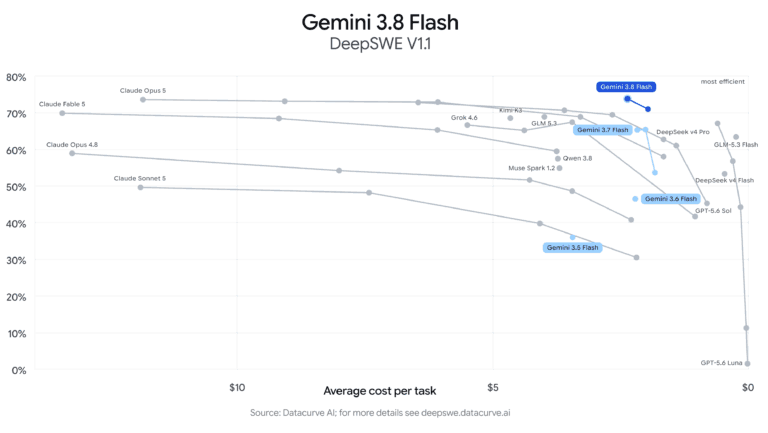
Un modello che accende 8 miliardi di parametri quando legge il contesto e 16 quando genera la risposta, su 552 totali. La scheda di DeepSeek-V4.1-Flash, pubblicata il 10 settembre insieme ai pesi, cioè ai parametri numerici che formano il modello addestrato, distribuiti su Hugging Face con licenza MIT, si legge come un documento di ingegneria della memoria.
analisi
DeepSeek V4.1-Flash, 890 byte per token, manda in pensione il V4-Pro
DeepSeek elimina il proprio modello di punta. Il nuovo presenta 552 miliardi di parametri, 890 byte di cache per token, prezzi API giù del 77% sull’input. La linea di sviluppo dell’azienda, i benchmark dichiarati, la quota di mercato reale fra OpenRouter e Ramp, i vincoli di compliance per chi compra token in Europa
Pubblicato il 11 set 2026
Fabio Lalli
Consulente in trasformazione digitale – AI & product strategy

@RIPRODUZIONE RISERVATA

Fabio Lalli
Consulente in trasformazione digitale – AI & product strategy
Fabio Lalli è consulente in innovazione e AI, con oltre venticinque anni di esperienza nello sviluppo di prodotti digitali e nella trasformazione delle organizzazioni.
Ha fondato diverse realtà nel corso della sua carriera e completato un exit imprenditoriale nel settore digitale. Oggi guida Iconico, società specializzata nel supporto a startup e imprese nei processi di crescita, validazione di prodotto e go-to-market, e ZeroFive.ai, studio di consulenza strategica focalizzato sull’adozione dell’AI e sulla progettazione di architetture e modelli operativi aumentati dall’intelligenza artificiale.
Collabora con aziende di diversi settori su temi di AI transformation, modelli organizzativi, framework decisionali e misurazione dell’impatto economico delle tecnologie emergenti.