


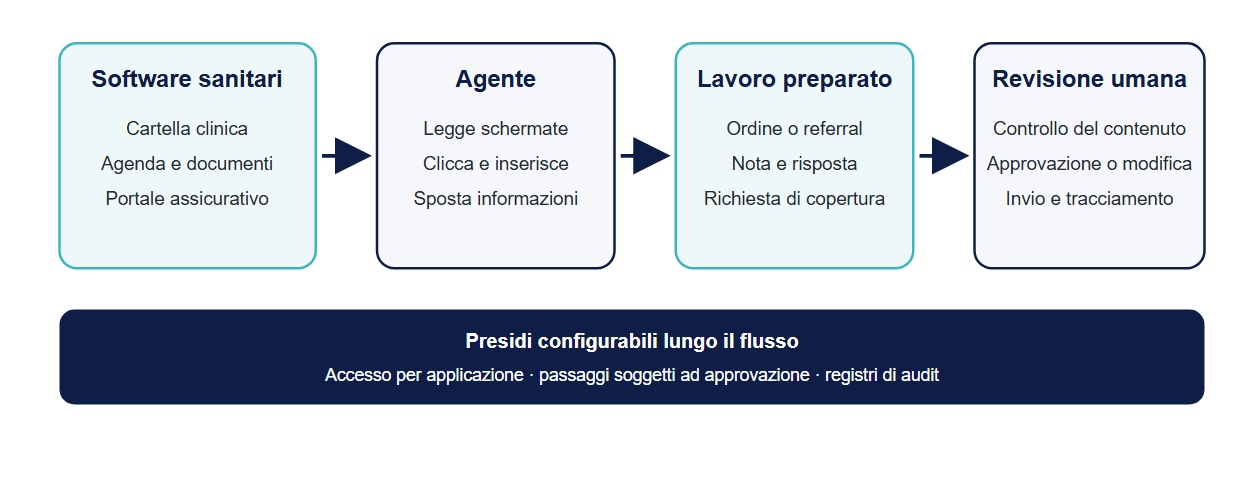
OpenAI porta gli agenti AI dentro i flussi di lavoro di ospedali e assicurazioni sanitarie: possono consultare cartelle cliniche elettroniche, passare da un portale all’altro e preparare documenti per autorizzazioni, invii e follow-up. L’annuncio del 16 novembre amplia ChatGPT for Healthcare con l’uso del computer, una ricerca clinica aggiornata e oltre venti nuovi plugin. Per le strutture, il cambiamento è operativo: l’assistente non si limita a formulare una risposta, ma può eseguire passaggi tra software già in uso.
OpenAI presenta queste funzioni come supporto per attività amministrative e cliniche, con autorizzazioni configurabili, registri delle azioni e controlli umani. Un esempio mostra l’agente che esamina la cartella, prepara una prescrizione di risonanza e una risposta al paziente, poi compila una richiesta di autorizzazione assicurativa. Il professionista deve rivedere le bozze prima dell’invio o della registrazione definitiva.
Indice degli argomenti:
Agenti AI in sanità: dal testo all’azione nei sistemi
La differenza rispetto a un chatbot tradizionale sta nell’interazione con applicazioni che non sempre dispongono di un’interfaccia di programmazione adatta. L’agente osserva lo schermo, clicca, digita e passa da un sistema all’altro. Nel caso mostrato da OpenAI, un messaggio del paziente avvia la consultazione di note cliniche, fisioterapia e immagini precedenti; il modello prepara quindi ordine, nota clinica e risposta, lasciando la valutazione al medico.
Il computer-use copre i passaggi intermedi che spesso restano manuali anche quando cartella elettronica e portale assicurativo sono digitalizzati. Per una richiesta di risonanza, per esempio, il team deve raccogliere elementi clinici, trasferirli nel modulo dell’assicuratore e registrare l’esito nella cartella. L’automazione promette di collegare questi passaggi senza sostituire i sistemi informativi esistenti.
OpenAI cita collaborazioni con Abridge, Ambience, Cigna Healthcare e CVS Health per referral, autorizzazioni, pianificazione delle dimissioni e contatti successivi alle visite.
Nel caso di CVS, l’azienda riferisce che un agente ha smaltito in un fine settimana un arretrato di documenti accumulato per mesi; un altro gestisce passaggi di sistema legati a decine di migliaia di consulti al giorno. Sono risultati riferiti dal fornitore e da un partner: la comunicazione non offre un confronto indipendente sui tempi, sugli errori o sui costi complessivi.
La collaborazione con Cigna mostra un’altra applicazione: riunire informazioni su coperture, fornitori, appuntamenti e interazioni precedenti, prima disperse in più di dieci sistemi. Madhu Nutakki, CIO di Cigna Healthcare, ha dichiarato che il passaggio dal prototipo alla messa in esercizio in meno di otto settimane ha permesso ai case manager di ricevere prima un quadro più completo dei propri assistiti. Anche in questo caso, la valutazione del beneficio proviene dall’azienda coinvolta.
Che cosa misurano i test OpenAI
Per sostenere il lancio, OpenAI pubblica risultati su due famiglie di prove: le attività cliniche svolte nella casella di posta di una cartella elettronica e quelle amministrative del benchmark HealthAdminBench. I valori hanno denominatori diversi e descrivono dimensioni distinte: sicurezza e utilità percepite, punti di una rubrica, costo per attività. Non vanno letti come un unico tasso di successo clinico.
Tre misure distinte nelle valutazioni annunciate
| Area valutata | Risultato riportato | Che cosa indica |
|---|---|---|
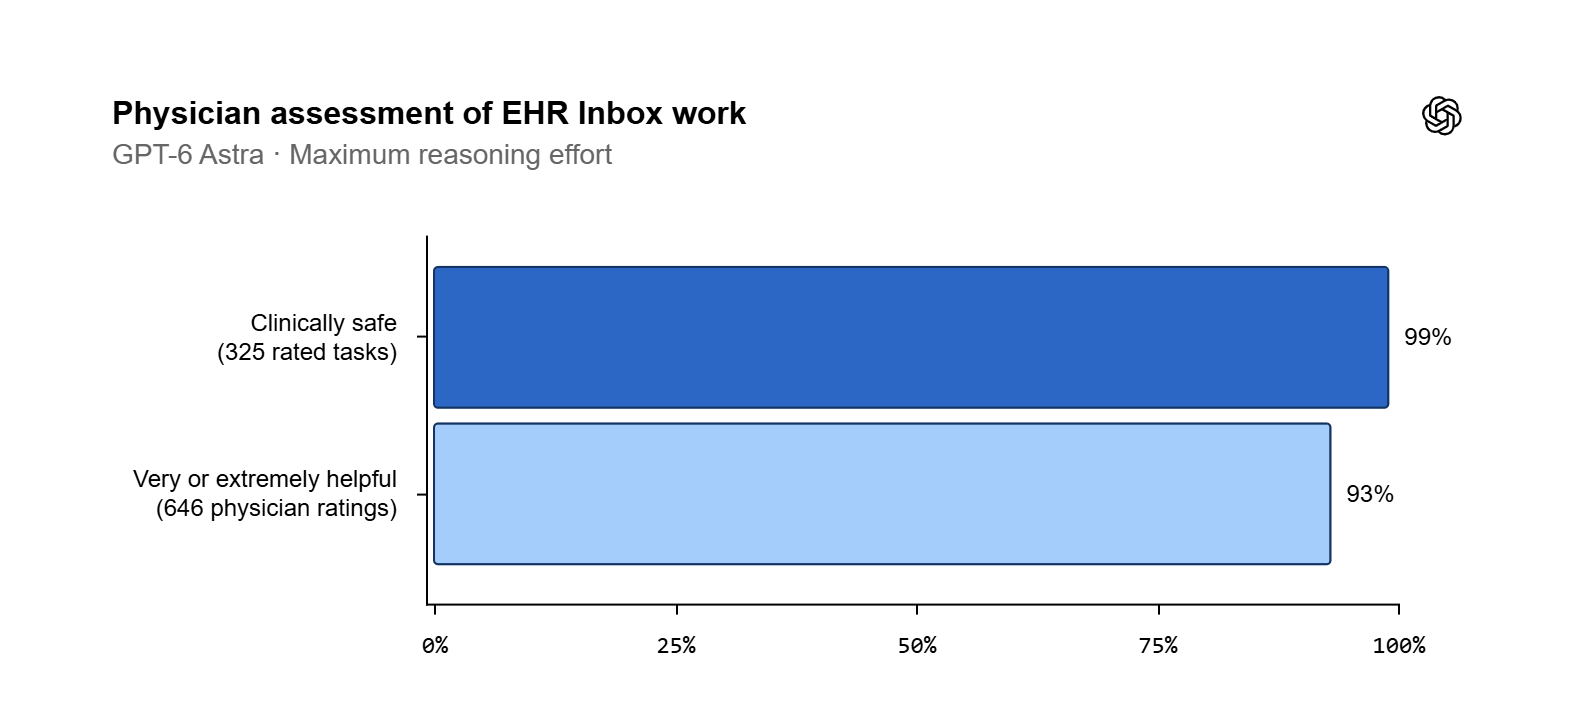
| Attività cliniche in EHR | 99% di 325 attività valutate come sicure; 93% di 646 valutazioni giudicate molto o estremamente utili | Giudizi dei revisori sui compiti esaminati; campioni e misure separati |
| Workflow amministrativi | GPT‑6 Astra: 94,3% dei punti disponibili; GPT‑6 Luna: 91,8%. Luna: 8,5 centesimi per attività, con costo dichiarato inferiore del 98% | Punteggio di rubrica e costo nel benchmark HealthAdminBench, con massimo livello di ragionamento |
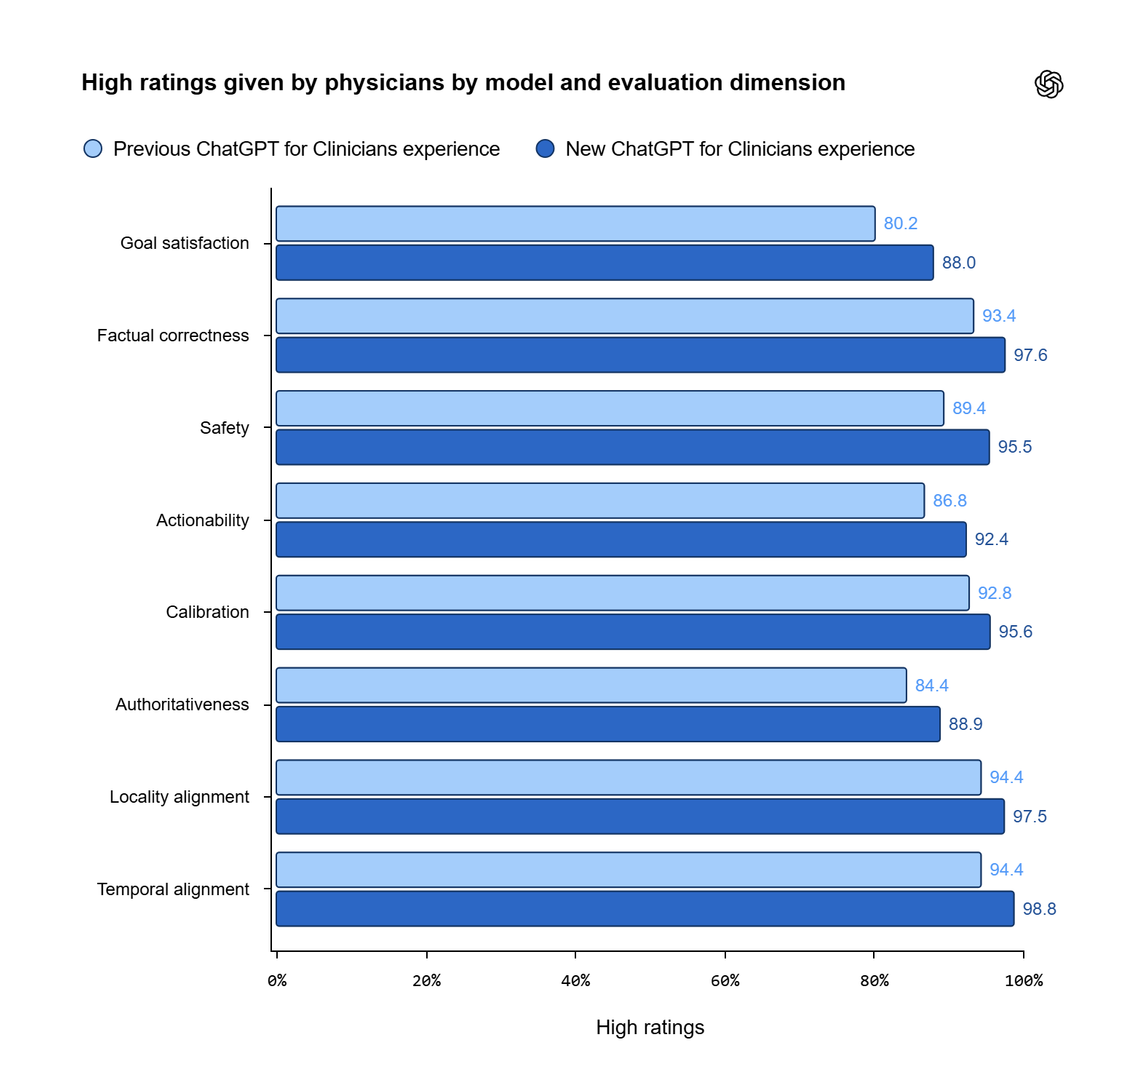
| Ricerca clinica aggiornata | Oltre 1.300 valutazioni in cieco; giudizi più alti in tutte le otto dimensioni esaminate | Confronto tra la nuova esperienza e la versione precedente, secondo OpenAI |
Le percentuali non misurano esiti sui pazienti: OpenAI non pubblica per questi test un tasso di riduzione degli errori clinici in corsia, né un confronto dei costi totali di implementazione. Per le attività amministrative, l’azienda indica la quota di punti assegnati da una rubrica; questo dato non equivale alla percentuale di procedure completate correttamente dall’inizio alla fine.
Il completamento end-to-end resta la prova più difficile
La distinzione tra singoli passaggi e intero workflow è rilevante perché un agente può compilare correttamente un modulo ma non allegare il documento giusto, oppure perdere un dato mentre cambia applicazione. Lo studio di Stanford HAI del 19 ottobre 2026 sui benchmark clinici e amministrativi mostra quanto la valutazione cambi quando si misura l’esecuzione completa, non solo la qualità dei singoli passaggi.
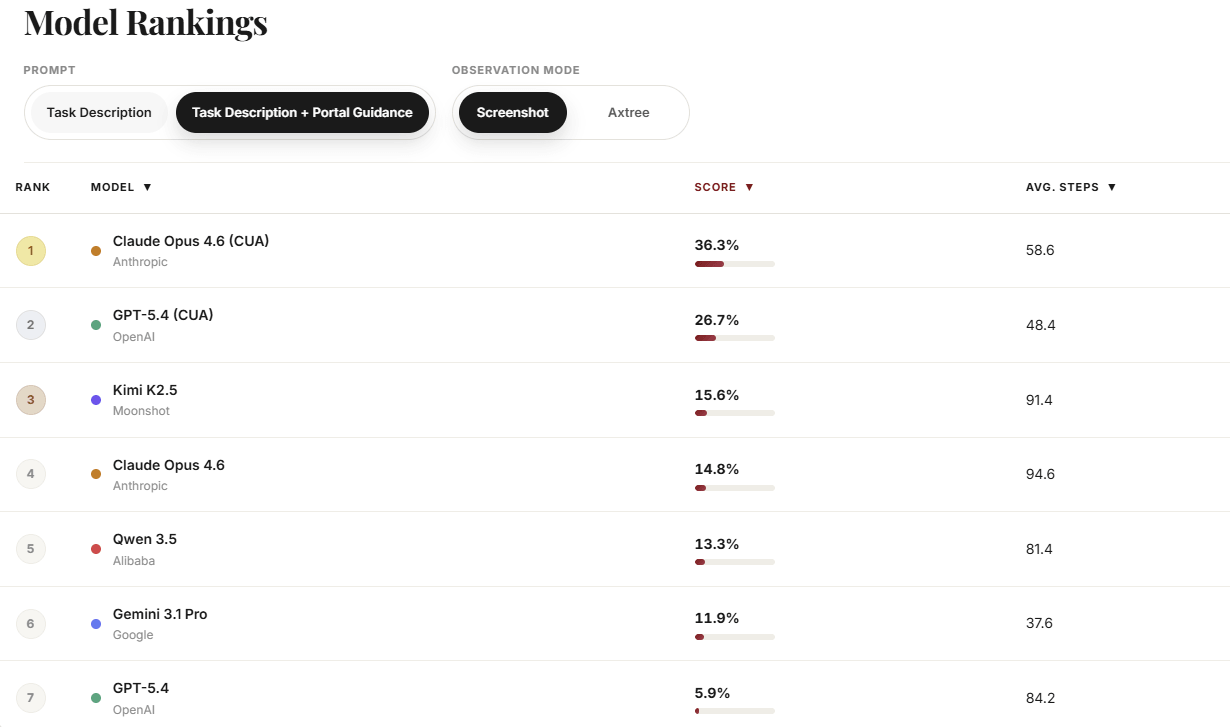
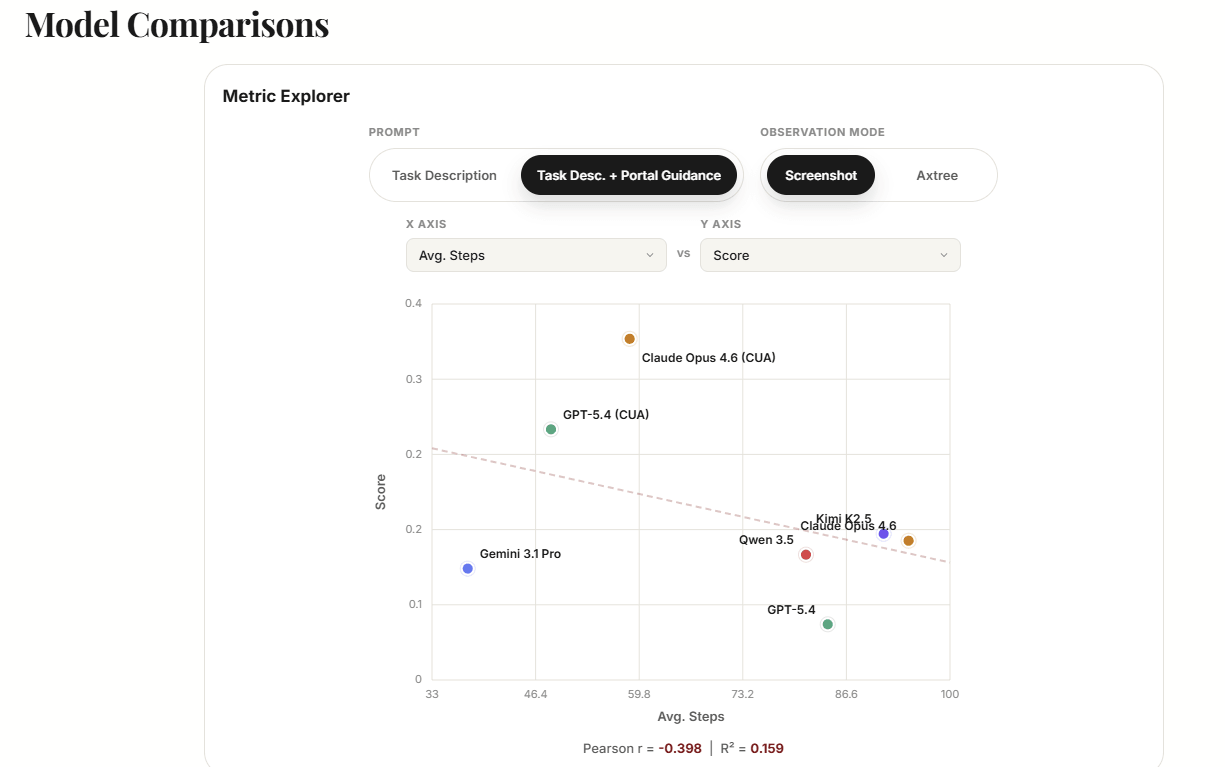
Nella versione corrente di HealthAdminBench, il gruppo di Stanford descrive 135 attività, quattro ambienti simulati e dati dei pazienti sintetici. Nel test riportato da Stanford, l’agente migliore allora valutato completava il 36,3% dei compiti end-to-end; GPT‑5.4 in modalità computer-use superava l’82% dei sotto-compiti, ma terminava il 26,7% delle attività complete.
Queste percentuali non sono direttamente confrontabili con il punteggio di rubrica pubblicato da OpenAI: cambiano modello, configurazione, criterio di valutazione e momento del test. Il dato utile è la distanza tra eseguire una parte e chiudere il caso.
Per questo, l’affidabilità non dipende soltanto dal modello. Contano la memoria di lavoro tra schermate, la gestione degli allegati, la capacità di correggere un errore e il comportamento quando i dati sono ambigui. Stanford rileva che i fallimenti dei test amministrativi sono spesso legati alla perdita di informazioni nel passaggio tra cartella, portale e documenti.
I sistemi sanitari dovranno quindi collaudare le sequenze complete con casi realistici, non fermarsi a demo riuscite o benchmark aggregati.
Dosaggio dell’ibuprofene dopo una frattura al braccio
Messaggio in posta in arrivo
“Mi può dire quanta quantità di ibuprofene pediatrico posso somministrarle per il dolore al braccio e con quale frequenza? Ne ha ricevuto un po’ in ambulatorio, ma non vedo le istruzioni sui documenti.”
Cosa è stato chiesto al modello di fare
Esaminare la visita e gli esami di imaging, quindi salvare una risposta non inviata al genitore con le indicazioni sul dosaggio, la cura del gesso e le precauzioni in caso di ritorno urgente, oltre a una nota di documentazione non firmata.
Cosa ha fatto il modello
Ha utilizzato il peso documentato della bambina e la dose prescritta in ambulatorio per redigere le istruzioni sul dosaggio dell’ibuprofene, sulla cura del gesso e sui segnali di allarme.
Ha salvato una nota separata non firmata che documentava la revisione della cartella clinica, il dosaggio proposto, le precauzioni per il ritorno in ambulatorio e il fatto che la risposta al caregiver rimanesse una bozza non inviata in attesa dell’approvazione del medico.
Privacy, supervisione e disponibilità in Europa
OpenAI dichiara che i contenuti condivisi in ChatGPT for Healthcare non vengono usati per addestrare i modelli. La piattaforma offre controlli di accesso basati sui ruoli, registri di audit e possibilità di introdurre approvazioni. Per i flussi coperti da HIPAA, l’azienda richiede servizi idonei inclusi nell’accordo BAA, le impostazioni di sicurezza e conservazione necessarie e la protezione anche dei sistemi collegati.
La copertura non si estende automaticamente a ogni integrazione: dipende dal servizio abilitato, dalla configurazione e dagli accordi applicabili.
Per ospedali e aziende sanitarie europee, il riferimento HIPAA riguarda la normativa statunitense e non sostituisce gli obblighi europei. Il Regolamento generale sulla protezione dei dati classifica i dati relativi alla salute tra le categorie particolari e ne disciplina il trattamento; l’ente che adotta un agente deve definire finalità, base giuridica, accessi, tempi di conservazione e responsabilità per ogni sistema coinvolto.
Anche l’AI Act richiede una valutazione legata all’uso previsto: la Commissione europea chiarisce che la classificazione dipende dalla funzione e dalle modalità di impiego, e non dal solo fatto che un’applicazione operi in sanità. Gli obblighi per i sistemi ad alto rischio si applicheranno secondo il calendario aggiornato al 2027 e al 2028, ma la categoria dipende dal caso specifico. L’automazione di una pratica amministrativa e un software che influenza una decisione clinica possono avere perimetri differenti.
La disponibilità annunciata va letta nello stesso modo. OpenAI indica gli agenti computer-use per i clienti ChatGPT for Healthcare, per ChatGPT for Clinicians e per gli sviluppatori tramite API, ma l’accesso individuale gratuito a ChatGPT for Clinicians è riservato ai professionisti verificati negli Stati Uniti.
Per le strutture europee, il comunicato non specifica un calendario di disponibilità commerciale locale: la possibilità di usare l’API o il prodotto aziendale va verificata con OpenAI e con i responsabili di conformità e sicurezza della singola organizzazione.
La valutazione passa dai tempi al rischio operativo
Il vantaggio economico non coincide con il prezzo per chiamata del modello. Una struttura deve sommare licenze, integrazioni, gestione degli accessi, controllo umano, correzione degli errori, formazione e manutenzione delle procedure. Il costo dichiarato di 8,5 centesimi per attività di GPT‑6 Luna riguarda la valutazione indicata da OpenAI e non include questi oneri organizzativi.
La metrica da osservare è il costo per pratica completata e verificata, confrontato con il processo manuale e con il tempo di supervisione necessario.
Un progetto pilota dovrebbe partire da un flusso circoscritto, per esempio il completamento di un referral o la raccolta dei documenti per un’autorizzazione. Prima dell’avvio l’organizzazione può definire quali sistemi l’agente può consultare, quali campi può compilare, quali azioni richiedono approvazione e quali errori impongono un passaggio a una persona. Il test dovrebbe poi registrare attività concluse, rilavorazioni, errori, eccezioni, tempo risparmiato e impatto sulle code di lavoro.
OpenAI sta quindi spostando la propria offerta sanitaria dalla risposta testuale all’azione coordinata fra applicazioni. I casi di CVS e Cigna mostrano attività già avviate o in produzione secondo le aziende; le valutazioni interne indicano miglioramenti su alcuni compiti. Ma le prove indipendenti sui workflow completi segnalano che gli agenti possono ancora perdere informazioni nei passaggi tra sistemi.
Per le strutture sanitarie, il valore dipenderà dalla capacità di verificare ogni fase, mantenere la responsabilità professionale e dimostrare che il tempo liberato dall’automazione si traduce in assistenza più tempestiva.




Partecipa alla community