


Un chatbot può descrivere con ordine quello che una persona racconta, distinguere il suo punto di vista da quello di un’altra e collegare emozioni, pensieri e comportamenti. Questa abilità può sembrare comprensione emotiva. Uno studio pubblicato su JMIR AI mostra però che la coerenza di queste risposte si può osservare e valutare come una proprietà del linguaggio, senza scambiarla per un’esperienza interiore della macchina.
Il gruppo guidato da Stefano Epifani, della Fondazione per la Sostenibilità Digitale e della Sapienza Università di Roma, ha esaminato 50 dialoghi in italiano condotti con GPT‑4.1. Cinque psichiatri formati nella terapia basata sulla mentalizzazione hanno giudicato i profili prodotti dal modello. I risultati, con punteggi medi tra 3,63 e 3,98 su cinque, indicano una struttura riflessiva riconoscibile; non misurano diagnosi, miglioramento dei pazienti o efficacia terapeutica.
Gli autori (Stefano Epifani, MSc; Giuliano Castigliego , MSc; Giuliano Razzicchia , MSc; Elisabeth Seiwald-Sonderegger , MSc; Laura Kecskeméti , MSc) chiamano questa capacità riflessività algoritmica: l’organizzazione del discorso imita alcune forme con cui le persone ragionano sugli stati mentali. La distinzione conta per chi progetta strumenti per la salute, la formazione e la ricerca: un testo persuasivo può aiutare a osservare come si parla di emozioni, ma non basta a dimostrare che il sistema comprenda chi le prova.
Coerenza valutativa media dei profili generati da GPT‑4.1
Indice degli argomenti:
Che cosa misura la mentalizzazione
La mentalizzazione è la capacità di interpretare i comportamenti propri e altrui considerando pensieri, intenzioni, convinzioni ed emozioni. In psicoterapia aiuta a dare un senso alle reazioni: una persona può chiedersi che cosa abbia provato, quale evento abbia contribuito a quella sensazione e come abbia interpretato il comportamento di chi le stava vicino. Il linguaggio rende osservabile questo ragionamento, ma nella persona nasce da una storia e da un’esperienza vissuta.
Gli autori hanno scelto di studiare la forma linguistica della riflessione, non di stabilire se il modello possieda una mente. GPT‑4.1 è stato configurato per condurre un’intervista orientata alla mentalizzazione. Il sistema proponeva domande a partire da una breve storia e, al termine dello scambio, organizzava le risposte in un profilo narrativo. Il compito chiedeva al modello di collegare il racconto a sei dimensioni: quattro assi della terapia basata sulla mentalizzazione, le funzioni regolative e una sintesi complessiva.
I quattro assi distinguono coppie di aspetti intrecciati nel ragionamento umano: quanto pesa la componente affettiva rispetto a quella cognitiva; come si collegano mondo interno ed eventi esterni; come si separano il punto di vista di sé e quello altrui; e quanto i significati impliciti vengono resi espliciti. Le due dimensioni aggiuntive chiedono se il profilo descriva processi di regolazione emotiva e se riesca a riunire le informazioni in una sintesi. Così la valutazione non si limita a chiedere se il testo “suona bene”, ma verifica che cosa il modello riesca a organizzare nel racconto.
Il disegno dello studio: 50 dialoghi e cinque psichiatri
Quindici persone adulte, reclutate con un campionamento di convenienza e senza selezione clinica, hanno risposto alle domande in 50 dialoghi. Ogni partecipante ha contribuito in media a tre conversazioni. Il gruppo ha usato 20 storie generate dal modello e valutate da psichiatri per plausibilità e coerenza tematica. Tutte le interazioni si sono svolte in italiano; i cinque valutatori avevano oltre dieci anni di esperienza e formazione nella terapia basata sulla mentalizzazione.
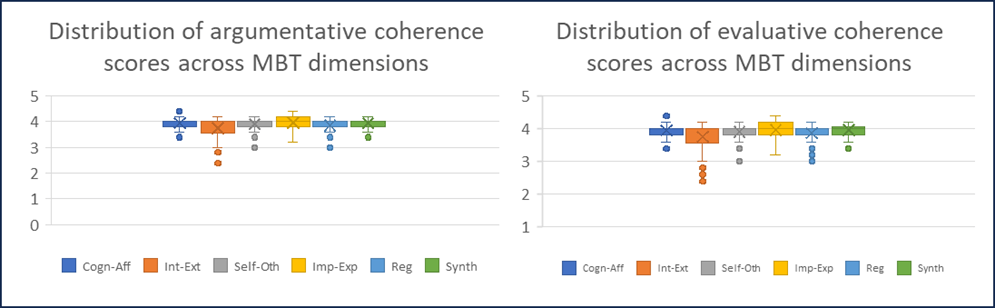
Ogni psichiatra ha assegnato due punteggi da uno a cinque per ciascuna dimensione: quanto il profilo corrispondesse alla propria lettura clinica del dialogo e quanto il ragionamento apparisse coerente e fondato. In una condizione di controllo, i ricercatori hanno abbinato alcuni dialoghi a profili prodotti per conversazioni diverse. In quei casi le valutazioni di coerenza sono scese a uno o due, segno che gli esperti non premiavano soltanto una prosa ben costruita: contava anche la corrispondenza con le risposte della persona.
Tre dei cinque valutatori erano coautori del paper. Gli psichiatri hanno giudicato i testi in forma anonima e non sapevano che i profili fossero generati dall’AI, ma il gruppo non ha verificato formalmente se qualcuno ne avesse intuito la provenienza dallo stile. Questo dettaglio non annulla i risultati; delimita quanto si può concludere da una valutazione condotta da un gruppo ristretto di specialisti legati anche alla ricerca.
La media dei punteggi di coerenza valutativa varia da 3,63 a 3,98 su cinque. Le valutazioni più alte riguardano l’asse implicito-esplicito e il profilo sintetico; quella più bassa l’integrazione tra mondo interno e contesto esterno. Il 76% dei 2.500 giudizi raccolti è pari o superiore a quattro, mentre circa il 4% è pari o inferiore a due.
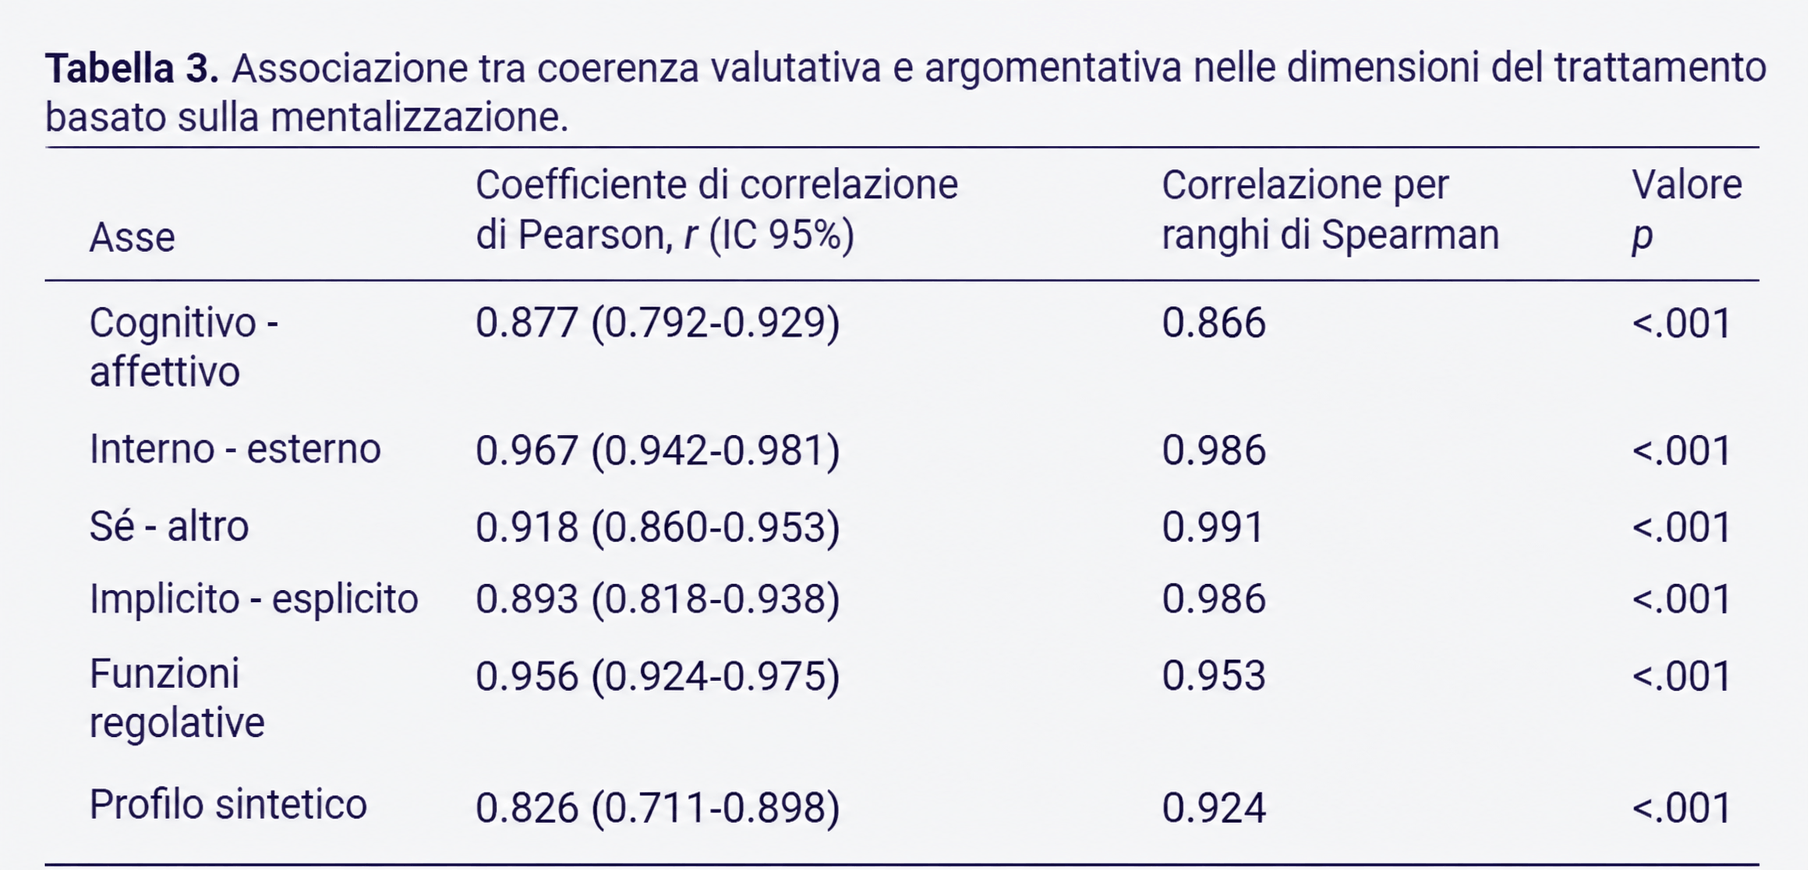
L’accordo tra valutatori, calcolato sulle medie dei cinque esperti, va da moderato a buono nelle dimensioni valutative, con coefficienti compresi fra 0,60 e 0,84.
Dove il linguaggio funziona e dove perde contesto
Gli esperti hanno riconosciuto al modello una buona capacità di rendere espliciti i nessi tra emozioni, pensieri e azioni e di distinguere il punto di vista della persona da quello degli altri. Nei profili, formule come “potrebbe pensare” o “l’altra persona forse prova” organizzano una scena sociale in modo chiaro. La sintesi finale integra elementi diversi in un testo leggibile e stabile.
Il limite emerge quando il profilo deve legare esperienza e contesto. In quella dimensione il punteggio medio scende a 3,63 e le valutazioni variano di più. I clinici hanno osservato che il modello tende a descrivere stato d’animo e contesto uno accanto all’altro, senza ricostruire sempre la relazione dinamica tra i due: che cosa, nella situazione, possa aver provocato una reazione e come questa abbia modificato il rapporto con gli altri.
Anche le emozioni possono apparire ordinate e comprensibili, ma con una gamma affettiva ridotta. Le osservazioni qualitative dei medici segnalano passaggi talvolta lineari, prescrittivi o troppo strutturati. Gli autori precisano che queste impressioni provengono dai commenti liberi dei valutatori e non da una codifica qualitativa formale: sono quindi indicazioni esplorative, da verificare con studi progettati appositamente.
Perché una risposta empatica non equivale a una terapia
Un linguaggio attento può dare a chi conversa l’impressione di essere ascoltato. La ricerca distingue questa pseudoempatia percepita dalla riflessività algoritmica: la prima riguarda l’effetto relazionale sull’utente, la seconda la struttura del testo prodotto. Una risposta può sembrare sintonizzata e tuttavia non poggiare su esperienza, intenzioni o sensibilità emotiva da parte del sistema.
La distinzione conta quando si progettano chatbot per la salute mentale. Un modello che riformula un racconto o propone collegamenti tra eventi e stati d’animo può sembrare autorevole proprio perché scrive in modo fluido. Se conferma senza verifica un’interpretazione rigida o distorta, la stessa capacità di adattarsi al discorso dell’utente può rafforzare convinzioni dannose. Gli autori richiamano perciò il rischio di compiacenza dei modelli e indicano la supervisione professionale come condizione da studiare nei possibili usi clinici.
Il lavoro non ha coinvolto pazienti né attività terapeutiche: i partecipanti hanno risposto a stimoli strutturati per una ricerca non clinica, senza test psicologici o diagnosi. I punteggi dicono che cinque psichiatri hanno riconosciuto coerenza in profili generati da GPT‑4.1; non dimostrano un beneficio per i pazienti, capacità diagnostica o efficacia di un trattamento. Il modello non è stato confrontato con profili scritti da terapeuti, quindi lo studio non stabilisce equivalenza tra macchina e professionista.
Che cosa serve per passare dalla ricerca all’uso
Il valore più immediato dello studio è metodologico. Se alcuni aspetti della mentalizzazione si manifestano in regolarità linguistiche, un modello può diventare un oggetto sperimentale per analizzare come si costruiscono narrazioni riflessive. Può offrire varianti controllate a ricercatori e formatori, o aiutare a osservare quali passaggi rendono un profilo più leggibile. Sono ipotesi di ricerca e formazione, non applicazioni già validate dalla sperimentazione.
Per capire se questi strumenti possano sostenere il lavoro clinico serviranno confronti diretti con profili scritti da professionisti, campioni più ampi e diversificati e test in contesti più vicini alla pratica. I ricercatori indicano inoltre la necessità di osservare interazioni più lunghe e situazioni emotivamente intense, nelle quali il ragionamento può diventare frammentario o ambivalente. È in questi passaggi che si potrà capire se la struttura formale regge quando il racconto si fa più complesso.
Pubblicato il 20 ottobre 2026, lo studio propone un criterio utile per leggere le capacità dei modelli: valutare che cosa fanno con le parole senza attribuire loro, sulla base della sola fluidità, processi psicologici che la ricerca non ha misurato. La riflessività algoritmica descrive una somiglianza di forma, circoscritta e verificabile.
Per impieghi che toccano la salute mentale, la distanza tra un testo ben formato e una relazione terapeutica resta una questione da dimostrare con prove cliniche, non da dedurre dal tono della conversazione.



Partecipa alla community