


Google ha presentato un modello AI capace di individuare vulnerabilità nel software, verificare se si possono sfruttare e proporre correzioni. Si chiama Gemini 4 Carbon, è stato annunciato il 28 ottobre 2026 e, secondo le prove pubblicate dall’azienda, raggiunge l’88,2% nella ricerca delle falle, il 54,8% nei test di sfruttamento e il 71% nella generazione di patch.
Per un’impresa, la prospettiva è ridurre il tempo che passa dalla scoperta di un problema alla sua correzione, uno dei colli di bottiglia più costosi della sicurezza applicativa.
Google, però, ha scelto di distribuire inizialmente Carbon soltanto a un gruppo selezionato di difensori. La disponibilità generale è rimandata. E la concorrenza è già operativa su parte dello stesso processo: OpenAI offre Codex Security e l’ecosistema Daybreak, Anthropic ha aperto Claude Code Security a un gruppo limitato di clienti aziendali e permette verifiche di sicurezza anche nel normale Claude Code. Il mercato sta quindi passando dai semplici assistenti che suggeriscono codice agli agenti capaci di svolgere indagini tecniche e preparare modifiche verificabili.
La domanda per chi dirige IT e sviluppo cambia di conseguenza: quali vulnerabilità riesce davvero a chiudere un sistema, quanto lavoro lascia agli specialisti e a quali condizioni può analizzare il codice dell’azienda? I punteggi dei modelli sono un’indicazione di potenza; le risposte dipendono anche da integrazione, controlli, costi e disponibilità.
Indice degli argomenti:
Gemini 4 Carbon: cosa può fare il nuovo modello di Google
Il comunicato ufficiale di Google DeepMind descrive tre capacità lungo la stessa sequenza di lavoro. Un agente deve prima leggere componenti e dipendenze di un’applicazione per individuare il punto vulnerabile; poi tentare, in un ambiente autorizzato e controllato, di riprodurre il comportamento pericoloso; infine modificare il codice e verificare che la correzione funzioni senza rompere le altre funzioni del software. L’ultima fase è essenziale: un rapporto su una falla, anche molto accurato, da solo non protegge il sistema.
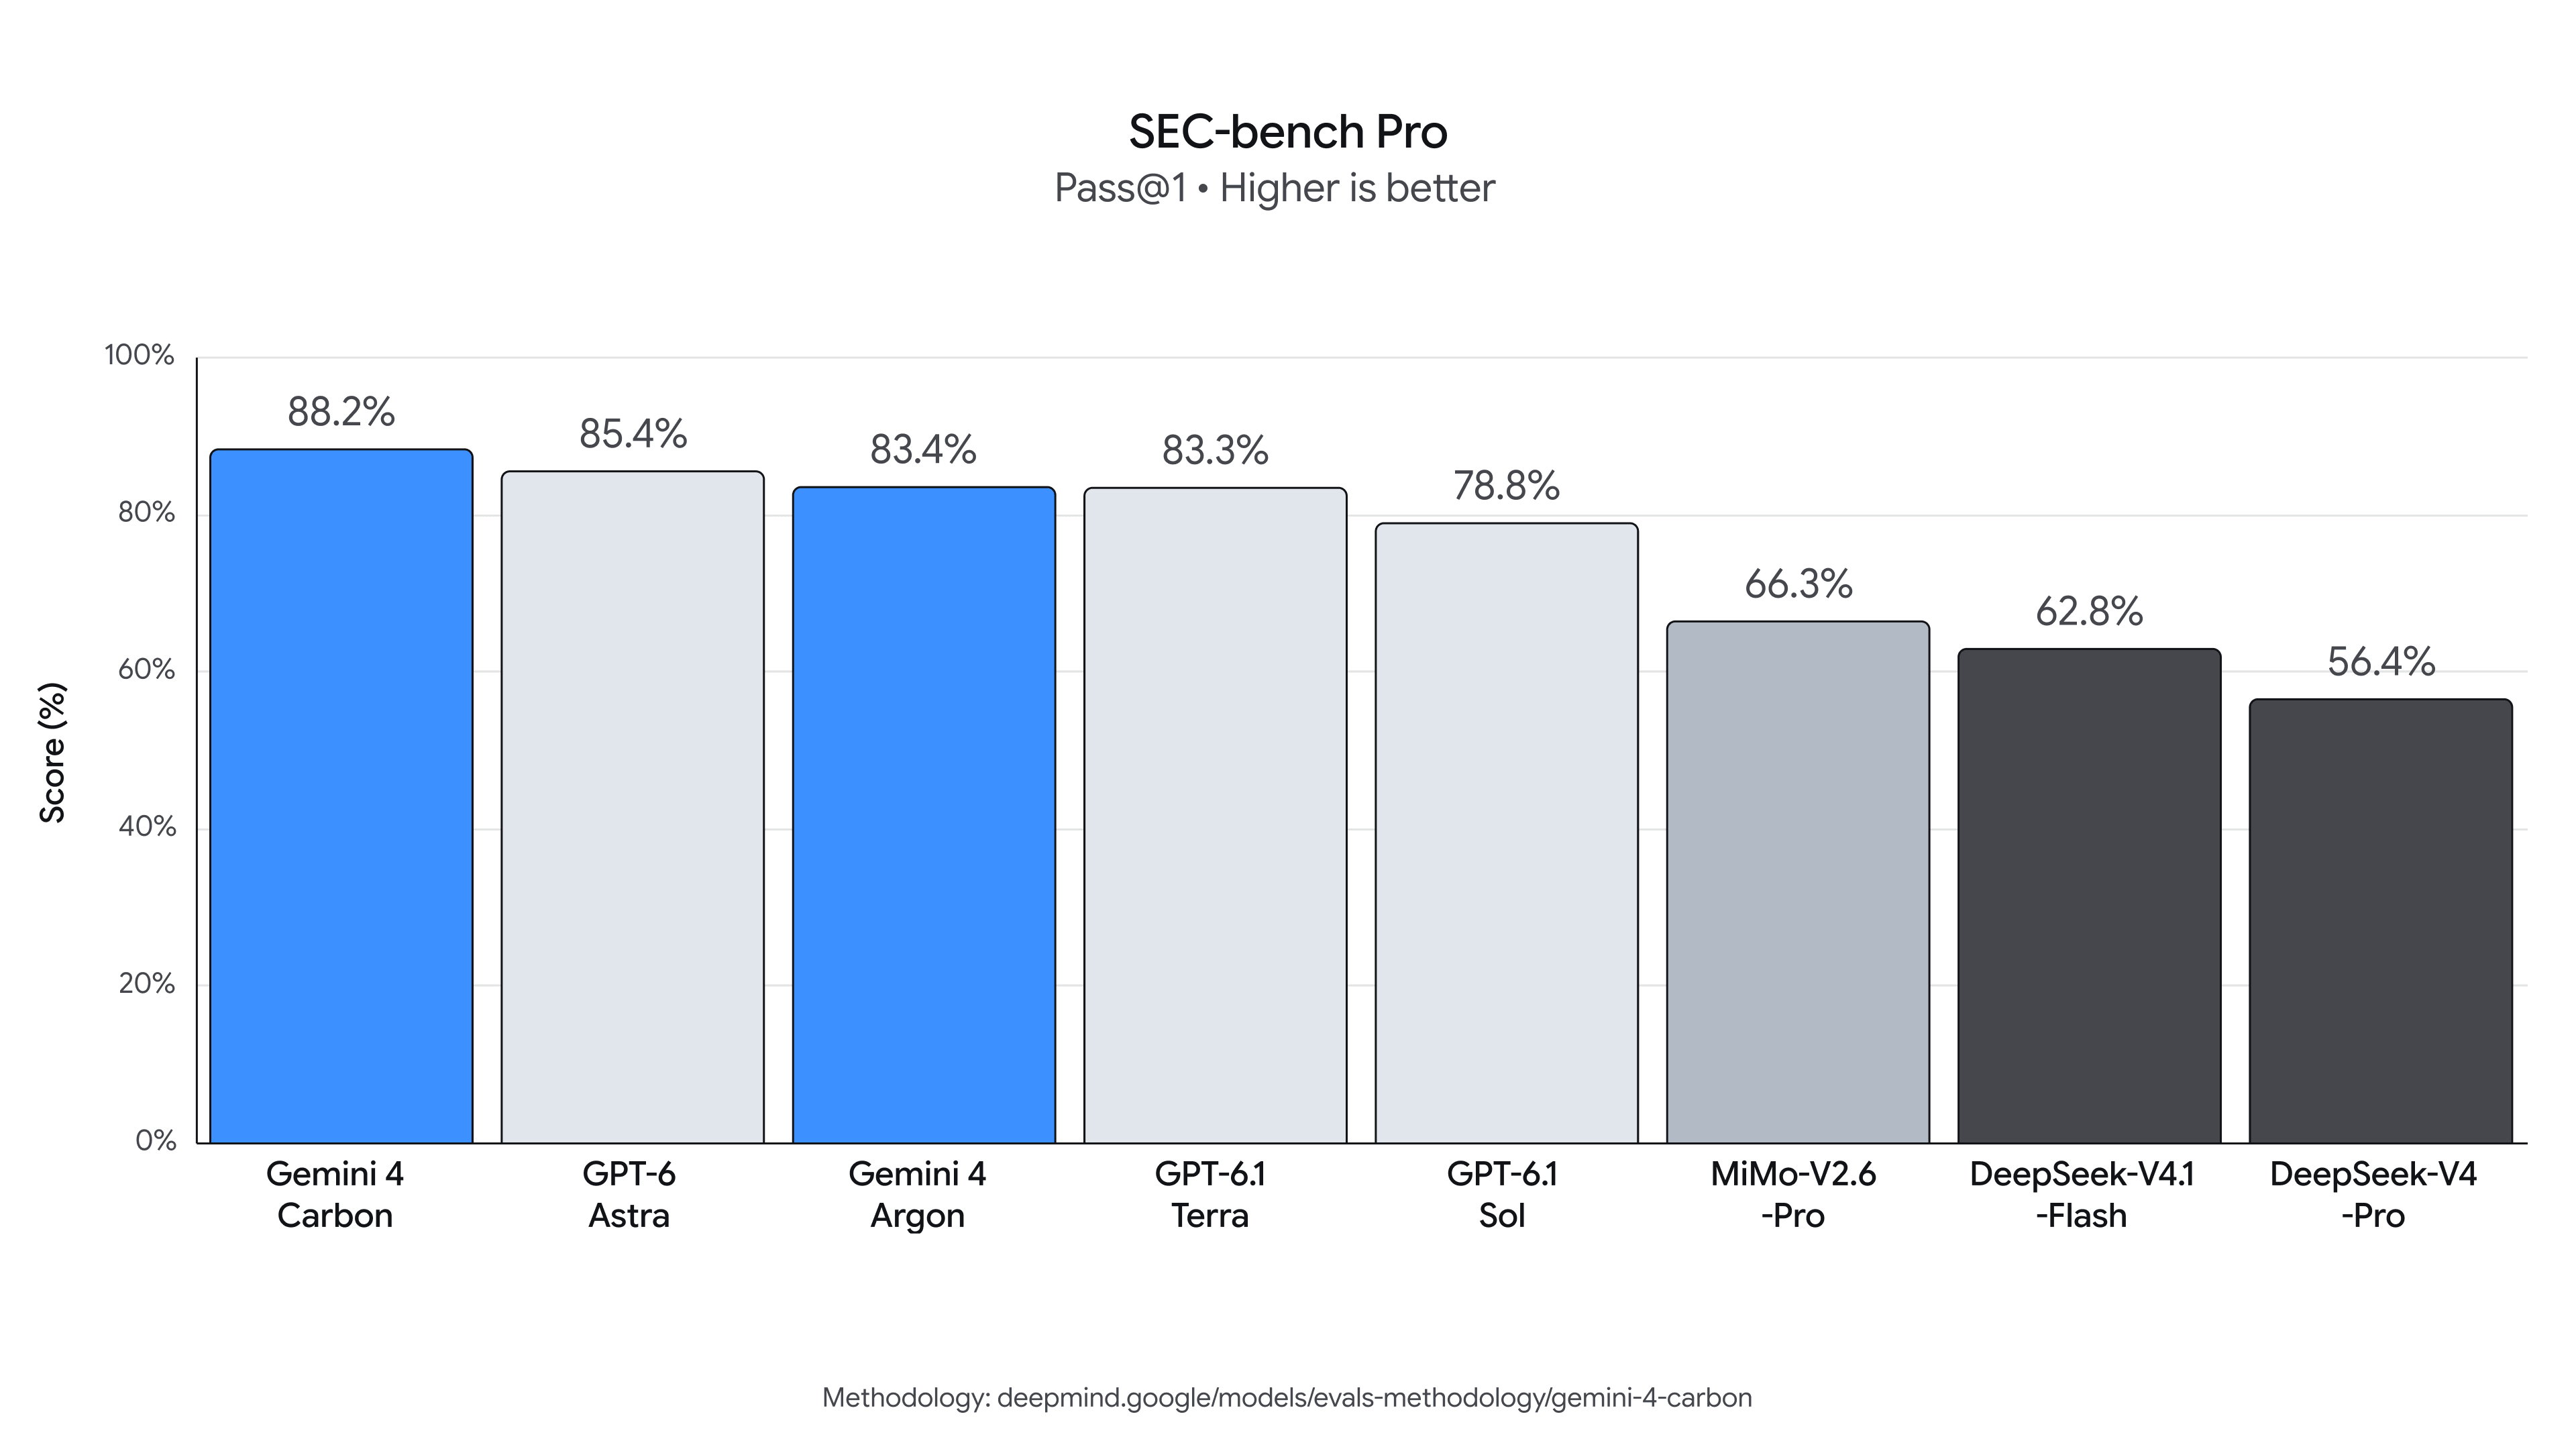
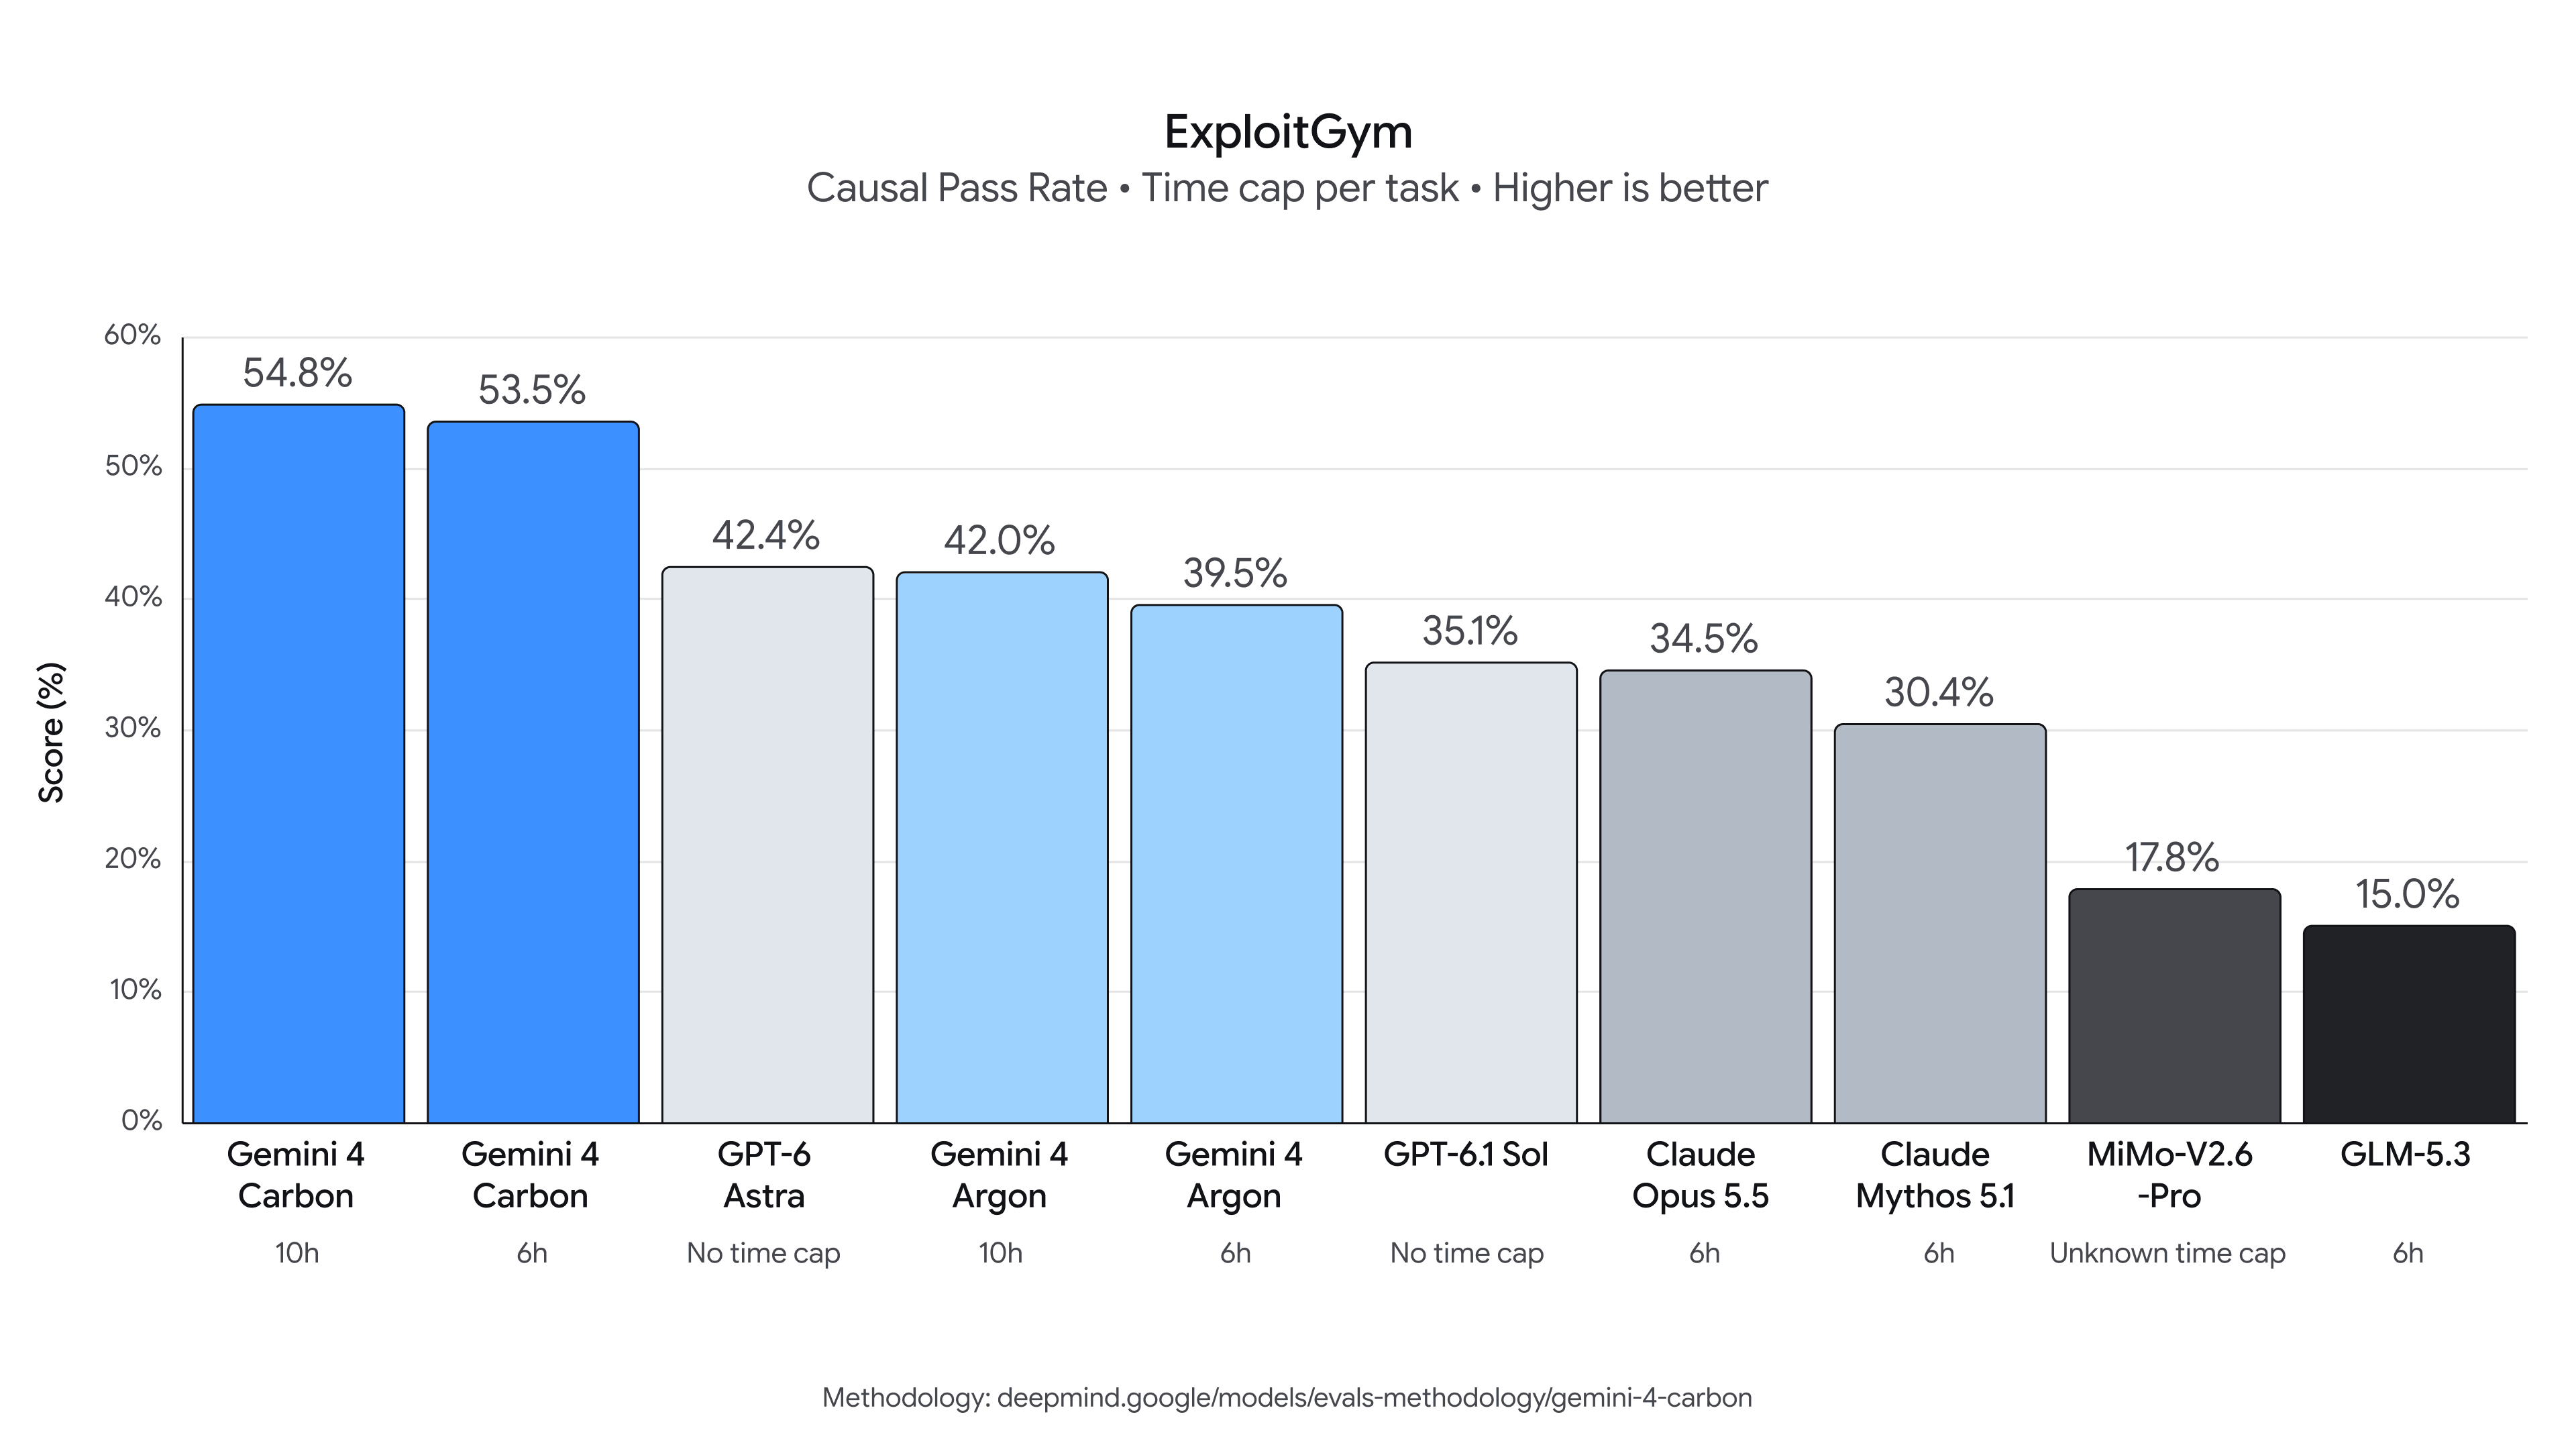
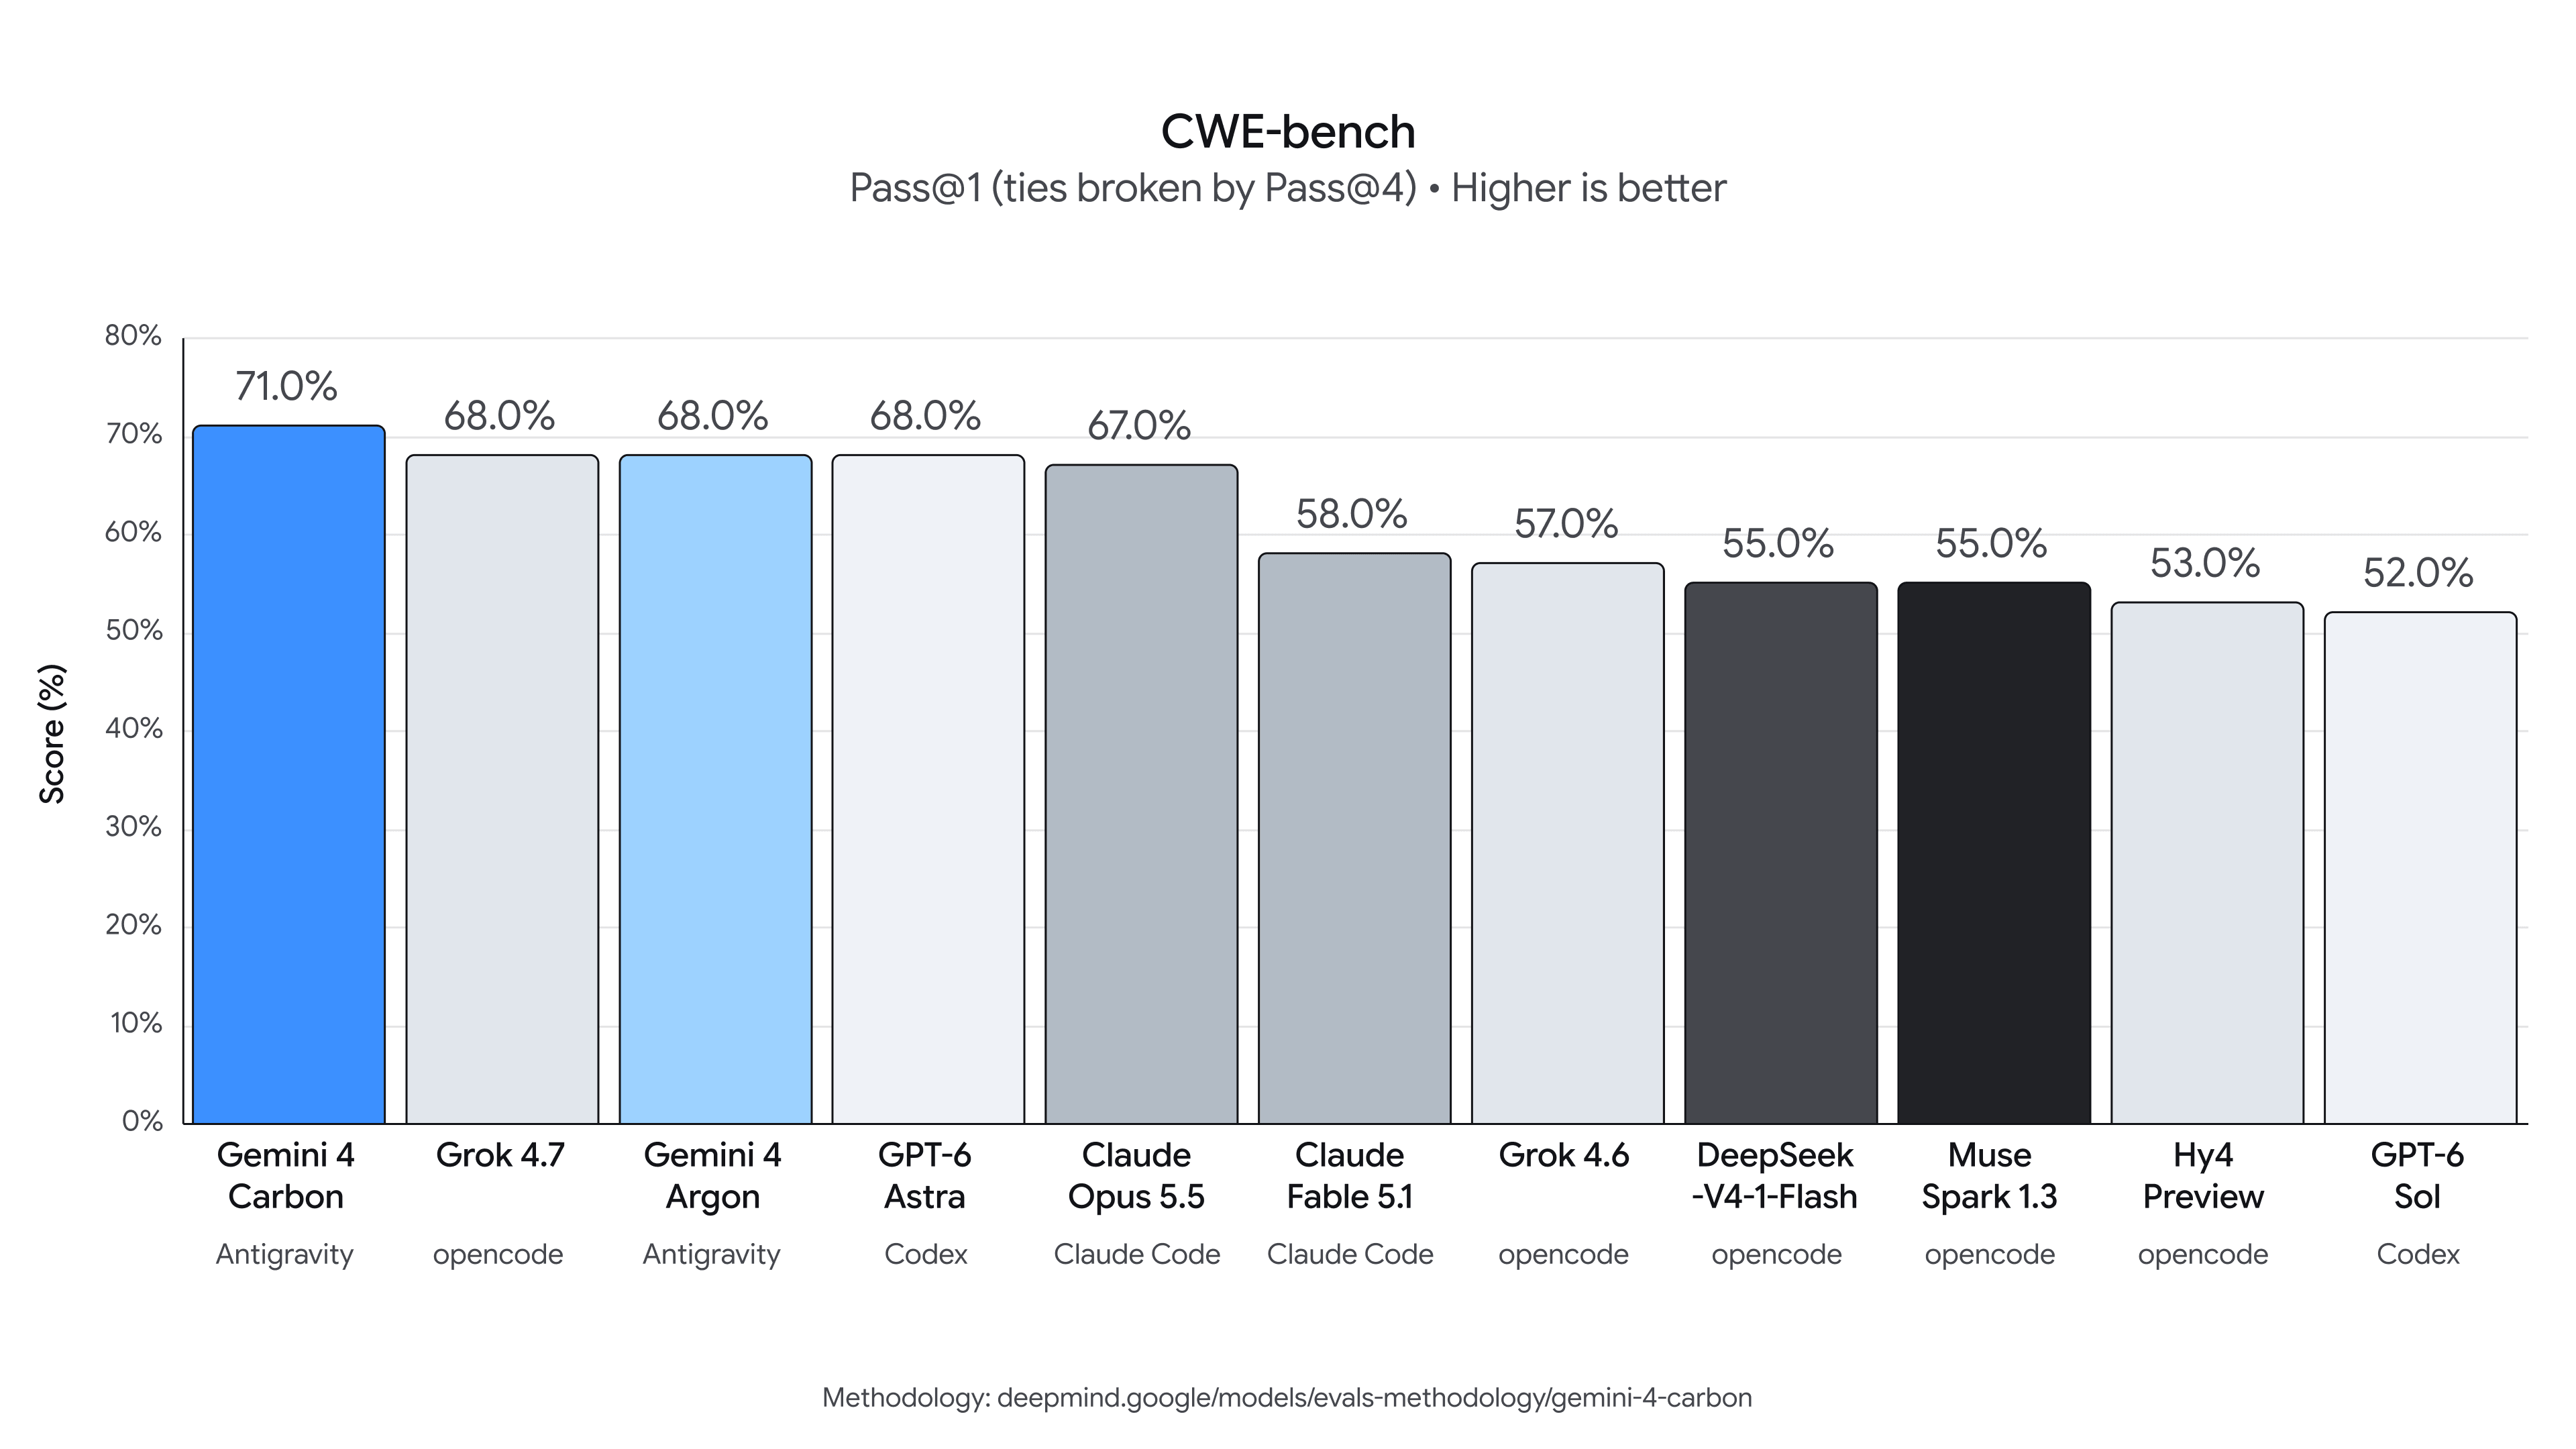
Carbon ottiene l’88,2% su SEC-bench Pro, dedicato alla ricerca di vulnerabilità complesse, il 54,8% su ExploitGym, che mette alla prova la possibilità di costruire exploit nei contesti del benchmark, e il 71% su CWE-bench, dedicato alla correzione di bug.
Rispetto a Gemini 4 Argon il salto maggiore riguarda lo sfruttamento: dal 42 al 54,8%, 12,8 punti percentuali in più. Google riferisce inoltre di aver utilizzato Carbon per attività di ingegneria software prolungate anche per giorni, affrontando problemi e tentativi falliti lungo codebase estese.
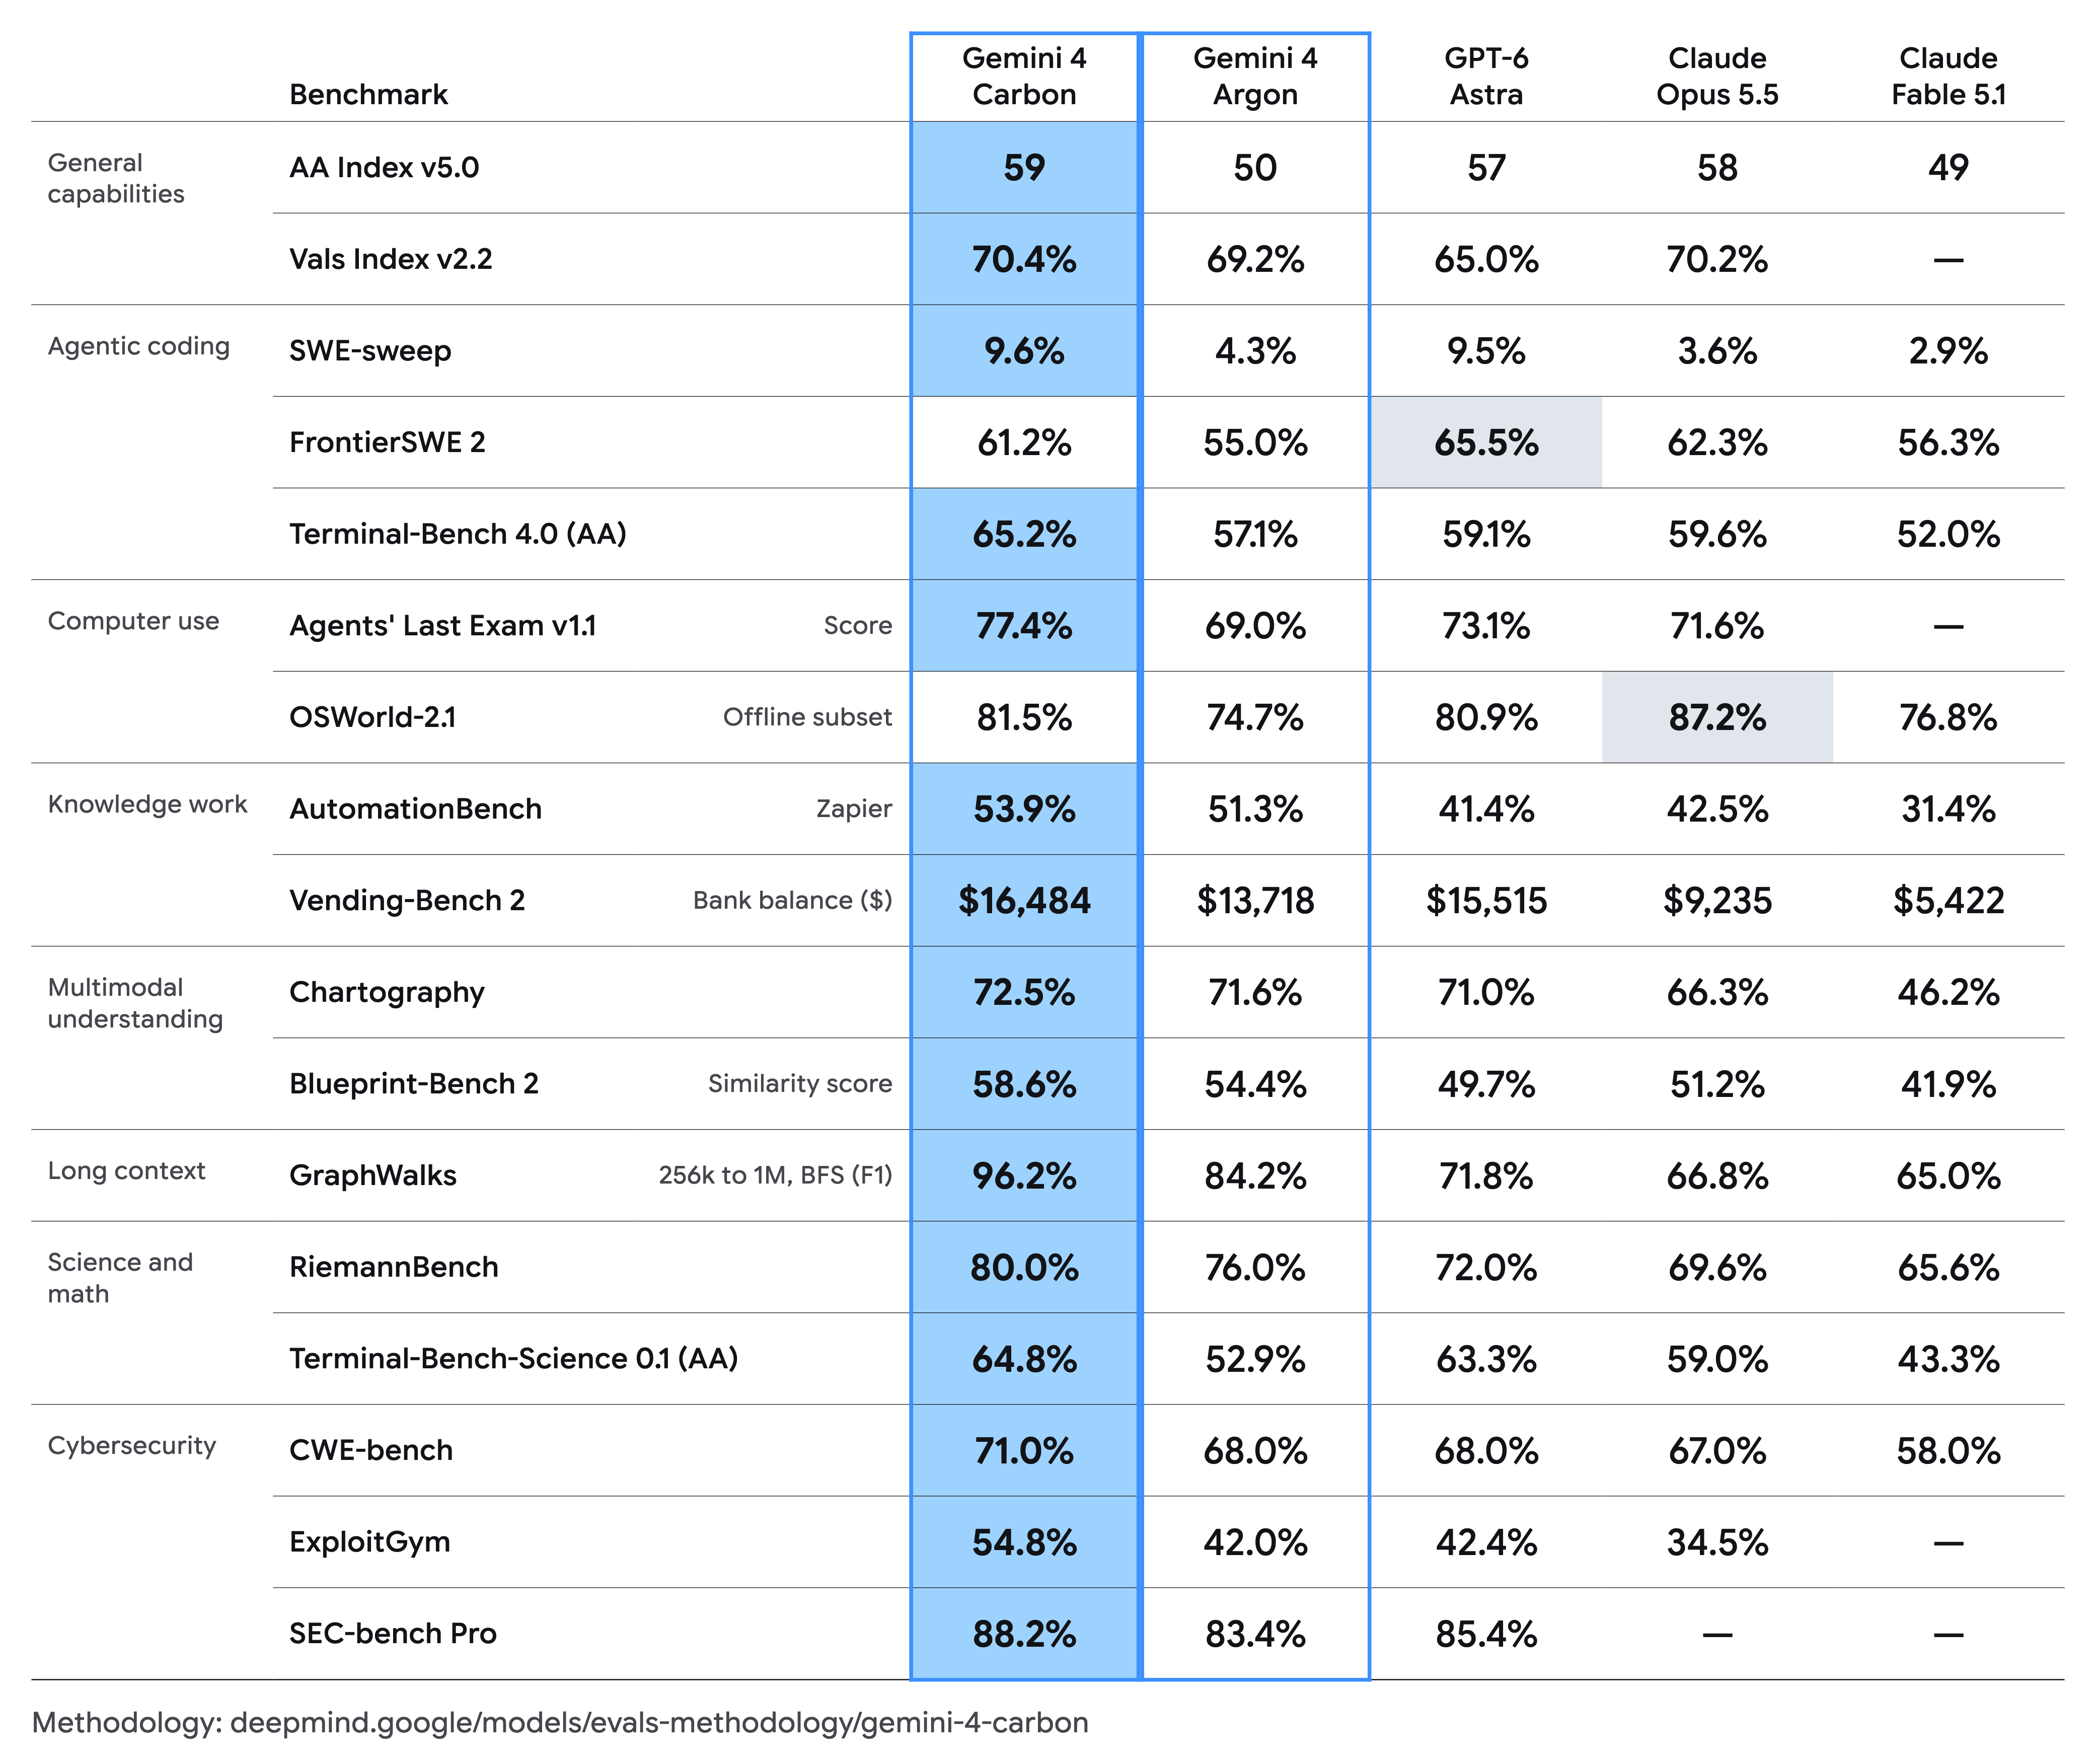
Per leggere le cifre è importante considerare come sono state ottenute. I test cyber sono stati eseguiti senza i normali guardrail del modello e i confronti di settore provengono dalla documentazione delle aziende, con protocolli che possono differire. I tre benchmark misurano attività diverse; nessuna di queste percentuali indica la quota di vulnerabilità che un cliente risolverà nel proprio ambiente di produzione.
Una valutazione indipendente dà comunque un’indicazione della qualità generale. Artificial Analysis ha assegnato a Carbon 59 punti sull’Intelligence Index 5.0, mettendolo al primo posto nell’edizione del 28 ottobre. Nell’indice specifico degli agenti di programmazione, invece, Claude Opus 5.5 rimane avanti con 62 punti, contro 59 di Carbon. È una ragione in più per misurare un sistema sul proprio lavoro anziché attribuirgli un primato universale.
OpenAI e Anthropic: il confronto tra i prodotti disponibili
La prima differenza tra i tre fornitori riguarda il tipo di offerta. Carbon è un modello di frontiera che Google sta portando a un numero inizialmente ristretto di specialisti. Gli altri due concorrenti hanno invece già costruito strumenti orientati al flusso operativo dei team aziendali, dall’analisi dei repository alla proposta di patch. È una distinzione centrale per chi vuole avviare subito un progetto.
Google, OpenAI e Anthropic: strumenti, attività e disponibilità
| Strumento | Cosa offre ai team | Stato e accesso |
|---|---|---|
| Google Gemini 4 Carbon | Modello avanzato per individuare falle, verificare la loro sfruttabilità e proporre patch, da integrare in workflow aziendali. | Accesso iniziale a difensori selezionati; estensione tramite Fairwind. API generali e applicazioni per imprese ancora da aprire. |
| OpenAI Codex Security e Daybreak | Agente Codex per repository e commit, validazione in sandbox, patch da revisionare. Daybreak estende le capacità a operazioni difensive più ampie. | Codex Security in research preview per utenti Pro, Business, Enterprise ed Edu; Daybreak avanzato attraverso verifiche per difensori autorizzati. |
| Anthropic Claude Code Security | Analisi contestuale del codice, verifiche dei risultati, classificazione dei problemi e proposte di patch da approvare. | Anteprima limitata su Claude Code web per clienti Team ed Enterprise; /security-review di Claude Code è disponibile più ampiamente. |
Fonti: Google, 28 ottobre 2026; OpenAI, guida Codex Security e Daybreak; Anthropic e guida Claude Code. Disponibilità verificata al 29 ottobre 2026.
Le diverse condizioni di accesso impongono anche un confronto economico prudente. Google ha annunciato per Carbon un listino iniziale di 2 dollari per milione di token in ingresso e 10 in uscita, destinato a salire a 4 e 20 dollari dopo la promozione. La cache in lettura prevede uno sconto del 95% sul prezzo dei token in ingresso. Il prezzo di una chiamata al modello, però, copre soltanto una parte del lavoro di un agente: test ripetuti, ambienti isolati, strumenti e revisione umana incidono sul costo finale.
Codex Security utilizza fatturazione basata sui token, con attivazione esplicita dell’uso a pagamento per i clienti interessati; Claude Code Security non ha un listino pubblico direttamente comparabile per la funzione in anteprima limitata. Una gara basata soltanto sui prezzi per milione di token rischierebbe dunque di confrontare oggetti diversi: un modello, una piattaforma di sicurezza e una funzionalità integrata in un ambiente di sviluppo.
OpenAI: Codex Security collega l’analisi del codice alla correzione
OpenAI ha introdotto Codex Security il 6 marzo 2026, dopo una fase sperimentale con il nome Aardvark. Lo strumento si connette ai repository GitHub e ricostruisce un modello delle minacce specifico del software: quali componenti ricevono dati esterni, quali autorizzazioni sono previste e dove potrebbero esistere percorsi di accesso pericolosi. Questa mappa è visibile e modificabile dai responsabili tecnici, che possono correggere le ipotesi dell’agente.
Su quella base Codex Security analizza il codice e le modifiche recenti, approfondisce i difetti potenzialmente più pericolosi e, quando possibile, cerca di riprodurli in una sandbox. Se la vulnerabilità risulta confermata, propone una patch con le informazioni necessarie a valutarla. La modifica viene sottoposta alla normale revisione del team e può diventare una pull request; il prodotto non interviene automaticamente sui sistemi produttivi.
La guida operativa di Codex Security specifica che la funzione è in research preview per utenti ChatGPT Pro, Business, Enterprise ed Edu, con requisiti di autorizzazione amministrativa negli ambienti aziendali.
OpenAI sostiene che, negli ultimi trenta giorni della fase beta descritta a marzo, lo strumento abbia analizzato oltre 1,2 milioni di commit in repository esterni, segnalando 792 problemi critici e 10.561 di gravità alta. Il dato misura il lavoro svolto in quel gruppo di progetti e viene dal produttore: per capire il valore in una singola impresa servono il tasso di falsi positivi, le correzioni accettate e soprattutto il tempo fino all’installazione delle patch.
Attorno a Codex Security OpenAI sta costruendo anche Daybreak, una piattaforma più ampia che integra modelli specializzati, inventario, scoperta, verifica, assegnazione ai responsabili e remediation. Le capacità più avanzate di ricerca e validazione offensiva sono sottoposte a controlli di accesso per professionisti della difesa verificati.
Per un’impresa questa architettura può collegare il team AppSec a chi gestisce gli incidenti e a chi rilascia gli aggiornamenti, evitando che le vulnerabilità individuate rimangano segnalazioni senza un proprietario.
Anthropic: Claude Code Security e la dimostrazione dei cinque attacchi
Anthropic ha presentato Claude Code Security il 20 febbraio 2026 come funzione di Claude Code sul web. Legge il repository cercando difetti che richiedono di capire il comportamento del programma, come autorizzazioni incoerenti tra servizi e passaggi di dati rischiosi. Ogni risultato passa attraverso ulteriori verifiche; l’interfaccia presenta criticità, livello di confidenza e correzioni suggerite, che il responsabile deve approvare.
Il servizio è stato annunciato in anteprima limitata per clienti Team ed Enterprise, con percorso di accesso dedicato per alcuni manutentori open source. Le funzioni più semplici di revisione di sicurezza di Claude Code, disponibili tramite il comando /security-review o GitHub Actions, hanno invece una platea più ampia. Conviene distinguere i due livelli: l’esistenza della revisione ordinaria non implica l’accesso generalizzato alla versione avanzata del servizio.
La ricerca di Anthropic è arrivata nel frattempo a capacità ancora più aggressive. Il 27 ottobre il suo Frontier Red Team ha pubblicato cinque catene di attacco sviluppate da un modello Claude interno e non distribuito, che interessavano Chrome, Safari, Android, Windows e Linux. Su Chrome il modello ha combinato vulnerabilità fino a uscire dalla sandbox del browser e ottenere esecuzione di codice; su Safari ha aggirato l’isolamento tra siti.
Le falle descritte sono state segnalate ai produttori e corrette secondo la procedura di divulgazione coordinata.
Quelle dimostrazioni non sono funzioni disponibili ai clienti di Claude Code Security. Servono però a comprendere perché Google, OpenAI e Anthropic riservino alcune capacità ai difensori verificati: quando un agente può provare autonomamente sequenze di exploit, la stessa tecnologia che aiuta a correggere il software può ridurre i tempi necessari per attaccarlo.
Dove l’AI produce già risultati aziendali misurabili
Per valutare i benefici servono esperienze di produzione, oltre ai laboratori. Block, la società di Square, Cash App e Afterpay, ha descritto a OpenAI il proprio uso di Codex e Daybreak per un sistema interno di difesa. In esercitazioni di red teaming, secondo l’azienda, il tempo fra una descrizione ad alto livello della vulnerabilità e una proposta automatica di patch è sceso a 18 minuti.
Block riporta anche l’equivalente di circa 1.100 ore di indagine degli analisti svolte ogni trimestre dai sistemi AI.
Il primo dato riguarda il tempo di produzione di una patch proposta, che deve ancora essere verificata, accettata e distribuita. Il secondo è una stima aziendale del lavoro svolto dagli agenti, non un numero di ore di personale licenziato o una misura di risparmio di bilancio. Entrambi, tuttavia, mostrano quali variabili comincino a essere osservabili: velocità di analisi, capacità di trattare le segnalazioni e spazio restituito agli esperti per i problemi complessi.
Per tradurre questi risultati in un progetto italiano, conviene partire da repository autorizzati e rappresentativi, comprendenti sia codice nuovo sia componenti legacy. Il test dovrebbe confrontare l’agente con la situazione precedente su vulnerabilità effettivamente confermate, falsi positivi, ore umane necessarie, patch accettate e tempo fino al rilascio. È quest’ultimo indicatore a dire se la maggiore capacità di ricerca abbia davvero ridotto il periodo in cui l’azienda è esposta.
La scelta per le imprese: permessi, dati e responsabilità delle patch
L’agente ha bisogno di accedere a codice, dipendenze e talvolta configurazioni molto sensibili. Prima di collegarlo ai repository, il responsabile tecnico deve valutare con il fornitore quali dati vengano trattati, dove passino e per quanto tempo restino disponibili, insieme ai permessi effettivamente concessi e ai vincoli contrattuali. La compatibilità con una data organizzazione dipende da questi dettagli, oltre che da prezzo e benchmark.
Serve inoltre separare i contesti di analisi dai sistemi in produzione. La riproduzione di una vulnerabilità deve avvenire entro perimetri autorizzati e isolati; le modifiche suggerite vanno sottoposte a review, test di regressione e approvazione. Un modello può produrre una patch che supera un test e contemporaneamente introduca un nuovo errore funzionale o di sicurezza. Anche istruzioni malevole inserite nei file letti dall’agente, le cosiddette prompt injection, vanno considerate nella progettazione del flusso.
In definitiva, la presentazione di Gemini 4 Carbon accelera la competizione tra tre strategie: Google sviluppa un modello di frontiera con capacità cyber molto elevate, OpenAI costruisce una piattaforma di difesa continua attorno a Codex, Anthropic porta la revisione contestuale dentro l’ambiente di sviluppo. Per le imprese il vantaggio emergerà quando scoperta, verifica e correzione formeranno un processo misurabile e governato, capace di chiudere più rapidamente le vulnerabilità senza trasferire decisioni critiche a un agente privo di supervisione.




Partecipa alla community