


Secondo l’Osservatorio sull’Intelligenza Artificiale del Politecnico di Milano, nel 2025 il mercato italiano dell’AI ha raggiunto 1,8 miliardi di euro, segnando una crescita del 50% rispetto all’anno precedente. Eppure, il dato più significativo non è il volume economico in sé, ma ciò che sta accadendo sotto la superficie. Sempre secondo l’Osservatorio, i sistemi di process orchestration e di agentic AI rappresentano oggi appena il 4% del mercato, ma stanno introducendo con rapidità meccanismi di orchestrazione altamente intelligenti, fondati sui Large Language Model (LLM).
Si tratta di un salto qualitativo prima ancora che quantitativo. Questi sistemi non si limitano più a rispondere a un comando: interpretano le intenzioni, pianificano sequenze di azioni, interagiscono con strumenti esterni, eseguono codice e determinano autonomamente il passo successivo.
È l’agentic AI, e sta rivoluzionando le infrastrutture IT aziendali a un ritmo che molti decision maker faticano ancora a seguire. Le ragioni sono in larga parte strutturali: ogni fase di un flusso di lavoro “agentico” costituisce un carico di lavoro distinto, con requisiti computazionali propri e variabili. Non si tratta, quindi, di un semplice problema di scala, ma di architettura. Ed è esattamente qui che si concentrano sfide – e opportunità – per i CIO.
Indice degli argomenti:
Anatomia di un flusso di lavoro agentico: dove finisce la GPU e dove inizia la CPU
Gran parte del dibattito sull’infrastruttura dell’AI continua a gravitare attorno ai modelli e alle GPU su cui questi vengono eseguiti. Una prospettiva comprensibile, ma sempre più parziale. In pratica, i requisiti infrastrutturali dell’intelligenza artificiale sono determinati principalmente dal flusso di lavoro che circonda il modello – non dal modello in sé.
Un sistema agentico, nel concreto, non si limita a elaborare un comando: interpreta l’intento, recupera il contesto, pianifica le mosse successive, richiama strumenti esterni, applica le policy, esegue codice in ambiente sandbox, effettua transazioni e osserva i risultati. Ogni operazione presenta un profilo computazionale distinto. È proprio questa eterogeneità – e non la sola potenza di calcolo – a definire la vera complessità infrastrutturale dell’AI aziendale.
Questi profili, inoltre, sono tutt’altro che uniformi. Alcune operazioni richiedono un’elevata densità di core; altre beneficiano di frequenze di clock elevate e di una latenza prevedibile; altre ancora dipendono dalle dimensioni della memoria, dalla velocità di I/O, dalla località dei dati, dall’efficienza energetica o dalla capacità di gestire numerosi servizi in esecuzione simultanea. Nessun singolo profilo computazionale è in grado di soddisfare efficacemente tutti questi requisiti.
È per questo che, con la diffusione dell’AI agentica all’interno delle organizzazioni, i team responsabili dell’infrastruttura si trovano a dover ripensare il proprio approccio: non un processore universale, ma un portafoglio di CPU su misura per l’intero spettro dei flussi di lavoro agentici.
La famiglia AMD Epyc è progettata per rispondere a questa esigenza: non come soluzione monolitica, ma come insieme di componenti specializzati, ciascuno ottimizzato per una specifica classe di carichi di lavoro di AI agentica.
Dentro il flusso di lavoro agentico
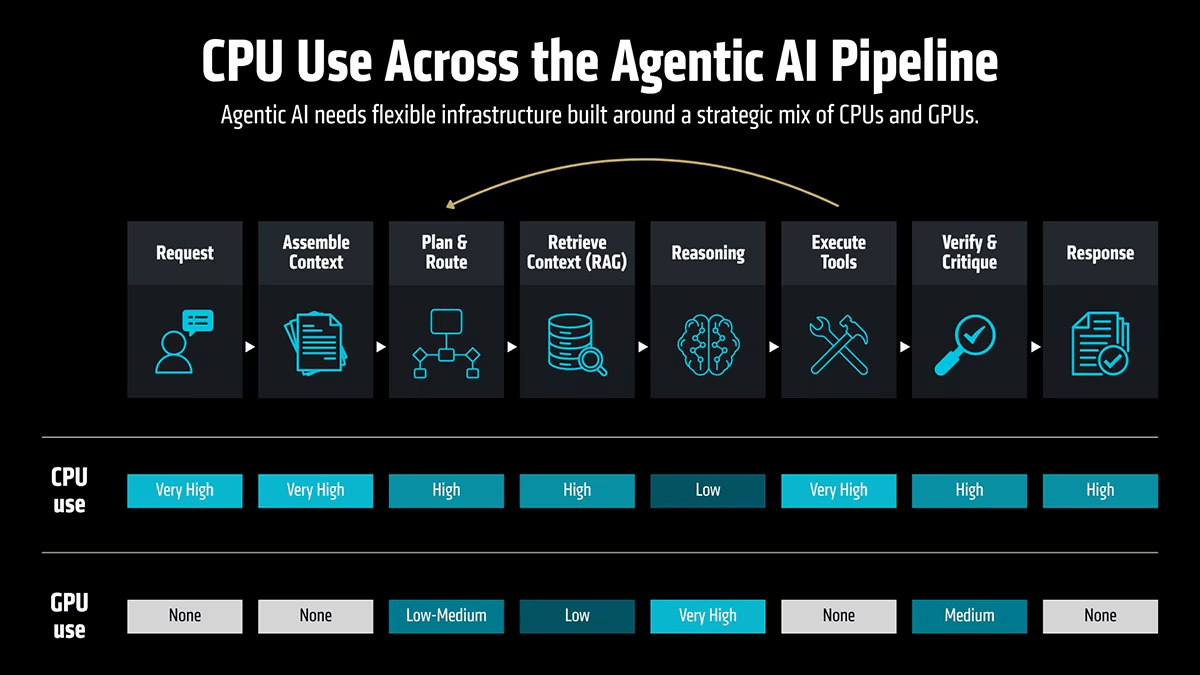
Per comprendere concretamente cosa questo implichi, vale la pena osservare da vicino i meccanismi di un flusso di lavoro agentico. Quando un agente riceve un’attività, la scompone in passaggi sequenziali – e spesso torna sui propri passi più volte prima di completarla. La richiesta transita innanzitutto attraverso un gateway dove vengono applicate le policy di sicurezza e governance.
Un livello di pianificazione, tipicamente affidato a modelli di AI più leggeri, determina come instradare l’attività. L’agente interroga quindi database e basi di conoscenza, si appoggia a un cluster di GPU per i ragionamenti più complessi, esegue gli strumenti necessari, verifica il risultato e decide autonomamente se ripetere il ciclo o procedere.
Questa sequenza evidenzia perché l’AI agentica non possa essere trattata come un unico carico di lavoro: è un processo end-to-end e deve essere gestito come tale. La giusta strategia infrastrutturale parte dalla mappatura di ciascun flusso di lavoro e dall’assegnazione delle risorse computazionali più adatte a ogni fase.
È su questo principio che AMD ha costruito il proprio posizionamento:
- CPU Epyc per il calcolo ad alta frequenza e ad alta densità di core,
- acceleratori AMD Instinct per l’inferenza e l’addestramento,
- la rete Pensando per garantire un trasporto dei dati prevedibile ed efficiente lungo l’intera pipeline.
Dove conta la latenza, dove conta il throughput – e dove contano entrambi
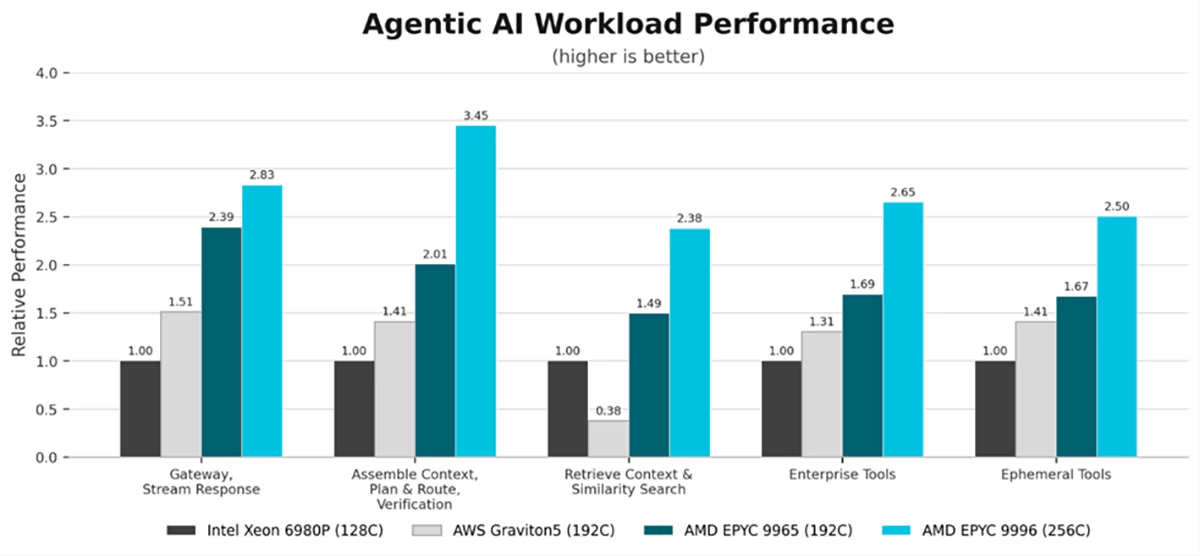
Tradurre questa visione in un’architettura concreta significa partire da un principio non negoziabile: profili di carico di lavoro diversi richiedono CPU diverse. È esattamente attorno a questa logica che abbiamo costruito la gamma AMD Epyc.
Orchestrazione degli strumenti, sandboxing ed esecuzione. Quando decine o centinaia di agenti operano in parallelo – eseguendo codice Python in sandbox, richiamando API o interrogando database – la densità dei core diventa il fattore critico, ancor più della velocità di clock. Le CPU per server AMD Epyc di quinta generazione offrono fino a 192 core e 384 thread grazie al Simultaneous Multithreading. I processori di prossima generazione, nome in codice “Venice”, porteranno queste cifre rispettivamente a 256 core e 512 thread.
Integrazione con le applicazioni aziendali. Il vero valore di un agente si misura dalla sua capacità di interagire con gli strumenti e i sistemi aziendali esistenti. Questo richiede CPU che combinino un’ampia gamma di configurazioni di core con prestazioni elevate, capaci di gestire il volume e la varietà delle richieste in entrata. La famiglia AMD Epyc 9005 offre questo equilibrio – da 8 a 192 core, con una larghezza di banda di memoria fino a 640 GB/s – mentre “Venice” porterà il numero di core e thread a 1,3 volte e la larghezza di banda di memoria a 2,5 volte rispetto alla generazione attuale.
Ragionamento e inferenza
I Large Language Model su cui gli agenti fanno affidamento per il ragionamento girano principalmente su GPU, ma la CPU del nodo host svolge un ruolo tutt’altro che marginale: deve garantire un’alimentazione costante degli acceleratori. In questo contesto, ciò che conta è la combinazione di prestazioni per core, frequenze di clock elevate e il giusto bilanciamento tra core, memoria, I/O e rete. Il processore AMD Epyc 9575F è ottimizzato per questo ruolo: 64 core con frequenze di clock fino a 5 GHz. Con “Venice”, l’offerta ad alta frequenza della famiglia Epyc si amplierà ulteriormente.
La sfida dei sistemi legacy
Le conversazioni con i clienti enterprise delineano un quadro coerente, in cui emergono regolarmente due modelli ricorrenti.
Il primo riguarda la standardizzazione. Molte organizzazioni continuano ad acquistare infrastrutture CPU sulla base di specifiche legacy: configurazioni a 16 o 32 core che hanno funzionato bene per anni. Ma i flussi di lavoro agentici richiedono qualcosa di diverso: alta densità di core per alcune fasi, frequenze di clock elevate per altre. La flessibilità di configurazione non è più facoltativa. Il cambio di mentalità necessario è quello da uno standard basato su una singola CPU a un portafoglio calibrato sull’intero flusso di lavoro agentico aziendale.
Il secondo modello è più sottile, ma potenzialmente più dirompente: l’effetto moltiplicatore. Man mano che le organizzazioni abilitano i propri dipendenti a creare e distribuire agenti, l’adozione cresce rapidamente – e con essa il carico sull’intera infrastruttura IT esistente. Database, piattaforme ERP e CRM, sistemi di business intelligence, gestione delle identità e server di inferenza diventano tutti endpoint di un ecosistema agentico in continua espansione. È una domanda che i team di pianificazione IT non possono più rimandare: cosa accadrà a questi sistemi quando i volumi di utilizzo degli agenti cresceranno in modo significativo?
Non è uno scenario futuro. In Italia, secondo una ricerca condotta da indigo.ai, il 28% delle aziende dispone già di agenti di AI per interagire con i clienti tramite chat o telefono, il 23% li utilizza per l’analisi dei dati e il 15% per supportare internamente gli operatori umani. Un ulteriore 34% prevede di implementarli entro i prossimi dodici mesi. L’infrastruttura deve essere pronta a scalare di conseguenza.
La sfida per i CIO
L’AI agentica sta ridefinendo il modo in cui le aziende scalano la propria infrastruttura, e chi la affronta con strumenti concettuali inadeguati rischia di trovarsi in posizione di svantaggio. Trattarla come un problema monolitico – affidandosi a una singola GPU o a una CPU universale – significa ignorare la natura profondamente eterogenea dei flussi di lavoro che la compongono. Chi invece pianifica un ecosistema end-to-end, riconoscendo che ogni fase presenta esigenze computazionali distinte, è nella posizione migliore per scalare in modo efficiente.
La domanda giusta, dunque, non è quante CPU o GPU servano alla vostra organizzazione per l’AI agentica. È piuttosto se la vostra infrastruttura rifletta il modo in cui l’AI agentica funziona realmente: per fasi, per profili e per carichi di lavoro distinti che si susseguono lungo ogni flusso di lavoro. Chi pianifica queste fasi in anticipo e assegna a ciascuna il profilo computazionale corretto non si limita a ottimizzare i costi, ma pone l’organizzazione nelle condizioni di competere con rapidità ed efficienza man mano che l’adozione si espande.
Il contesto di mercato: i numeri dell’AI agentica
I dati globali confermano che il 2026 sarà l’anno della crescita esplosiva dell’AI agentica in ambito enterprise. Il mercato è attualmente valutato tra i 10,9 e i 12 miliardi di dollari, con un tasso di crescita annuale composto tra il 40% e il 46%. Le proiezioni per il 2030 stimano che il segmento enterprise raggiungerà un valore compreso tra i 24,5 e i 46 miliardi di dollari.
Gartner prevede che entro la fine del 2026 il 40% delle applicazioni aziendali integrerà agenti di AI dedicati a compiti specifici: un balzo notevole rispetto al dato inferiore al 5% registrato nel 2025.
Eppure, dietro questi numeri si nasconde un divario preoccupante tra adozione e maturità operativa. Secondo Deloitte, solo il 23% delle organizzazioni che utilizzano l’AI generativa ha implementato pienamente almeno un sistema agentico maturo.
Gartner stima che oltre il 40% dei progetti di AI agentica verrà abbandonato entro la fine del 2027, a causa dell’aumento dei costi, di un valore aziendale poco chiaro o di controlli sul rischio inadeguati. Non a caso, il 75% dei leader tecnologici indica governance e sicurezza come le principali sfide nell’implementazione. La corsa è iniziata, ma il percorso verso la produzione è più accidentato di quanto i piani iniziali lasciassero prevedere.
La rinascita della CPU: cosa sta cambiando
Il 2026 ha segnato quello che molti analisti definiscono un vero e proprio “rinascimento della CPU” nei data center aziendali. Le GPU rimangono indispensabili per l’inferenza diretta dei modelli, ma la complessità di orchestrazione richiesta dall’esecuzione di agenti autonomi ha riportato la CPU al centro del dibattito infrastrutturale: un ritorno che pochi avevano previsto.
Il motivo è strutturale. A differenza di una query LLM tradizionale, un flusso di lavoro agentico è per sua natura iterativo e articolato in più fasi. La CPU riceve la richiesta, la scompone in sotto-attività, le pianifica, gestisce le chiamate a database esterni e API aziendali, mantiene la memoria nel corso di sessioni multi-turno – esercitando una pressione significativa su memoria e cache KV – raccoglie i risultati dai sotto-agenti, li valuta e decide se riavviare il ciclo o restituire la risposta finale. Un processo che si ripete, si ramifica e torna continuamente su se stesso.
A questo si aggiunge un effetto moltiplicatore spesso sottovalutato: gli agenti di AI non operano uno alla volta, come un utente che digita lentamente un prompt. Centinaia di agenti possono girare in parallelo, alla massima velocità consentita dalla macchina. Il risultato è una domanda di risorse CPU che non è cresciuta in modo lineare, ma esponenziale – e che impone un ripensamento fondamentale di come l’infrastruttura viene progettata e scalata.
I dati di mercato confermano questa tendenza. Non si tratta di una crescita generica: riflette una domanda specifica e crescente di capacità di calcolo per i carichi di lavoro agentici. I workload agentici e quelli emergenti legati all’AI richiedono infatti sempre più CPU ad alte prestazioni per alimentare i nodi principali ed eseguire attività parallele insieme alle GPU. Una conferma che arriva direttamente dal mercato.
Per i CIO aziendali, queste tendenze si traducono in decisioni concrete. La strategia “universale” per le CPU non è semplicemente subottimale: è diventata un rischio operativo. Standardizzarsi su configurazioni legacy a 16 o 32 core significa rischiare di non soddisfare i requisiti delle fasi più critiche del flusso di lavoro agentico.
E le conseguenze non si limitano alle prestazioni: con l’AI agentica che fa crescere in modo esponenziale la domanda di token, l’efficienza energetica è diventata un fattore strategico a tutti gli effetti. Il concetto di “token per watt” sta entrando a far parte dei KPI infrastrutturali delle organizzazioni più avanzate come parametro fondamentale per mantenere sostenibile il TCO di un’infrastruttura agentica sempre attiva.
Conclusione: dal monolite al portafoglio
L’Italia è in movimento: il 71% delle grandi aziende ha progetti di AI attivi, il 22% dispone già di agenti autonomi operativi e quasi otto italiani su dieci hanno interagito con un agente di AI nell’ultimo anno per effettuare acquisti o ricevere assistenza. La direzione è inequivocabile. Ciò che ancora manca, in molti casi, è la piena comprensione dell’infrastruttura che questa trasformazione richiede.
L’infrastruttura agentica non si acquista “pronta all’uso”. Richiede un portafoglio di risorse computazionali calibrato sul flusso di lavoro reale: frequenze di clock elevate dove la latenza deve essere ridotta al minimo, alta densità di core dove conta il throughput, e il giusto equilibrio tra memoria e I/O dove i nodi principali devono operare con efficienza. Non esiste una configurazione universale in grado di soddisfare tutti questi requisiti – e presumere che esista è il primo errore che un CIO possa commettere oggi.
Chi inizia per tempo a definire le proprie esigenze e a costruire l’infrastruttura di conseguenza otterrà con ogni probabilità un vantaggio competitivo misurabile. Chi rimanda, invece, rischia di entrare a far parte di una statistica di cui nessun decision maker vorrebbe essere protagonista: quel 40% di progetti di AI agentica che, secondo Gartner, verrà cancellato entro il 2027.
La finestra di opportunità è aperta. Ma non lo sarà per sempre.


Partecipa alla community