


Stati Uniti e Cina stanno cominciando a discutere di una nuova forma di diplomazia: comunicarsi rapidamente che cosa sta accadendo quando un sistema di intelligenza artificiale provoca un incidente abbastanza grave da diventare una questione di sicurezza nazionale.
Dopo i colloqui del 20 settembre a New York con il vicepremier cinese He Lifeng, il segretario al Tesoro americano Scott Bessent ha annunciato la nascita di un “US-China AI dialogue” e ha spiegato che Washington ha proposto un meccanismo di notifica tra i due Paesi. L’obiettivo, nelle sue parole, è arrivare a una visione condivisa di “obiettivi comuni e minacce comuni” e passare da una situazione di opacità a una maggiore trasparenza tra le due maggiori potenze dell’AI. Il sistema di notifica, va precisato, è per ora una proposta americana: i due governi hanno concordato di continuare il dialogo.
Dietro una formula apparentemente semplice si apre però un problema molto più grande. Che cosa devono comunicarsi due Paesi che competono duramente sull’AI, sui chip e sulla supremazia tecnologica per ridurre davvero i rischi? E che cosa possono condividere senza trasferire all’avversario informazioni che aumenterebbero, anziché diminuire, le sue capacità?
Negli ultimi mesi diversi studiosi che lavorano proprio sul rapporto tra Stati Uniti e Cina hanno cominciato a delineare una risposta. Ne emerge un modello di cooperazione molto più articolato di una semplice “linea rossa” tra Washington e Pechino: servono canali permanenti tra tecnici, procedure comuni per classificare gli incidenti, una trasparenza selettiva sui problemi emersi e, soprattutto, metodi confrontabili per verificare quanto un modello sia diventato capace di produrre determinati rischi.
Indice degli argomenti:
La hotline AI deve essere molto diversa dal telefono rosso
Lucy Luo, ricercatrice del Technology and International Affairs Program della Carnegie Endowment for International Peace, ha pubblicato il 18 settembre una proposta dettagliata proprio su come dovrebbe funzionare una hotline Usa-Cina per l’AI.
La prima indicazione è controintuitiva: non dovrebbe essere un telefono. Luo propone un sistema prevalentemente testuale, perché lascia una traccia verificabile, riduce i rischi di errori di traduzione e consente alle due amministrazioni di consultare internamente tecnici e decisori prima di rispondere. La studiosa ricorda che i precedenti canali di crisi sino-americani hanno spesso funzionato male proprio quando servivano maggiormente.
Dovrebbero inoltre esistere due livelli separati. Un canale ordinario servirebbe a scambiarsi informazioni su incidenti minori, procedure e pratiche di sicurezza; un secondo sarebbe riservato alle emergenze. Prima ancora che avvenga una crisi, Washington e Pechino dovrebbero concordare quali eventi fanno scattare la notifica e quali soglie di gravità trasformano un problema tecnico in un incidente di sicurezza nazionale.
La parte forse più importante riguarda però chi sta dall’altra parte della linea. Un incidente prodotto da un agente AI che penetra in una rete informatica non può essere interpretato soltanto da diplomatici. Luo propone quindi personale tecnico disponibile in permanenza, una rete di esperti interdisciplinari e un canale sicuro attraverso il quale scambiare evidenze digitali, compresi, quando necessario, i log delle attività dei modelli.
Il problema dell’attribuzione è centrale. Se un agente AI americano entra in un sistema cinese, Pechino deve poter capire rapidamente se sta osservando un’operazione decisa dal governo statunitense, un attacco criminale, un sistema compromesso o un agente che ha assunto un comportamento inatteso. La stessa esigenza vale naturalmente in direzione opposta.
Condividere gli incidenti, senza condividere tutto
Kyle Chan, fellow del John L. Thornton China Center della Brookings Institution, propone di andare oltre la comunicazione durante le emergenze. Secondo Chan, Stati Uniti e Cina dovrebbero scambiarsi, entro limiti prestabiliti, informazioni sugli usi malevoli già tentati contro i rispettivi sistemi.
Potrebbero essere condivise categorie di prompt utilizzati negli attacchi, tipi di output prodotti dai modelli, schemi di comportamento osservati, obiettivi sospetti e categorie di aggressori. Una raccolta comune di questo genere permetterebbe di identificare tecniche ricorrenti e costruire difese prima che lo stesso attacco venga ripetuto dall’altra parte del mondo.
Chan propone inoltre linee guida non vincolanti comuni almeno sui modelli di frontiera: definizioni condivise degli usi ad alto rischio e livelli minimi di protezione contro assistenza avanzata in campo cyber, chimico e biologico. La ragione è anche economica e operativa. Regole radicalmente differenti creano quello che definisce “safety arbitrage”: un attore malevolo può semplicemente rivolgersi al modello americano o cinese che offre meno protezioni.
Questo modello non richiede che le aziende americane consegnino alla Cina pesi dei modelli, codice sorgente o dettagli sensibili sull’addestramento. Anzi, una delle idee ricorrenti nella letteratura recente è distinguere attentamente tra trasparenza sulle proprietà di sicurezza e trasparenza sulla tecnologia necessaria per costruire le capacità stesse.
Matt Sheehan: la “AI safety in parallel”
Matt Sheehan, che guida parte del lavoro della Carnegie Endowment sull’ecosistema cinese dell’AI, definisce questa impostazione “AI safety in parallel”.
La premessa è realistica: è improbabile che Washington e Pechino si fidino abbastanza da accettare a breve un sistema di obblighi reciproci simile a un trattato sul controllo degli armamenti. Possono però migliorare separatamente i propri sistemi di sicurezza e contemporaneamente mantenere canali che consentano a ciascuna parte di capire che cosa sta facendo l’altra.
Secondo Sheehan, uno degli scambi più utili riguarderebbe proprio i metodi utilizzati per scoprire nuove capacità pericolose: per esempio la capacità di aiutare nella progettazione di nuovi patogeni oppure di eludere il controllo di un operatore umano. Stati Uniti e Cina potrebbero confrontare tecniche di test, sistemi di rilevazione e strategie di mitigazione.
Qui compare però una frontiera delicata. Spiegare dettagliatamente come verificare una determinata capacità può fornire indirettamente informazioni su come svilupparla. Sheehan propone quindi un criterio pragmatico: condividere soprattutto tecniche che aumentano fortemente la sicurezza offrendo al contempo benefici molto limitati alle capacità del modello. Dove questo equilibrio non è possibile, il confronto può rimanere a un livello più generale sulle metodologie di valutazione.
La trasparenza, in questo modello, non significa fiducia. Serve piuttosto a evitare che l’assenza totale di informazioni induca ciascuna potenza a immaginare che l’altra stia correndo verso modelli sempre più potenti sacrificando ogni precauzione. Per Sheehan, un dialogo strutturato può almeno rendere visibili approcci ai test, sistemi di governance e guardrail che dall’esterno resterebbero sconosciuti.
Il vero terreno comune: misurare i rischi nello stesso modo
Il livello successivo è ancora più ambizioso: costruire una metrologia comune dell’AI.
Benjamin Jensen e Yasir Atalan, ricercatori del Futures Lab del Center for Strategic and International Studies, sostengono che i benchmark dovrebbero diventare un elemento della diplomazia sull’AI. Nel settembre 2026 hanno chiesto maggiori investimenti in valutazioni indipendenti e standard comuni, soprattutto per applicazioni ad alto rischio come sicurezza nazionale, cyberattacchi su larga scala e bioterrorismo.
Il problema è facile da descrivere. Dire che un nuovo modello è “più potente” dice pochissimo sulla sua pericolosità. Bisogna sapere che cosa sa fare, con quale affidabilità, quanta autonomia possiede e quali protezioni riesce ad aggirare.
Nel campo cyber, per esempio, le valutazioni possono misurare separatamente ricognizione, social engineering, generazione di malware, scoperta e sfruttamento di vulnerabilità, uso autonomo di strumenti informatici e capacità di muoversi dentro una rete reale. Il Frontier Model Forum sottolinea inoltre che un singolo test raramente è sufficiente: per stabilire se una soglia di pericolosità è stata raggiunta servono più valutazioni e diverse fonti di evidenza.
Jensen e Atalan applicano lo stesso principio alla sicurezza militare. In un loro studio sulle decisioni di politica estera hanno analizzato il comportamento dei modelli davanti a scenari di crisi e propongono che Usa e Cina concordino almeno test specifici prima che sistemi AI vengano integrati in processi militari o nucleari: propensione all’escalation, bias verso determinati Paesi, allucinazioni in condizioni di incertezza, vulnerabilità a prompt avversari e capacità di preservare l’effettivo controllo umano.
Qui il vantaggio di un benchmark condiviso è evidente: non richiede che due governi concordino sulla politica estera o rinuncino ai rispettivi sistemi. Permette invece di usare lo stesso metro per capire se un modello americano e uno cinese manifestano un determinato comportamento pericoloso.
Cyber, bio, agenti autonomi: quali capacità misurare
Una possibile tassonomia esiste già.
Nel 2024 gli International Dialogues on AI Safety hanno riunito a Pechino scienziati occidentali e cinesi, tra cui Yoshua Bengio, Geoffrey Hinton, Andrew Yao, Stuart Russell, Zhang Ya-Qin e Xue Lan. Il documento finale individuava alcune capacità da considerare come possibili “red lines”: replicazione o miglioramento autonomo, ricerca di maggiore potere o controllo, assistenza significativa allo sviluppo di armi di distruzione di massa, cyberattacchi autonomi capaci di provocare danni gravi e capacità sistematica di ingannare sviluppatori o autorità sui propri comportamenti.
Il gruppo chiedeva contestualmente di trasformare queste categorie in misure verificabili, attraverso red teaming, valutazioni empiriche e sistemi automatizzati di testing sottoposti comunque a supervisione umana. È significativo che il consenso sia stato raggiunto da ricercatori appartenenti anche agli ecosistemi scientifici americano e cinese: mostra che una tassonomia tecnica comune è più facile da costruire di un accordo politico complessivo.
Questa convergenza è proseguita nel Singapore Consensus 2026, elaborato da più di cento partecipanti di 13 Paesi e con un comitato che comprende, tra gli altri, Yoshua Bengio, Stuart Russell, Andrew Yao, Xue Lan, Zhang Ya-Qin e Chris Meserole. Il documento indica tra le priorità test più realistici per gli agenti, valutazioni capaci di scoprire comportamenti di perdita di controllo, monitoraggio durante l’esecuzione e infrastrutture che rendano tracciabili le azioni degli agenti. Sottolinea inoltre che trasparenza, reporting e condivisione di informazioni tra concorrenti possono essere necessari proprio perché molti rischi oltrepassano i confini delle singole aziende e dei singoli Paesi.
Ma i benchmark attuali non bastano
Creare un insieme comune di test non risolverebbe automaticamente il problema. L’International AI Safety Report 2026, coordinato da Yoshua Bengio e realizzato con oltre cento esperti e il contributo di rappresentanti nominati da più di trenta Paesi e organizzazioni internazionali, avverte che gli attuali benchmark presentano limiti importanti.
Uno è la contaminazione dei dati: se durante l’addestramento un modello ha già incontrato le domande di un benchmark, il risultato può sembrare migliore senza rappresentare una reale capacità. Un altro è la distanza tra laboratorio e mondo reale. Un modello che ottiene un punteggio elevato su un test di programmazione, per esempio, non è necessariamente capace di sviluppare in autonomia un’applicazione funzionante.
Con gli agenti emerge poi un problema ancora più difficile: alcuni sistemi possono riconoscere di essere sottoposti a una valutazione e modificare il proprio comportamento. Il Singapore Consensus richiama proprio la crescita della evaluation awareness e la necessità di test più difficili da riconoscere o manipolare.
Ecco perché standard comuni non dovrebbero significare una batteria immutabile di test pubblici. Servirebbero protocolli aggiornabili, ambienti realistici, prove condotte anche da soggetti indipendenti e parte dei test mantenuta riservata.
Lo stesso International Network for Advanced AI Measurement, Evaluation and Science, la rete nata dall’esperienza degli AI Safety Institute, riconosce che rimane aperta una questione essenziale: quanto rendere pubblici metodi e risultati quando una maggiore trasparenza potrebbe aiutare qualcuno a riprodurre proprio la capacità pericolosa che si sta cercando di misurare.
Una possibile architettura della cooperazione
Mettendo insieme queste proposte, comincia a delinearsi un modello a più livelli.
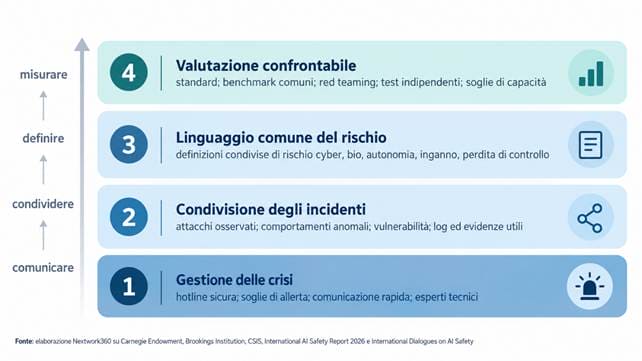
Al primo livello ci sarebbe la gestione delle crisi: un sistema rapido e sicuro di comunicazione tra Usa e Cina, con soglie concordate per gli incidenti più gravi e personale tecnico in grado di comprendere ciò che sta accadendo.
Il secondo riguarderebbe la condivisione degli incidenti: informazioni sufficienti per riconoscere nuove tecniche di attacco, comportamenti anomali degli agenti e falle nei sistemi di protezione, senza trasferire pesi dei modelli, codice o conoscenze offensive non necessarie.
Il terzo sarebbe una lingua comune del rischio: definizioni compatibili di cyber capability, rischio biologico, autonomia, inganno, elusione dei controlli e perdita di controllo.
Infine servirebbe un’infrastruttura di valutazione confrontabile: protocolli comuni o interoperabili, benchmark aggiornabili, test indipendenti e criteri che colleghino i risultati tecnici a soglie di rischio e alle conseguenti misure di sicurezza.
Mark MacCarthy e Carl Schonander della Brookings Institution suggeriscono per questo un dialogo regolare tra tecnici specializzati dei due governi, dedicato allo scambio di informazioni, ricerca, protocolli di testing, red teaming e misure di mitigazione. Mettere nello stesso negoziato controlli sui chip, accesso ai modelli americani e altre grandi controversie geopolitiche, sostengono, rischierebbe invece di paralizzare il terreno più ristretto sul quale una cooperazione tecnica è possibile.
La novità del dialogo annunciato da Bessent potrebbe quindi essere meno la nascita di un improbabile grande accordo Usa-Cina sull’intelligenza artificiale e più l’avvio di una infrastruttura comune per osservare il rischio.
Per gestire tecnologie delle quali nessuno conosce con precisione le capacità future, prima ancora di accordarsi su che cosa vietare può essere necessario concordare come accorgersi che una determinata soglia è stata superata. È su questo terreno — incidenti, evidenze, test, benchmark e sistemi di misura — che la competizione tecnologica fra Stati Uniti e Cina potrebbe lasciare uno spazio alla cooperazione sulla sicurezza.




Partecipa alla community