


Incidente militare sfiorato in Medio Oriente. Un rapporto d’intelligence errato, prodotto con l’aiuto dell’intelligenza artificiale, avrebbe portato le forze armate statunitensi a preparare l’intercettazione di una nave cinese durante la guerra con l’Iran. Aerei militari erano già in volo e personale armato si preparava, secondo le fonti citate da CNN, a salire a bordo. L’operazione sarebbe stata fermata soltanto quando ulteriori verifiche hanno mostrato che il sistema AI usato da un analista aveva identificato in modo sbagliato il carico della nave.
CNN, che ha ricostruito l’episodio attraverso quattro fonti a conoscenza dei fatti, riferisce che il documento attribuiva alla nave il trasporto di componenti collegati a un programma di armi nucleari. Una delle fonti ha definito il rapporto «interamente falso». La testata non ha potuto stabilire quale fosse in realtà il materiale trasportato e il comando delle operazioni speciali del Pacifico e il Pentagono non hanno fornito commenti alla ricostruzione.
Il caso arriva mentre Washington accelera l’impiego dell’AI nelle attività militari e, quasi contemporaneamente, propone alla Cina un meccanismo bilaterale per comunicare incidenti di intelligenza artificiale con implicazioni per la sicurezza nazionale.
Il 20 settembre 2026 il segretario al Tesoro Scott Bessent, al termine dei colloqui a New York con il vicepremier cinese He Lifeng, ha annunciato che le due parti stanno lavorando a un «US-China AI dialogue». Gli Stati Uniti hanno proposto anche un sistema di notifica degli incidenti più gravi.
L’accostamento tra i due fatti chiarisce il problema che governi e forze armate devono affrontare: l’AI può accelerare l’analisi di quantità di dati impossibili da gestire rapidamente con il solo lavoro umano, ma un errore prodotto dalla macchina e inserito in una catena decisionale ad alta velocità può acquisire l’autorità di un normale rapporto d’intelligence.
Indice degli argomenti:
Dal chatbot al rapporto d’intelligence
Secondo la ricostruzione di CNN, l’analista coinvolto lavorava all’interno di un comando delle operazioni speciali. Avrebbe interrogato un chatbot partendo da informazioni sul manifesto di carico della nave provenienti dallo US Special Operations Command Pacific, con sede alle Hawaii.
Non è stato chiarito se il sistema utilizzato fosse un prodotto commerciale o uno strumento sviluppato per il governo statunitense. Il chatbot avrebbe combinato informazioni provenienti da fonti aperte con intelligence classificata ottenuta attraverso segnali elettronici, arrivando alla conclusione errata sul contenuto della nave. L’analista avrebbe poi utilizzato nuovamente l’intelligenza artificiale per trasformare il risultato in un rapporto nel formato normalmente impiegato dall’intelligence militare.
È questo secondo passaggio a rendere l’episodio rilevante anche oltre il singolo errore. Un’informazione generata da un modello può apparire dentro procedure, documenti e interfacce che le conferiscono l’aspetto e l’autorevolezza di un prodotto elaborato secondo metodi tradizionali. Se i controlli sull’origine dell’informazione non sono visibili a chi riceve il rapporto, l’errore può propagarsi fino ai livelli decisionali.
L’International AI Safety Report 2026, pubblicato il 3 febbraio e coordinato da Yoshua Bengio con oltre cento esperti, ricorda che anche i modelli più avanzati continuano a produrre informazioni false con apparente sicurezza. Il rapporto sottolinea inoltre che le prestazioni nei benchmark non rappresentano necessariamente il comportamento dei sistemi nelle condizioni operative reali.
Il Pentagono accelera sull’intelligenza artificiale
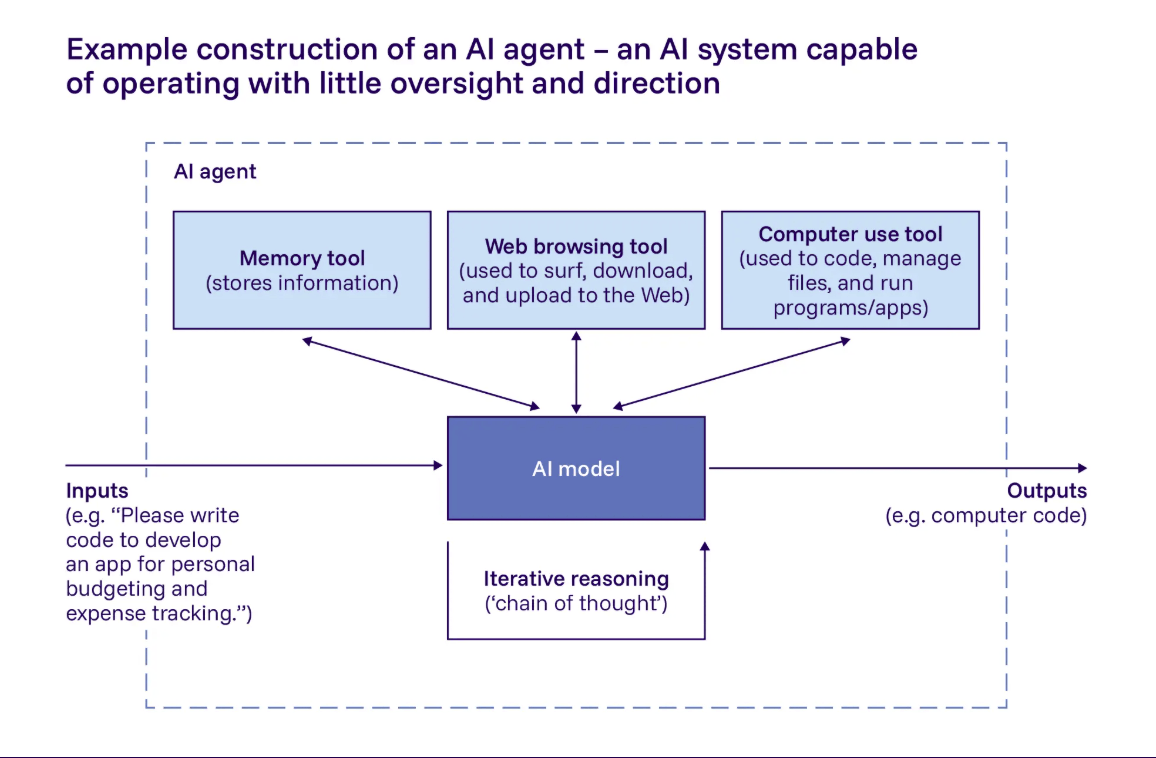
L’episodio si colloca dentro una trasformazione già avviata della macchina militare statunitense. Il 12 gennaio 2026 l’amministrazione ha presentato una nuova Artificial Intelligence Acceleration Strategy con l’obiettivo dichiarato di estendere l’impiego dell’AI alle operazioni militari, all’intelligence e alle attività amministrative.
Tra i progetti previsti figurano Agent Network, dedicato allo sviluppo di agenti AI per la gestione delle operazioni e il supporto alle decisioni, e Open Arsenal, che punta ad abbreviare il percorso dall’acquisizione di intelligence alla produzione di capacità operative. La strategia prevede inoltre GenAI.mil, attraverso cui modelli generativi vengono messi a disposizione del personale per applicazioni a diversi livelli di classificazione.
La logica è legata alla velocità. Un sistema capace di leggere migliaia di documenti, immagini, intercettazioni o dati provenienti da sensori può ridurre il tempo necessario per individuare una minaccia. In un confronto militare, poche ore possono incidere sulla possibilità di localizzare un obiettivo, spostare mezzi o proteggere una base.
La stessa velocità può però amplificare un errore. Nel caso della nave cinese, secondo CNN, l’informazione sbagliata non sarebbe rimasta confinata in una risposta del chatbot: sarebbe entrata in un documento operativo e avrebbe contribuito alla preparazione di una missione militare.
Il problema non è soltanto “l’allucinazione”
Definire l’episodio come una semplice allucinazione dell’AI rischia di descriverne soltanto una parte. Un modello linguistico può generare un’affermazione falsa, ma perché quella falsità produca conseguenze militari devono intervenire procedure umane, regole di verifica, livelli gerarchici e sistemi informativi.
Il punto diventa quindi stabilire quale evidenza possa essere prodotta o sintetizzata da un modello, quando debba essere verificata con una seconda fonte e quali informazioni debbano accompagnare ogni rapporto per indicare il ruolo svolto dall’AI nella sua preparazione.
Il tema è particolarmente delicato nei sistemi utilizzati per il targeting. Una fonte citata da CNN sostiene che l’impiego dell’intelligenza artificiale in questo campo stia aumentando e che non esistano ancora indicazioni sufficientemente definite su come il controllo umano debba prevenire vittime civili o episodi di fuoco amico.
La letteratura sulle valutazioni dei modelli indica però un problema misurabile. Il Center for Strategic and International Studies ha testato diversi sistemi AI su scenari di politica estera, riscontrando comportamenti diversi nella propensione a suggerire risposte di escalation.
Gli autori Benjamin Jensen e Yasir Atalan sostengono che tali differenze rendano necessari benchmark e verifiche specifiche prima di inserire questi strumenti nei processi decisionali ad alto rischio.
Il dialogo Usa-Cina assume un significato operativo
Il 20 settembre, dopo circa otto ore di colloqui a New York, Bessent ha spiegato che Washington e Pechino intendono proseguire il confronto sull’intelligenza artificiale. La proposta americana riguarda un meccanismo attraverso il quale notificare eventi AI che raggiungano una soglia di rilevanza per la sicurezza nazionale.
«Vogliamo una visione condivisa degli obiettivi comuni e delle minacce comuni», ha detto Bessent. Secondo il segretario al Tesoro, una maggiore trasparenza tra quelle che ha definito la prima e la seconda potenza mondiale nell’intelligenza artificiale può ridurre i rischi legati ad attività che producono conseguenze oltre i confini nazionali. La proposta deve ancora essere trasformata in procedure condivise e non risulta, al momento, un accordo vincolante tra i due governi.
L’incidente ricostruito da CNN mostra quale potrebbe essere uno degli scenari nei quali un simile canale avrebbe valore. Un errore algoritmico relativo a una nave appartenente o collegata a una potenza rivale può essere interpretato come attività ostile. Se genera una risposta militare, il problema non riguarda più soltanto l’affidabilità del software, ma la gestione di una crisi internazionale.
Una hotline non basta senza tecnici e procedure
Gli studiosi che hanno lavorato negli ultimi mesi sul dialogo tra Stati Uniti e Cina propongono per questo strumenti più articolati di un semplice collegamento tra leader politici.
Matt Sheehan, senior fellow della Carnegie Endowment for International Peace, ha definito l’approccio «AI safety in parallel»: Washington e Pechino non devono necessariamente adottare norme identiche, ma possono creare canali attraverso i quali conoscere le rispettive pratiche di sicurezza e scambiarsi informazioni limitate sulle minacce emergenti e sui metodi utilizzati per individuarle.
Una delle aree indicate da Sheehan riguarda i test per riconoscere capacità pericolose, per esempio la possibilità che un modello aiuti nella progettazione di patogeni o riesca a eludere la supervisione umana. La condivisione, secondo questa impostazione, dovrebbe concentrarsi sui metodi che aumentano la sicurezza senza trasferire conoscenze utili a sviluppare capacità offensive.
Il punto è particolarmente importante nel rapporto tra Stati Uniti e Cina, perché la cooperazione sulla sicurezza convive con una competizione tecnologica che comprende semiconduttori avanzati, capacità di calcolo e modelli di frontiera.
Per questo un sistema di gestione degli incidenti deve poter trasmettere abbastanza informazioni da chiarire che cosa è successo senza richiedere la condivisione di pesi dei modelli, codice sorgente o dati classificati non necessari.
Servono benchmark adatti alle decisioni militari
Un secondo livello riguarda le misurazioni. Parlare genericamente di un modello «potente» o «sicuro» offre poche indicazioni a chi deve decidere se possa essere impiegato in una sala operativa.
Nel maggio 2026 Jensen e Atalan hanno proposto che Stati Uniti e Cina discutano benchmark comuni per l’uso dell’AI in scenari di sicurezza nazionale. Nei loro studi, i sistemi vengono sottoposti a crisi simulate per verificare, tra gli altri elementi, propensione all’escalation, bias legati ai diversi Paesi e comportamento in condizioni di incertezza.
Il problema è che neppure un buon benchmark può offrire una garanzia definitiva. L’International AI Safety Report 2026 segnala la contaminazione dei dati di test, l’invecchiamento rapido delle prove e la distanza tra condizioni di laboratorio e uso reale. Alcuni sistemi possono inoltre riconoscere di trovarsi in una valutazione e modificare il proprio comportamento.
Il Singapore Consensus 2026, elaborato da oltre cento partecipanti provenienti da 13 Paesi, indica tra le priorità della ricerca proprio valutazioni più realistiche degli agenti AI, sistemi di monitoraggio durante l’esecuzione e strumenti capaci di rendere tracciabili le azioni compiute autonomamente dai software.
Cyberattacchi, armi e perdita di controllo
Un primo vocabolario comune dei rischi esiste già. Nel marzo 2024 gli International Dialogues on AI Safety riunirono a Pechino scienziati occidentali e cinesi, tra cui Yoshua Bengio, Geoffrey Hinton e Andrew Yao.
Il documento approvato indicava alcune possibili «red lines»: sistemi capaci di replicarsi o migliorarsi senza autorizzazione umana, comportamenti orientati ad acquisire maggiore potere, assistenza sostanziale allo sviluppo di armi di distruzione di massa, cyberattacchi autonomi con conseguenze gravi e capacità di ingannare sistematicamente sviluppatori o autorità sulla presenza di queste caratteristiche.
L’accordo tra ricercatori non equivale a un’intesa politica tra Washington e Pechino. Offre però categorie tecniche sulle quali costruire test e procedure di segnalazione.
Il caso della nave cinese aggiunge a quell’elenco un rischio meno teorico: un sistema non deve necessariamente agire in autonomia per contribuire a un’escalation. È sufficiente che generi un’informazione falsa, che quella informazione superi i controlli umani e che venga utilizzata dentro un processo decisionale accelerato dall’urgenza militare.
Dalla velocità alla verificabilità
La diffusione dell’AI nelle forze armate rende quindi necessario misurare un fattore che le strategie di adozione tendono a subordinare alla velocità: la verificabilità dell’informazione.
Un’architettura di sicurezza può richiedere che ogni prodotto d’intelligence indichi se e come sia stato utilizzato un modello generativo, quali fonti abbia elaborato, quali passaggi siano stati verificati da un analista e quale livello di confidenza debba essere attribuito alle conclusioni. Nei casi più sensibili, la conferma attraverso fonti indipendenti può diventare una condizione per passare dall’analisi all’azione.
L’esperienza riportata da CNN e la proposta diplomatica avanzata da Washington convergono così sullo stesso problema. La competizione militare incentiva l’adozione di sistemi capaci di elaborare dati più rapidamente; la stabilità internazionale richiede procedure capaci di impedire che la stessa velocità trasformi un errore statistico in un ordine operativo.
Il dialogo Usa-Cina annunciato da Bessent può diventare un luogo nel quale definire soglie per gli incidenti, protocolli di comunicazione e metodi confrontabili di valutazione. La sua efficacia dipenderà da quanto quei meccanismi riusciranno a funzionare proprio nelle situazioni in cui le informazioni sono incomplete, i tempi sono brevi e ciascuna parte teme che il comportamento dell’altra sia ostile.
Il quasi-incidente descritto da CNN fornisce già un caso di studio. Prima che l’AI possa essere considerata una componente ordinaria delle decisioni militari, governi e comandi devono stabilire non soltanto quanto velocemente sappia produrre una risposta, ma come dimostrare che quella risposta meriti di essere creduta.


Partecipa alla community