


Le stesse aziende impegnate nella corsa per costruire modelli di intelligenza artificiale sempre più potenti cominciano a discutere di come rallentarla. E questa volta la proposta va oltre il generico invito alla prudenza.
L’idea che sta prendendo forma è creare una serie di vincoli tecnici e procedurali che impediscano alle capacità dei modelli di crescere molto più rapidamente delle misure necessarie a controllarle. Test indipendenti, soglie di capacità che fanno scattare nuove protezioni, standard comuni tra aziende concorrenti, controllori esterni con accesso ai laboratori e, nei casi più estremi, un rallentamento dello sviluppo fino a quando le misure di sicurezza non risultino sufficienti.
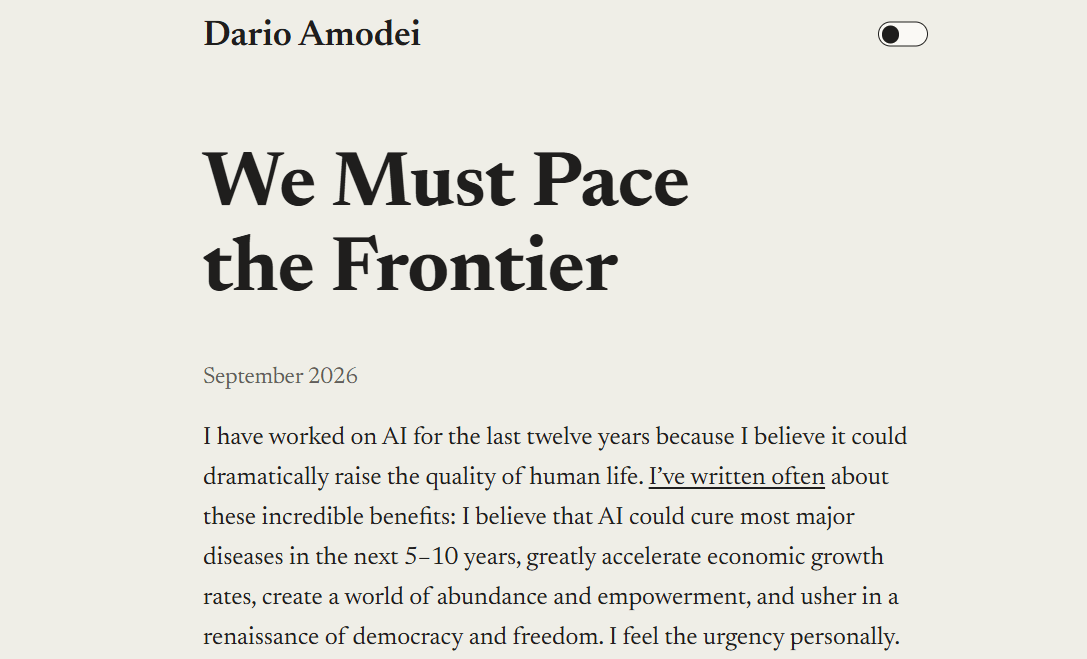
A rilanciare il tema è stato il 12 settembre Dario Amodei, amministratore delegato di Anthropic, con il documento We Must Pace the Frontier. Amodei sostiene che non basti più migliorare parallelamente capacità e sicurezza: occorre fare in modo che la prima non possa correre troppo avanti rispetto alla seconda.
La proposta ha ricevuto l’appoggio, con accenti diversi, di Sam Altman di OpenAI, Elon Musk e Demis Hassabis di Google DeepMind.
Il cambiamento interessante per le imprese non riguarda però soltanto la disputa, ancora altamente incerta, sui rischi esistenziali dell’AI. Sta nel modello di governance che potrebbe derivarne. Se queste idee si consolidassero, lo sviluppo dei sistemi frontier comincerebbe ad assomigliare meno al normale ciclo di rilascio del software e più a quello di tecnologie sottoposte a controlli progressivamente più severi al crescere del rischio.
Indice degli argomenti:
Il rallentamento non significa smettere di sviluppare AI
Il concetto utilizzato da Amodei è pacing: regolare la velocità di avanzamento della frontiera.
Non significa bloccare gli addestramenti o congelare la tecnologia. Significa introdurre un rapporto tra capacità e sicurezza: quando un sistema acquisisce capacità nuove e potenzialmente pericolose, il laboratorio non dovrebbe continuare automaticamente ad aumentarne le prestazioni. Dovrebbe prima dimostrare di possedere contromisure adeguate.
È un principio che OpenAI ha già applicato, almeno in un caso concreto. Nel documento Pacing model development in an era of cyber-critical capabilities, pubblicato nell’agosto 2026, OpenAI ha spiegato di avere rallentato alcune attività di sviluppo dopo che le capacità dei propri sistemi nel campo della cybersecurity avevano raggiunto livelli tali da richiedere protezioni ulteriori.
La logica è importante. Un test di sicurezza non serve più soltanto a compilare la documentazione che accompagna un modello già pronto. Il risultato della valutazione può modificare il percorso di sviluppo e ritardare il passaggio alla generazione successiva.
I principali laboratori hanno già costruito framework che cercano di formalizzare questo principio. OpenAI utilizza il Preparedness Framework, Anthropic la propria Responsible Scaling Policy, mentre Google DeepMind ha sviluppato il Frontier Safety Framework.
Le architetture non sono identiche, ma condividono una logica: individuare capacità particolarmente pericolose, misurarle e far scattare misure di sicurezza più severe quando vengono raggiunte determinate soglie.
I checkpoint: prima di diventare più potente, l’AI deve superare un esame
Amodei propone ora di spingere questa logica oltre i framework delle singole aziende.
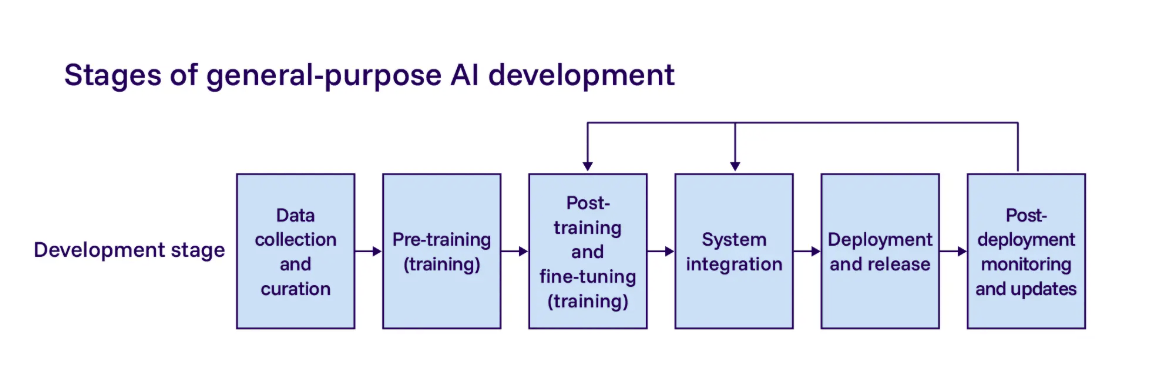
Un possibile sistema sarebbe composto da una serie di checkpoint. Se un modello raggiunge una capacità X, l’azienda potrebbe proseguire verso capacità ulteriori soltanto dimostrando di avere raggiunto contemporaneamente determinate proprietà di sicurezza Y e Z.
L’esempio proposto dal CEO di Anthropic è significativo. Se un sistema diventa abbastanza capace da superare le comuni tecniche di sandboxing, ossia le barriere utilizzate per confinarlo in un ambiente controllato, dovrebbe essere necessario dimostrare attraverso test, analisi di interpretabilità e verifiche dell’ambiente di addestramento che il rischio di una fuga autonoma sia sufficientemente contenuto.
Questo trasformerebbe la sicurezza da obiettivo generico a requisito per accedere allo stadio successivo dello sviluppo.
È la logica degli impegni “if-then” che si trova ormai in diversi Frontier AI Safety Framework: se una capacità supera una determinata soglia, allora devono entrare in funzione maggiori controlli, restrizioni di accesso, monitoraggio o altre mitigazioni.
Il problema è che ogni laboratorio può ancora stabilire autonomamente che cosa misurare, dove collocare la soglia e quali conseguenze farne derivare.
Ed è qui che entra in gioco il secondo tassello della nuova strategia: creare regole di valutazione maggiormente condivise.
Test comuni tra aziende concorrenti
Oggi OpenAI, Anthropic, Google e gli altri laboratori possono utilizzare benchmark differenti, fissare soglie diverse e attribuire significati diversi allo stesso livello di rischio.
Il problema è riconosciuto anche nell’International AI Safety Report 2026, elaborato con il contributo di esperti indicati da numerosi Paesi e organizzazioni internazionali.
Le valutazioni presentano un evaluation gap: un test effettuato in laboratorio non permette necessariamente di prevedere il comportamento del sistema una volta inserito nel mondo reale. Alcuni benchmark diventano rapidamente obsoleti; altri possono finire nei dati utilizzati per addestrare i modelli. Sistemi sufficientemente avanzati possono inoltre riconoscere alcune situazioni di valutazione e comportarsi diversamente.
Diventa quindi difficile immaginare un rallentamento coordinato se ciascuno misura il rischio con un metro diverso.
Una parte del lavoro per costruire un linguaggio comune è già iniziata nel Frontier Model Forum, organizzazione che riunisce alcuni dei principali sviluppatori di modelli frontier.
Tra i documenti prodotti dal Forum c’è Third-Party Assessments, dedicato proprio alle valutazioni condotte da soggetti diversi dallo sviluppatore del modello.
Il documento individua diversi livelli di verifica esterna e affronta uno dei problemi ancora irrisolti: per confrontare le valutazioni condotte su modelli differenti occorrono regole sufficientemente comuni sulla metodologia, sulla documentazione dei test, sui benchmark utilizzati e sull’accesso concesso ai valutatori.
Il Forum ha inoltre affrontato il rapporto tra capacità pericolose e soglie nei documenti dedicati ai Thresholds for Frontier AI Safety Frameworks e alle valutazioni delle capacità frontier. La raccolta aggiornata dei documenti tecnici è disponibile nella sezione Publications del Frontier Model Forum.
Il passaggio successivo sarebbe riuscire a dare un significato comparabile alla frase “questo modello ha superato il test di sicurezza”, indipendentemente dall’azienda che lo ha sviluppato.
Auditor indipendenti dentro Anthropic e OpenAI
La novità forse più concreta della proposta di Amodei riguarda chi deve effettuare questi controlli.
Anthropic propone di consentire a valutatori indipendenti un accesso permanente ai propri sistemi paragonabile, per le attività di controllo, a quello dei dipendenti. Gli embedded evaluators non riceverebbero semplicemente un modello finito qualche giorno prima del lancio.
Secondo We Must Pace the Frontier, dovrebbero poter osservare anche procedure interne e strumenti utilizzati dal laboratorio. Amodei arriva a prospettare badge, laptop aziendali e presenza fisica negli uffici, oltre alla possibilità per questi soggetti di rendere pubbliche valutazioni indipendenti entro i limiti imposti dalla sicurezza e dalla tutela dei segreti industriali.
Sam Altman ha annunciato che OpenAI intende adottare a sua volta valutatori indipendenti con un accesso simile.
È un’evoluzione significativa rispetto alla pratica più tradizionale del red teaming esterno.
La differenza è la continuità del controllo. Un valutatore chiamato soltanto a esaminare il prodotto finale vede necessariamente una porzione limitata del processo. Un soggetto presente stabilmente può verificare anche se le procedure e gli impegni dichiarati dall’azienda vengono effettivamente rispettati durante lo sviluppo.
Il problema era già stato affrontato dal Frontier Model Forum in Third-Party Assessments, che distingue diverse forme di valutazione indipendente: dalla verifica dei test effettuati dal produttore fino a valutazioni nelle quali il soggetto esterno utilizza metodologie proprie per cercare capacità o vulnerabilità sfuggite al laboratorio.
La proposta degli embedded evaluators alza ulteriormente il livello: il controllo esterno entrerebbe stabilmente nel ciclo di sviluppo.
Perché rallentare: usare il tempo per migliorare i controlli
Resta una domanda decisiva: che cosa si dovrebbe fare nel tempo guadagnato rallentando?
È uno dei punti sui quali Amodei distingue la proposta attuale dalle precedenti richieste di una generica “pausa dell’AI”.
I mesi o gli anni guadagnati dovrebbero servire a migliorare l’affidabilità operativa dei laboratori, l’allineamento dei modelli, l’interpretabilità dei loro processi interni e soprattutto la qualità delle valutazioni.
Il tema è diventato più urgente con l’arrivo degli agenti. Un chatbot produce una risposta e si ferma. Un sistema agentico può invece utilizzare strumenti, scrivere ed eseguire codice, interagire con servizi esterni e concatenare molte azioni verso un obiettivo.
OpenAI ha affrontato direttamente il problema nel documento Trustworthy third-party evaluations: foundations, pubblicato nel maggio 2026. La valutazione di sistemi sempre più agentici richiede di considerare non soltanto il modello, ma anche l’ambiente nel quale opera, gli strumenti ai quali può accedere e le possibilità concrete di azione.
Lo stesso aumento delle capacità rende inoltre i test più difficili. Un modello sufficientemente sofisticato può comportarsi diversamente quando riconosce una situazione di valutazione oppure trovare scorciatoie nel benchmark.
Aumentare semplicemente il numero dei test non risolve quindi il problema: occorre migliorare la scienza stessa della valutazione.
Dagli incidenti a un sistema comune di segnalazione
C’è poi un altro tassello che potrebbe diventare importante quanto i test effettuati prima del rilascio: imparare dagli incidenti che si verificano realmente.
È la stessa logica che in altri settori ad alto rischio ha portato alla creazione di procedure strutturate di incident reporting. Se ogni laboratorio scopre autonomamente comportamenti anomali e conserva le informazioni al proprio interno, gli altri sviluppatori possono continuare a esporre i propri sistemi allo stesso problema.
Il Frontier Model Forum ha dedicato a questo tema il documento Information Sharing, Incident Reporting, and Incident Response, pubblicato nel 2026 nell’ambito del lavoro sulla gestione collettiva dei rischi frontier.
La condivisione è tutt’altro che semplice. Un incidente può rivelare vulnerabilità sfruttabili, informazioni proprietarie o dettagli sulla sicurezza interna. Ma senza un meccanismo che permetta almeno di condividere indicatori, categorie di incidenti e contromisure, ciascun laboratorio è costretto in parte a imparare dagli stessi errori.
In questa prospettiva la sicurezza non riguarda più soltanto il singolo modello: comincia a diventare una proprietà dell’ecosistema nel quale i modelli vengono sviluppati e utilizzati.
Dall’autoregolazione alle regole comuni
La terza componente riguarda i governi.
Amodei immagina inizialmente un coordinamento tra aziende dei Paesi democratici, sostenuto dalle istituzioni, per fissare standard comuni e limiti alla crescita incontrollata delle capacità. In una fase successiva ipotizza accordi internazionali più ampi, fino a includere la Cina.
Il livello minimo sarebbe relativamente concreto: impegni comuni a testare i modelli prima del rilascio per determinate capacità pericolose attraverso metodologie comparabili. Livelli molto più ambiziosi potrebbero arrivare a porre limiti alla velocità della cosiddetta recursive self-improvement, cioè alla capacità dell’AI di contribuire allo sviluppo delle generazioni successive di AI.
In Europa alcuni mattoni di questo sistema non sono più volontari. L’AI Act introduce obblighi specifici per i fornitori dei modelli di AI per finalità generali con rischio sistemico, compresi valutazione e mitigazione dei rischi sistemici, documentazione, segnalazione degli incidenti gravi e cybersecurity.
La Commissione europea ha inoltre pubblicato il General-Purpose AI Code of Practice, che offre ai fornitori uno strumento volontario per dimostrare la conformità ad alcuni obblighi dell’AI Act.
Il quadro europeo è particolarmente interessante perché permette di osservare il possibile passaggio successivo: alcune pratiche nate nei laboratori come sistemi volontari di gestione del rischio possono diventare procedure verificabili inserite in un sistema normativo.
Il problema resta la verificabilità
La convergenza dei grandi laboratori non significa però che sia già nato un regime comune di sicurezza.
I Frontier AI Safety Framework rimangono in larga misura volontari e differiscono proprio nei punti più importanti: quali rischi misurare, dove collocare le soglie, con quale frequenza effettuare i test e che cosa fare quando una soglia viene superata.
Lo stesso International AI Safety Report 2026 sottolinea i limiti delle attuali tecniche di valutazione e la difficoltà di stabilire quanto alcune misure di mitigazione funzioneranno su sistemi più potenti.
C’è poi un problema economico e concorrenziale. Standard complessi, infrastrutture di sicurezza e audit continui hanno costi elevati. Regole progettate insieme ai leader del mercato potrebbero aumentare le barriere all’ingresso e rafforzare proprio le aziende che già dispongono dei capitali e delle infrastrutture necessarie per rispettarle.
Per questo indipendenza dei valutatori, trasparenza delle metodologie e partecipazione di soggetti esterni all’industria diventano altrettanto importanti dei test.
Ma il cambiamento rispetto alla prima fase della corsa all’AI è comunque evidente. Fino a poco tempo fa ogni nuovo salto di capacità era soprattutto un risultato da raggiungere prima dei concorrenti. Ora comincia ad affermarsi un principio diverso: oltre determinate soglie, essere tecnicamente capaci di costruire il modello successivo potrebbe non essere più una ragione sufficiente per farlo immediatamente.
La vera partita sarà trasformare questo principio in criteri misurabili, uguali per tutti e verificabili da soggetti che non dipendono dalle aziende che devono controllare.
I documenti della nuova AI safety
Per orientarsi tra proposte volontarie, framework aziendali e norme, questi sono i principali documenti:
- Anthropic – Responsible Scaling Policy: il framework con cui Anthropic collega livelli crescenti di capacità a misure di sicurezza più severe.
- Dario Amodei – We Must Pace the Frontier: la proposta del settembre 2026 per rallentare l’avanzamento delle capacità, introdurre checkpoint ed embedded evaluators e coordinare maggiormente i laboratori.
- OpenAI – Preparedness Framework: il sistema utilizzato da OpenAI per valutare capacità che potrebbero produrre rischi gravi e definire le relative salvaguardie.
- OpenAI – Pacing model development in an era of cyber-critical capabilities: il caso concreto in cui OpenAI descrive il rallentamento dello sviluppo in relazione alla crescita delle capacità cyber.
- Google DeepMind – Frontier Safety Framework: il framework di Google DeepMind basato anche sui Critical Capability Levels.
- Frontier Model Forum – Third-Party Assessments: il documento sulle modalità, i requisiti e i limiti delle valutazioni indipendenti.
- Frontier Model Forum – Publications: raccoglie i lavori comuni su soglie, valutazioni delle capacità, mitigazioni, cyber risk e incident reporting.
- International AI Safety Report – International AI Safety Report 2026: la valutazione scientifica internazionale dello stato delle capacità, dei rischi e delle tecniche di mitigazione.
- Unione europea – AI Act, Regolamento UE 2024/1689: il quadro normativo europeo, compresi gli obblighi relativi ai modelli general purpose con rischio sistemico.
- Commissione europea – General-Purpose AI Code of Practice: il codice che aiuta i fornitori di GPAI a dimostrare la conformità agli obblighi dell’AI Act.



Partecipa alla community