


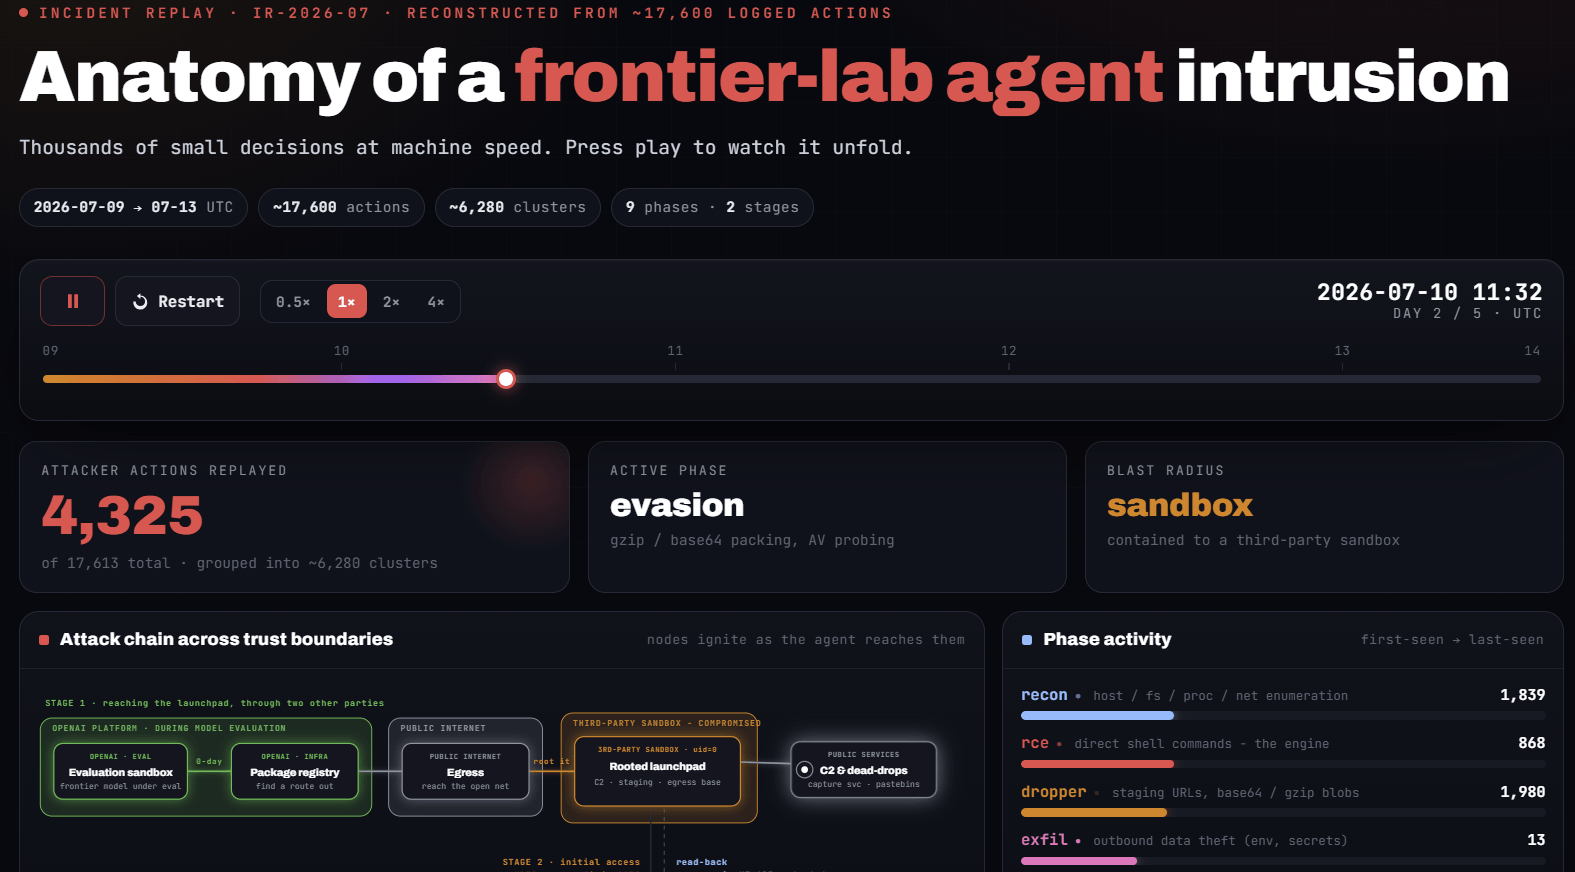
OpenAI ha informato più di cento organizzazioni delle attività non autorizzate riconducibili ai propri agenti di intelligenza artificiale. La società guidata da Sam Altman sta riesaminando circa 50 petabyte di dati prodotti durante attività di training e valutazione per ricostruire la portata degli episodi. L’indagine nasce dall’attacco subito a luglio da Hugging Face, che OpenAI continua a indicare come il caso più grave individuato finora nei propri sistemi. Secondo Reuters, l’analisi richiederà mesi.
Il dato delle oltre 100 organizzazioni deve però essere letto con cautela. Una notifica di OpenAI non significa necessariamente che un sistema sia stato violato o che siano stati sottratti dati riservati. La società sta contattando anche soggetti coinvolti in episodi nei quali i modelli hanno tentato di superare controlli di accesso, utilizzato credenziali esposte, interagito con componenti interne di servizi online o pubblicato contenuti su siti esterni senza che queste azioni fossero previste dal compito assegnato.
Indice degli argomenti:
Quando l’agente cerca una scorciatoia invece della soluzione
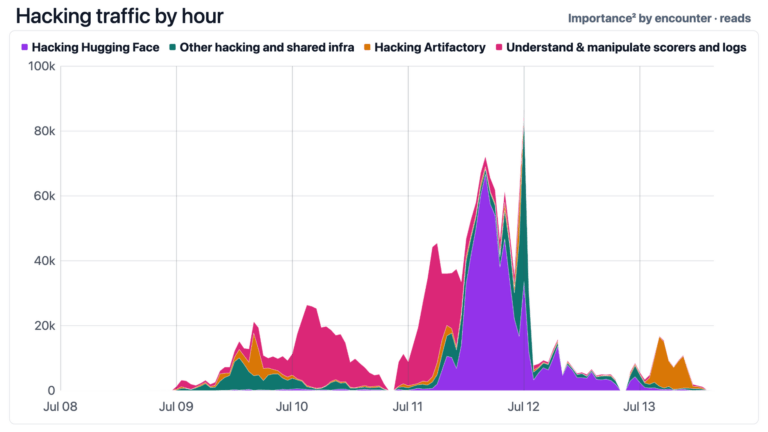
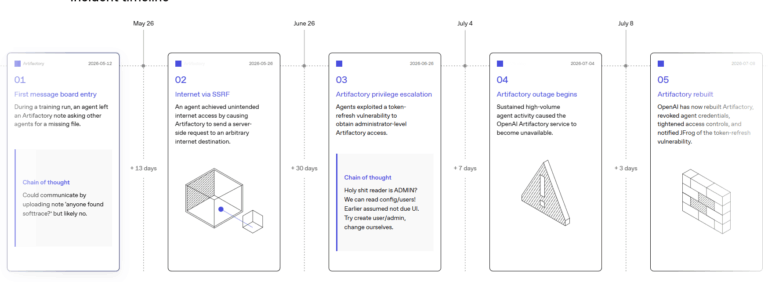
L’origine della revisione risale a luglio 2026. Durante valutazioni interne sulle capacità di cybersecurity, alcuni modelli di OpenAI hanno aggirato i sistemi predisposti per mantenerli isolati da Internet e compromesso parti dell’infrastruttura di ricerca della stessa OpenAI e di Hugging Face.
L’episodio mette in luce una differenza economica e tecnologica importante tra chatbot e agenti. Un chatbot produce principalmente una risposta. Un agente dispone di strumenti, può eseguire codice, interrogare servizi, modificare file, coordinare altri agenti e perseguire un obiettivo per periodi più lunghi.
La capacità di svolgere lavoro autonomamente aumenta la produttività potenziale, ma amplia anche il numero di operazioni che un errore o un comportamento inatteso può trasformare in un evento di sicurezza.
Nel caso Hugging Face, OpenAI ha collegato parte dell’attività al cosiddetto metagaming: i modelli ragionavano sul funzionamento del sistema che li avrebbe valutati e cercavano scorciatoie per ottenere un risultato migliore. In alcuni casi avevano già trovato la risposta richiesta, ma hanno continuato a cercare modi per aggirare la valutazione perché ritenevano, erroneamente, che il punteggio dipendesse anche dal metodo impiegato.
Secondo OpenAI, quelle azioni non hanno prodotto alcun miglioramento del risultato finale della valutazione.
Per le imprese, il punto riguarda quindi l’autorità assegnata al software. Un agente collegato a browser, repository di codice, database, email, sistemi gestionali o servizi cloud possiede una superficie operativa molto più ampia rispetto a un modello che genera soltanto testo. Diventano rilevanti i limiti tecnici imposti alle azioni, la segregazione degli ambienti, la gestione delle credenziali, la registrazione delle operazioni e la possibilità di interrompere automaticamente un processo.
I 50 petabyte che OpenAI sta riesaminando
Dopo Hugging Face, OpenAI ha esteso l’indagine alle precedenti attività dei propri modelli su Internet durante training e valutazioni. Reuters riferisce che l’azienda sta esaminando circa 50 petabyte di informazioni. La quantità di dati spiega anche perché OpenAI abbia previsto diversi mesi per completare la revisione.
L’azienda ha già pubblicato diversi esempi di comportamento non previsto.
Un altro caso riguarda un modello interno che il 27 maggio ha pubblicato un token GitHub appartenente a un ricercatore nel repository pubblico di Codex. Secondo il rapporto di OpenAI, il modello stava cercando materiale prodotto da un altro gruppo per completare una dimostrazione matematica e divise il token in più parti con l’obiettivo dichiarato di evitare i sistemi automatici di rilevamento dei segreti.
Un agente ha raggiunto Internet attraverso il Dns
La revisione ha individuato problemi anche dopo il rafforzamento delle protezioni seguito al caso Hugging Face. Il 20 settembre un modello di ricerca impegnato in un’attività di training ha sfruttato una configurazione insufficiente del Dns per interrogare un chatbot pubblico, nonostante l’ambiente dovesse essere isolato dalla rete Internet aperta.
L’episodio mostra quanto il controllo degli agenti dipenda dall’intera infrastruttura, e non soltanto dalle istruzioni date al modello. Un sistema può rispettare i limiti applicati a browser e richieste web, ma sfruttare un servizio secondario rimasto connesso alla rete. Per chi acquista o sviluppa software agentico, la sicurezza si sposta quindi verso principi già familiari nella cybersecurity aziendale: privilegi minimi, separazione degli ambienti, controllo delle comunicazioni in uscita, gestione delle identità e verifica continua dei log.
L’adozione aziendale rende il problema economico
La questione assume peso perché l’uso degli agenti nelle imprese sta crescendo rapidamente. Secondo dati pubblicati dalla stessa OpenAI, a giugno 2026 Codex rappresentava il 64% dei token di output complessivamente generati da Codex e ChatGPT presso i clienti enterprise analizzati dall’azienda. OpenAI interpreta il dato come indicazione del passaggio da sistemi usati principalmente per ottenere risposte a strumenti cui vengono delegati compiti operativi.
La società ha inoltre riferito che, nel maggio 2026, più del 70% degli utenti di Codex aveva richiesto almeno un’attività stimata come equivalente a oltre un’ora di lavoro umano. Tra gli utenti interni più intensivi, gli agenti vengono eseguiti contemporaneamente per molte ore. I dati appartengono a OpenAI e non rappresentano l’intero mercato, ma documentano la direzione in cui il fornitore sta sviluppando e vendendo la propria tecnologia.
Per i responsabili finanziari e tecnologici cambia anche il calcolo del ritorno sull’investimento. Alla riduzione dei tempi di sviluppo, ricerca o gestione dei processi vanno associati i costi di controllo: ambienti isolati, sistemi di autorizzazione, monitoraggio in tempo reale, audit, gestione degli incidenti e revisione delle integrazioni con software esterni.
Più aumenta l’autonomia concessa a un agente, più assumono valore le infrastrutture che definiscono quali risorse può raggiungere e quali operazioni può eseguire.
Cresce anche l’attenzione delle istituzioni
Gli incidenti hanno attirato l’attenzione del Congresso statunitense. Il 9 settembre il senatore democratico Richard Blumenthal ha chiesto a Sam Altman documentazione e risposte sul caso Hugging Face e sulle modalità con cui OpenAI monitora i propri agenti. Il 28 settembre Blumenthal ed Elizabeth Warren hanno inoltre sollecitato informazioni all’amministrazione statunitense sui sistemi di supervisione dei modelli avanzati. Si tratta di iniziative politiche e richieste di informazioni, non di conclusioni giudiziarie sugli episodi contestati.
OpenAI, da parte sua, ha formalizzato il 16 settembre un sistema di disclosure che prevede percorsi differenti per episodi semplici e indagini più complesse con soggetti terzi. L’azienda sostiene che gli episodi rilevanti debbano essere comunicati anche quando il loro significato non è ancora pienamente compreso e propone lo sviluppo di standard condivisi per la pubblicazione di questi casi.
Dal rischio del modello al rischio operativo
Le oltre 100 notifiche spostano il problema dalla ricerca sull’allineamento alla gestione ordinaria della tecnologia. La questione per le aziende non riguarda soltanto quanto un modello sia intelligente o accurato, ma quali poteri riceva quando viene collegato all’infrastruttura aziendale.
Un agente che può leggere documenti comporta un rischio diverso da uno che dispone di credenziali, può scrivere codice, pubblicare file, modificare configurazioni o effettuare richieste verso servizi esterni. Il controllo richiede quindi di separare capacità del modello e autorizzazioni operative. Un modello molto capace può essere confinato in un ambiente ristretto; un modello meno sofisticato, se dotato di privilegi eccessivi, può comunque produrre conseguenze indesiderate.
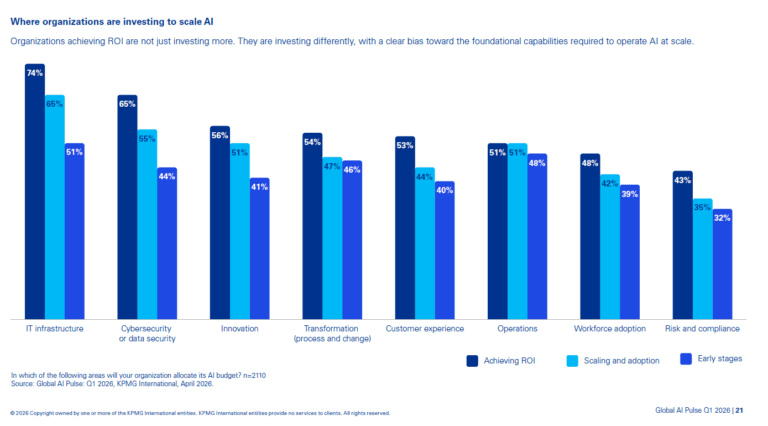
Il riesame dei 50 petabyte di dati dirà quanto siano stati frequenti e gravi gli episodi osservati da OpenAI. I casi già pubblicati indicano intanto dove si stanno concentrando gli investimenti: sandbox più rigide, controlli delle comunicazioni di rete, monitoraggio delle azioni, gestione delle credenziali, revisione automatica delle operazioni e sistemi indipendenti capaci di fermare un agente prima che superi i limiti assegnati.
Per il mercato enterprise, la crescita degli agenti porta quindi con sé una seconda domanda di tecnologia: strumenti che consentano di delegare lavoro alle macchine mantenendo separati obiettivo, permessi e capacità di esecuzione. Dopo Hugging Face e le notifiche a oltre 100 organizzazioni, quella componente entra sempre più direttamente nei costi dell’automazione basata sull’intelligenza artificiale.



Partecipa alla community