


I sistemi cinesi di generazione video stanno conquistando una posizione sempre più visibile nei benchmark internazionali. Una nuova analisi del South China Morning Post ha richiamato l’attenzione sulla presenza di Alibaba, MiniMax e ByteDance nelle zone alte delle classifiche di Artificial Analysis, piattaforma indipendente che confronta i principali modelli generativi disponibili sul mercato. Il dato più evidente riguarda Wan 3.0 di Alibaba, attualmente al primo posto nella categoria text-to-video con generazione audio.
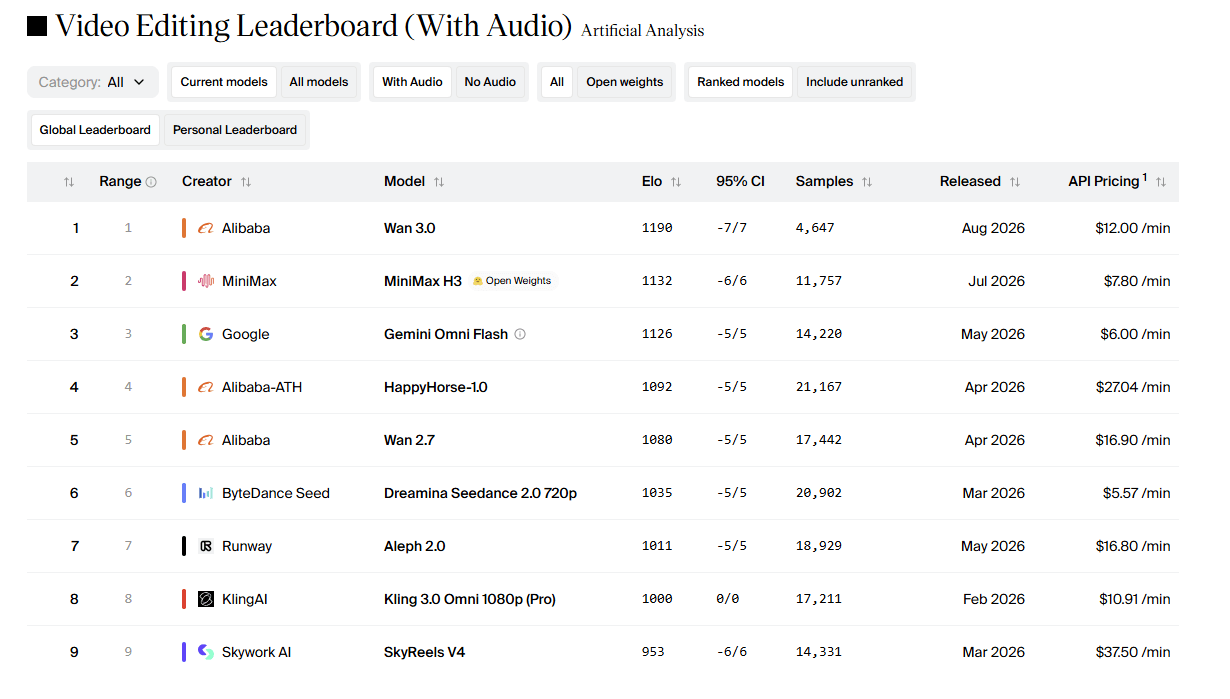
Il risultato non certifica però una superiorità generale dell’industria cinese né identifica un vincitore assoluto della generazione video. Artificial Analysis mantiene classifiche separate per differenti modalità, tra cui text-to-video, image-to-video ed editing, con ulteriori distinzioni tra sistemi che producono audio e modelli che generano soltanto immagini in movimento.
Nella classifica text-to-video senza audio, per esempio, il primo posto appartiene attualmente a Gemini Omni Flash di Google.
Il quadro che emerge è quindi più articolato e mostra una competizione molto serrata fra tecnologie sviluppate negli Stati Uniti e in Cina.
Indice degli argomenti:
Wan 3.0 è primo, ma il margine resta molto ridotto
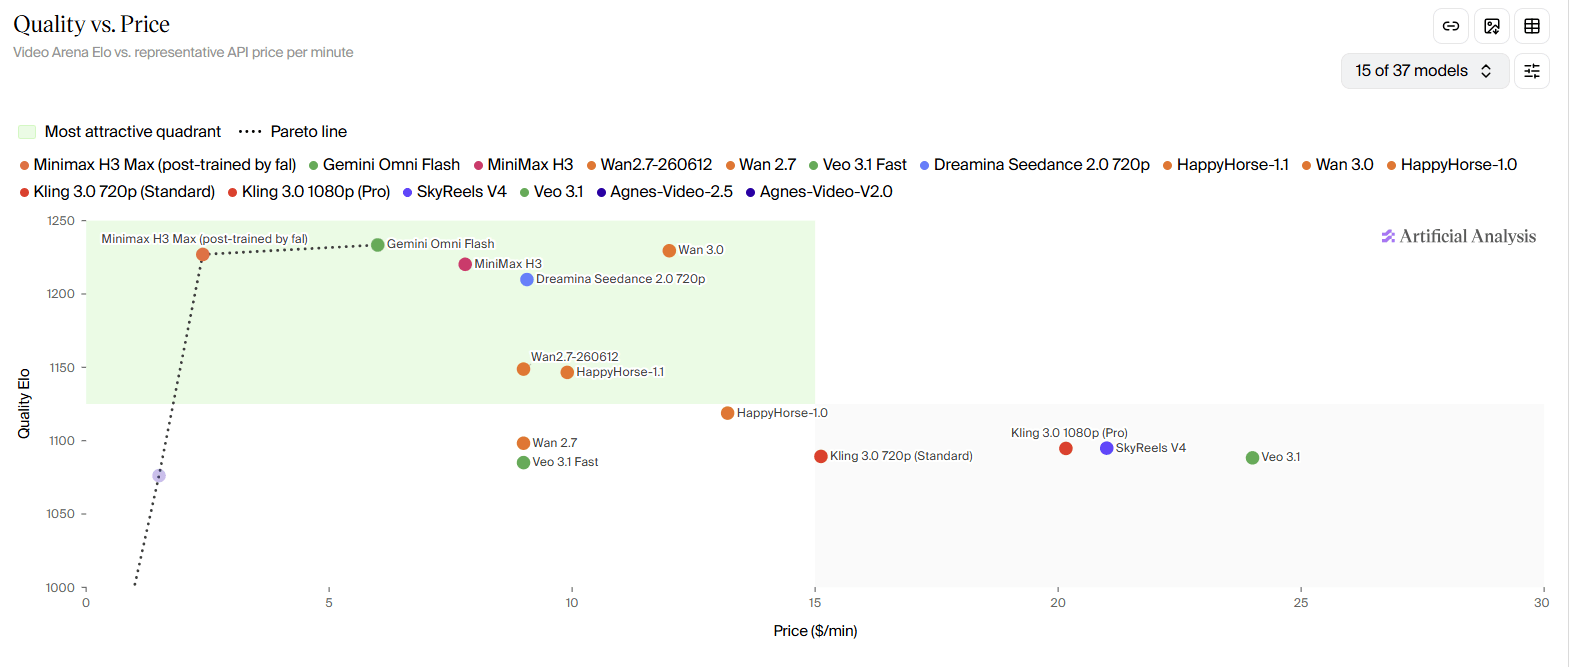
Nel benchmark text-to-video con audio, Wan 3.0 occupa al momento la prima posizione con un punteggio intorno ai 1.240 punti. Subito dietro compare Gemini Omni Flash, mentre una versione di MiniMax H3 sottoposta a ulteriore post-training da fal si trova nella stessa fascia. Seguono il modello originale MiniMax H3 e Dreamina Seedance 2.0 di ByteDance.
La graduatoria deve essere interpretata tenendo conto dell’incertezza statistica. Gli intervalli di confidenza associati alle prime tre posizioni si sovrappongono, quindi la distanza numerica fra Wan 3.0, Gemini Omni Flash e MiniMax H3 Max non permette di sostenere che il modello di Alibaba sia statisticamente superiore agli altri due. La formulazione più rigorosa è che Wan 3.0 guida oggi quella specifica classifica, all’interno di un gruppo di testa molto ravvicinato.
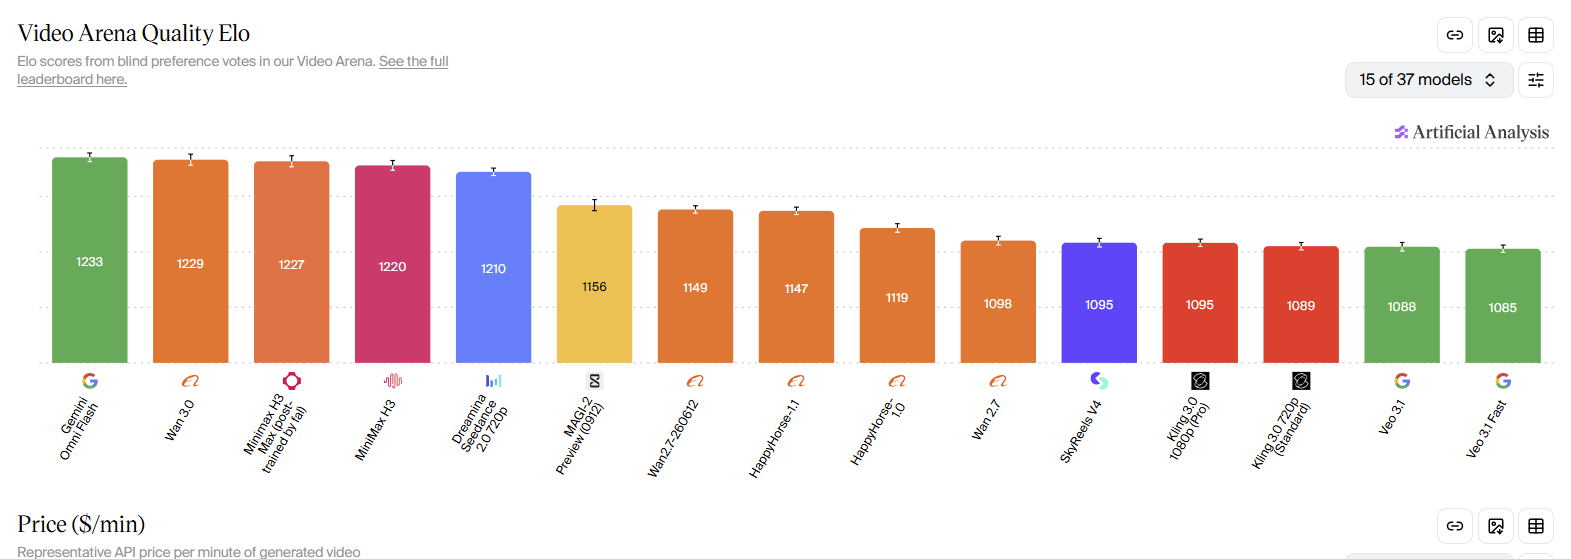
Il numero di valutazioni varia inoltre da modello a modello e continua a crescere. Le posizioni possono quindi modificarsi con l’arrivo di nuovi confronti. Un leaderboard dinamico descrive lo stato della competizione in un determinato momento, non costituisce una graduatoria definitiva.
Come Artificial Analysis misura la qualità dei video
La metodologia utilizzata da Artificial Analysis è basata principalmente su confronti umani alla cieca. Due video prodotti a partire dallo stesso prompt vengono presentati agli utenti senza indicare il modello che li ha generati. La persona sceglie l’output preferito e l’insieme dei confronti viene aggregato attraverso un modello statistico Bradley-Terry, successivamente riportato su una scala simile a quella Elo.
Il metodo riduce l’effetto della notorietà dei marchi e misura direttamente la preferenza degli osservatori. Al tempo stesso non equivale a una valutazione esaustiva della capacità tecnologica di un sistema. Un punteggio elevato può riflettere qualità visiva, realismo, dinamica della scena, resa sonora e piacevolezza complessiva, ma non misura necessariamente nello stesso modo aspetti come affidabilità nel seguire istruzioni molto complesse, continuità di personaggi su sequenze lunghe, controllabilità professionale o capacità di editing.
Artificial Analysis separa inoltre le diverse modalità proprio per evitare confronti impropri. Un filmato con audio sincronizzato non viene giudicato nello stesso bacino di un video privo di audio e un modello di editing non compete direttamente con un sistema text-to-video.
Wan 3.0 punta su durata e input multimodali
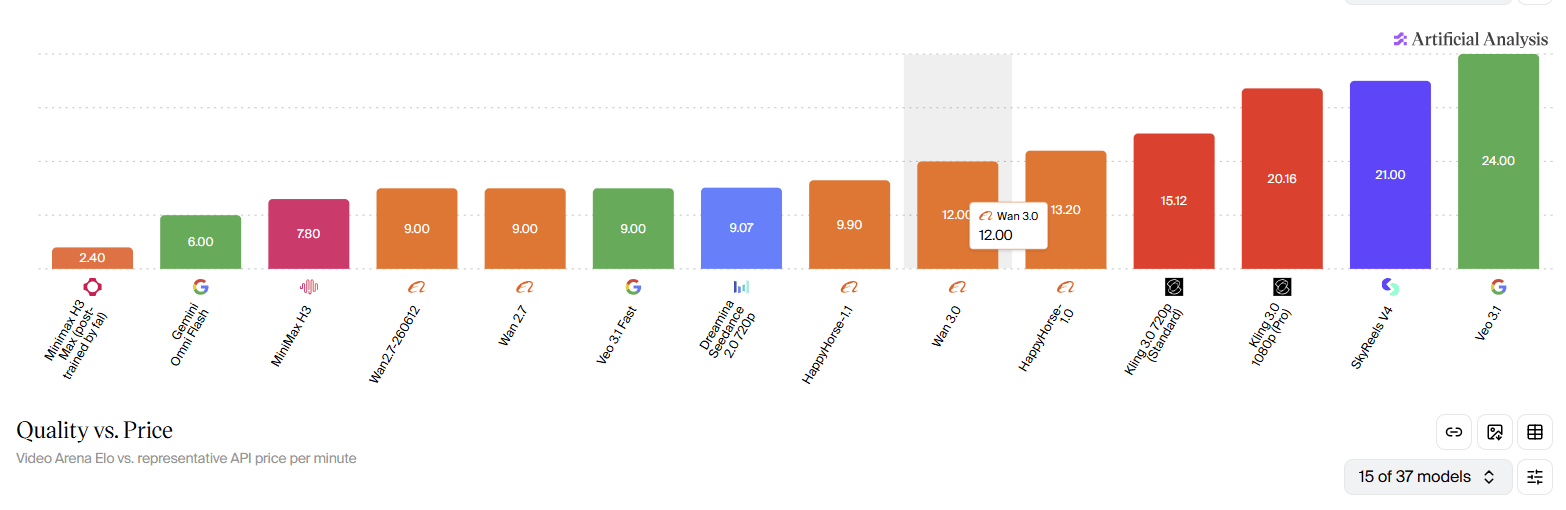
Alibaba ha presentato Wan 3.0 come una piattaforma di generazione audiovisiva capace di produrre filmati fino a 30 secondi in un’unica generazione. La documentazione di Alibaba Cloud indica output fino a 1080p a 30 fotogrammi al secondo e generazione nativa di dialoghi, musica di sottofondo ed effetti sonori.
Un altro elemento caratterizzante è la quantità di materiale che può essere fornita come riferimento. Il sistema accetta testo, immagini, video e audio, oltre a documenti e pagine web, con un massimo dichiarato di venti elementi multimodali per richiesta. Sono previste anche funzioni per utilizzare il primo fotogramma o il primo e l’ultimo fotogramma come vincoli, estendere sequenze ed effettuare operazioni di editing.
Queste caratteristiche non devono essere confuse con risultati ottenuti da valutatori indipendenti. Durata massima, risoluzione e modalità di input sono specifiche documentate dal produttore; affermazioni come maggiore realismo, migliore coerenza dei personaggi o qualità cinematografica appartengono invece alla presentazione commerciale di Alibaba e richiedono verifiche comparative esterne.
MiniMax mostra un’altra strada verso i modelli aperti
La presenza cinese nelle classifiche non dipende soltanto da Alibaba. MiniMax H3 compare tra i primi modelli sia nelle valutazioni con audio sia in quelle senza audio e introduce un elemento differente nella competizione, perché una parte sostanziale del sistema è disponibile con pesi aperti.
Secondo la documentazione di MiniMax, H3 può generare video accompagnati da audio stereo a 32 kHz, con una durata compresa tra quattro e quindici secondi. Il modello base produce immagini con il lato corto a 768 pixel. La pipeline completa può arrivare a 2K attraverso un ulteriore processo di rigenerazione.
È però importante distinguere il modello aperto dall’intero sistema utilizzato commercialmente. H3-Base può essere eseguito localmente, mentre H3-Context-IR, utilizzato per elaborare input multimodali complessi, e H3-Regenerate-2K, necessario per la pipeline ufficiale a maggiore risoluzione, non sono attualmente distribuiti nello stesso modo. MiniMax mette a disposizione questi componenti attraverso i propri servizi. Definire l’intera pipeline H3 completamente open source sarebbe quindi impreciso.
ByteDance porta l’esperienza multimodale dentro Seedance
ByteDance compete nella stessa area con Seedance 2.0, presentato nel febbraio 2026. Il sistema utilizza un’architettura destinata alla generazione congiunta di audio e video e può ricevere quattro tipologie di input, vale a dire testo, immagini, audio e filmati.
Il produttore dichiara progressi nella gestione di scene con movimenti articolati, interazioni tra più soggetti, realismo e controllabilità. Anche in questo caso si tratta di caratteristiche indicate da ByteDance e non devono essere trattate automaticamente come prestazioni superiori rispetto ai concorrenti.
La posizione raggiunta da Dreamina Seedance 2.0 nelle classifiche indipendenti di Artificial Analysis fornisce però un riscontro separato sul fatto che gli output del modello risultano competitivi nei confronti alla cieca.
La presenza simultanea di Alibaba, MiniMax e ByteDance nelle prime posizioni è più significativa del successo temporaneo di un singolo prodotto. Indica che la generazione video cinese dispone ormai di più famiglie tecnologiche capaci di competere ai vertici delle valutazioni internazionali.
La competizione non si riduce a Stati Uniti contro Cina
Attribuire questi risultati a una sola causa sarebbe prematuro. Il South China Morning Post, testata controllata da Alibaba, cita analisti che collegano la crescita cinese alla diffusione dei video brevi, alla velocità di sviluppo dei prodotti, alla domanda del mercato domestico e alla pressione sui prezzi. Sono interpretazioni plausibili, ma non dimostrano un rapporto causale e vanno separate dai dati osservabili nei benchmark.
Ciò che può essere affermato con maggiore sicurezza è che la competizione nell’AI video è oggi distribuita tra numerosi sviluppatori e non replica necessariamente gli equilibri osservati nei modelli linguistici. Google rimane ai vertici di diverse categorie, mentre sistemi di Alibaba, MiniMax, ByteDance e altri produttori asiatici compaiono frequentemente nelle prime posizioni.
Il confronto si sta inoltre allargando oltre la qualità visiva di brevi clip. Durata, sincronizzazione dell’audio, capacità di utilizzare materiali di riferimento, continuità dei soggetti, editing e prezzo dell’inferenza stanno diventando parametri sempre più rilevanti per l’uso professionale. È su questa combinazione di fattori, più che su una singola posizione in classifica, che si misurerà la maturità industriale dei sistemi di generazione video.
Wan 3.0 offre quindi una fotografia significativa, ma non definitiva. Oggi guida uno dei benchmark più osservati per il text-to-video con audio. Il risultato realmente importante è però più ampio: la frontiera della generazione audiovisiva non è concentrata in un unico laboratorio o in un solo Paese e i principali modelli cinesi sono ormai parte stabile del gruppo che compete per definirne gli standard tecnologici.
Bibliografia
Artificial Analysis, Text to Video Leaderboard – Top AI Video Models, consultato il 29 agosto 2026. urlArtificial Analysis – classifica text-to-videohttps://artificialanalysis.ai/video/leaderboard/text-to-video
Artificial Analysis, Video Generation Benchmarking Methodology, consultato il 29 agosto 2026. urlArtificial Analysis – metodologia dei benchmark videohttps://artificialanalysis.ai/video/methodology
Alibaba Cloud Model Studio, Wan3.0 Video Generation, aggiornato il 25 agosto 2026. urlAlibaba Cloud – documentazione tecnica Wan 3.0https://www.alibabacloud.com/help/en/model-studio/wan3-video-generation-guide
Alibaba Cloud Model Studio, Wan 3.0, documentazione ufficiale del modello. urlAlibaba Cloud – Wan 3.0https://modelstudio.console.alibabacloud.com/model-releases/wan3.0-video
MiniMax, Open General Intelligence: MiniMax H3 Is Now Open Source, 3 agosto 2026. urlMiniMax – documentazione H3https://www.minimax.io/news/minimax-h3-open-source
ByteDance Seed, Seedance 2.0 Official Launch, 12 febbraio 2026. urlByteDance Seed – Seedance 2.0https://seed.bytedance.com/en/blog/seedance-2-0-%E6%AD%A3%E5%BC%8F%E5%8F%91%E5%B8%83
South China Morning Post, China leverages short-video ecosystem, lower costs to carve out lead in AI video, 29 agosto 2026. urlSouth China Morning Post – analisi sull’AI video cinesehttps://www.scmp.com/tech/tech-trends/article/3365605/china-leverages-short-video-ecosystem-lower-costs-carve-out-lead-ai-video




Partecipa alla community