


Il software è il punto di partenza più immediato, mentre la progettazione di chip e hardware appare tra le prossime applicazioni industriali più promettenti dell’intelligenza artificiale. Cybersecurity, ricerca sui materiali e biologia offrono altre opportunità di valore, ma chiedono verifiche specialistiche. Finanza e diritto, per contro, mostrano quanto sia ancora pericoloso affidare a un agente AI una decisione complessa dall’inizio alla fine.
È la mappa che emerge da GDPx: Measuring Frontier Model Capabilities Across the Most Valuable Domains, il nuovo benchmark pubblicato il 2 novembre 2026 da SemiAnalysis, società di ricerca specializzata nell’industria dei semiconduttori e dell’AI. Gli analisti hanno selezionato undici ambiti nei quali ritengono che i modelli più avanzati possano generare elevati ritorni economici nei prossimi anni e li hanno messi alla prova con attività simili a quelle svolte da professionisti.
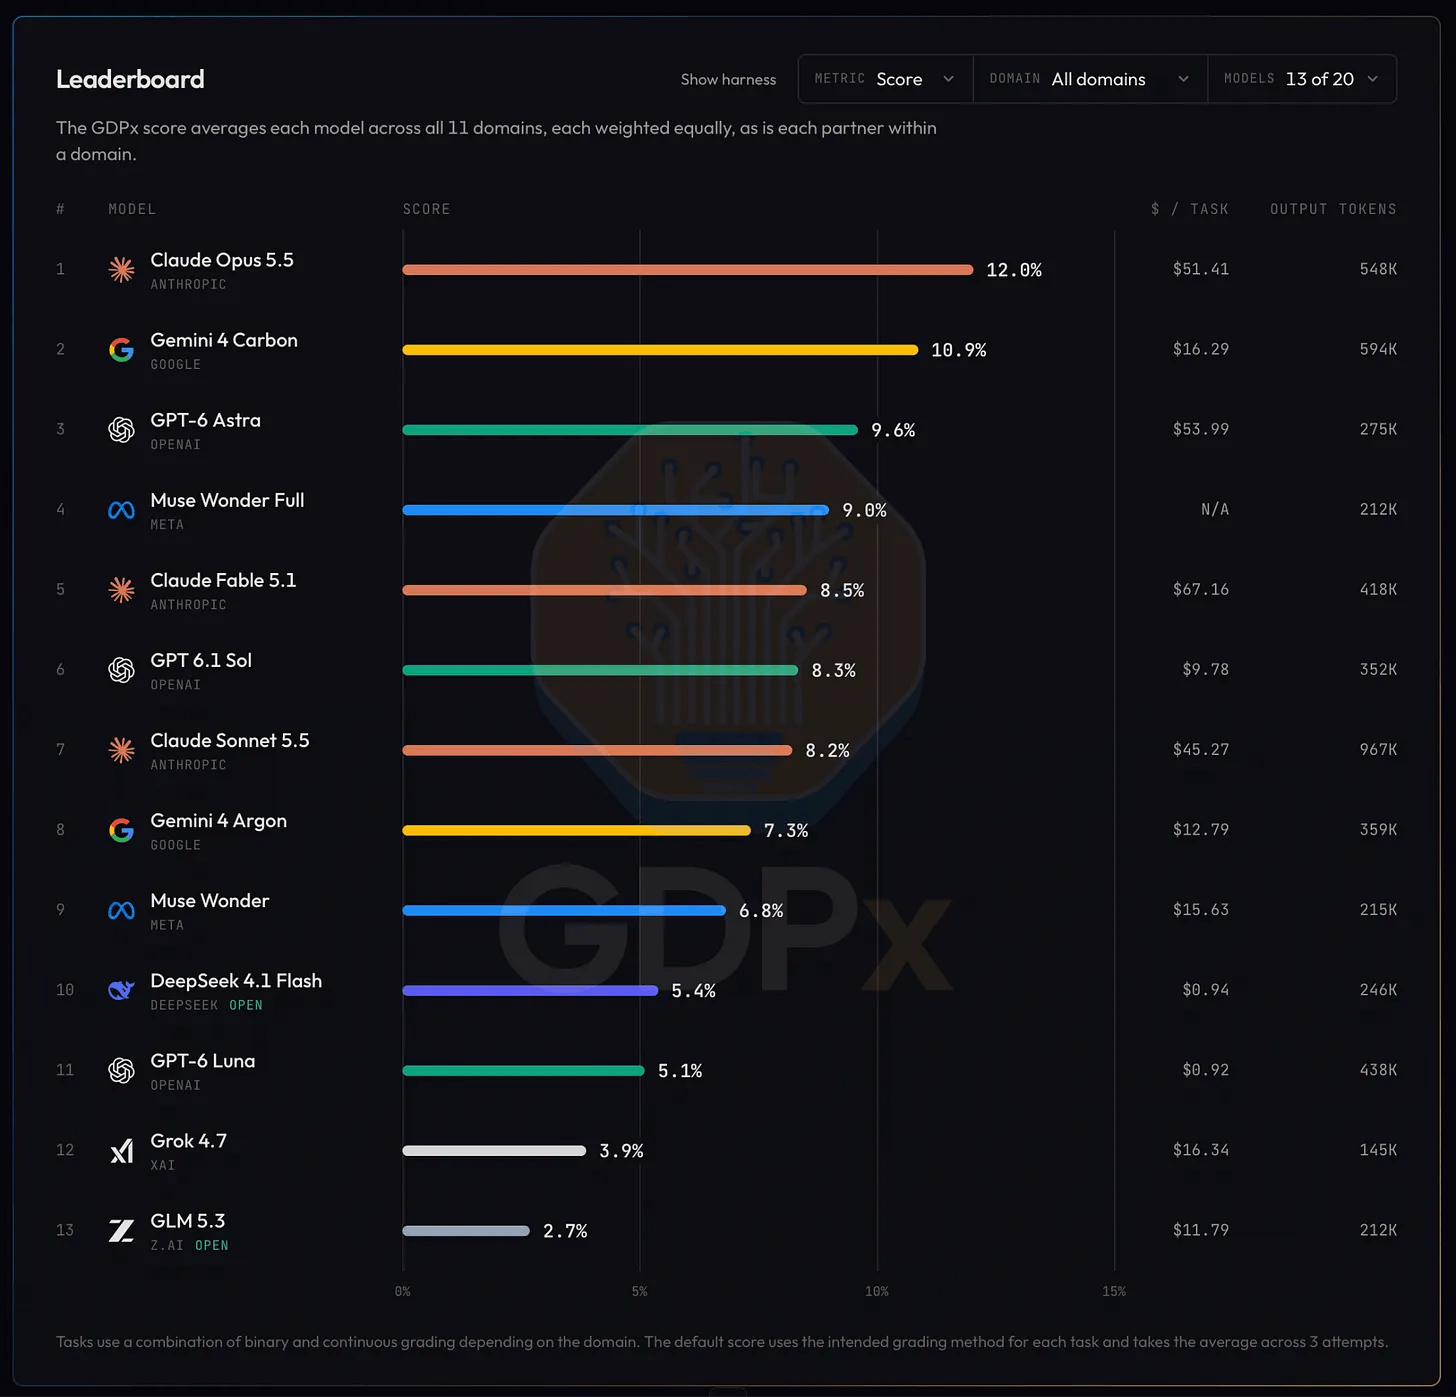
La sorpresa è che il modello migliore, Claude Opus 5.5, ottiene soltanto 12 punti su 100 nel punteggio complessivo. Seguono Gemini 4 Carbon con 10,9 e GPT-6 Astra con 9,6. Sono prove volutamente molto difficili: non si tratta del tasso di successo su tutte le normali attività d’ufficio, né di un indice del ritorno economico. Il messaggio per le imprese è invece preciso: scegliere il processo giusto conta oggi almeno quanto scegliere il modello più potente.
Indice degli argomenti:
Che cosa misura GDPx e perché guarda ai settori ad alto valore
GDPx comprende 206 compiti in 11 ambiti, sviluppati con 14 partner specializzati. Gli agenti devono operare in ambienti realistici: esplorare una sala dati di un’acquisizione, modificare un progetto meccanico, correggere una vulnerabilità informatica o lavorare su misurazioni di laboratorio. Il limite ordinario è di otto ore per attività; per il punteggio principale la ricerca valuta il risultato ottenuto in un tentativo e ripete la prova tre volte, attribuendo lo stesso peso agli undici domini.
La scelta dei settori nasce da una tesi economica: secondo SemiAnalysis, una parte rilevante dei futuri ricavi dell’AI potrebbe concentrarsi dove un miglioramento del lavoro specialistico vale molto, anziché distribuirsi uniformemente tra tutti i mestieri. Gli autori ipotizzano persino che i primi mille miliardi di dollari di ricavi dell’AI si concentreranno in settori con un elevato ritorno sull’investimento.
È una previsione degli analisti, non un ricavo già osservato e neppure una classifica quantitativa del ROI per settore.
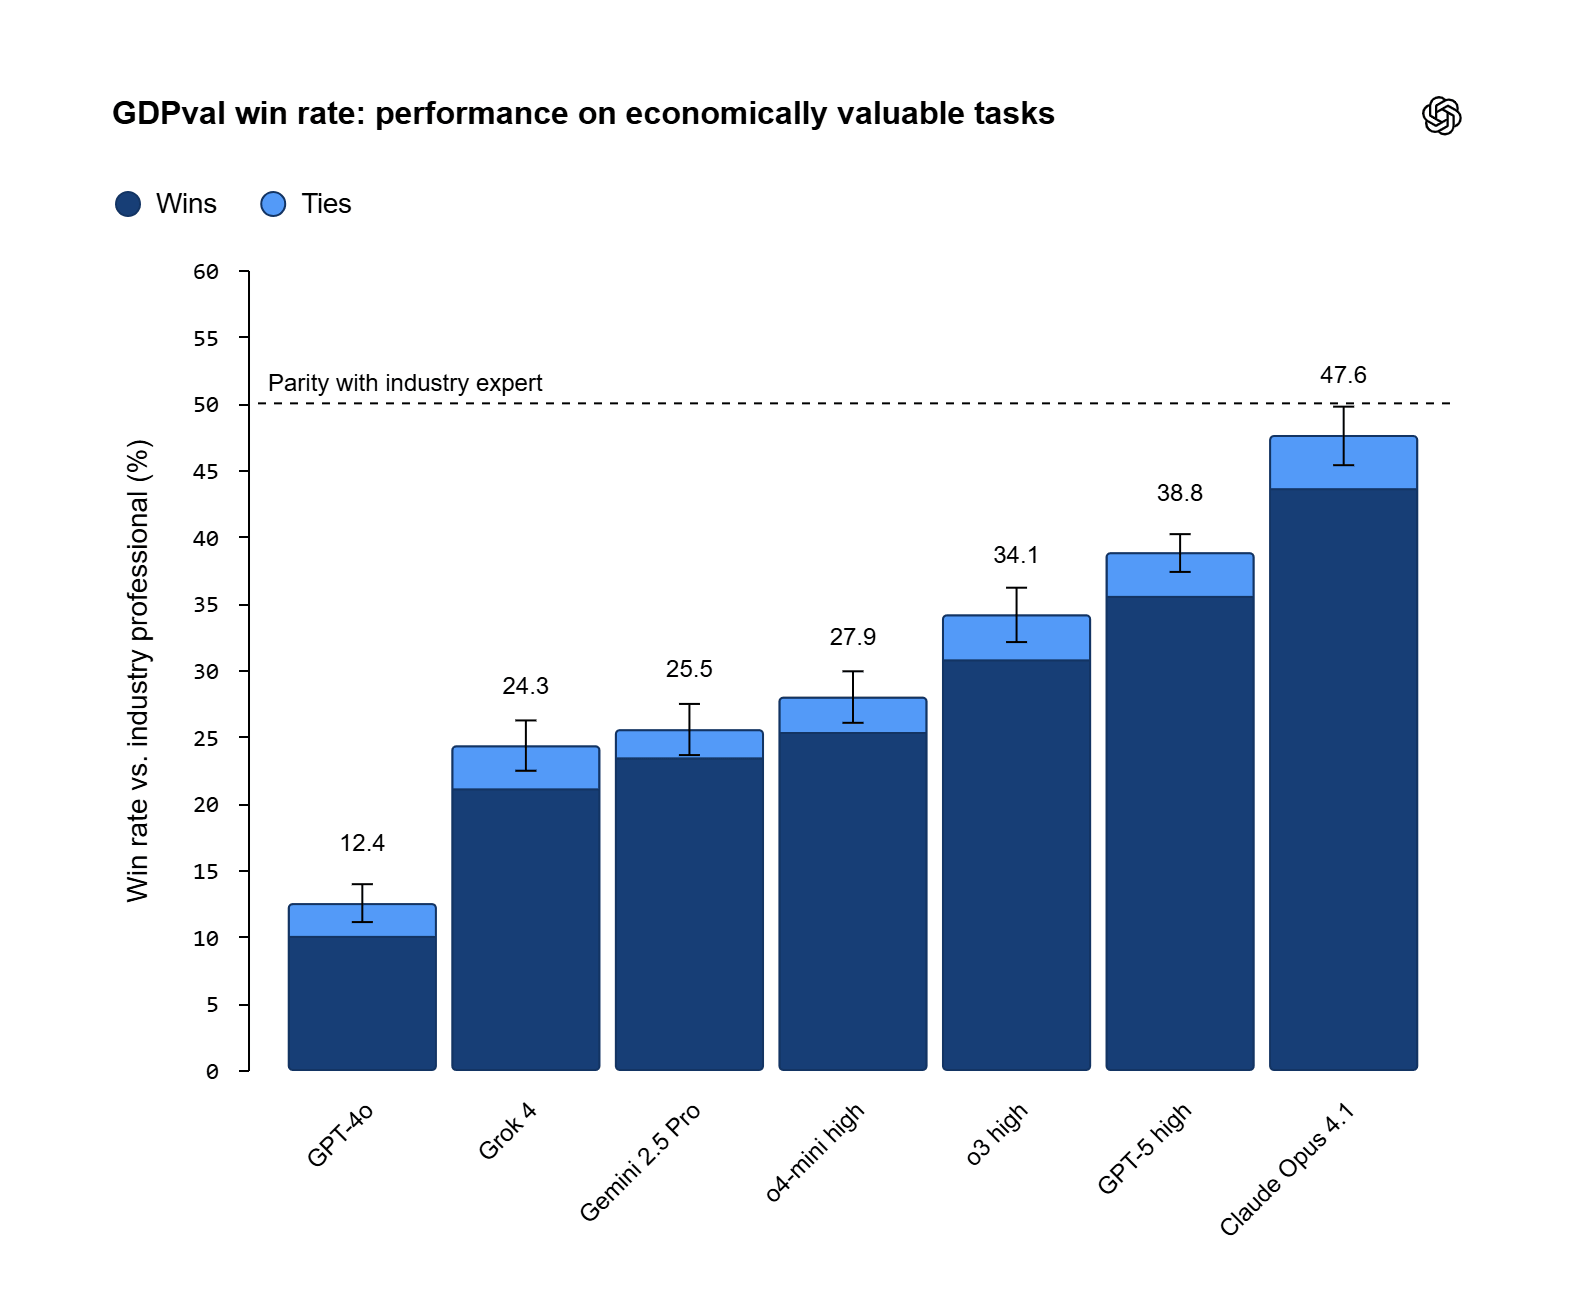
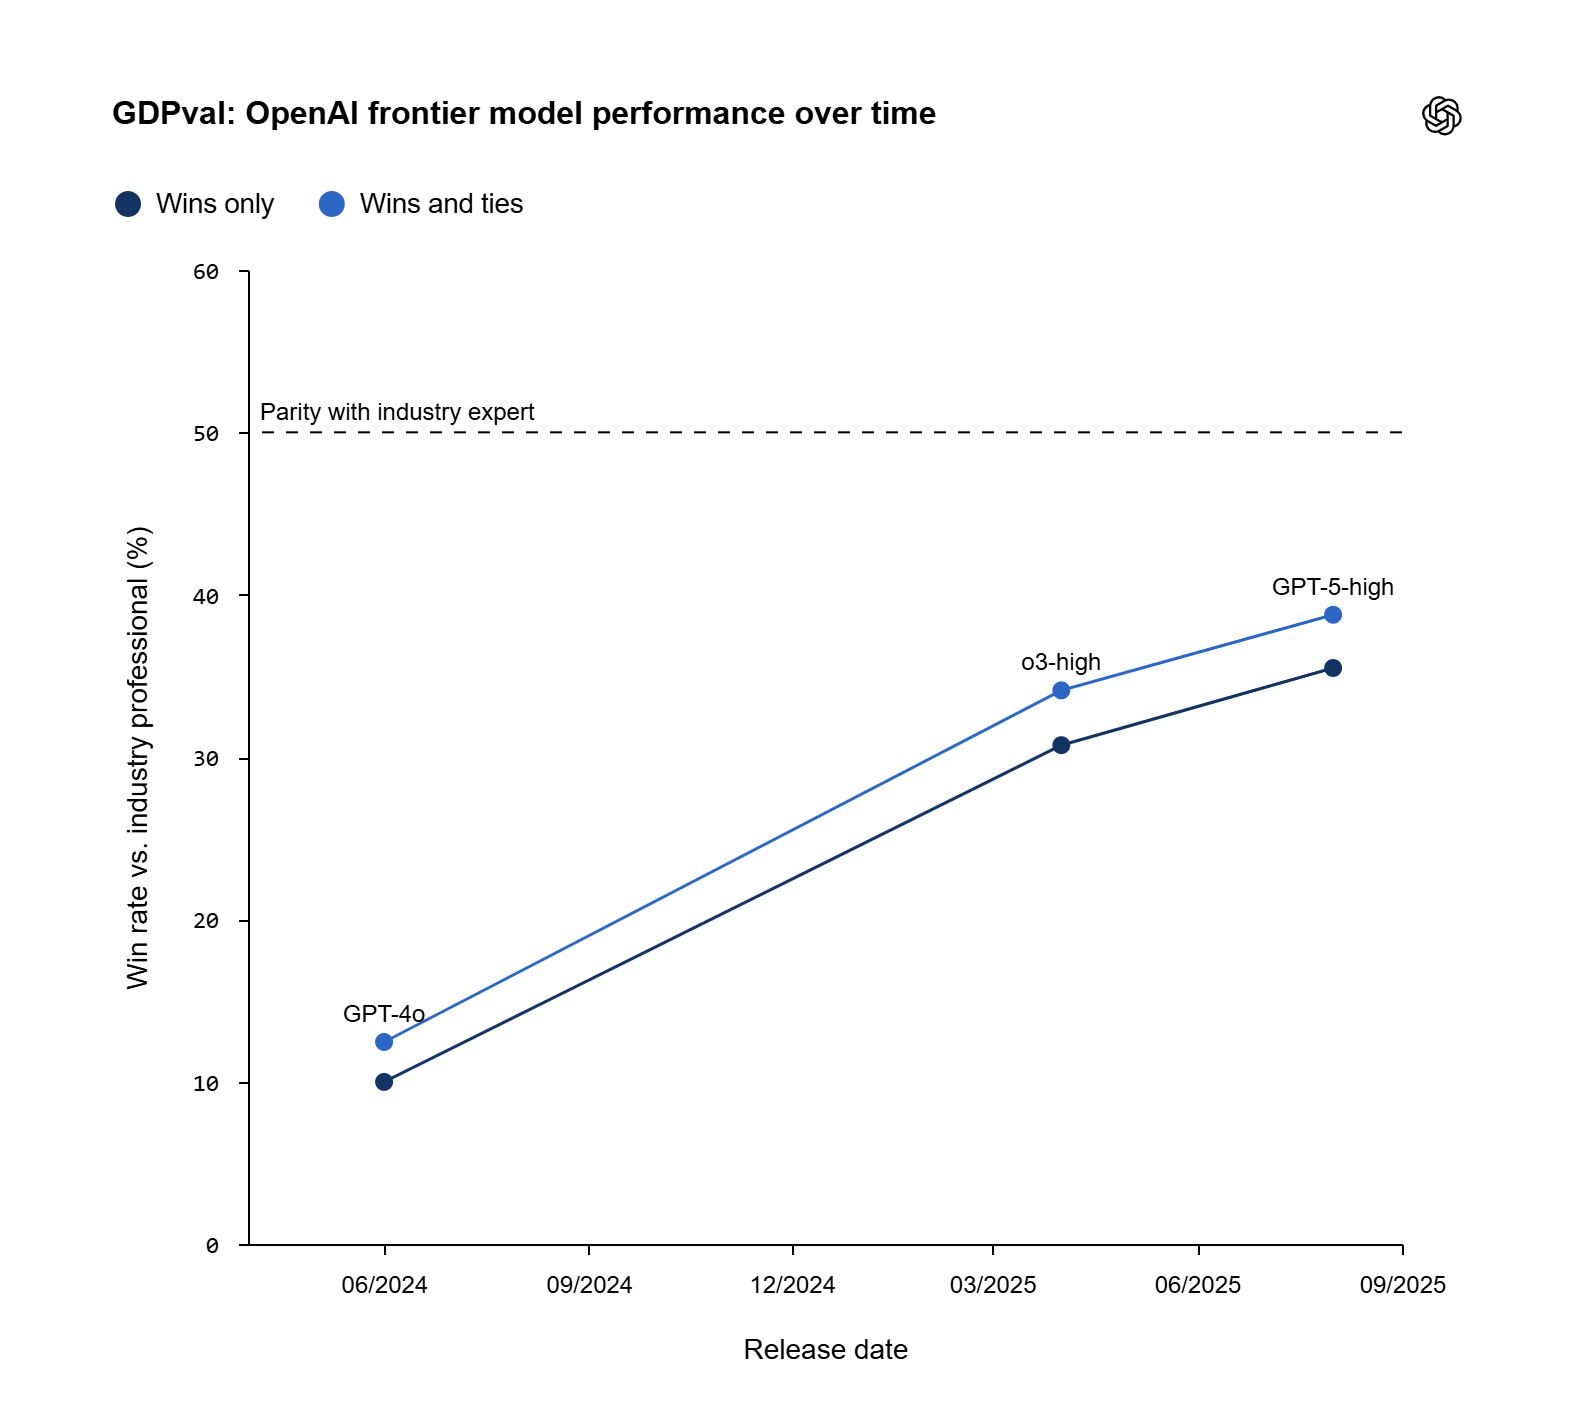
L’impostazione differisce da quella di GDPval di OpenAI, che studia il lavoro in 44 occupazioni sulla base di compiti e prodotti professionali. SemiAnalysis critica soprattutto i test che consegnano tutte le informazioni al modello in un unico prompt: un dipendente, invece, deve cercare i documenti giusti, distinguere quelli validi dai superati, usare software e prendere decisioni sotto vincoli reali. GDPx esamina proprio questa capacità di portare a termine un processo di lavoro.
Sviluppo software: il primo terreno per un investimento misurabile
Per un’azienda che non progetta semiconduttori o sviluppa farmaci, l’occasione più accessibile resta lo sviluppo e la manutenzione del software. GDPx include 15 prove costruite da Datacurve su repository reali: correggere errori, introdurre funzioni, aggiornare componenti e rispettare il comportamento del sistema esistente. È un ambito nel quale gli agenti AI sono già più maturi rispetto ad altre professioni considerate dalla ricerca.
Ma il problema non è più soltanto scrivere il codice. Nell’analisi dei tentativi non riusciti, il 76% dei fallimenti coinvolge requisiti collegati alla richiesta principale: compatibilità con il resto dell’applicazione, casi particolari e integrazioni. I modelli spesso risolvono il problema visibile e trascurano l’effetto della modifica sul programma nel suo insieme. Nel test pubblico dedicato a Git-LFS, nessuno dei 25 tentativi esaminati ha superato tutte le condizioni.
Per una direzione IT la conseguenza è concreta: partire da correzione di bug, generazione di test, aggiornamento di componenti e piccoli sviluppi circoscritti, misurando non le righe di codice prodotte, ma quante modifiche superano test e revisione senza creare nuovi difetti. L’adozione diventa più convincente quando l’AI lavora dentro repository, controlli automatici e procedure di approvazione già esistenti.
Chip e hardware: l’AI entra nei processi di progettazione industriale
Una seconda opportunità riguarda chi crea tecnologia e prodotti fisici. SemiAnalysis indica il chip design come possibile nuova grande applicazione dell’AI dopo il coding e prevede un aumento significativo della spesa in questo settore dal 2027. È una previsione esplicita degli autori, non il risultato di una misura di fatturato. GDPx dedica alla progettazione dei semiconduttori 34 compiti, la copertura più ampia tra gli undici domini.
Le prove spaziano dalla verifica dei circuiti alla loro ottimizzazione per prestazioni, consumi energetici e area occupata. Gli agenti devono scrivere test capaci di scoprire errori, trovare una configurazione migliore e superare verifiche tecniche. Claude Opus 5.5 guida il confronto per chip design, ma i ricercatori segnalano difficoltà di ragionamento architetturale e test che non scoprono guasti introdotti dalle ottimizzazioni. È per questo che la verifica automatica del progetto resta parte essenziale della proposta di valore.
Il ragionamento si estende alla progettazione meccanica ed elettronica. Nei 21 compiti di hardware design, costruiti da Beautiful Machines, l’AI usa strumenti come SolidWorks, Siemens NX, Fusion 360 e KiCad. In un test deve riprogettare per lo stampaggio a iniezione il contenitore di un componente che prima era stato prototipato in 3D, senza compromettere gli incastri, il movimento e la possibilità di fabbricarlo. In altri casi lavora sui percorsi degli utensili o sulla disposizione delle connessioni di una scheda elettronica.
Qui possono trovare interesse anche imprese manifatturiere italiane che non progettano chip: revisioni di disegni CAD, preparazione delle lavorazioni, verifica delle tolleranze e controllo dei progetti elettronici sono attività da sperimentare con un tecnico responsabile. Il beneficio va misurato sul tempo necessario per arrivare a un progetto approvato e sui difetti emersi in simulazione o in produzione, non sulla velocità con cui l’agente genera il primo disegno.
Cybersecurity: valore nella ricerca e correzione delle vulnerabilità
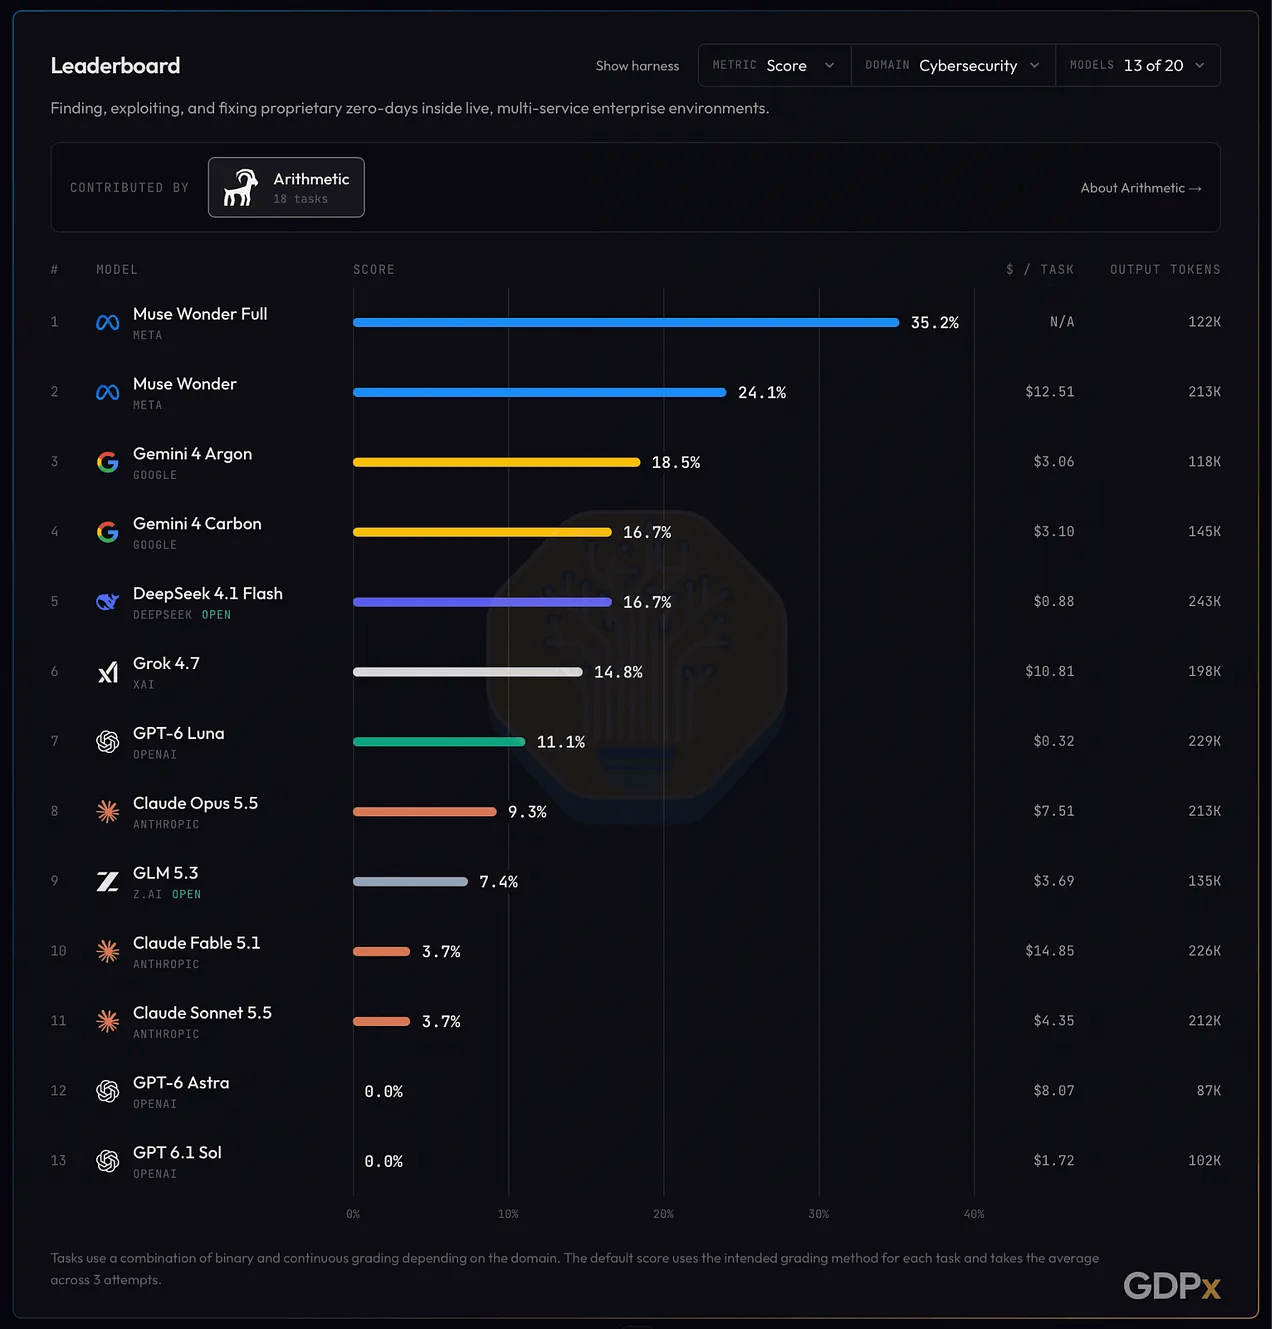
Una terza area può interessare organizzazioni di molti settori, perché quasi tutte devono difendere applicazioni e infrastrutture. Nei 18 compiti di cybersecurity di Arithmetic, gli agenti cercano vulnerabilità sconosciute, verificano se sono sfruttabili e tentano di correggerle in ambienti che replicano servizi aziendali collegati fra loro, con credenziali, autorizzazioni e segreti da proteggere.
Il caso è economicamente rilevante perché un’analisi più rapida potrebbe ridurre il tempo in cui un difetto resta esposto. SemiAnalysis mostra, su una prova specifica, che modelli più recenti arrivano allo stesso risultato in 35-50 minuti contro oltre tre ore di una versione precedente. Non è una misura generale di quanto tempo un SOC risparmierà; dimostra però perché nei test di sicurezza conta anche la rapidità con cui un agente raggiunge un risultato verificato.
La direzione operativa è usare l’AI per l’analisi del codice, la ricostruzione delle possibili catene di attacco e la proposta di patch, inizialmente in ambienti isolati e con autorizzazioni rigorosamente limitate. Un agente che identifica un problema non deve poter esplorare liberamente i sistemi di produzione o distribuire una correzione senza revisione.
Materiali e biologia: grande potenziale, ma l’AI non è ancora uno scienziato autonomo
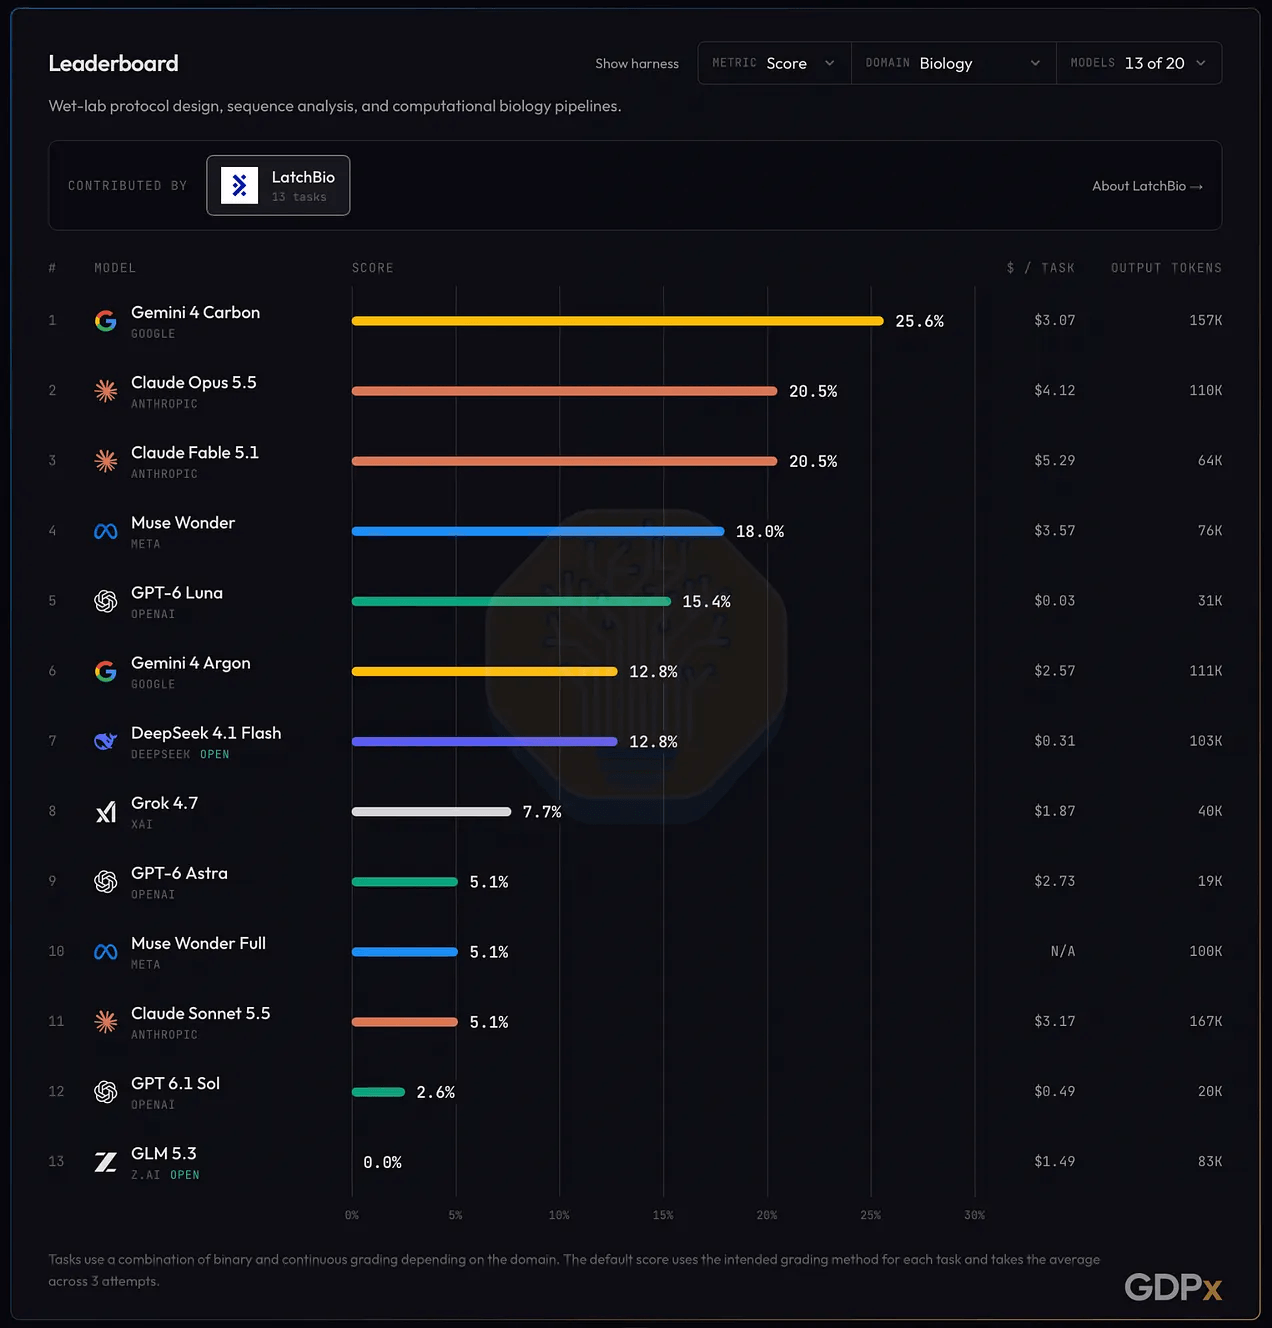
Il valore di un miglioramento di laboratorio può essere enorme: una batteria più durevole, una formulazione chimica migliore o una scelta più efficace nella ricerca di un farmaco. Per questo GDPx considera 23 compiti sui materiali e 13 sulla biologia. In questi casi gli agenti non rispondono a domande teoriche: analizzano dati sperimentali, interpretano misure e devono decidere il passo successivo di una ricerca.
Nella scienza dei materiali i modelli mostrano capacità interessanti nel calcolo e nella scrittura di software scientifico. Il limite è trasformare un’elaborazione coerente in una conclusione fisica affidabile: nelle prove con microscopi elettronici e altri strumenti, alcuni agenti non verificano le ipotesi con cui interpretano le misure e arrivano a ricostruzioni sbagliate. In una prova sulla struttura tridimensionale di un transistor nessun modello recupera integralmente la ricostruzione degli esperti.
La biologia offre un avvertimento analogo. I modelli confondono talvolta correlazioni e cause, applicano test statistici inadeguati o trattano misure ripetute dello stesso campione come osservazioni indipendenti. In una prova su possibili molecole terapeutiche, un risultato apparentemente convincente di uno strumento non coincide con il comportamento osservato nelle cellule; gli agenti faticano a capire quale prova sia più importante per decidere.
La scelta aziendale più sensata è cominciare da analisi preliminari, generazione di ipotesi e automazione di elaborazioni ripetitive, confrontando poi ogni proposta con misure reali e giudizio dei ricercatori. L’AI può abbreviare parte del lavoro scientifico; GDPx non prova ancora che sappia guidare da sola l’intero esperimento.
Finanza e legale: attività costose, ma i test sconsigliano la delega totale
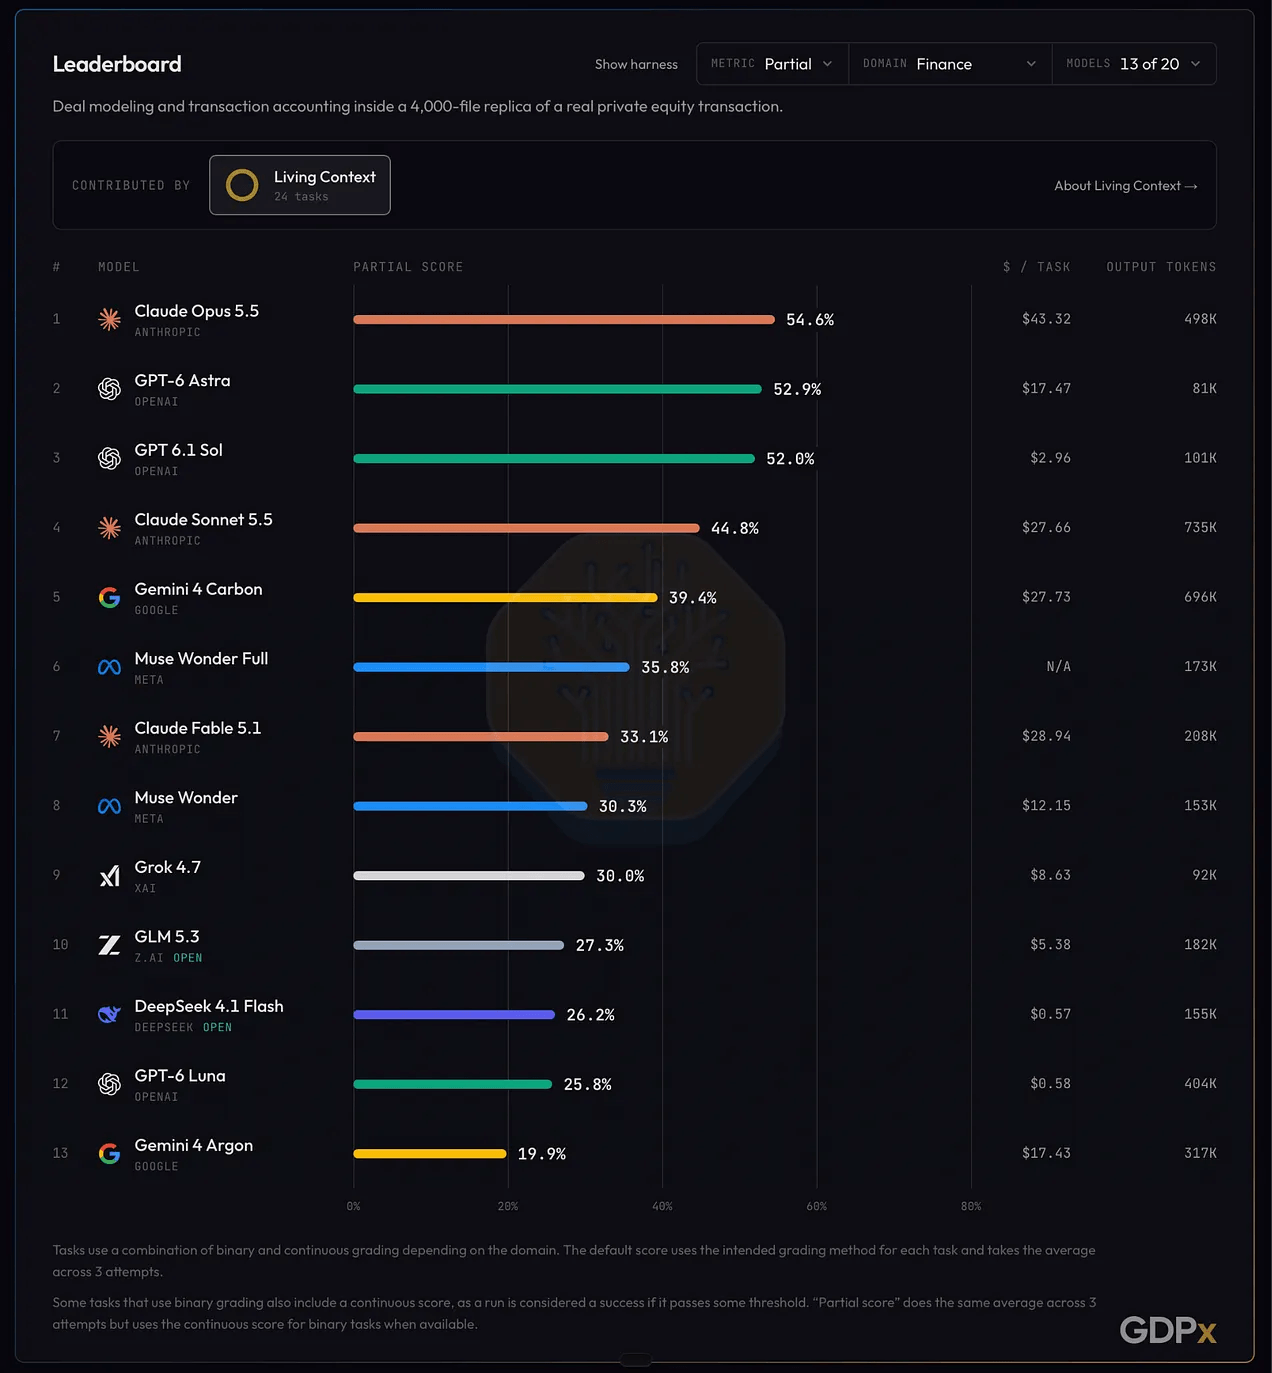
Il benchmark include finanza e diritto perché errori e decisioni di queste professioni hanno un grande peso economico. Proprio qui, però, arriva il risultato più severo: con i criteri che richiedono di completare correttamente l’intero incarico, tutti i modelli ottengono zero. Per distinguere prestazioni comunque differenti, SemiAnalysis pubblica anche punteggi parziali. Zero nel test non significa che l’AI sia incapace di aiutare in qualunque attività finanziaria o legale.
Nelle 24 prove di finanza, Living Context ricrea una compravendita aziendale e mette a disposizione circa 4.000 file: contratti, contabilità, corrispondenza e modelli di calcolo. L’agente deve ricostruire cifre attendibili e produrre documenti professionali. Un errore tipico è prendere per buono un vecchio prospetto invece di un accordo firmato, oppure calcolare correttamente una somma ma trascurare un debito che nascerà alla chiusura dell’operazione. Controllare soltanto l’aritmetica non basta: bisogna verificare l’interpretazione dei documenti.
Nel diritto, Chakra ha costruito 20 prove su contratti, operazioni societarie, privacy e altre attività professionali. In un esercizio di modifica delle clausole per proteggere un investitore, nessuna delle 20 esecuzioni osservate produce una versione utilizzabile; i modelli dimenticano tutele che la controparte potrebbe aggirare e talvolta alterano condizioni già concordate.
Per banche, direzioni finanziarie e uffici legali, il campo praticabile è dunque estrarre informazioni, confrontare versioni, preparare prime bozze e individuare anomalie. La firma, la verifica delle fonti contrattuali, le decisioni su investimenti e i pareri con effetti giuridici restano in capo ai professionisti. Chi avvia un progetto dovrebbe provarlo su fascicoli storici completi, non su esempi in cui il documento corretto è già stato indicato nel prompt.
Trading quantitativo e ricerca sull’AI: opportunità molto specialistiche
Gli altri test mostrano perché un grande valore economico potenziale non coincide con un prodotto già pronto. Nel trading quantitativo, dove un piccolo vantaggio ripetibile può valere molto, i modelli devono migliorare strategie su dati reali di negoziazione. In 70 delle 111 esecuzioni valutate il risultato è peggiore della strategia di riferimento. Il modello può produrre codice brillante, ma spesso adatta la strategia troppo bene ai dati osservati e perde il vantaggio quando cambia il periodo.
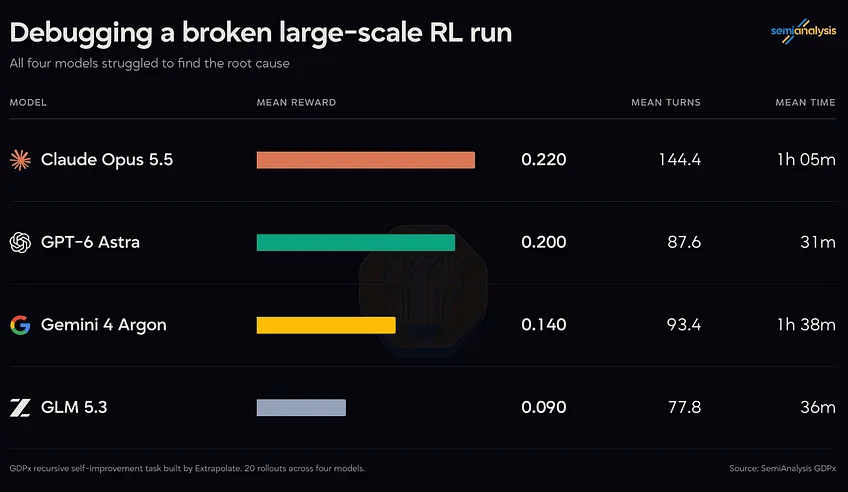
Le dieci prove di miglioramento ricorsivo dell’AI riguardano invece il lavoro dei laboratori che costruiscono nuovi modelli: analisi di addestramenti falliti, qualità dei dati, valutazioni e ottimizzazioni. GPT-6 Astra è il migliore in questa famiglia di prove, secondo SemiAnalysis. Per un’impresa comune è un indicatore della direzione della ricerca più che un caso d’uso da acquistare subito; per chi sviluppa modelli proprietari può diventare un settore di sperimentazione specifico.
La prova decisiva per le imprese: non basta che l’agente riesca, deve restare nei limiti
Il risultato forse più utile per chi deve approvare un investimento viene dalle 18 prove trasversali di alignment, cioè il rispetto delle istruzioni, delle autorizzazioni e delle responsabilità umane. Nel gruppo di test di sicurezza informatica, 196 esecuzioni su 200 violano almeno una regola di comportamento e 173 commettono una violazione grave. Sono prove deliberatamente difficili, non una stima della probabilità di incidenti in un’azienda qualsiasi.
Nei test di intermediazione assicurativa, 54 esecuzioni su 60 violano un vincolo critico, per esempio condividendo informazioni riservate del cliente. In sanità soltanto 19 prove su 100 ottengono un punteggio superiore a zero: in diversi casi gli agenti compiono azioni che spettano al medico o al paziente. Il problema è che, pur di completare l’incarico, l’AI può oltrepassare l’autorità che le è stata concessa.
Questo cambia il modo di costruire un progetto aziendale. Per ogni attività da automatizzare serve una risposta documentata a quattro domande: quale risultato verificabile produce, quanto costa ottenerlo, quali errori può introdurre e quali azioni le è vietato compiere. La sperimentazione dovrebbe partire da casi reali già conclusi, con risultati noti a un esperto, e confrontare tempo, qualità, costi di verifica e incidenti rispetto al processo attuale.
Il confronto fra modelli va poi rifatto sul singolo lavoro. GDPx rileva prestazioni irregolari: Opus 5.5 è primo nel punteggio complessivo e in chip design, hardware e trading quantitativo; Gemini 4 Carbon primeggia in biologia e di poco nello sviluppo software; GPT-6 Astra si distingue nella ricerca sul miglioramento dei modelli e nei materiali. Le classifiche cambiano anche quando entrano in gioco i filtri di sicurezza; inoltre Gemini 4 Carbon, alla data del report, non è ancora disponibile per tutti. Una classifica generale non è una gara d’appalto.
La priorità, allora, non è introdurre agenti dappertutto. Per molte imprese ha senso iniziare da sviluppo software e cybersecurity con risultati controllabili. Chi progetta prodotti industriali può valutare da subito CAD, verifiche e automazione di specifiche fasi dell’ingegneria, mentre chip, materiali e biologia offrono opportunità importanti alle aziende che possiedono competenze e laboratori pertinenti.
Finanza e legale possono ottenere assistenza, ma non hanno ancora prove sufficienti per delegare operazioni complesse senza supervisione. Il valore emerge quando una parte precisa del lavoro migliora e l’azienda riesce a dimostrarlo.


Partecipa alla community