


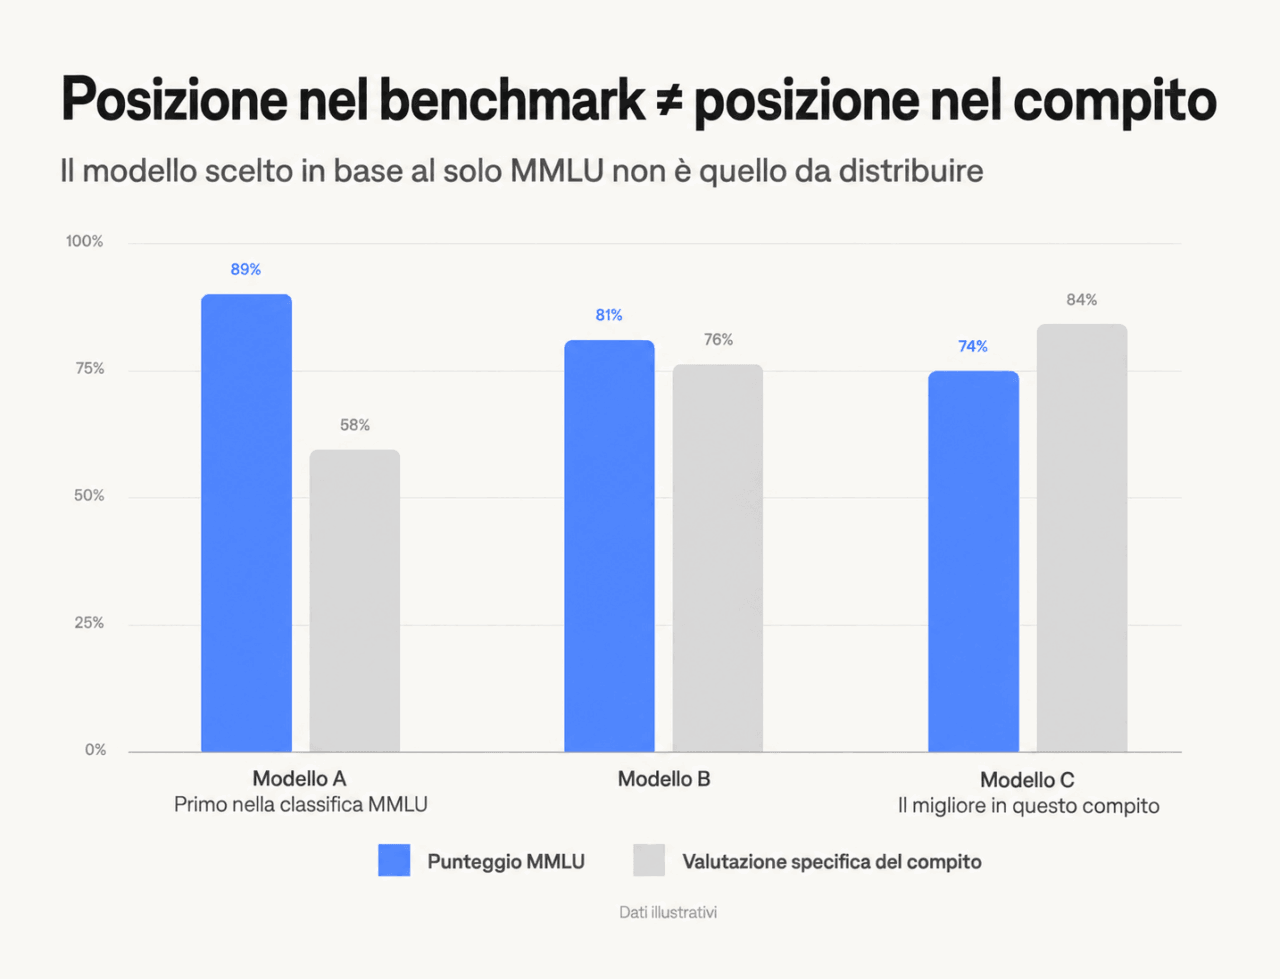
La domanda che smaschera lo stato reale di un progetto AI è sempre la stessa: come fate a sapere che funziona? La risposta più frequente descrive un controllo a campione fatto da qualcuno che esamina una ventina di risposte e conclude che vanno bene, senza casi registrati, senza soglia dichiarata e senza avere il modo di accorgersi se domani peggiorano.
Il problema si manifesta al primo cambiamento. Il fornitore aggiorna il modello, qualcuno modifica un’istruzione di sistema per correggere un caso, si aggiungono documenti all’archivio, e nessuno ha modo di sapere se quello che funzionava prima funziona ancora. La qualità di questi sistemi si degrada in silenzio, perché una risposta sbagliata resta fluente e credibile.
Indice degli argomenti:
Quattro livelli di maturità, dalla sensazione al presidio continuo
La scala che si è consolidata nel settore descrive bene dove si trovano le organizzazioni e cosa serve per salire di un gradino.
- Livello uno: valutazione a sensazione. Controlli manuali sporadici, nessuna metrica registrata nel tempo. È il punto di partenza di tutti e il punto di arrivo di molti.
- Livello due: giudizio automatico su un insieme di casi. Esiste una raccolta di esempi con la risposta attesa, un modello valuta ciascun output e produce un punteggio. Il salto rispetto al livello precedente è enorme, però il punteggio eredita tutti i difetti del giudice.
- Livello tre: valutazione multidimensionale integrata nel rilascio. Più metriche misurate insieme, fedeltà alle fonti, pertinenza, completezza, latenza e costo, con esecuzione automatica a ogni modifica e blocco del rilascio in caso di regressione sotto la linea di base.
- Livello quattro: valutazione continua in produzione con supervisione umana. Valutatori leggeri che assegnano un punteggio a tutto il traffico reale, rilevamento delle anomalie che attiva una revisione approfondita, e tracce di produzione che diventano automaticamente nuovi casi di prova.
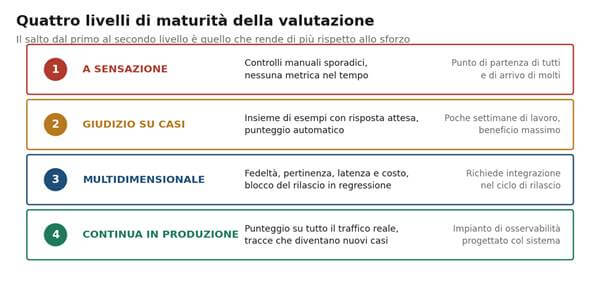
Il passaggio che produce il beneficio maggiore rispetto allo sforzo è quello dal primo al secondo livello, e nella maggior parte delle organizzazioni si può completare in poche settimane. Il passaggio dal terzo al quarto richiede invece un impianto di osservabilità che va progettato insieme al sistema.
Duecento casi veri valgono più di duemila sintetici
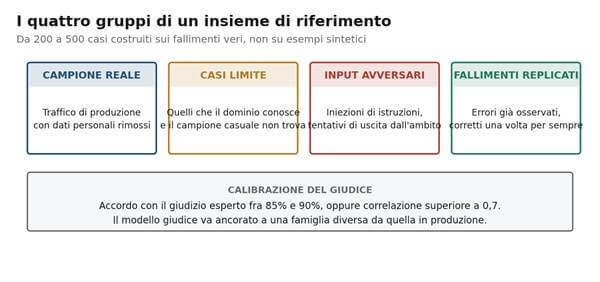
L’insieme di riferimento è l’artefatto su cui poggia tutto il resto, e il modo in cui viene costruito determina se misurerà qualcosa di utile. La dimensione adeguata per iniziare sta fra i duecento e i cinquecento casi, il che sorprende chi si aspettava numeri più grandi.
La composizione pesa più della dimensione, e va organizzata in quattro gruppi. Un campione rappresentativo del traffico reale, con i dati personali rimossi. I casi limite noti, quelli che il dominio conosce e che nessun campione casuale intercetta. Gli input avversari, dalle iniezioni di istruzioni ai tentativi di far uscire il sistema dal proprio ambito. E i fallimenti già osservati, riprodotti come casi permanenti perché un errore corretto una volta deve restare corretto.
L’errore che si ripete con più frequenza è la costruzione dall’alto: si sceglie una metrica, si costruisce un insieme di casi che la misuri bene, si ottengono punteggi alti e si scoprono fallimenti inattesi in produzione. La direzione corretta parte dal basso, dai fallimenti veri, e la metrica arriva dopo.
Va aggiunto che l’insieme di riferimento invecchia. I casi che passano su ogni modello e ogni versione delle istruzioni da cinquanta esecuzioni consecutive hanno smesso di discriminare qualcosa e vanno archiviati, mentre ogni nuovo fallimento in produzione va convertito in caso di prova entro pochi giorni. Un insieme di riferimento fermo da sei mesi sta certificando un sistema che non esiste più.
Il modello giudice va ancorato a una famiglia diversa da quella in produzione
L’uso di un modello per valutare l’output di un altro modello è diventato lo strumento principale della valutazione automatica, e porta con sé distorsioni documentate che vanno gestite esplicitamente.
La più insidiosa riguarda l’auto-preferenza. Quando il modello giudice appartiene alla stessa famiglia del modello che genera le risposte, i punteggi si gonfiano di diversi punti sui criteri soggettivi, perché il giudice riconosce come buono uno stile che assomiglia al proprio. La contromisura è semplice e va applicata sempre: ancorare il giudice a una famiglia diversa da quella in produzione.
Le altre distorsioni sono la preferenza per le risposte lunghe, che premia la verbosità indipendentemente dal contenuto, e l’effetto della posizione nei confronti a coppie, dove la prima opzione presentata riceve sistematicamente un vantaggio. Chiedere al giudice di articolare il ragionamento prima di assegnare il punteggio riduce sensibilmente tutte e tre.
Resta il punto decisivo, quello che quasi nessuno esegue: la calibrazione. Il giudice va confrontato con un insieme annotato da persone competenti del dominio, e l’accordo va misurato. Le soglie che il settore considera accettabili stanno intorno all’85-90% di concordanza, o a una correlazione superiore a 0,7 con il giudizio esperto. Sotto quella soglia il sistema sta misurando qualcosa, senza che nessuno sappia se ha a che fare con l’esperienza degli utenti.
La calibrazione va poi mantenuta, con una quota di output campionati e valutati da persone ogni mese, in genere fra il 3% e il 5% del volume.
Un agente che arriva alla risposta giusta per la strada sbagliata
I sistemi agentici introducono un problema che le metriche sul risultato finale non catturano. Un agente che raggiunge la risposta corretta attraverso una sequenza di chiamate ridondanti, costose o pericolose rappresenta comunque un fallimento in produzione, e il punteggio sull’esito finale lo certifica come successo.
La risposta metodologica è valutare l’intero percorso decisionale. Tre famiglie di metriche si sono affermate: l’aderenza della sequenza di passi a un percorso atteso, la correttezza dell’invocazione degli strumenti con i relativi parametri, e il comportamento in caso di errore, ovvero se l’agente recupera in modo controllato oppure insiste.
Su un flusso che scrive nei sistemi aziendali questa distinzione smette di essere accademica. Un agente che ottiene il risultato corretto dopo aver interrogato tre volte un sistema di produzione, o dopo aver tentato una scrittura poi annullata, è un incidente che non è ancora accaduto.
Dalla buona pratica all’obbligo documentale
C’è una ragione ulteriore, di natura diversa, per cui la valutazione sta salendo nelle priorità. Per i sistemi classificati ad alto rischio il quadro europeo richiede un sistema di gestione del rischio documentato, con evidenze delle prove effettuate e dei risultati ottenuti lungo l’intero ciclo di vita.
Le scadenze sono state spostate dal Digital Omnibus al 2 dicembre 2027 per i sistemi autonomi e al 2 agosto 2028 per quelli incorporati in prodotti, però la documentazione richiesta si costruisce accumulando, e retroattivamente non si accumula.
Un’organizzazione che oggi esegue valutazioni strutturate e ne conserva gli esiti si troverà, fra due anni, ad avere già gran parte dell’evidenza richiesta. Un’organizzazione che valuta a sensazione dovrà ricostruire da zero un impianto che non produce risultati retrospettivi.
Vale la pena chiudere con la domanda che rende concreto tutto il resto, e che nella mia esperienza mette in difficoltà anche team tecnicamente solidi: se il fornitore aggiornasse il modello stanotte, quanto tempo passerebbe prima che qualcuno in azienda se ne accorga dai risultati, anziché dal comunicato?



Partecipa alla community