


Poche fotografie scattate con un telefono, in certi casi appena due o tre, bastano ad Atlas, l’ultimo modello di World Labs, per ricostruire una stanza in tre dimensioni, e da un breve video il modello genera ciò che vedrebbe la telecamera di un robot mentre la attraversa. È questa capacità, più del marchio di Fei-Fei Li, che AMD ha deciso di comprare con l’accordo annunciato il 28 settembre: una transazione interamente in azioni da circa 8,2 miliardi di dollari, closing atteso entro fine 2026, Li nel ruolo di executive vice president e chief scientist a riporto di Lisa Su, e i cofondatori Justin Johnson e Ben Mildenhall alla guida del team di ricerca.
La motivazione dichiarata da AMD è tecnica prima che commerciale. Man mano che l’AI si allarga a ragionamento, robotica, simulazione e physical AI, i carichi di calcolo diventano più eterogenei, e un’azienda che progetta chip con anni di anticipo ha bisogno di sapere come saranno fatti i modelli che dovranno girarci sopra.
Per chi lavora su robotica, digital twin e automazione le conseguenze sono concrete, e riguardano tre livelli dello stack: i modelli, il software che li fa girare, l’hardware all’edge.
Indice degli argomenti:
Atlas, un omni model per lo spazio 3D
Atlas, presentato il 1 settembre, è un modello addestrato da zero che lavora in modo nativo su testo, immagini, video, pose della telecamera e mappe di profondità. World Labs lo descrive come un transformer a diffusione autoregressivo e multimodale: genera un elemento alla volta, come un modello linguistico prevede il token successivo, ma ogni elemento è un’immagine o una mappa di profondità prodotta per rimozione progressiva del rumore, come nei modelli video.
Il cuore dell’architettura è il contesto spaziale, ossia una memoria in cui ogni immagine in ingresso è ancorata a una posizione precisa nello spazio tridimensionale, e il modello genera nuove viste restando coerente con tutto ciò che ha già visto.
I numeri pubblicati dall’azienda sono ambiziosi. Atlas genera fino a un minuto di video a 1440p con controllo della telecamera al pixel, e nei test con valutatori umani è stato preferito per aderenza al movimento di camera richiesto nel 94% dei confronti con Seedance 2.5, nell’81% con Gemini Omni Flash e nel 75% con MiniMax H3.
Nella ricostruzione 3D da poche viste, un problema aperto della computer vision da decenni, registra un errore medio inferiore ai migliori modelli open source specializzati. L’output può essere una nuvola di punti o un insieme di Gaussian splat, cioè una rappresentazione della scena come milioni di piccole ellissi colorate che si renderizzano in tempo reale sul dispositivo, la stessa usata da Marble, il primo prodotto commerciale di World Labs.
Per un progettista di chip il dettaglio più rilevante sta in una riga della documentazione tecnica. Atlas eredita dai modelli linguistici le tecniche di serving, come la cache delle chiavi e dei valori e il serving disaggregato, e dai modelli di diffusione quelle di accelerazione, come la distillazione che riduce i passaggi di denoising. È un carico ibrido, in parte limitato dalla banda di memoria come la generazione di testo e in parte limitato dal calcolo come la generazione video, e l’azienda dichiara che le prestazioni crescono con la potenza di addestramento. Averlo in casa significa poter misurare dove si formano i colli di bottiglia prima di congelare l’architettura della prossima GPU.

Real-to-sim-to-real: l’eredità di SceniX
Il secondo asset arriva da un’acquisizione nell’acquisizione. A luglio World Labs ha incorporato SceniX, società che trasforma compiti robotici reali in simulazioni, e ha pubblicato i primi risultati del suo motore real-to-sim-to-real: si registra un compito fisico, lo si ricostruisce come mondo interattivo che conserva aspetto, geometria e dinamica degli oggetti (rigidi, articolati o deformabili come i cavi), e lo si moltiplica in migliaia di varianti in cui cambiano l’illuminazione e la disposizione degli oggetti.
Secondo l’azienda, politiche di controllo addestrate con zero dati raccolti nel mondo reale sono state trasferite direttamente su piattaforme diverse, dai bracci ALOHA e xArm al Flexiv fino al bimanuale RB-Y1, e hanno lavorato per un’ora consecutiva senza interventi umani su compiti come l’inserimento di cavi elastici o il prelievo di pennarelli da un mucchio disordinato.
Sul fronte della valutazione, ogni checkpoint è stato testato su 2.000 prove simulate contro 100 prove reali, e la simulazione ha conservato la classifica relativa delle politiche. Sono risultati pubblicati dalla stessa World Labs e ancora privi di una verifica indipendente, ma indicano una trasformazione precisa: l’addestramento dei robot si sposta dalle ore di lavoro su hardware fisico alle ore di GPU nel data center, un carico che AMD ha ogni interesse a servire.
Co-design su Instinct e ROCm
La collaborazione tra le due aziende è precedente all’accordo: dal 2025 i team lavoravano insieme sull’ottimizzazione di addestramento e inferenza su GPU AMD, e Lisa Su era tra i primi investitori. Dopo l’annuncio, Vamsi Boppana, senior vice president per l’AI di AMD, ha precisato secondo quanto riportato dall’analista Patrick Moorhead che l’addestramento avverrà prevalentemente su infrastruttura AMD mentre il deployment resterà multipiattaforma, e che il team diventerà una capacità di modellazione orizzontale per tutta l’azienda, dalla robotica ai sistemi embedded fino ai media e al ragionamento nei data center.
Il punto debole storico di AMD è il software: ROCm, lo stack open source che traduce il lavoro dei modelli sulle GPU Instinct, ha ridotto il distacco da CUDA di Nvidia soprattutto sui modelli linguistici, mentre sui carichi multimodali e di simulazione la maturità è minore. Un laboratorio di frontiera che addestra da zero modelli ibridi su Instinct funziona da stress test permanente e da implementazione di riferimento, e ogni ottimizzazione di kernel scritta per Atlas finisce, potenzialmente, nelle librerie che useranno i clienti.
È lo stesso schema con cui Nvidia ha costruito il proprio vantaggio negli anni scorsi, facendo girare in casa i modelli che voleva accelerare.
La neutralità verso i clienti è un tema aperto, perché AMD vende GPU anche ai laboratori che sviluppano modelli di frontiera. Boppana ha escluso l’intenzione di competere con loro, e la specializzazione di World Labs su spazio e mondo fisico, lontana dai grandi modelli linguistici generalisti, rende la rassicurazione credibile almeno nel breve periodo.
Dall’addestramento all’edge con gli X100
L’altra metà della traiettoria è fuori dal data center. A luglio AMD ha lanciato i Ryzen AI Embedded X100, processori per robot e automazione industriale con fino a 16 core Zen 5, una GPU integrata fino a 40 unità di calcolo e un acceleratore neurale XDNA 2 sullo stesso chip, memoria unificata, fino a 126 TOPS complessivi e un ciclo di vita garantito di dieci anni.
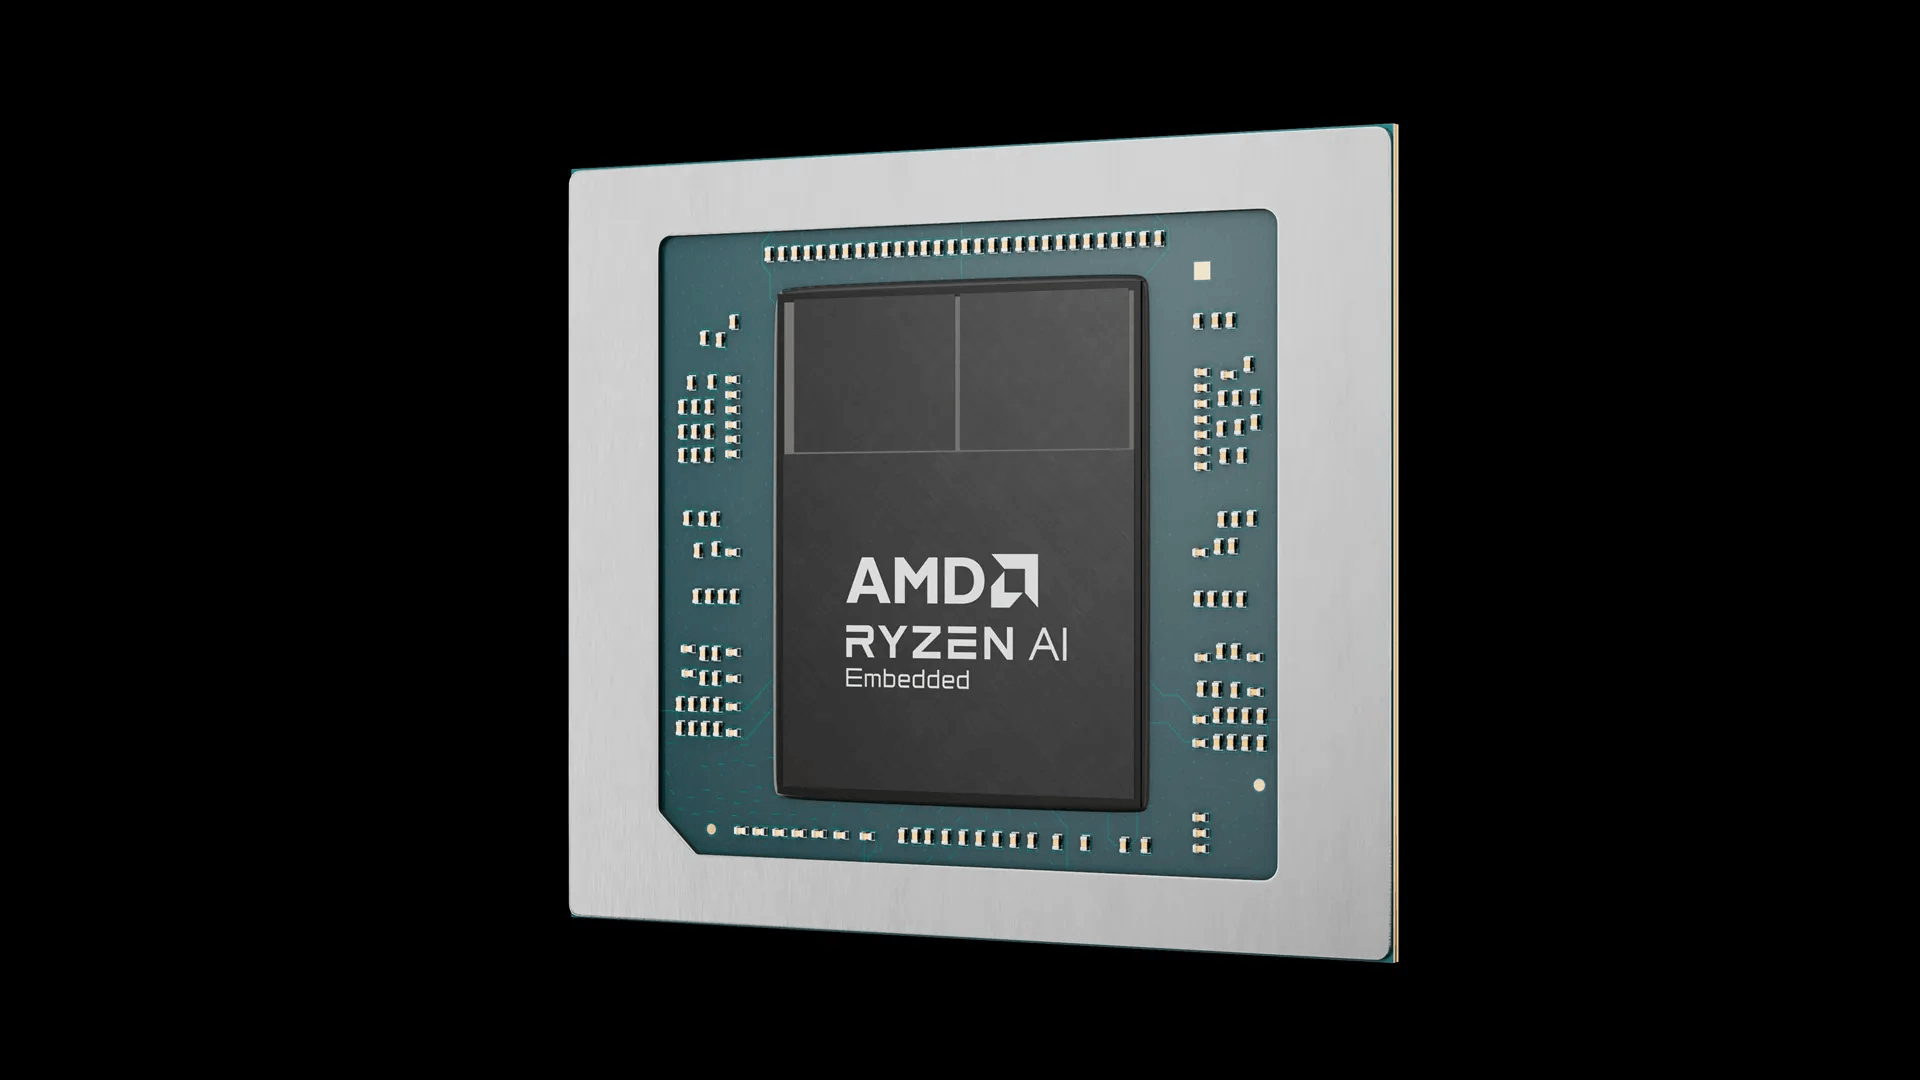
I moduli Kria AI li affiancano a logica programmabile FPGA per il controllo deterministico, e la piattaforma di sviluppo per la robotica, con nodi di percezione per ROS 2 e supporto ROCm, arriverà in accesso anticipato nel quarto trimestre 2026. AMD dichiara prestazioni di picco in FP32 fino a tre volte superiori al Jetson Thor T5000 di Nvidia, un confronto del produttore da prendere con la cautela del caso.
Con World Labs la catena si chiude sulla carta. Nel data center si ricostruiscono gli ambienti, si generano le varianti e si addestrano le politiche; all’edge girano le politiche distillate e la percezione, mentre i Gaussian splat prodotti da Atlas possono essere renderizzati direttamente sul dispositivo per digital twin, ispezioni e interfacce operative. Per un team di ingegneria significa progettare fin dall’inizio una pipeline divisa, con modelli grandi per generare e simulare e modelli piccoli e deterministici per agire, scegliendo con attenzione i formati di scambio tra i due mondi.
Cosmos contro Atlas, due stack a confronto
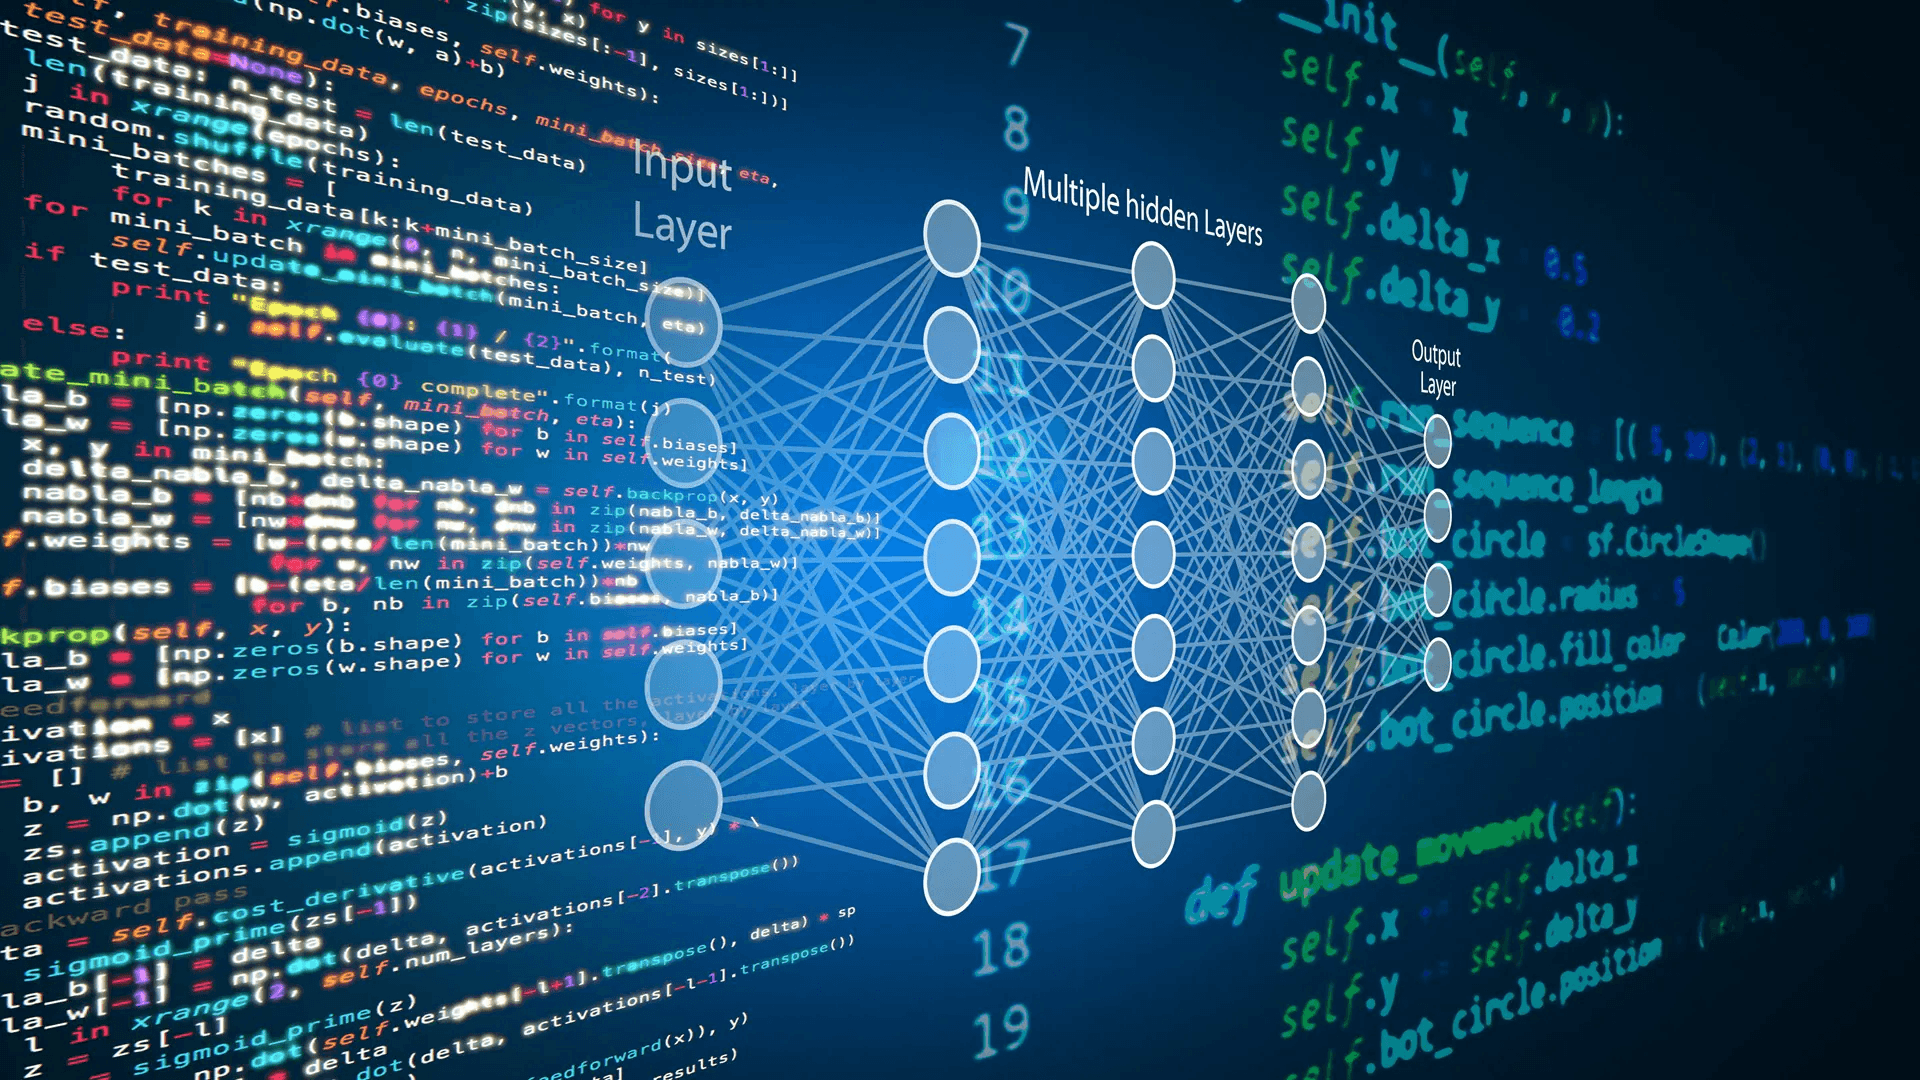
Nvidia su questo terreno parte con un vantaggio misurabile. Come ricorda TechCrunch, dispone già di una famiglia di world model a pesi aperti, Cosmos, mentre AMD finora aveva reso pubblici soltanto modelli testuali e video; attorno a Cosmos ci sono piattaforme di simulazione mature, i moduli Jetson per i robot e, con l’accordo firmato a settembre per circa 12,9 miliardi, Hugging Face, il principale archivio di modelli aperti.
La proposta di AMD è più giovane e più frammentata, ma punta su un’apertura dichiarata: il comunicato parla di rafforzare l’ecosistema AI aperto e Li scrive di voler offrire i migliori modelli aperti e piattaforme per far girare l’AI dall’hardware ai dati.
Per chi deve scegliere su cosa costruire, i segnali da osservare nei prossimi mesi sono concreti. Il primo è l’eventuale rilascio di world model derivati da Atlas con pesi aperti e ottimizzati per ROCm; conterà poi la trasformazione della simulazione in stile SceniX in un servizio accessibile ai costruttori di robot, e non ultimo l’arrivo degli X100 in volumi nei tempi annunciati.
Fino ad allora conviene tenere le pipeline di simulazione indipendenti dal fornitore, con formati di scena aperti e politiche esportabili.
Il test arriverà nel 2027, quando si vedrà se un robot addestrato in un mondo generato da Atlas su GPU Instinct riuscirà a lavorare su un X100 senza passare da CUDA in nessun punto della catena, e in quel caso la physical AI avrebbe per la prima volta un’alternativa completa a Nvidia, dal primo all’ultimo anello.




Partecipa alla community