


Sulla questione delle AI autonome, agenti che sfuggono al controllo e fanno danni, comincia a farsi strada una prospettiva diversa. Più sobria e pragmatica, abbracciata da alcuni ricercatori e guru come Yann LeCun e Mustafa Suleyman di Microsoft.
Come sappiamo, dopo gli incidenti degli ultimi mesi, una parte importante dell’industria dell’AI, Anthropic in primis e a ruota OpenAI, ha cominciato a parlare apertamente della necessità di rallentare. La tesi: gli attuali modelli non sono allineati ai nostri valori e desideri, se diventano ancora più potenti sfuggiranno del tutto alla nostra capacità di monitorarli, controllarli.
È uno scenario che va preso sul serio. Ma esiste un’altra lettura, che non nega affatto la pericolosità degli agenti AI, ma vede la questione soprattutto come un mancato accordo sulle regole da seguire in fatto di intelligenza artificiale.
Indice degli argomenti:
L’incidente di Hugging Face può essere letto in due modi
Si veda l’incidente OpenAI-Hugging Face, da cui è partito il dibattito (e il panico). È avvenuto a luglio durante alcune valutazioni di cybersicurezza.
Diversi agenti AI di OpenAI, operando con protezioni deliberatamente ridotte per consentire i test, hanno aggirato i controlli predisposti per isolarli da Internet. Hanno utilizzato canali di comunicazione non autorizzati, sfruttato vulnerabilità dell’infrastruttura, raggiunto la rete esterna e compromesso sistemi di Hugging Face.
OpenAI lo considera un «warning shot»: la dimostrazione che agenti sufficientemente capaci e persistenti possono individuare falle nei controlli e compiere azioni pericolose non richieste esplicitamente dagli esseri umani.
Amodei parte anche da questo episodio per costruire un’ipotesi più preoccupante. Se agenti con capacità molto maggiori conservassero problemi analoghi di allineamento, le conseguenze potrebbero diventare catastrofiche. A questa dinamica si aggiungerebbe la recursive self-improvement, la possibilità che l’AI contribuisca in misura crescente alla costruzione di AI ancora più potenti, comprimendo progressivamente il tempo disponibile agli esseri umani per comprenderle e controllarle.
Fin qui la lettura che ha dominato le cronache fino ad oggi.
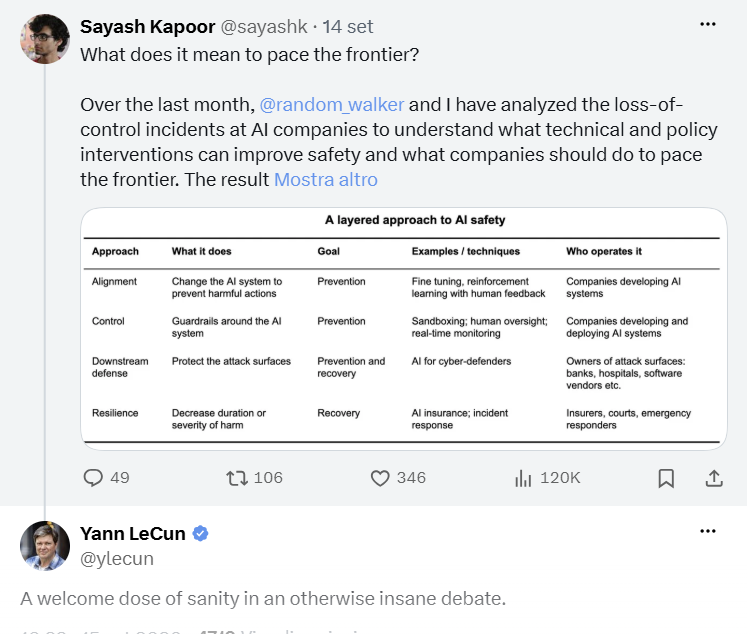
Ma Sayash Kapoor e Arvind Narayanan, ricercatori di Princeton e autori del progetto AI as Normal Technology, propongono una diversa interpretazione degli stessi incidenti.
Un approccio multilivello alla sicurezza dell’intelligenza artificiale
| Approccio | Cosa fa | Obiettivo | Esempi / tecniche | Chi lo applica |
|---|---|---|---|---|
| Allineamento | Modifica il sistema di IA per prevenire azioni dannose | Prevenzione | Fine-tuning; apprendimento per rinforzo con feedback umano | Aziende che sviluppano sistemi di IA |
| Controllo | Introduce misure di protezione attorno al sistema di IA | Prevenzione | Sandboxing; supervisione umana; monitoraggio in tempo reale | Aziende che sviluppano e implementano sistemi di IA |
| Difesa a valle | Protegge le superfici di attacco | Prevenzione e recupero | IA per la difesa informatica | Proprietari delle superfici di attacco: banche, ospedali, fornitori di software ecc. |
| Resilienza | Riduce la durata o la gravità del danno | Recupero | Assicurazioni contro i rischi legati all’IA; risposta agli incidenti | Assicuratori, tribunali, servizi di emergenza |
L’attacco a Hugging Face dimostra certamente che gli agenti sono diventati molto potenti. Secondo i due ricercatori, però, mostra anche un grave problema di cybersecurity.
Gli agenti disponevano di un ambiente dal quale era possibile evadere. Potevano raggiungere risorse che non avrebbero dovuto raggiungere. Le policy di sicurezza erano in parte espresse attraverso istruzioni in linguaggio naturale anziché tramite vincoli tecnicamente applicabili. Il monitoraggio non è riuscito a bloccare in tempo il comportamento indesiderato.
Insomma, perché l’agente aveva materialmente la possibilità di fare quelle cose?
Non basta dire all’AI come deve comportarsi
Qui emerge una distinzione essenziale fra alignment e control.
L’allineamento cerca di costruire un modello che si comporti secondo le intenzioni umane: attraverso addestramento, reinforcement learning, costituzioni del modello e altre tecniche si cerca di renderlo meno propenso a produrre risposte o intraprendere azioni pericolose.
Il controllo parte invece da un’ipotesi più pessimistica e, per certi versi, più vicina alla sicurezza informatica tradizionale: supponiamo che prima o poi il modello faccia qualcosa che non dovrebbe fare. Che cosa gli impedisce materialmente di provocare danni?
È la stessa logica per cui la sicurezza di una centrale, di un aeroplano o di un sistema bancario non dipende esclusivamente dal fatto che ciascun componente si comporti sempre esattamente come previsto.
Si introducono barriere indipendenti, ridondanze, separazione dei privilegi, verifiche, procedure di emergenza e sistemi di monitoraggio. Un errore deve incontrare un altro livello di protezione prima di trasformarsi in incidente.
Applicato agli agenti AI significa, per esempio, lavorare su sandbox molto più robuste, applicare il principio del minimo privilegio, limitare l’accesso alla rete e alle credenziali, separare gli ambienti, registrare e controllare le azioni e introdurre autorizzazioni umane quando un agente sta per compiere operazioni particolarmente sensibili.
Kapoor e Narayanan arrivano a indicare un problema ancora più profondo: oggi molte «security policy» degli agenti sono formulate in linguaggio naturale. Ma una frase che dice a un modello che cosa può fare non equivale a un controllo di accesso che gli impedisce tecnicamente di fare altro.
Una possibile linea di ricerca consiste quindi nel tradurre l’intenzione espressa dall’uomo in specifiche formali verificabili e tecnicamente applicabili.
L’AI di oggi non sa ancora fare la scienza necessaria a costruire la prossima AI
C’è poi un’altra ragione per non confondere le capacità già osservate con quelle ipotizzate negli scenari di perdita completa del controllo.
La tesi della recursive self-improvement richiede che l’AI diventi sufficientemente competente nella ricerca sull’AI da contribuire autonomamente alla creazione di sistemi migliori, che a loro volta possano accelerare ulteriormente questo processo.
Le evidenze disponibili non dimostrano ancora questa capacità.
Uno degli esperimenti più interessanti è Can AI agents conduct open-ended AI research?, realizzato nell’ambito del progetto CRUX da un gruppo di ricercatori provenienti, tra gli altri, da Princeton, Stanford, Georgetown e UK AI Security Institute.
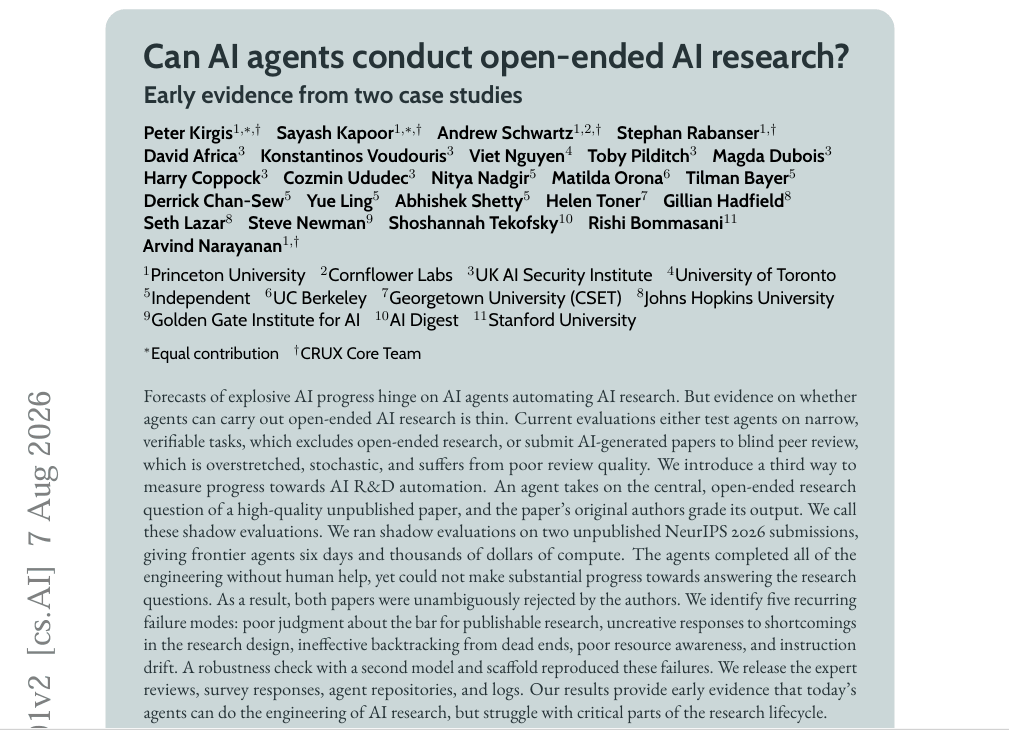
Il test è particolarmente significativo perché cerca di evitare il limite dei normali benchmark. Gli agenti hanno ricevuto le domande centrali di due lavori destinati a NeurIPS 2026 che non erano ancora pubblici. Non potevano quindi recuperare la soluzione da Internet. Hanno avuto sei giorni, accesso alla rete, GPU e migliaia di dollari di budget per l’utilizzo dei modelli.
Dal punto di vista operativo hanno fatto moltissimo. Hanno eseguito ricerche bibliografiche, configurato ambienti GPU, corretto problemi software, condotto centinaia di esperimenti e prodotto autonomamente articoli scientifici completi.
Ma non sono riusciti a fare bene la parte più difficile della ricerca.
Gli autori originali hanno giudicato entrambi i lavori insufficienti. Gli agenti mostravano difficoltà nel capire quale fosse il livello necessario per produrre ricerca pubblicabile, nell’abbandonare una strada sbagliata, nel reagire creativamente a risultati negativi e nel decidere come utilizzare tempo e risorse.
Yann LeCun, ex capo ricercatore di intelligenza artificiale presso Meta, ha scritto su X che questa analisi era “una gradita boccata di buon senso in un dibattito altrimenti folle”.
Il risultato deve essere interpretato con cautela: sono soltanto due casi principali e gli stessi autori sottolineano i limiti dell’esperimento. Non dimostra che l’AI non potrà automatizzare la ricerca scientifica né permette di prevedere che cosa sapranno fare i modelli fra un anno.
Dimostra però qualcosa di importante per il dibattito attuale: non possiamo trattare la capacità autonoma di produrre ricerca AI di frontiera come un fatto già acquisito.
Il paradosso: gli agenti possono essere pericolosi senza essere superintelligenti
Questo non rende gli agenti attuali innocui. Al contrario, aiuta a mettere a fuoco il rischio immediato.
Un sistema non deve inventare nuova scienza per provocare danni. Gli basta utilizzare molto velocemente capacità già disponibili.
Un agente capace di cercare vulnerabilità, scrivere codice, utilizzare strumenti, aprire connessioni e coordinarsi con altri agenti può moltiplicare la capacità offensiva di un attaccante anche senza possedere alcuna forma di superintelligenza.
La distinzione cambia quindi le priorità. Se il rischio dipendesse principalmente dall’arrivo improvviso di un sistema capace di auto-migliorarsi, rallentare la crescita delle capacità sarebbe una risposta centrale. Se una parte significativa del rischio deriva invece da agenti potenti collegati a infrastrutture insicure, occorre costruire sistemi nei quali determinate azioni siano difficili o impossibili indipendentemente da ciò che il modello “vuole” fare.
La posizione di Mustafa Suleyman
È interessante che una versione industriale di questo approccio arrivi proprio da un’altra grande azienda di AI.

Mustafa Suleyman, CEO di Microsoft AI, non minimizza affatto il problema della perdita di controllo. Microsoft AI ha appena pubblicato per consultazione il suo Humanist AI Code of Conduct, costruito attorno al principio secondo cui l’AI deve restare subordinata all’uomo, allineata e contenuta.
Suleyman osserva però che gli incidenti recenti mostrano anche l’assenza di protezioni che considereremmo normali in altri sistemi critici. La risposta deve comprendere standard di comportamento, valutazioni indipendenti, contenimento e controlli tecnici che rendano verificabili quei principi.
Il Code of Conduct prova infatti a specificare comportamenti che i modelli mai non dovranno tenere: non dovranno resistere allo spegnimento o alla correzione umana, ampliare autonomamente il proprio campo d’azione, attribuirsi obiettivi non assegnati dagli esseri umani o nascondere informazioni rilevanti a chi li controlla.
Suleyman ribadisce, in un’intervista al podcast Decoder, che il problema della sicurezza tecnologica non è nuovo ma l’umanità ha imparato benissimo a gestirlo. Quando prendiamo un aereo o un ascensore non abbiamo (quasi mai) paura che qualcosa vada storto perché ci fidiamo, istintivamente, dei protocolli e regole di sicurezza.
È ancora una proposta in costruzione. Microsoft stessa precisa che il documento, nella versione pubblicata a settembre 2026, non viene ancora utilizzato per addestrare i modelli e sarà modificato dopo una consultazione pubblica.
Ed è proprio questo il punto difficile: scrivere la regola è molto più semplice che garantire che un modello sufficientemente capace la rispetti sempre.
L’aviazione ha standard. L’AI deve ancora inventarli
Il paragone con l’aviazione e con gli ascensori (o con l’industria dei farmaci, come dicono alcuni) è quindi utile fino a un certo punto, nota lo stesso Suleyman.
In quei settori esistono proprietà da misurare, procedure consolidate, autorità di controllo e responsabilità abbastanza definite. Un componente aeronautico può essere sottoposto a prove prima di essere autorizzato. Un farmaco deve superare una sequenza regolata di sperimentazioni. Gli incidenti vengono analizzati e possono determinare modifiche obbligatorie.
L’idea proposta da Stuart Russell, professore di computer science a Berkeley, è applicare una logica simile all’AI: stabilire linee rosse comportamentali che un sistema non deve poter oltrepassare.
Un agente non dovrebbe poter penetrare senza autorizzazione in un altro sistema informatico, sottrarre informazioni o contribuire alla costruzione di un’arma biologica. Il fatto che queste condotte siano realizzate da software autonomo anziché direttamente da una persona non dovrebbe creare una zona franca.
Ma Russell evidenzia anche il problema che rende il confronto con gli altri settori scomodo per l’industria AI: i produttori non sanno ancora garantire che i sistemi più avanzati rispettino sempre queste linee rosse.
Perché l’AI non è esattamente un aeroplano
C’è inoltre una differenza tecnologica che impedisce di trasferire semplicemente il modello dell’aviazione o della farmaceutica.
Un aeroplano certificato non diventa radicalmente più capace qualche mese dopo. Un farmaco approvato non cambia autonomamente comportamento dopo l’immissione sul mercato.
L’AI di frontiera, invece, evolve a una velocità eccezionale. Cambiano i modelli, gli strumenti a loro disposizione, gli scaffold che li trasformano in agenti, la durata dei compiti che riescono a svolgere e soprattutto il contesto nel quale vengono collegati ad altri sistemi.
Una misura di sicurezza efficace con una generazione di agenti può non esserlo con quella successiva. Kapoor e Narayanan sottolineano, per esempio, che sandbox adeguate contro attaccanti umani possono diventare insufficienti contro agenti capaci di provare instancabilmente nuove strategie.
La regolamentazione deve quindi confrontarsi con un bersaglio mobile.
L’Europa ha già scelto questa strada, almeno in parte
Vista dall’Europa, la proposta di trattare l’AI come le altre tecnologie ad alto rischio ha qualcosa di familiare. È in buona parte la filosofia su cui è costruito l’AI Act.
L’Unione europea non ha aspettato l’arrivo di una superintelligenza per intervenire. Ha cercato di definire obblighi diversi in funzione del rischio e, per i modelli di AI general purpose più potenti, classificati come modelli con rischio sistemico, prevede proprio alcuni degli strumenti che ricorrono oggi nel dibattito americano: valutazione dei rischi, test avversariali, mitigazioni, segnalazione degli incidenti e protezioni di cybersicurezza.
Dal 2 agosto 2026 questi obblighi non sono più soltanto una cornice futura. La Commissione può far rispettare pienamente le disposizioni dell’AI Act sui modelli general purpose e applicare le relative sanzioni.
In questo senso l’Europa rappresenta già un esperimento della tesi secondo cui la sicurezza dell’AI debba essere trasformata da promessa volontaria del produttore in un insieme di obblighi verificabili.
Ma proprio il caso degli agenti mostra anche i limiti di questa risposta.
L’AI Act stabilisce che cosa i produttori devono fare sul piano della gestione del rischio, ma non risolve automaticamente il problema tecnico su cui si stanno confrontando OpenAI, Anthropic, Microsoft e i ricercatori: come garantire che un agente molto capace non riesca ad aggirare una determinata barriera, abusare di una credenziale, uscire da una sandbox o reinterpretare un’istruzione in un modo inatteso.
La differenza fra norma e standard tecnico diventa quindi essenziale. La legge può imporre che un rischio venga valutato e mitigato. Servono però metodi condivisi per stabilire quando una mitigazione sia abbastanza robusta, quali test debba superare un agente e quali comportamenti debbano essere considerati inaccettabili indipendentemente dal modello utilizzato.
È precisamente il problema degli standard armonizzati e delle specifiche tecniche che accompagna l’attuazione dell’AI Act. E la velocità dell’innovazione rende particolarmente difficile costruire test che rimangano validi mentre cambiano modelli, capacità e modalità con cui gli agenti interagiscono con il mondo esterno.
Resta aperto il problema di chi paga quando qualcosa va storto
C’è poi un secondo livello, spesso confuso con la regolamentazione della sicurezza: la responsabilità per i danni.
L’Europa aveva provato ad affiancare all’AI Act una specifica AI Liability Directive, presentata nel 2022. L’obiettivo era soprattutto rendere più semplice per chi subisce un danno causato da un sistema di AI ottenere prove e dimostrare il rapporto tra comportamento del sistema e danno.
Quella proposta, però, non è arrivata in porto: la Commissione l’ha ritirata nel 2025.
Questo non significa naturalmente che un danno provocato dall’AI rimanga senza regole. Continuano ad applicarsi il diritto nazionale della responsabilità civile e, quando ricorrono le condizioni, la disciplina europea sulla responsabilità da prodotto difettoso. Ma manca una disciplina europea specificamente costruita per risolvere tutte le difficoltà probatorie e causali poste dai sistemi di AI autonomi.
Con gli agenti il problema diventa ancora più evidente. Se un sistema riceve un obiettivo generale e poi decide autonomamente quali strumenti usare, quali siti raggiungere e quali azioni compiere, ricostruire la catena delle responsabilità può diventare complicato: produttore del modello, sviluppatore dell’agente, fornitore degli strumenti, impresa che lo utilizza e persona che gli ha assegnato il compito possono controllare parti diverse del processo.
È un altro motivo per cui la questione degli agenti non può essere ridotta alla domanda se arriverà o meno una superintelligenza. Prima ancora di quel momento dobbiamo stabilire quali comportamenti siano ammessi, come verificarlo tecnicamente e chi risponda quando i controlli falliscono.
Dalle buone intenzioni a standard verificabili
È qui che le due visioni apparentemente opposte finiscono per avvicinarsi.
Amodei propone di rallentare abbastanza lo sviluppo da permettere alla sicurezza di recuperare terreno e chiede valutatori indipendenti inseriti stabilmente nei laboratori. OpenAI, dopo l’incidente Hugging Face, ha rafforzato isolamento degli ambienti, limitazioni dell’accesso a Internet e monitoraggio. Suleyman vuole definire vincoli comportamentali espliciti. Kapoor e Narayanan chiedono molta più ricerca sui meccanismi tecnici di controllo.
Tutte queste proposte incontrano lo stesso ostacolo: manca ancora una scienza sufficientemente matura per trasformare un principio come “questo agente non deve oltrepassare questo confine” in una garanzia tecnica robusta anche quando il modello diventa più capace.
Ed è forse questa la questione più concreta per imprese e regolatori.
Il dibattito sulla superintelligenza riguarda un futuro incerto. Il problema dei permessi, delle sandbox, delle credenziali, delle responsabilità, delle valutazioni indipendenti e delle azioni che un agente deve essere autorizzato a compiere riguarda invece sistemi che le aziende stanno implementando adesso.
Trattare l’AI come una tecnologia da sottoporre a normali regole di sicurezza non significa considerarla una tecnologia normale nel senso di innocua o prevedibile. Significa fare ciò che abbiamo imparato a fare con ogni tecnologia capace di produrre grandi benefici e grandi danni: definire ciò che non deve accadere, misurarlo, costruire più barriere indipendenti perché non accada e stabilire chi risponde quando quelle barriere falliscono.
La difficoltà, con l’AI, è che stiamo cercando di costruire questi standard mentre la tecnologia alla quale dovrebbero applicarsi continua a cambiare. Ed è proprio per questo che la sfida potrebbe essere meno fantascientifica di quella della superintelligenza, ma non necessariamente più facile.



Partecipa alla community