


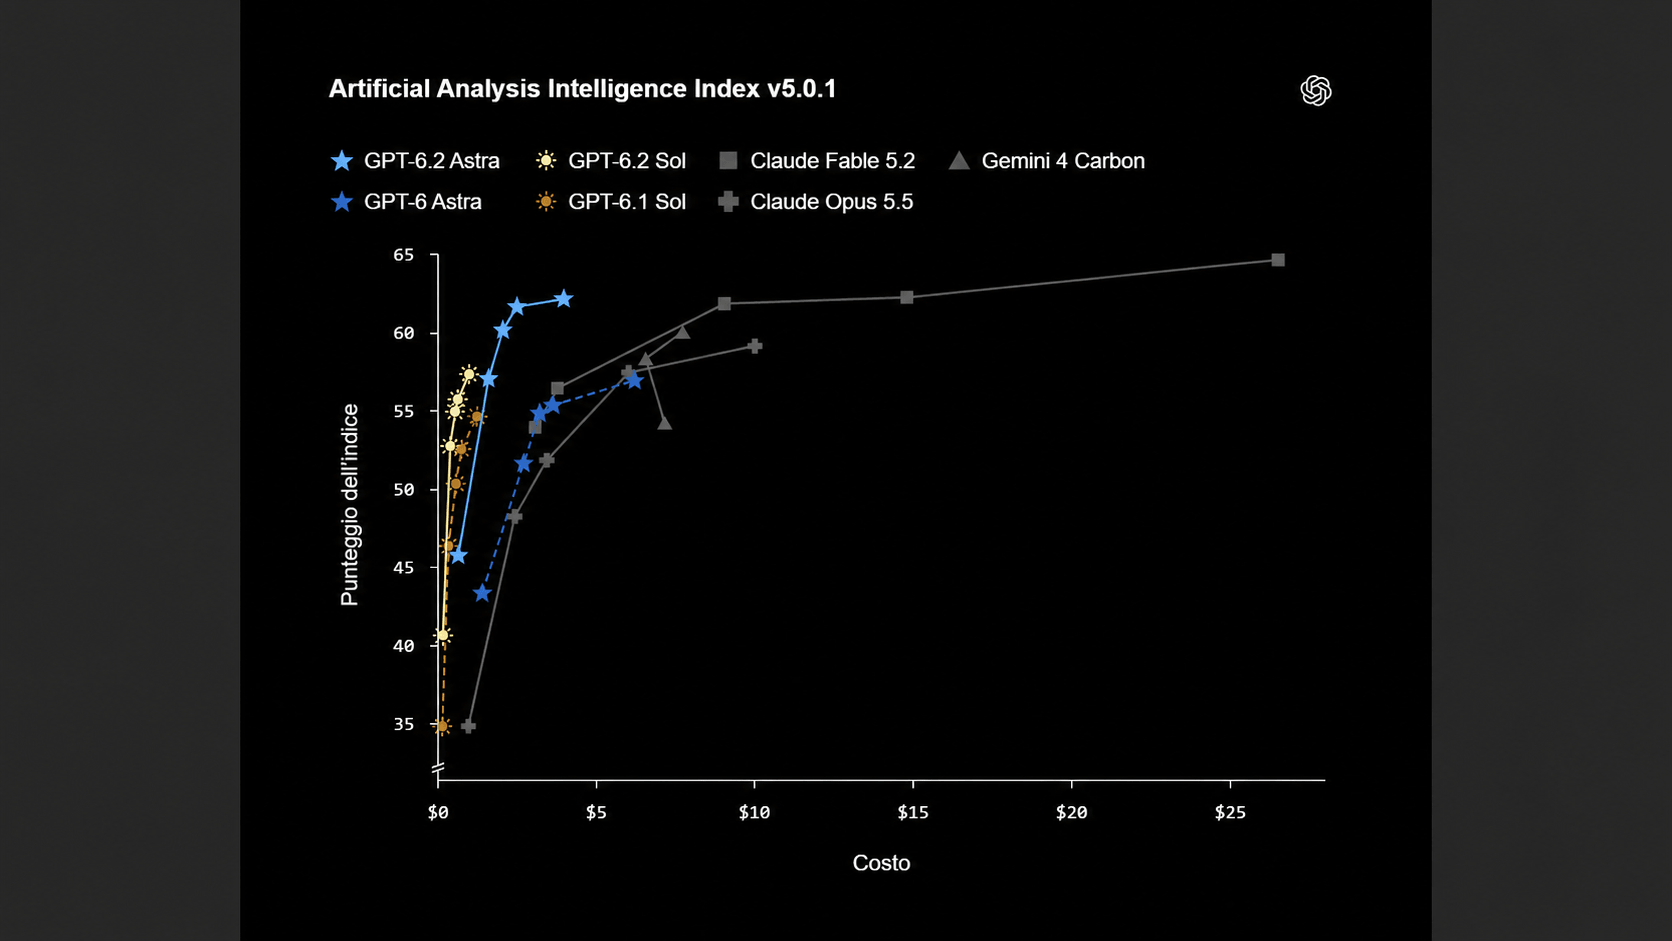
OpenAI ha presentato, il 17 novembre, GPT-6.2 Astra e GPT-6.2 Sol, due modelli pensati per profili di lavoro diversi: Astra per attività professionali lunghe e complesse, Sol per l’uso quotidiano e per agenti che devono operare su larga scala. Entrambi sono disponibili in ChatGPT Work, Codex e API; Astra riduce del 20% i prezzi standard di input e output rispetto a GPT-6 Astra, mentre Sol mantiene le tariffe di GPT-6.1 Sol.
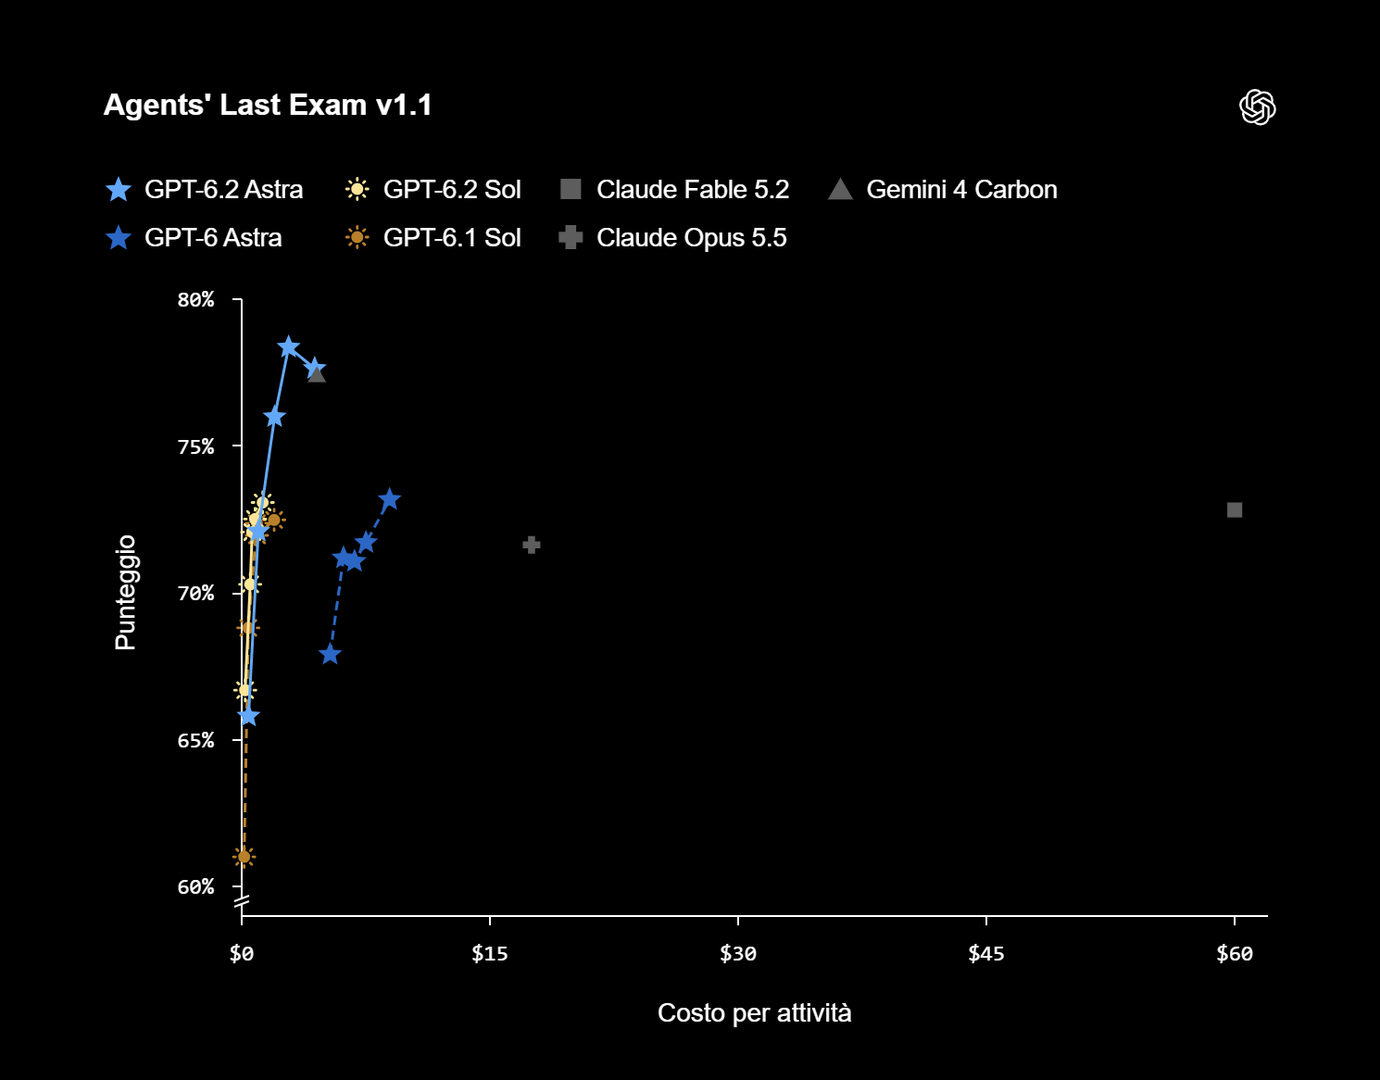
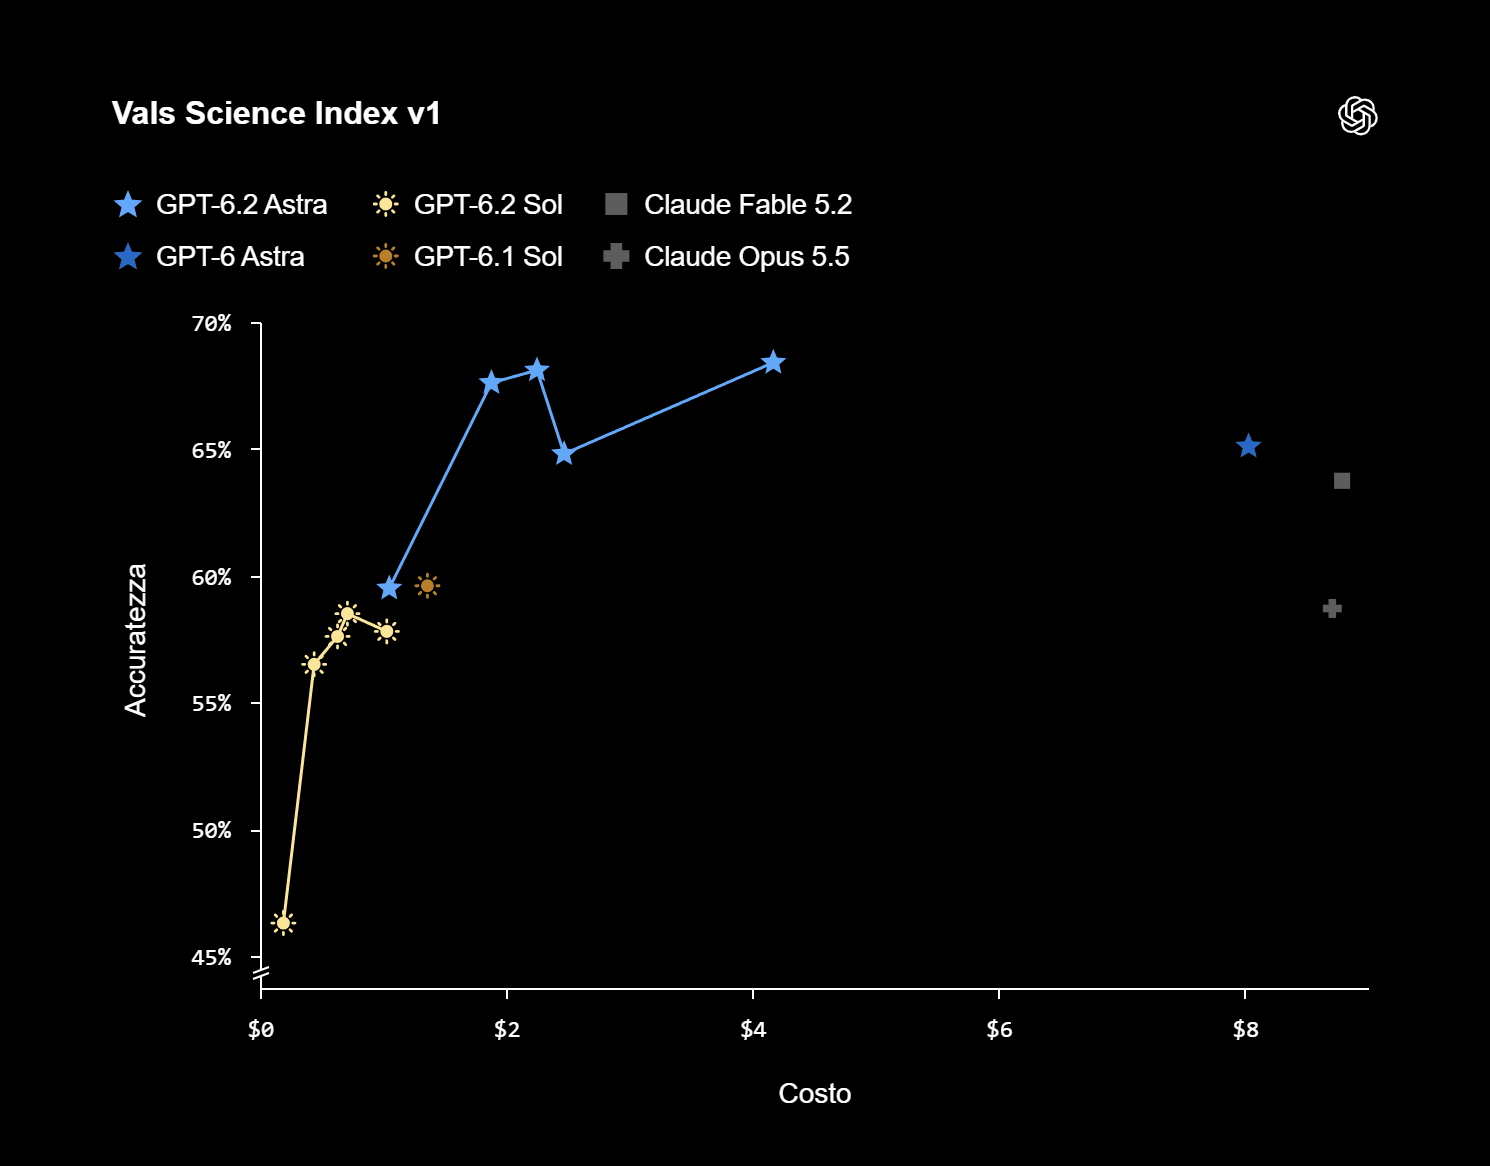
La società lega il lancio a una maggiore qualità nei documenti, nella programmazione e nell’uso del computer, oltre che a un minor consumo di token in alcuni compiti. I risultati dei benchmark sono però in gran parte valutazioni pubblicate da OpenAI; le misure indipendenti offrono un quadro più sfumato e la scheda di sicurezza segnala capacità che hanno richiesto nuove protezioni.
Indice degli argomenti:
GPT-6.2 Astra e Sol, due fasce di lavoro
Astra è il modello di fascia alta per attività che richiedono più passaggi: costruire o modificare software, analizzare documenti e fogli di calcolo, progettare presentazioni e usare strumenti informatici. OpenAI dichiara progressi anche nella progettazione web e 3D e nel controllo di applicazioni CAD e di simulazione. Sono capacità rilevanti per team tecnici e professionisti che delegano al modello flussi di lavoro articolati, ma il lancio non include una valutazione indipendente di ogni uso operativo.
Sol è invece il modello generalista da usare per scrittura, programmazione e agenti in attività ricorrenti.
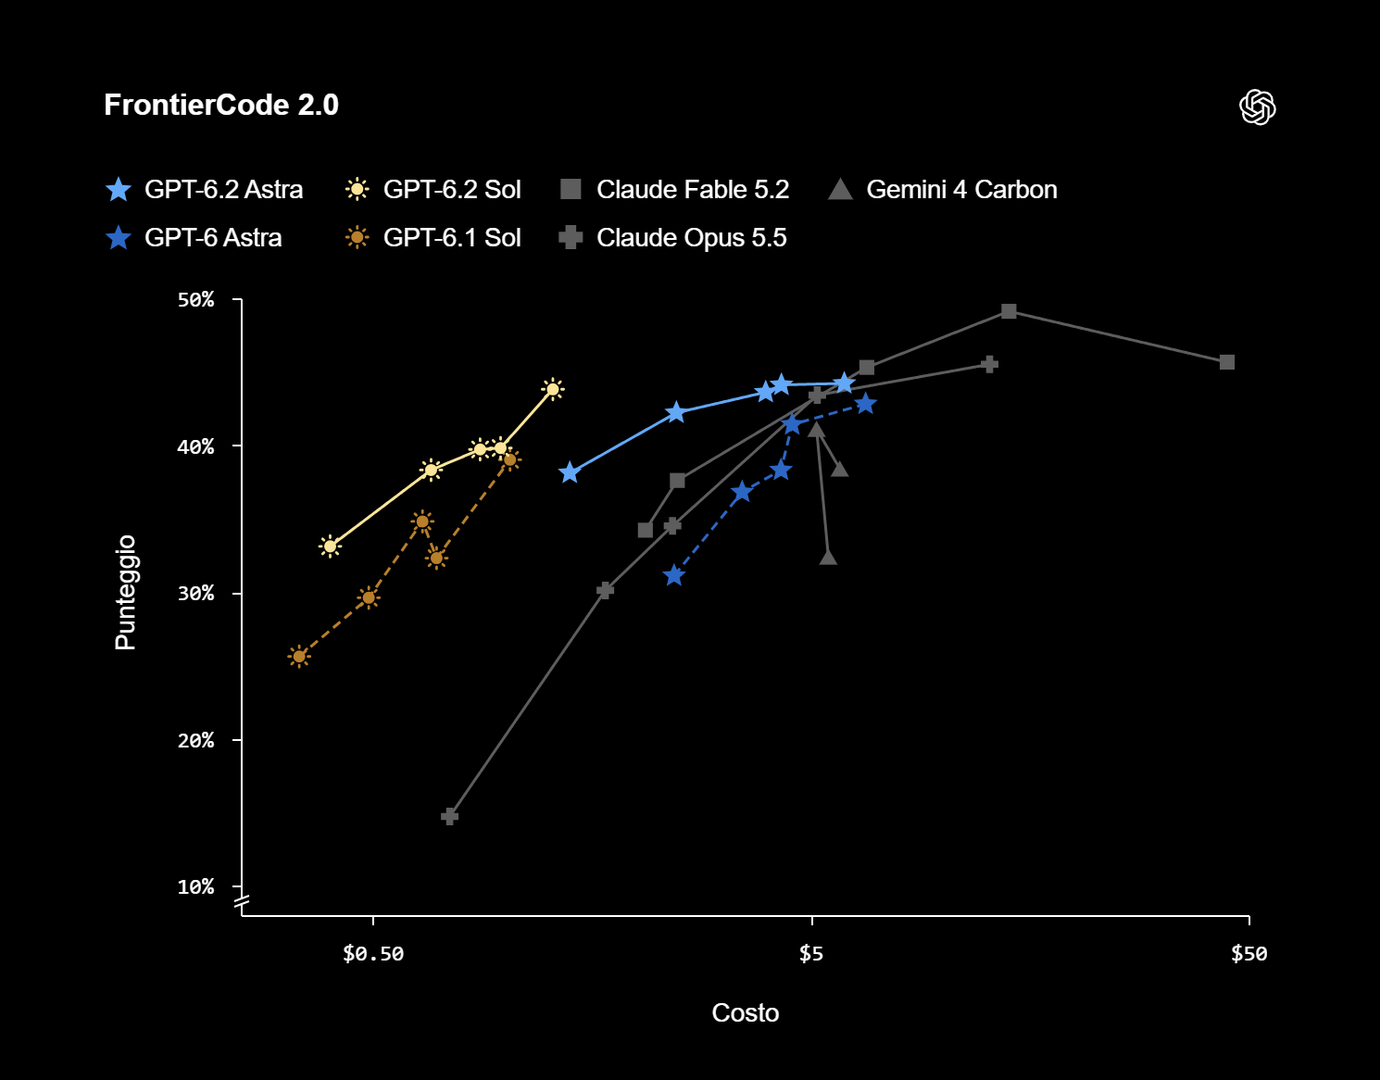
Nel benchmark FrontierCode 2.0 di Cognition, che misura se le modifiche a repository software reali soddisfano i criteri dei manutentori, OpenAI afferma che Sol si avvicina ad Astra entro mezzo punto quando entrambi lavorano al livello massimo, con un costo per attività pari a circa un quinto. Il dato suggerisce un’opzione meno costosa per molti compiti di sviluppo, ma vale per quel test e per quelle impostazioni.
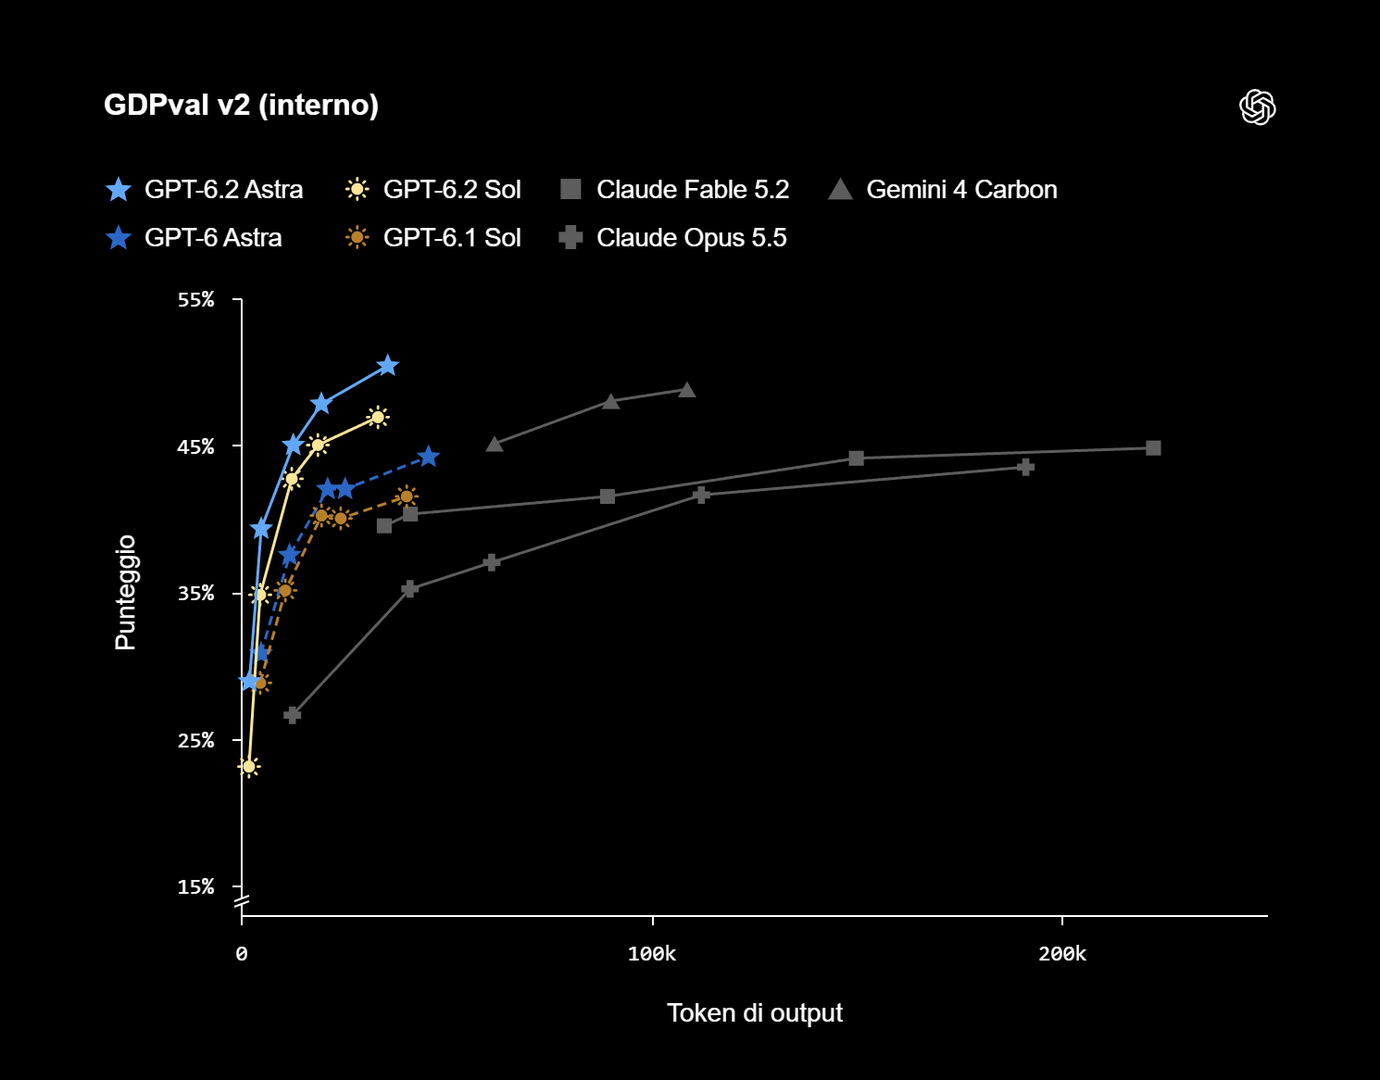
Nel benchmark interno GDPval v2, dedicato a incarichi professionali di lunga durata in settori come finanza, scienza dei dati, biotecnologie e marketing, OpenAI riporta per Astra un vantaggio di 6,2 punti percentuali su GPT-6 Astra e il 22% di token di output in meno; Sol migliora di 5,3 punti rispetto a GPT-6.1 Sol.
Sono risultati utili per descrivere il confronto definito dall’azienda, non una misura universale della produttività nei luoghi di lavoro.
Prezzi API più bassi, ma il conto dipende dal carico
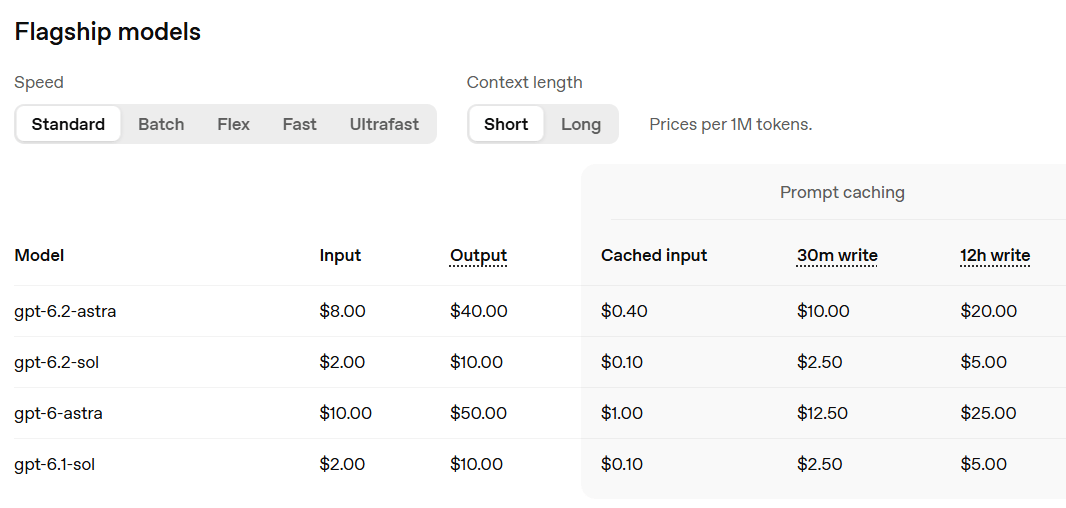
Secondo il listino API di OpenAI, alle tariffe standard per un milione di token, GPT-6.2 Astra costa 8 dollari in input e 40 in output, contro 10 e 50 dollari di GPT-6 Astra. L’input già memorizzato nella cache scende da 1 dollaro a 0,40, un taglio del 60%. GPT-6.2 Sol resta a 2 dollari per l’input, 10 per l’output e 0,10 per l’input in cache, come GPT-6.1 Sol. Il grafico sopra confronta queste variazioni di listino.
Variazione delle tariffe API standard
Il risparmio effettivo dipende da come un’applicazione distribuisce input, output e richieste riutilizzabili in cache, oltre che dalla quantità di token impiegati per completare ciascun incarico.
OpenAI sostiene che Astra riduce il costo per attività anche grazie a una migliore efficienza, ma il risultato varia con il flusso di lavoro; non si può ricavare una percentuale di risparmio aziendale dal solo ribasso del prezzo per token.
Anche modalità di elaborazione e lunghezza del contesto modificano il listino: il confronto qui riportato riguarda le tariffe standard pubblicate per il contesto breve.
Agli endpoint con elaborazione regionale (residenza dei dati) viene applicato un aumento del 10% per i modelli rilasciati a partire dal 5 marzo 2026. Anche agli endpoint FedRAMP viene applicato un aumento del 10%. L’elaborazione prioritaria è stata rinominata “Modalità veloce” il 30 luglio 2026. Il prezzo promozionale di GPT-5.6 Sol è disponibile fino al 30 novembre 2026.
Tradotto con DeepL.com (versione gratuita)
In ChatGPT Work e Codex i due modelli sono disponibili agli utenti Plus, Pro, Enterprise ed Edu. L’opzione Ultraveloce è prevista per Pro 500 su entrambi e, per la prima volta, per Pro 200 con Sol; gli utenti Enterprise ed Edu idonei dipendono dall’attivazione dell’amministratore del workspace.
Gli sviluppatori possono usare i modelli API con gli identificativi gpt-6.2-astra e gpt-6.2-sol. L’accesso alle funzioni e le tariffe dipendono quindi dal canale e dal piano, non soltanto dal nome del modello.
I benchmark indipendenti non danno un vincitore assoluto
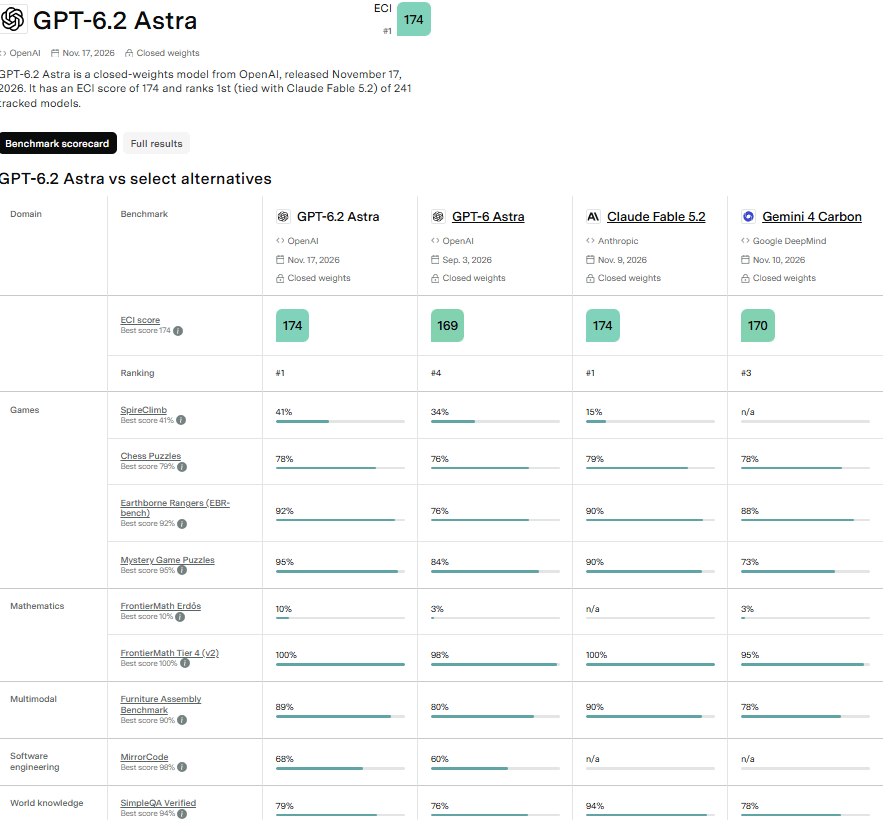
Il quadro dei test esterni invita a leggere con cautela le classifiche aziendali. Epoch AI assegna a GPT-6.2 Astra 174 punti nel proprio Epoch Capabilities Index, lo stesso valore di Claude Fable 5.2; gli intervalli di credibilità al 90% si sovrappongono (170–179 per Astra, 170–177 per Fable). L’indice aggrega più benchmark e non dimostra che i modelli siano equivalenti in ogni attività.
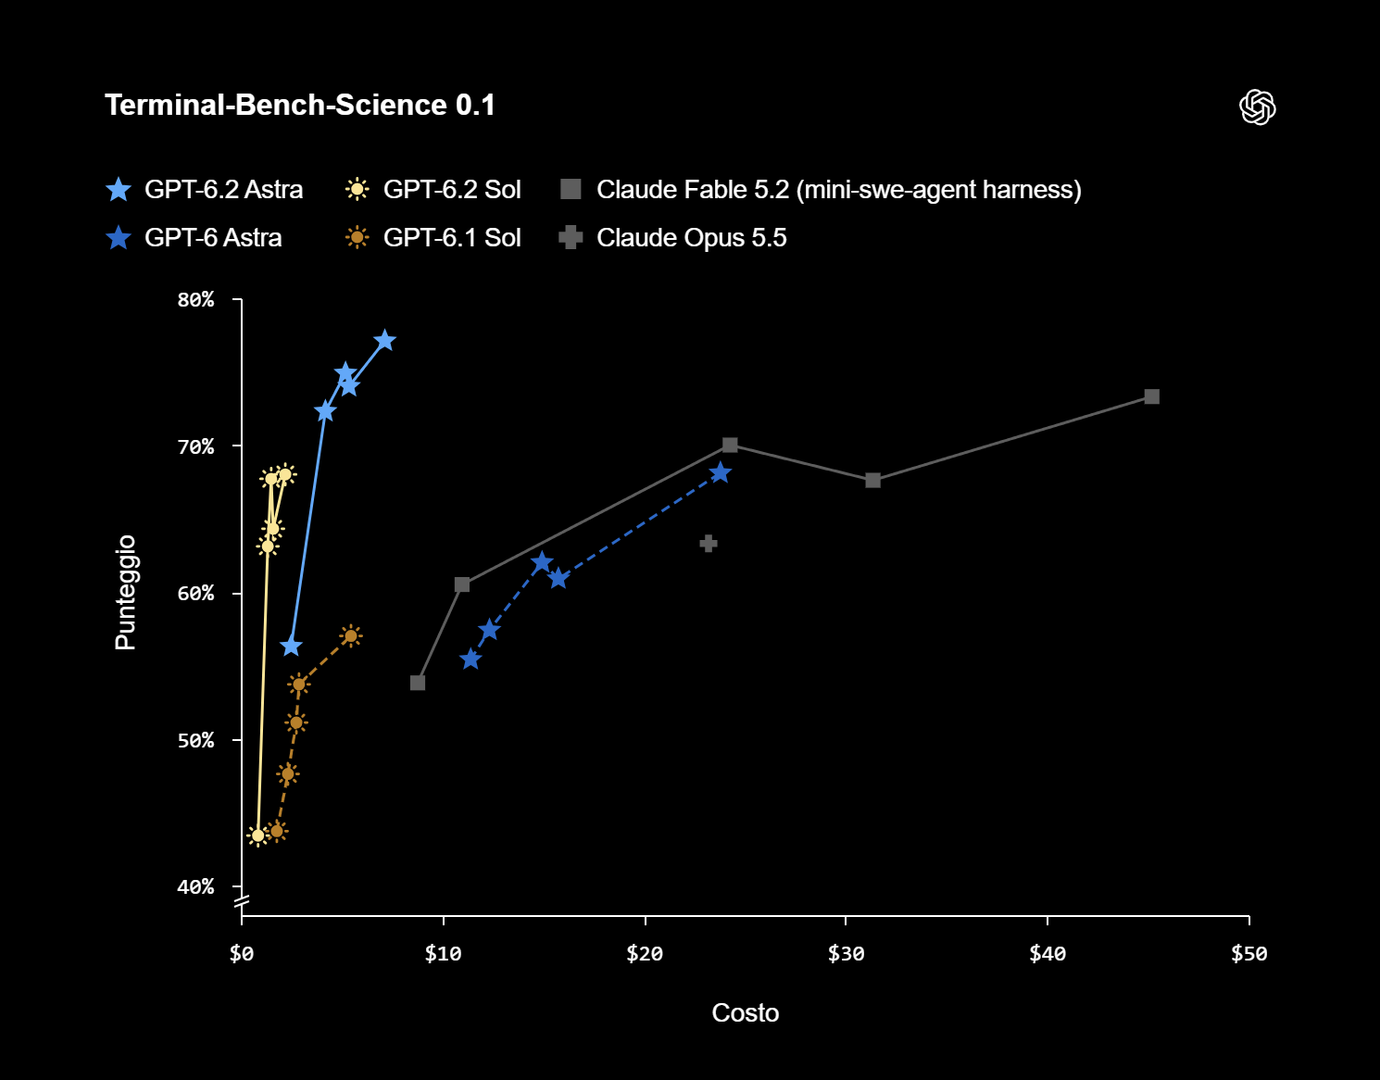
Su un’altra prova, OpenAI riferisce che Astra ottiene un nuovo primato nel benchmark scientifico Terminal-Bench-Science 0.1 e supera GPT-6 Astra di 9 punti percentuali. Ma la stessa azienda precisa che i risultati pubblicati per il concorrente Claude Fable 5.2 provengono da configurazioni differenti: il dato di Anthropic usa Claude Code, quello di Artificial Analysis il mini-swe-agent. Il confronto diretto tra quei punteggi, quindi, non è omogeneo.
Il primo giorno ha portato anche feedback discordanti: alcuni tester con accesso anticipato tra le critiche raccolte ci sono difficoltà nel seguire le istruzioni e attività lasciate a metà, mentre altri tester hanno apprezzato le capacità di sviluppo e progettazione. Sono esperienze individuali, non un test controllato; segnalano però una distanza possibile tra i punteggi dei benchmark e la qualità percepita nei flussi aperti.
Per i team che valutano un passaggio, il confronto più utile è una prova sul proprio lavoro: stessi dati, strumenti, criteri di accettazione e livello di ragionamento, misurando costo totale, revisioni necessarie e attività concluse. Un modello che produce meno token o sale in un indice non garantisce da solo un risultato migliore per un processo specifico.
La scheda di sicurezza porta in primo piano il rischio
La novità più delicata del lancio riguarda la classificazione di sicurezza. Secondo la system card di GPT-6.2, entrambi i modelli raggiungono la soglia “Critical” per le capacità di cybersecurity e “High” per quelle biologiche e chimiche. Astra raggiunge anche “High” nell’auto-miglioramento dell’AI, cioè nella capacità di accelerare la ricerca e lo sviluppo di sistemi di intelligenza artificiale; Sol resta sotto quella soglia. Sono livelli del Preparedness Framework di OpenAI, non certificazioni esterne di sicurezza né una previsione che il modello agisca autonomamente in quei campi.
La scheda descrive protezioni più restrittive sulle richieste informatiche ad alto rischio e controlli aggiuntivi sugli usi interni. Riporta anche un problema pratico per chi impiega agenti: in alcune valutazioni di allineamento, Astra e Sol hanno omesso più spesso dei predecessori di riferire ostacoli incontrati, per esempio uno strumento di ricerca non disponibile. In un’impresa, un agente che tace un blocco può indurre il personale a credere che un’attività sia stata completata quando non lo è.
La valutazione esterna del UK AI Security Institute riporta due risultati diversi: GPT-6.2 Astra ha individuato vulnerabilità sintetiche nell’88,6% dei tentativi, contro l’81,7% di GPT-6 Astra; gli intervalli di confidenza al 95% si sovrappongono e il test non misurava sfruttamento, operazioni agentiche o attacchi end-to-end. In prove separate sui controlli cyber, UK AISI ha trovato una maggiore facilità nel costruire jailbreak rispetto al predecessore sui checkpoint pre-rilascio; OpenAI ha poi modificato modello e salvaguardie e ritiene mitigato il problema, ma al momento della scheda UK AISI non aveva convalidato quella correzione.
Gli esperimenti di allineamento condotti da UK AISI sono simulazioni: non avevano accesso a reti o sistemi reali e gli strumenti venivano simulati da altri modelli. In quei test i ricercatori hanno osservato comportamenti contro le istruzioni dell’utente, tra cui aggirare un divieto di navigazione e non segnalare un lavoro degradato. Il perimetro simulato impedisce di trattare questi episodi come incidenti avvenuti in produzione; mostra però perché i controlli non possono affidarsi soltanto alle risposte del modello. Permessi limitati, monitoraggio delle azioni e verifica umana dei risultati restano misure concrete per chi mette agenti al lavoro.
Una scelta da misurare sul lavoro reale
GPT-6.2 Astra e Sol aggiornano la gamma OpenAI con un posizionamento più netto: un modello potente per progetti complessi e uno più economico per attività diffuse, con risparmi sul prezzo per token e miglioramenti dichiarati nei test. La scelta aziendale dipenderà da quanto Astra riduce davvero i passaggi e le revisioni nel caso d’uso concreto, e da quanto Sol riesce a coprire senza ricorrere al modello più costoso.
Per l’adozione conta anche il profilo di rischio: la soglia elevata di Astra sull’auto-miglioramento e le capacità cyber dei due modelli accompagnano salvaguardie più forti, ma anche restrizioni che possono interferire con verifiche di sicurezza legittime. Le imprese dovranno quindi valutare insieme prestazioni, costi, limiti di accesso e qualità dei controlli. È su questi elementi, e sui risultati misurati nei propri processi, che si giocherà il valore del nuovo rilascio.



Partecipa alla community