


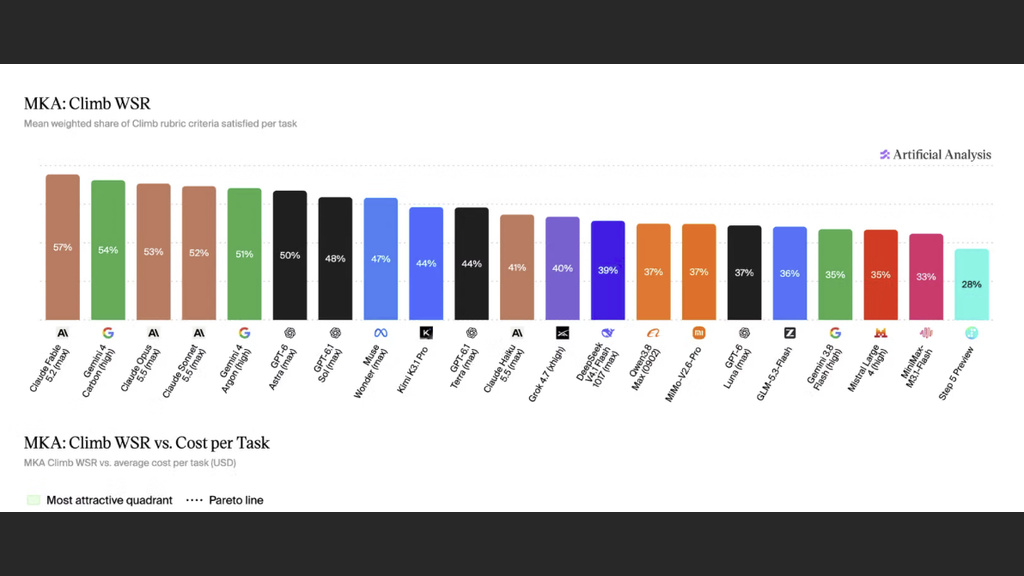
Claude Fable 5.2 ottiene il punteggio più alto, ma Gemini 4 Carbon offre un rapporto tra prestazioni e costo molto più favorevole. La valutazione di Artificial Analysis e Google DeepMind prova a superare i benchmark tradizionali, misurando la capacità di produrre documenti, presentazioni e analisi utilizzabili.
La nuova frontiera della competizione tra modelli di intelligenza artificiale non riguarda soltanto la qualità delle risposte testuali. Sempre più spesso alle AI viene chiesto di esaminare planimetrie, scansioni cliniche, schemi tecnici, tabelle e documenti aziendali, per poi trasformarli in presentazioni, fogli di calcolo, report o immagini annotate.
È questo il terreno esplorato dal nuovo benchmark Multimodal Knowledge Agent, o MKA, sviluppato da Google DeepMind e pubblicato in collaborazione con Artificial Analysis. L’obiettivo è misurare le capacità degli agenti AI in attività professionali realistiche, nelle quali comprendere correttamente le informazioni visive è indispensabile per completare il lavoro.
I primi risultati collocano Claude Fable 5.2 al primo posto, seguito a breve distanza da Gemini 4 Carbon e Claude Opus 5.5. Ma il dato forse più interessante riguarda i costi: il vantaggio qualitativo del modello Anthropic è relativamente contenuto, mentre la spesa media per completare ogni attività risulta molto più elevata.
Indice degli argomenti:
Come funziona MKA
Il benchmark comprende 200 attività private distribuite in dieci settori professionali. I materiali di partenza includono documenti visivamente complessi come disegni architettonici, schemi di ingegneria, mappe, scansioni cliniche e altri file specialistici.
Agli agenti non viene chiesto semplicemente di rispondere a una domanda. Devono produrre un risultato concreto, per esempio:
- una presentazione;
- un foglio di calcolo;
- un documento Word;
- un report in PDF;
- un’immagine annotata;
- un file di testo strutturato.
Le immagini e gli elementi grafici non sono quindi informazioni accessorie. Secondo Artificial Analysis, sono necessari per risolvere correttamente i task.
Ogni attività viene valutata attraverso una griglia elaborata da esperti, con una media di circa 70 criteri ponderati. I criteri sono divisi in due gruppi: quelli di base, chiamati “Regression”, e quelli più difficili, denominati “Climb”. Il punteggio principale, Climb Weighted Satisfaction Rate, indica la percentuale ponderata dei requisiti più complessi soddisfatti dal modello.
I test vengono eseguiti all’interno di Stirrup, l’ambiente agentico open source di Artificial Analysis. Gli agenti possono usare codice, ricerca sul web, consultazione di pagine online e strumenti per analizzare immagini, con un limite massimo di 250 passaggi per attività.
Claude guida, ma il margine è ridotto
Claude Fable 5.2 ottiene il risultato migliore, con un Climb WSR del 57%. Gemini 4 Carbon raggiunge il 54%, mentre Claude Opus 5.5 si ferma al 53%.
La classifica mostra quindi un vantaggio di appena tre punti tra il primo e il secondo modello. Una distanza ridotta, soprattutto se confrontata con la differenza nei costi operativi.
Secondo Artificial Analysis, Claude Fable 5.2 costa mediamente 31,97 dollari per task. Gemini 4 Carbon ne costa 6,29: circa un quinto, a fronte di un punteggio inferiore di soli tre punti.
GPT-6.1 Sol registra invece un costo medio di 1,11 dollari per attività. Rimane entro dieci punti dal risultato migliore e si colloca, insieme agli altri modelli OpenAI testati, sulla frontiera costo-prestazioni individuata dall’analisi.
Il benchmark suggerisce quindi che il modello con il punteggio assoluto più alto non sia necessariamente la scelta migliore per ogni organizzazione. In applicazioni con grandi volumi, la differenza di costo può contare più di pochi punti percentuali di accuratezza.
Nessun modello domina in tutti i settori
Un altro risultato significativo è l’assenza di un vincitore universale. Le prestazioni cambiano sensibilmente a seconda del settore.
Claude Fable 5.2 guida in cinque aree: software e dati, ingegneria, logistica e cartografia, business e finanza, in quest’ultimo caso insieme a Claude Sonnet 5.5.
Claude Opus 5.5 ottiene i risultati migliori nell’istruzione e nelle costruzioni. Gemini 4 Argon prevale nelle attività scientifiche, mentre Gemini 4 Carbon guida il settore sanitario. Claude Sonnet 5.5 ottiene infine il punteggio più alto, con un margine ridotto, in diritto e pubblica amministrazione.
La stessa variabilità emerge osservando il formato dei risultati. Fable 5.2 guida nella produzione di PDF e documenti Word e ottiene i punteggi migliori, o condivisi, per fogli di calcolo e presentazioni. I modelli Gemini risultano invece più forti nelle attività che richiedono immagini, mentre DeepSeek V4.1 Flash 1017 guida nella produzione di file testuali.
Documenti Word e file di testo risultano sorprendentemente difficili: nessun modello supera il 52% dei requisiti complessi previsti dal benchmark.
Perché questo benchmark conta
MKA prova ad avvicinare la valutazione dei modelli alle condizioni reali del lavoro professionale. Molti benchmark tradizionali misurano conoscenza, ragionamento o programmazione attraverso domande con risposte relativamente brevi e facilmente verificabili. Nelle aziende, però, il risultato richiesto è spesso un artefatto completo che deve rispettare struttura, formato, precisione e convenzioni specifiche del settore.
Il benchmark mette inoltre in evidenza la crescente importanza della capacità multimodale. Un agente destinato a studi professionali, ospedali, imprese industriali o società finanziarie deve saper interpretare contemporaneamente testo, grafici, immagini, disegni e tabelle. Deve poi trasformare questa comprensione in un documento utilizzabile, non limitarsi a descrivere ciò che vede.
I risultati indicano che i modelli frontier stanno facendo progressi, ma sono ancora lontani da un’affidabilità uniforme. Anche il modello migliore soddisfa poco più della metà dei criteri difficili. Per attività ad alto rischio, il controllo umano rimane indispensabile.
I limiti della valutazione
MKA introduce una metodologia più vicina al lavoro reale, ma presenta alcuni limiti importanti.
Le 200 attività sono private. Questa scelta riduce il rischio che i modelli siano stati addestrati direttamente sui test, ma rende più difficile per soggetti esterni verificare integralmente dataset e risultati.
La valutazione utilizza inoltre GPT-6 Luna, configurato con livello di ragionamento medio, come giudice agentico. Il sistema applica rubriche preparate da esperti, ma rimane un modello AI che valuta l’output di altri modelli. Eventuali preferenze, errori o affinità del giudice potrebbero influire sui punteggi.
Il benchmark è stato sviluppato da Google DeepMind e pubblicato in partnership con Artificial Analysis. Sebbene Gemini non risulti primo nella classifica generale, questa collaborazione va comunque considerata quando si interpreta la metodologia.
Infine, differenze di pochi punti non dovrebbero essere lette come distanze definitive. Il risultato può cambiare con aggiornamenti dei modelli, variazioni dell’ambiente agentico, strumenti disponibili, limiti di calcolo e modalità di prompting.
La scelta del modello diventa un problema economico
Il messaggio principale di MKA è che la competizione tra agenti AI non può essere riassunta in una singola classifica. Claude Fable 5.2 offre le prestazioni complessive migliori, ma Gemini 4 Carbon si avvicina molto con costi nettamente inferiori. I modelli OpenAI mostrano, a loro volta, un posizionamento competitivo sul rapporto tra qualità e spesa.
Per le imprese la domanda non sarà semplicemente quale modello sia “più intelligente”. Sarà necessario stabilire quale combinazione di accuratezza, costo, velocità, sicurezza e specializzazione settoriale sia più adatta a ogni workflow.
MKA mostra anche quanto lavoro resti da fare. Se nessun modello supera il 57% sui criteri più difficili, gli agenti multimodali sono già strumenti professionali interessanti, ma non ancora sostituti affidabili dei processi di revisione e controllo.


Partecipa alla community