


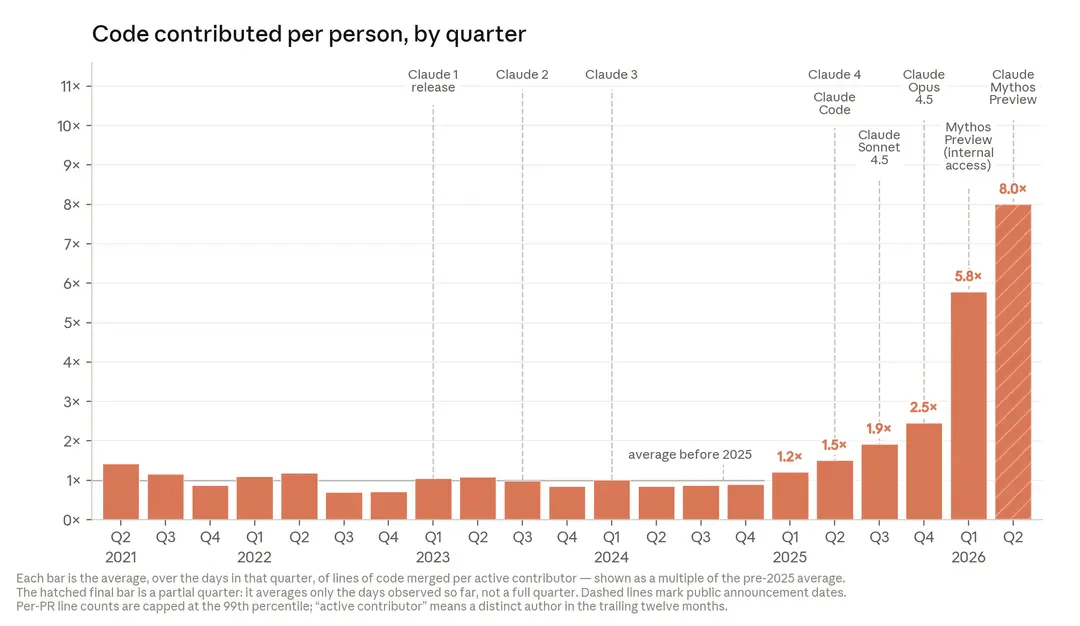
Claude sta già svolgendo gran parte del lavoro necessario a sviluppare le future versioni dell’intelligenza artificiale. Nell’agosto 2026, secondo un indice interno di Anthropic, il modello guidava sotto supervisione umana il 26% delle attività di ricerca e sviluppo della società. A marzo quella quota era appena dell’1%. È il segnale di una trasformazione che potrebbe accorciare il ciclo di sviluppo dei modelli e, con esso, quello dei prodotti e servizi che le imprese costruiscono sull’AI.
Il dato, diffuso da Anthropic il 17 settembre e riportato al centro di un approfondimento del Wall Street Journal pubblicato il 30 ottobre negli Stati Uniti, richiede però una distinzione decisiva. Il 26% non indica ricerca svolta senza esseri umani: significa che Claude compie la maggior parte di determinati compiti, mentre ricercatori e ingegneri stabiliscono gli obiettivi, supervisionano il processo e ne verificano i risultati. Nell’agosto osservato, l’indice non attribuiva a Claude alcuna attività completamente autonoma.
La progressione mensile è impressionante anche senza trasformarla in una previsione. La serie riportata dal giornale, costruita sui dati aziendali, mostra il passaggio dall’1% di marzo al 3% di aprile, al 12% di maggio, fino al 26% di agosto. Il grafico ricostruisce soltanto questa categoria, chiamata AI leads, per distinguere il lavoro guidato dall’AI da quello nel quale l’intervento umano è del tutto assente.
Il punto che interessa il business è già visibile: l’AI comincia a incidere sulla velocità con cui si produce altra tecnologia. Quando uno strumento accelera la progettazione del suo successore, possono ridursi i tempi necessari per sperimentare nuove funzionalità, correggere errori e aggiornare i sistemi che poi le aziende acquistano. Non è ancora provato che il miglioramento prosegua senza limiti, né che il vantaggio tecnico si traduca automaticamente in profitti.
Indice degli argomenti:
Che cosa significa davvero quando un’AI contribuisce a migliorarne un’altra
Per capire come possa funzionare questo processo, basta immaginare un gruppo che sta sviluppando un nuovo modello. Prima servivano ingegneri per scrivere e modificare il software di addestramento, avviare esperimenti, esaminare i risultati e correggere i problemi. Oggi un agente può ricevere un obiettivo definito da una persona — per esempio velocizzare un programma senza peggiorarne l’accuratezza — e scrivere codice, eseguire test, confrontare soluzioni e proporre una modifica. Il gruppo umano valuta poi se adottarla.
Se quelle modifiche contribuiscono a costruire un modello successivo più capace, il nuovo modello potrà aiutare a sua volta i ricercatori in compiti più difficili. Si crea così un possibile ciclo di miglioramento che si alimenta attraverso le capacità sviluppate nei passaggi precedenti. È il principio del miglioramento ricorsivo dell’AI, o recursive self-improvement (RSI), discusso da decenni e ora osservabile nelle sue forme iniziali di assistenza alla ricerca.
La differenza rispetto a uno scenario pienamente ricorsivo resta grande. Nel suo approfondimento When AI builds itself, Anthropic riconosce che Claude sa eseguire bene esperimenti con obiettivi già fissati, ma incontra ancora difficoltà quando deve decidere da solo quali problemi scientifici affrontare. La scelta delle ipotesi, la valutazione del loro significato e la direzione della ricerca continuano quindi a dipendere in misura rilevante dai ricercatori.
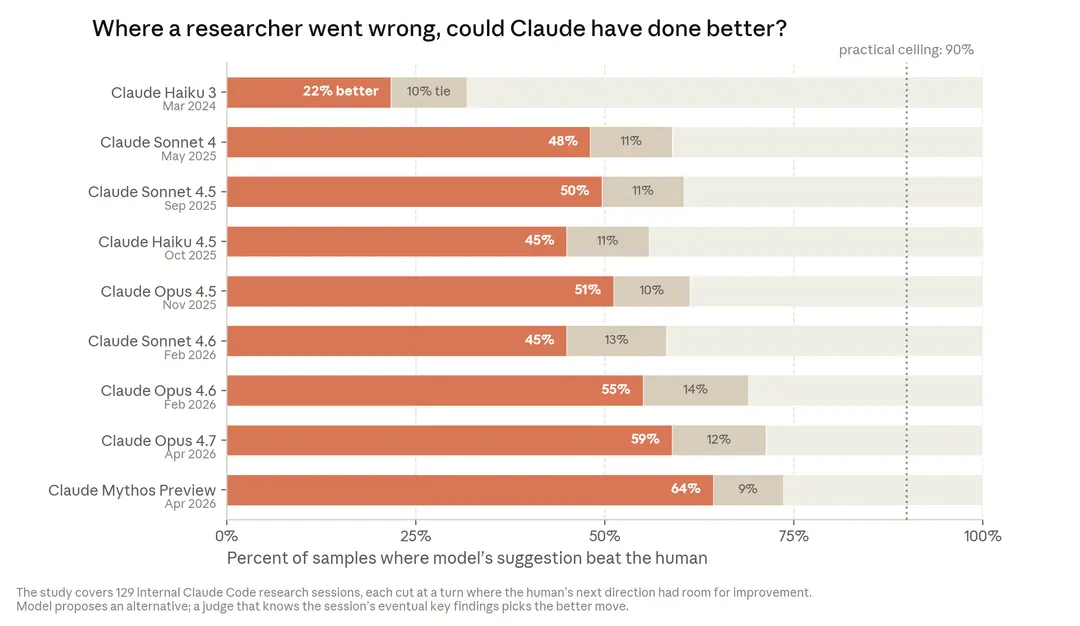
È una distinzione che conta anche per interpretare i benchmark. L’istituto indipendente Metr misura la difficoltà delle attività software che un agente riesce a completare con un determinato livello di affidabilità. La durata riportata si riferisce al tempo che impiegherebbe una persona esperta, non alle ore trascorse effettivamente dall’agente al lavoro. Inoltre la prova riguarda soprattutto attività software, di machine learning e di sicurezza informatica, non tutte le decisioni richieste nella ricerca scientifica o nella gestione di un’impresa.
Il 26% di Anthropic: come è stata fatta la misurazione e quanto è affidabile
La base dell’indice è descritta nel rapporto Measurements for understanding the pace of AI development inside frontier labs. Anthropic ha campionato il lavoro di parte dei suoi dipendenti nel luglio 2026 e ha usato agenti Claude per ricavare circa 15.000 attività granulari da documentazione e conversazioni aziendali. Le attività sono state raggruppate in una classificazione comune e valutate secondo sei livelli di automazione, dal lavoro senza AI a quello interamente autonomo.
La categoria che raggiunge il 26% è il quinto livello, denominato AL4: l’agente svolge la maggior parte del lavoro a partire da istruzioni generali, sotto controllo umano. Il livello successivo, AL5, richiede invece che l’AI lavori dall’inizio alla fine senza persone coinvolte. Anthropic ha rilevato anche che oltre il 90% delle attività considerate raggiunge almeno il livello della collaborazione tra persone e AI, che resta una categoria distinta da quella della guida operativa.
Per calcolare le quote, la società non conta semplicemente quante azioni siano state svolte dai modelli: attribuisce alle categorie un peso ricavato dal tempo-persona dedicato al lavoro. L’indice è quindi una stima della distribuzione dell’automazione nelle attività considerate, costruita su un insieme di compiti mantenuto stabile per confrontare i mesi. Non indica che Claude abbia progettato da solo il 26% di un nuovo modello né che un quarto del personale di Anthropic sia stato sostituito.
Esiste anche un limite alla verifica: sono stati altri sistemi Claude a raccogliere e classificare gran parte delle evidenze. Anthropic ha confrontato i giudizi automatici con quelli dei dipendenti, ma riconosce che resta discutibile il confine fra “collabora” e “guida”. Per questo propone verifiche indipendenti e criteri comuni fra laboratori. Il grafico è una misurazione aziendale documentata, non un benchmark certificato da una terza parte.
Dal laboratorio all’impresa: nuovi prodotti sviluppati più rapidamente
La conseguenza economica più immediata non riguarda soltanto il mercato dei grandi modelli. Se un agente riesce a svolgere più fasi della ricerca e dell’ingegneria, può diminuire il tempo che separa un’idea da un prototipo verificato. Un fornitore di software gestionale potrebbe sperimentare più versioni di una funzione, un’azienda industriale valutare un maggior numero di algoritmi di manutenzione, una società biotech accelerare l’analisi preliminare di ipotesi da sottoporre poi a controlli scientifici.
Perché il vantaggio diventi reale, ogni passaggio deve produrre risultati utilizzabili. Avere dieci prototipi al posto di due è un beneficio se l’impresa riesce a testarli e a integrarli nel prodotto. Se invece i controlli di sicurezza, la validazione normativa o la raccolta di dati affidabili richiedono lo stesso tempo di prima, il collo di bottiglia si sposta dal lavoro di sviluppo alle attività successive. Nella sanità, per esempio, una proposta di modello può arrivare rapidamente, ma dimostrarne sicurezza ed efficacia richiede prove che non si possono eliminare accelerando il codice.
All’interno di Anthropic il fenomeno ha già effetti misurabili sul volume di produzione software. La società riferisce che nel secondo trimestre del 2026 i suoi ingegneri hanno integrato circa otto volte più righe di codice per persona al giorno rispetto al 2024. Il rapporto stesso avverte che le righe di codice misurano la quantità, non la qualità: otto volte più codice non significa otto volte più produttività economica, clienti o valore aggiunto.
Un’indicazione utile sui limiti di questa conversione arriva da un esperimento indipendente, condotto però con strumenti più vecchi. In uno studio randomizzato pubblicato da Metr nel luglio 2025, 16 sviluppatori open source esperti hanno impiegato in media il 19% di tempo in più per risolvere 246 attività quando potevano usare gli strumenti AI disponibili allora. Il campione era piccolo e comprendeva progetti molto familiari ai partecipanti: il dato non descrive le prestazioni dei modelli del 2026. Mostra però perché i tempi effettivi e i costi di revisione debbano essere misurati, invece di dedurre un risparmio dal numero di operazioni delegate.
Chi può guadagnare dalla corsa e perché il calcolo resta decisivo
Se i modelli migliori aiutano a crearne altri migliori, i grandi sviluppatori potrebbero ottenere un vantaggio che si accumula: maggiori capacità permettono più esperimenti, i risultati alimentano versioni successive e queste rendono ancora più efficiente il lavoro di ricerca. È un potenziale vantaggio competitivo per chi possiede modelli, ricercatori, infrastrutture e dati sperimentali nello stesso ecosistema. Ma l’effetto dipende anche da errori, tempi di addestramento e possibilità di verificare le scoperte.
Il ciclo ricorsivo non elimina inoltre la domanda di processori, memoria, energia e data center. Gli agenti devono eseguire codice, interrogare modelli, ripetere test e avviare esperimenti; le nuove generazioni di modelli richiedono a loro volta investimenti nell’addestramento. Se una parte degli esperimenti costa meno lavoro umano ma richiede più calcolo, il costo complessivo dell’innovazione può diminuire per singolo test e aumentare in valore assoluto, perché l’azienda decide di eseguirne molti di più.
Questa dinamica può favorire hyperscaler e produttori di chip, ma non esclude le imprese più piccole. Startup e fornitori specializzati possono usare modelli esterni per abbassare il costo della sperimentazione in settori verticali. La loro difesa competitiva dipenderà allora meno dal possesso del modello generalista e più da dati pertinenti, competenze di dominio, integrazione nei processi e capacità di dimostrare risultati affidabili. Per un cliente aziendale conta il valore della soluzione nel proprio lavoro, non il numero di ricerche compiute dal laboratorio che ha creato il modello.
Per chi decide un investimento in agenti AI la conseguenza è pratica. Bisogna confrontare il costo dell’intero processo — licenze, token, infrastruttura, test, controlli, integrazione e gestione degli errori — con tempi di consegna, qualità e rischi della soluzione precedente. Il tempo risparmiato nella generazione di codice va confrontato con quello necessario a controllarlo. Un progetto che aumenta i prototipi ma non migliora l’uscita in produzione rimane una sperimentazione costosa.
Come cambiano il lavoro qualificato e la supervisione degli agenti
Quando la macchina può eseguire molti dei passaggi prima affidati a un ricercatore o a uno sviluppatore, cambia la distribuzione dei compiti. Cresce il peso di chi formula problemi, seleziona dati, stabilisce criteri di riuscita, decide quali esperimenti meritano risorse e controlla le conclusioni. Per i profili junior, invece, parte del lavoro ripetitivo che serviva a imparare potrebbe essere delegato agli agenti. Le imprese dovranno riprogettare anche il percorso con cui formano e valutano le competenze, senza dedurre automaticamente da questi dati un numero di posti di lavoro destinati a sparire.
La supervisione però non può consistere in un’approvazione formale di risultati prodotti troppo rapidamente per essere capiti. Anthropic riferisce che, nell’agosto 2026, sulla sua principale piattaforma interna operavano contemporaneamente circa 30.000 agenti impegnati in ricerca e ingegneria. Secondo l’azienda tutte le loro azioni passavano attraverso controlli automatici prima dell’esecuzione; su oltre un miliardo di decisioni, lo 0,002% veniva bloccato. È un indicatore del sistema di controllo adottato, non una dimostrazione che gli agenti siano privi di rischi.
Quando attività simili arrivano in una banca, in un’impresa energetica o in una pubblica amministrazione, un errore può riguardare dati riservati, modifiche ai sistemi, pagamenti o decisioni sulle persone. Per questo l’automazione richiede permessi proporzionati al compito, registrazione delle azioni, verifiche indipendenti e possibilità di interrompere o annullare le operazioni. Il livello di controllo deve aumentare con le conseguenze che un agente può produrre, non soltanto con le capacità dichiarate del modello.
Le conseguenze generali: sicurezza, ricerca scientifica e competizione geopolitica
Il problema va oltre l’organizzazione dei singoli laboratori. Una ricerca AI più veloce può accelerare la scoperta di nuovi materiali e medicinali, lo sviluppo di sistemi energetici e la progettazione di strumenti scientifici. Le applicazioni utili dipendono però da prove nel mondo fisico, dalla disponibilità di dati e dalla capacità delle istituzioni di valutarle. La velocità con cui si genera una possibile scoperta non coincide con la velocità con cui la si può considerare vera e sicura.
Le stesse capacità possono rendere più rapide attività offensive nella cybersicurezza o in altri campi sensibili. Inoltre, se poche aziende e pochi Paesi possiedono le infrastrutture capaci di alimentare il miglioramento successivo dei modelli, aumenta la loro influenza sui mercati e sui settori che dipendono da quei sistemi. La concentrazione del calcolo e della conoscenza tecnologica diventa anche una questione di potere economico e politico, particolarmente rilevante per l’Europa che cerca maggiore autonomia nella filiera AI.
La preoccupazione non riguarda soltanto Anthropic. Il 6 settembre il chief scientist di OpenAI, Jakub Pachocki, ha indicato nella ricerca AI automatizzata una direzione essenziale per mantenere la competitività dei modelli di frontiera, avvertendo al tempo stesso che allineamento e monitoraggio non sono ancora sufficienti per accelerare senza cautele. Le due posizioni convergono su un nodo: se l’AI contribuisce sempre di più a sviluppare se stessa, la capacità di controllare il processo deve migliorare almeno altrettanto rapidamente.
L’Unione europea dispone già di regole per i fornitori di modelli di uso generale. La Commissione europea ricorda che l’AI Act prevede per i modelli con rischio sistemico obblighi aggiuntivi di valutazione dei rischi, segnalazione degli incidenti e cybersicurezza. Queste disposizioni non costituiscono, da sole, un meccanismo di controllo del ritmo del miglioramento ricorsivo: misurare quanta ricerca venga delegata agli agenti e rendere verificabili quelle misure potrebbe diventare un’informazione utile anche per autorità e valutatori indipendenti.
La soglia decisiva, dunque, non è il giorno in cui un’AI dichiarerà di aver costruito autonomamente la successiva. È quanto prima imprese e istituzioni saranno in grado di capire quali attività stanno davvero automatizzando, quali benefici misurabili ottengono e chi conserva il potere di correggere una decisione. Il 26% di Anthropic documenta un’accelerazione dentro un laboratorio; il modo in cui questa accelerazione si distribuirà tra prodotti, lavoro, investimenti e sicurezza resta la parte più importante da verificare.



Partecipa alla community