


Nello scenario dell’AI generativa in continua e forte accelerazione, le aziende che hanno superato la fase dei progetti pilota si trovano ad affrontare un ostacolo gestionale: la rapida obsolescenza e la deprecazione dei modelli di linguaggio (LLM) da parte dei fornitori commerciali.
A differenza del software tradizionale, dove gli aggiornamenti mantengono la retrocompatibilità, nel mondo dell’AI i provider modificano o ritirano le versioni dei modelli con frequenza trimestrale o persino mensile.
Questa dinamica impone un ciclo di avvicendamento continuo, ponendo sfide complesse sulla stabilità, sulle prestazioni e sulla continuità operativa delle applicazioni già distribuite in produzione.
In questo quadro, Eni ha sviluppato una strategia precisa per governare il fenomeno, e l’esperienza del gruppo energetico fornisce indicazioni di valore per manager e Data leader che intendono strutturare un’architettura enterprise capace di scalare, riducendo i costi e azzerando i rischi di regressione qualitativa delle risorse AI interne.
Indice degli argomenti:
Obsolescenza dei modelli AI e rischi delle strategie improvvisate
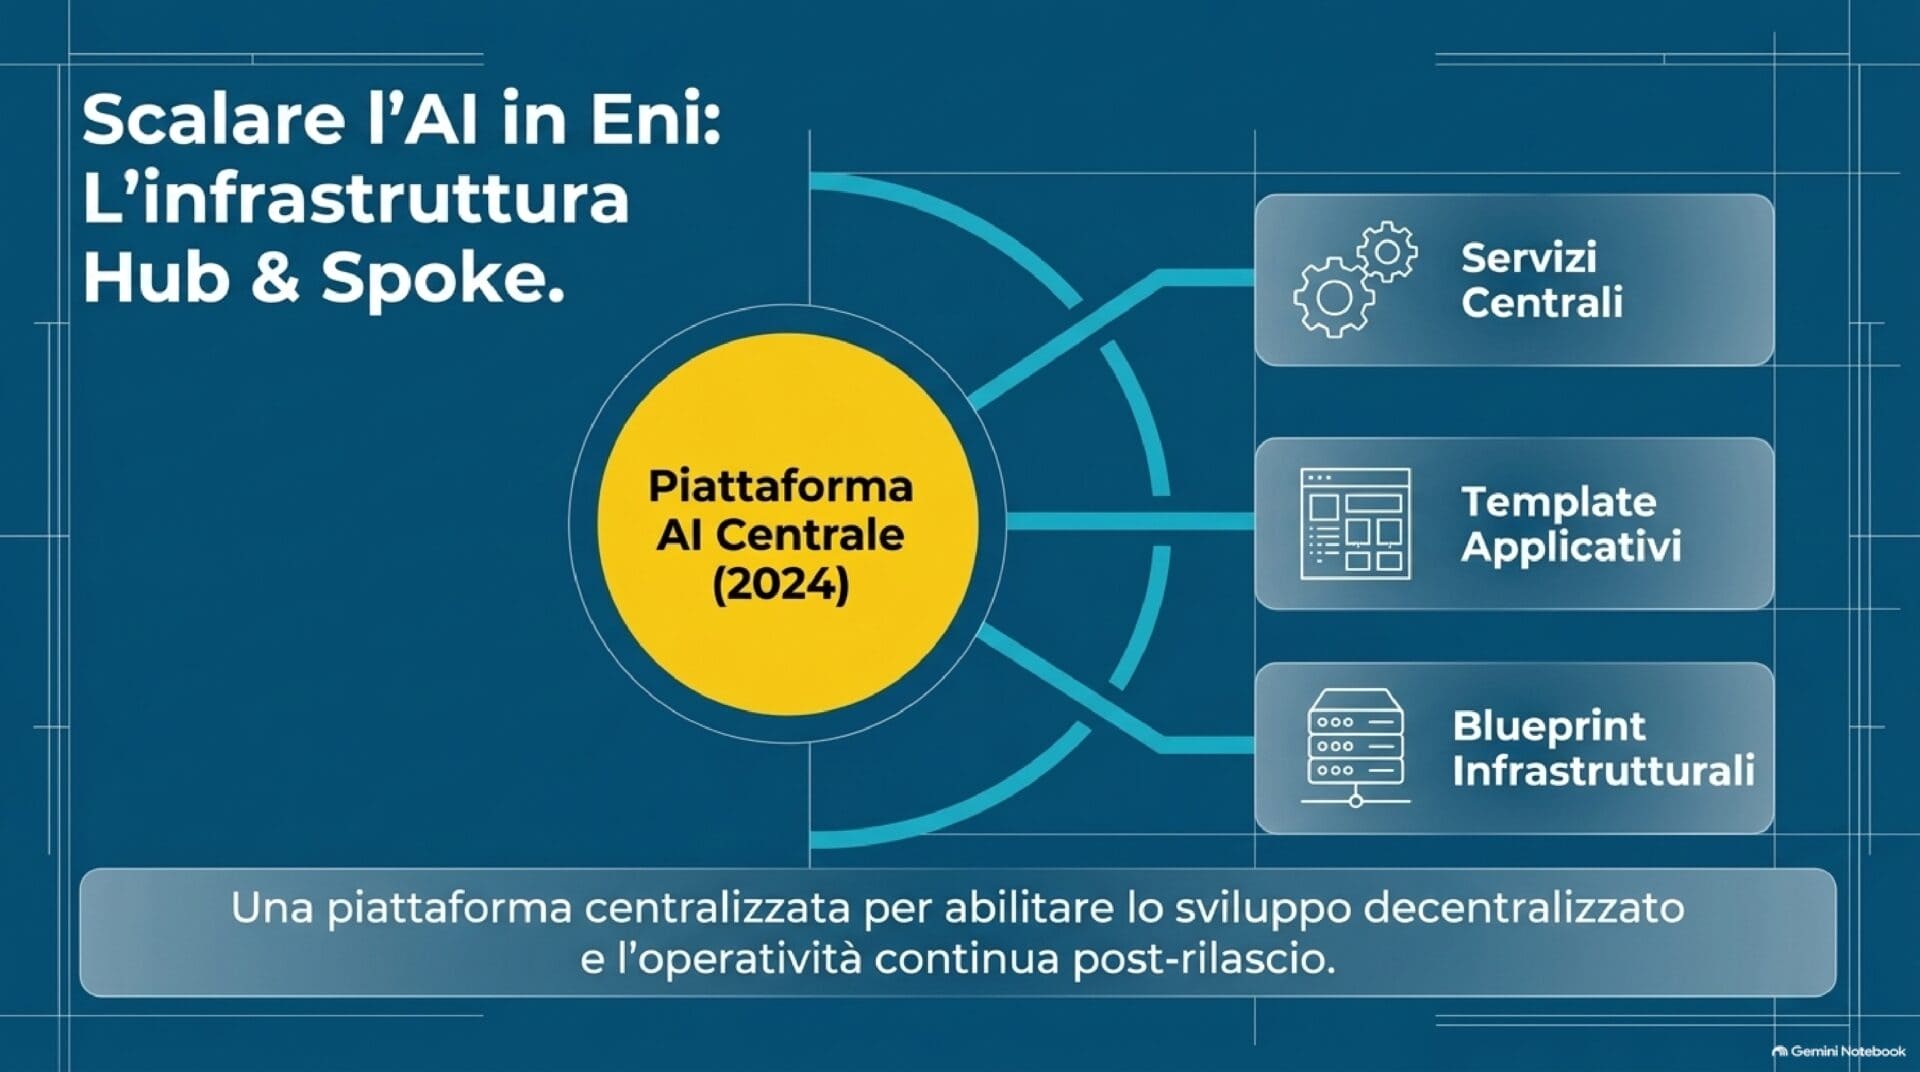
Quando un provider annuncia la deprecazione di un modello di frontiera, le aziende prive di una strategia ad hoc cadono tipicamente in due trappole. La prima è l’approccio definito ‘switch and pray’ (ossia “commuta e prega”): sostituire direttamente il vecchio modello con la versione più recente, sperando che non si verifichino malfunzionamenti o degradi prestazionali.
Tuttavia, gli LLM non sono deterministici: variazioni nelle impostazioni o nell’allineamento possono alterare la capacità di seguire un prompt o interpretare un contesto aziendale.
La seconda trappola è la risposta opposta, ovvero l’esecuzione di test end-to-end completi e indiscriminati sull’intera applicazione ad ogni aggiornamento. Questo metodo ‘full testing’, pur garantendo sicurezza teorica, si rivela estremamente oneroso, lento e insostenibile al crescere del parco applicativo.
Per superare questa dicotomia, Eni ha definito una strategia di Model Lifecycle Management – orientata al passaggio fondamentale da una gestione reattiva delle emergenze a una governance continua e proattiva del portafoglio modelli –, illustrata in occasione del convegno ‘AI and Automation Talk’ organizzato dagli Osservatori Digital Innovation del Politecnico di Milano.
L’architettura abilitante per la gestione dei modelli AI
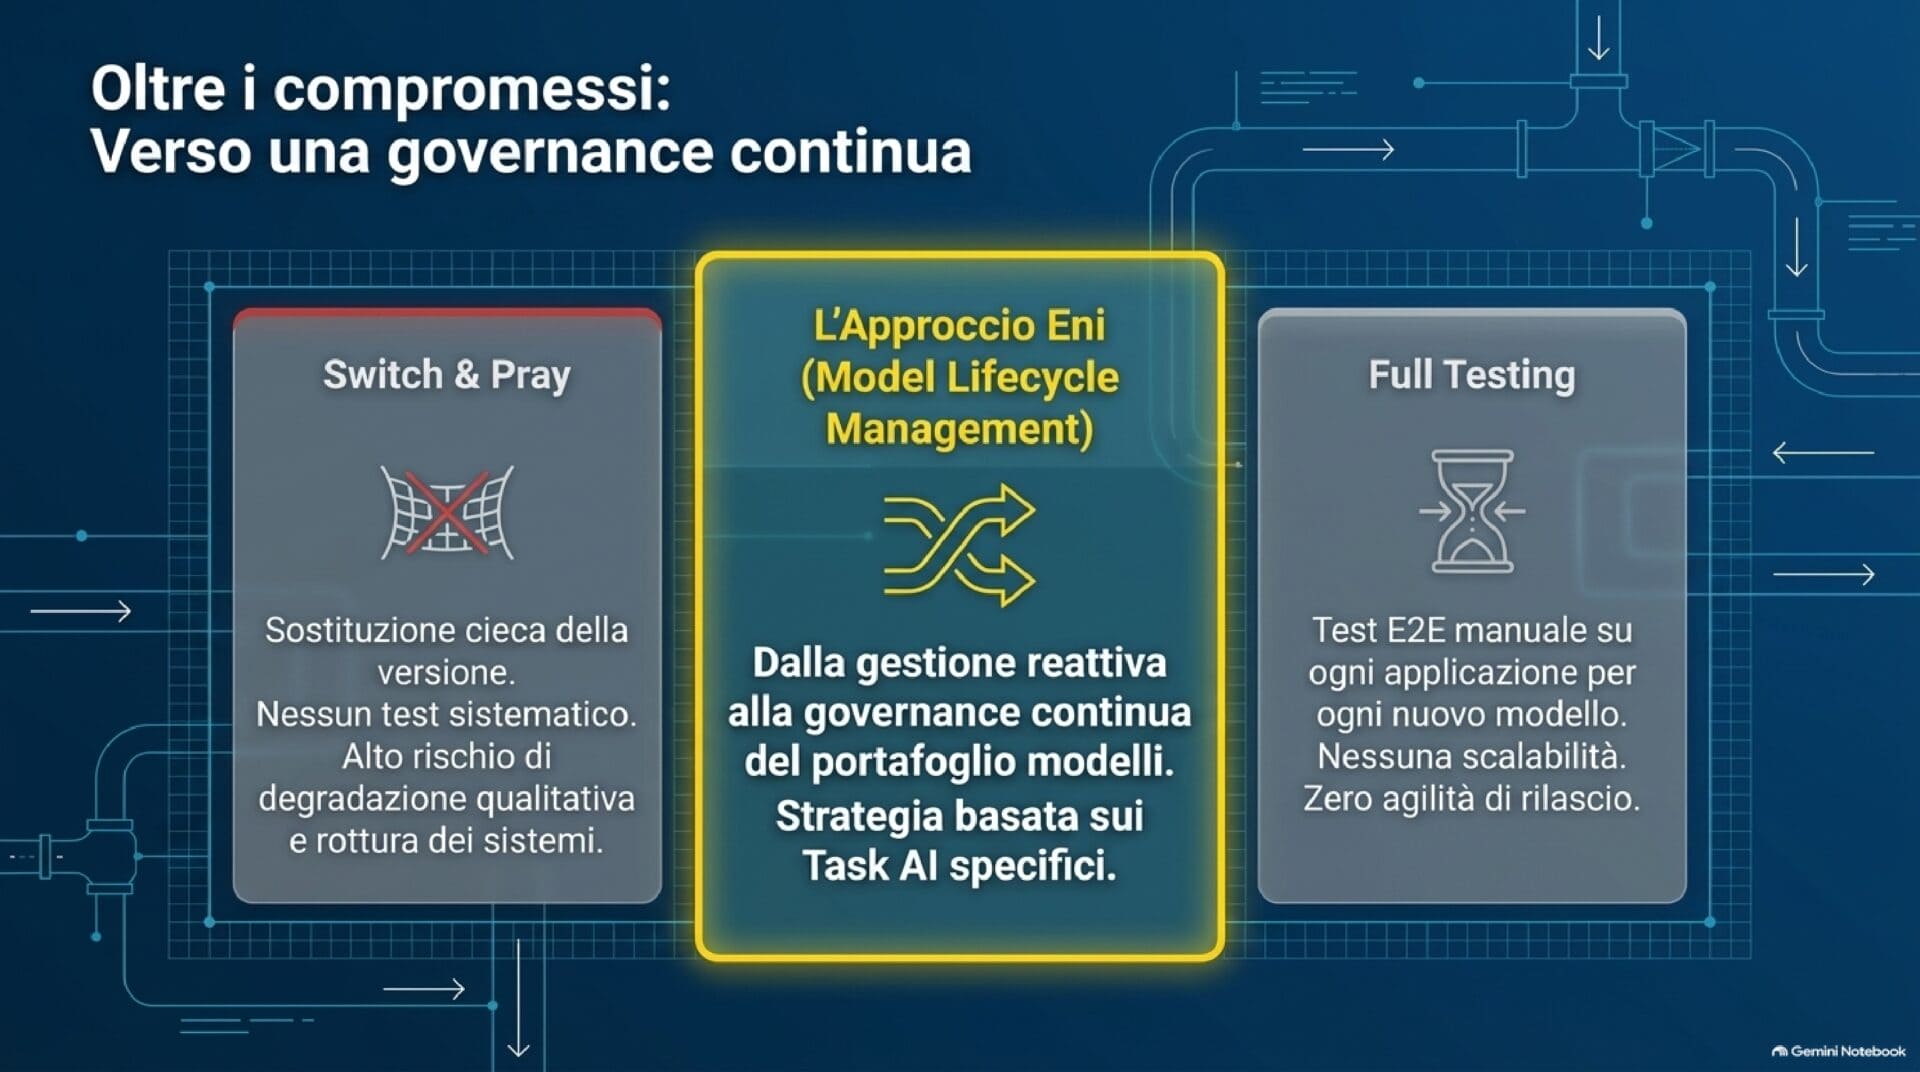
La base dell’approccio di Eni è stata costruita a partire dal 2024 con l’adozione di una piattaforma AI enterprise basata sul modello architetturale Hub and spoke. L’hub centrale fornisce e aggiorna costantemente servizi IT integrati, Template applicativi e Blueprint infrastrutturali a supporto dei singoli spoke aziendali.
Un tassello cruciale è il model gateway integrato nella Eni GenAI Platform. Il gateway agisce come punto unico di orchestrazione e monitoraggio di tutte le chiamate verso i modelli LLM, consentendo di operare sugli applicativi in modo continuo anche dopo il rilascio in produzione.
Ciò permette all’azienda di rispondere tempestivamente al mutare dei requisiti di business, alle evoluzioni tecnologiche del mercato e ai vincoli imposti dalle policy interne di governance o da direttive esterne.
Disaccoppiare applicazioni e modelli
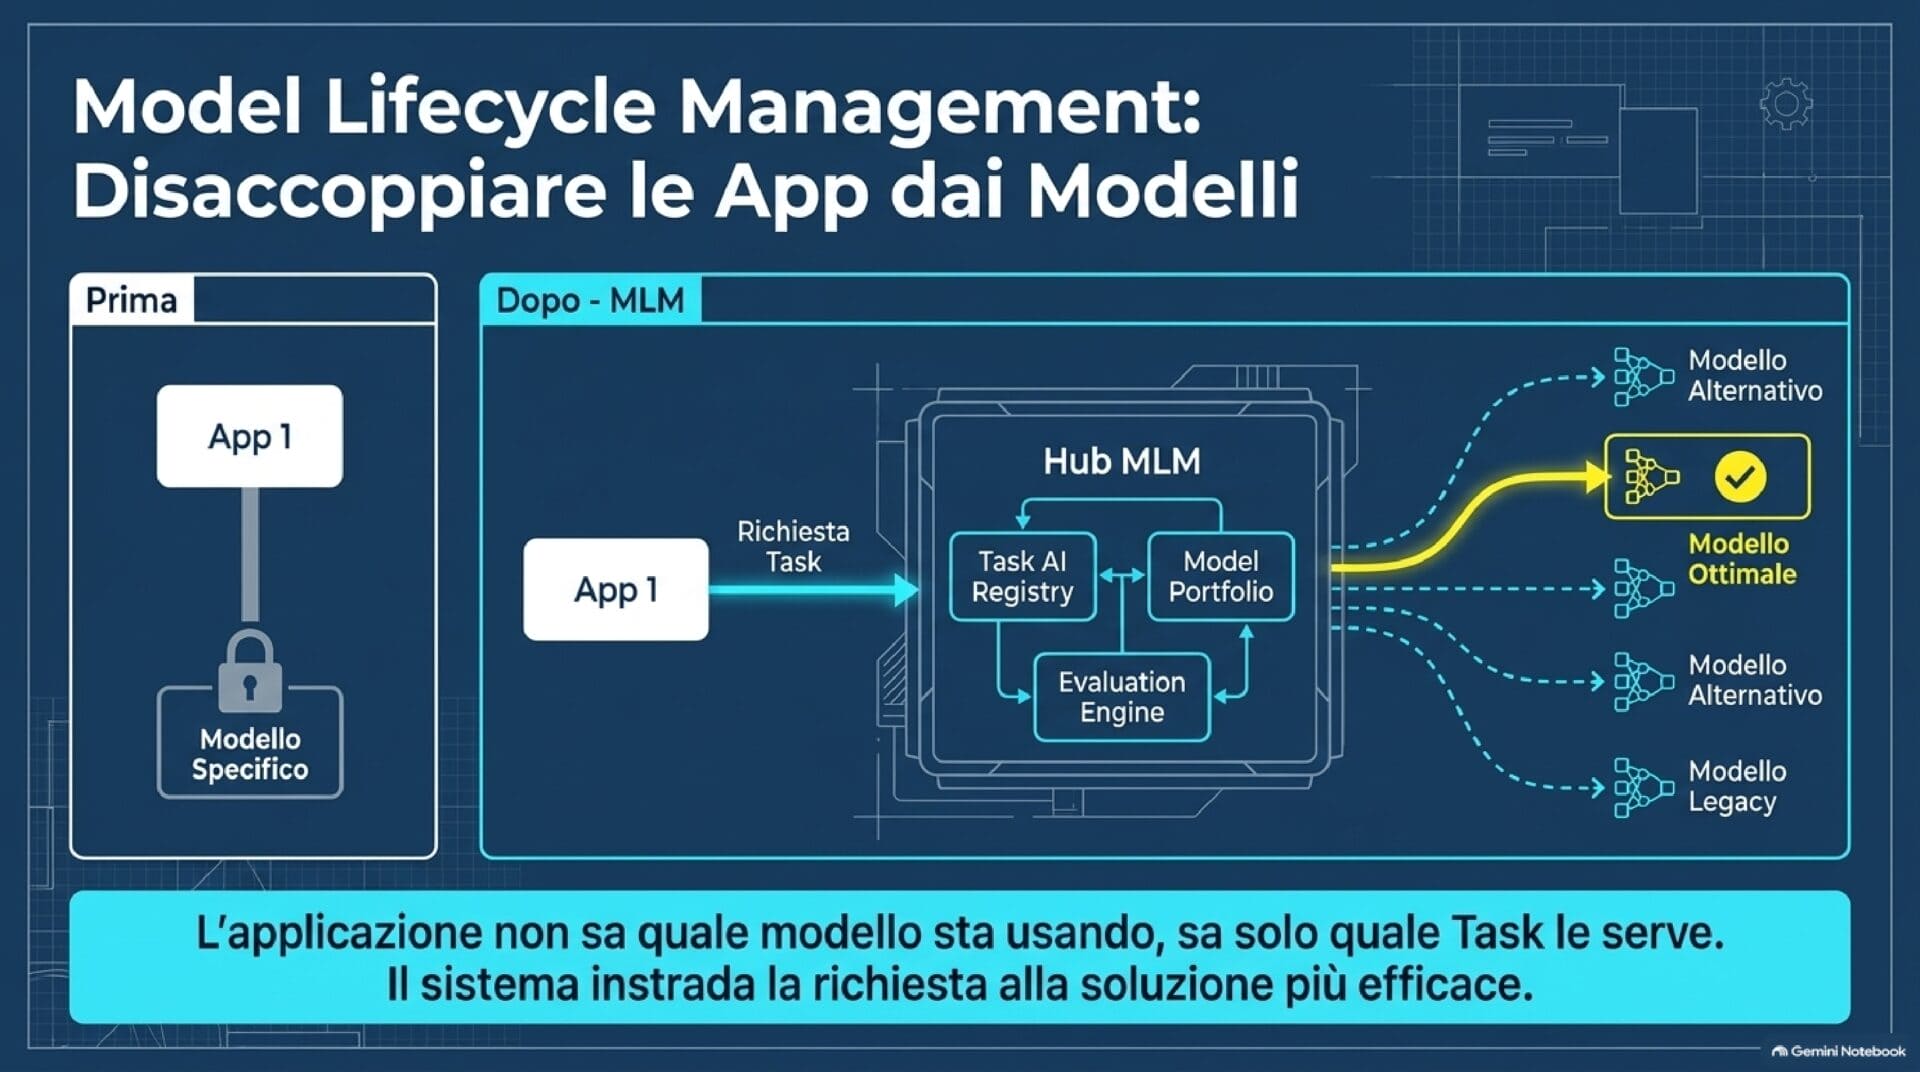
Il cambio di paradigma sta nel disaccoppiamento tra le applicazioni aziendali e i modelli fisici che le alimentano.
Nella visione tradizionale, un caso d’uso viene progettato e cablato rigidamente su un singolo modello LLM: se quel modello diventa obsoleto e viene deprecato, l’intera applicazione deve essere riprogettata.
Eni ha superato questa rigidità scomponendo ogni applicazione AI in specifici e granulari ‘task AI’. L’architettura si articola su tre componenti chiave:
- Task AI registry: un catalogo centralizzato in cui vengono mappati e classificati tutti i task AI delle soluzioni aziendali;
- Model Portfolio: l’insieme dei modelli AI accreditati ed erogabili;
- Evaluation engine: il motore di valutazione e benchmarking continuo.
Attraverso questa struttura, le applicazioni non richiamano più un modello specifico, ma un task AI. Il sistema seleziona il modello più efficace ed efficiente per quel determinato task, consentendo anche l’assegnazione di modelli differenziati per sub-task specifici.
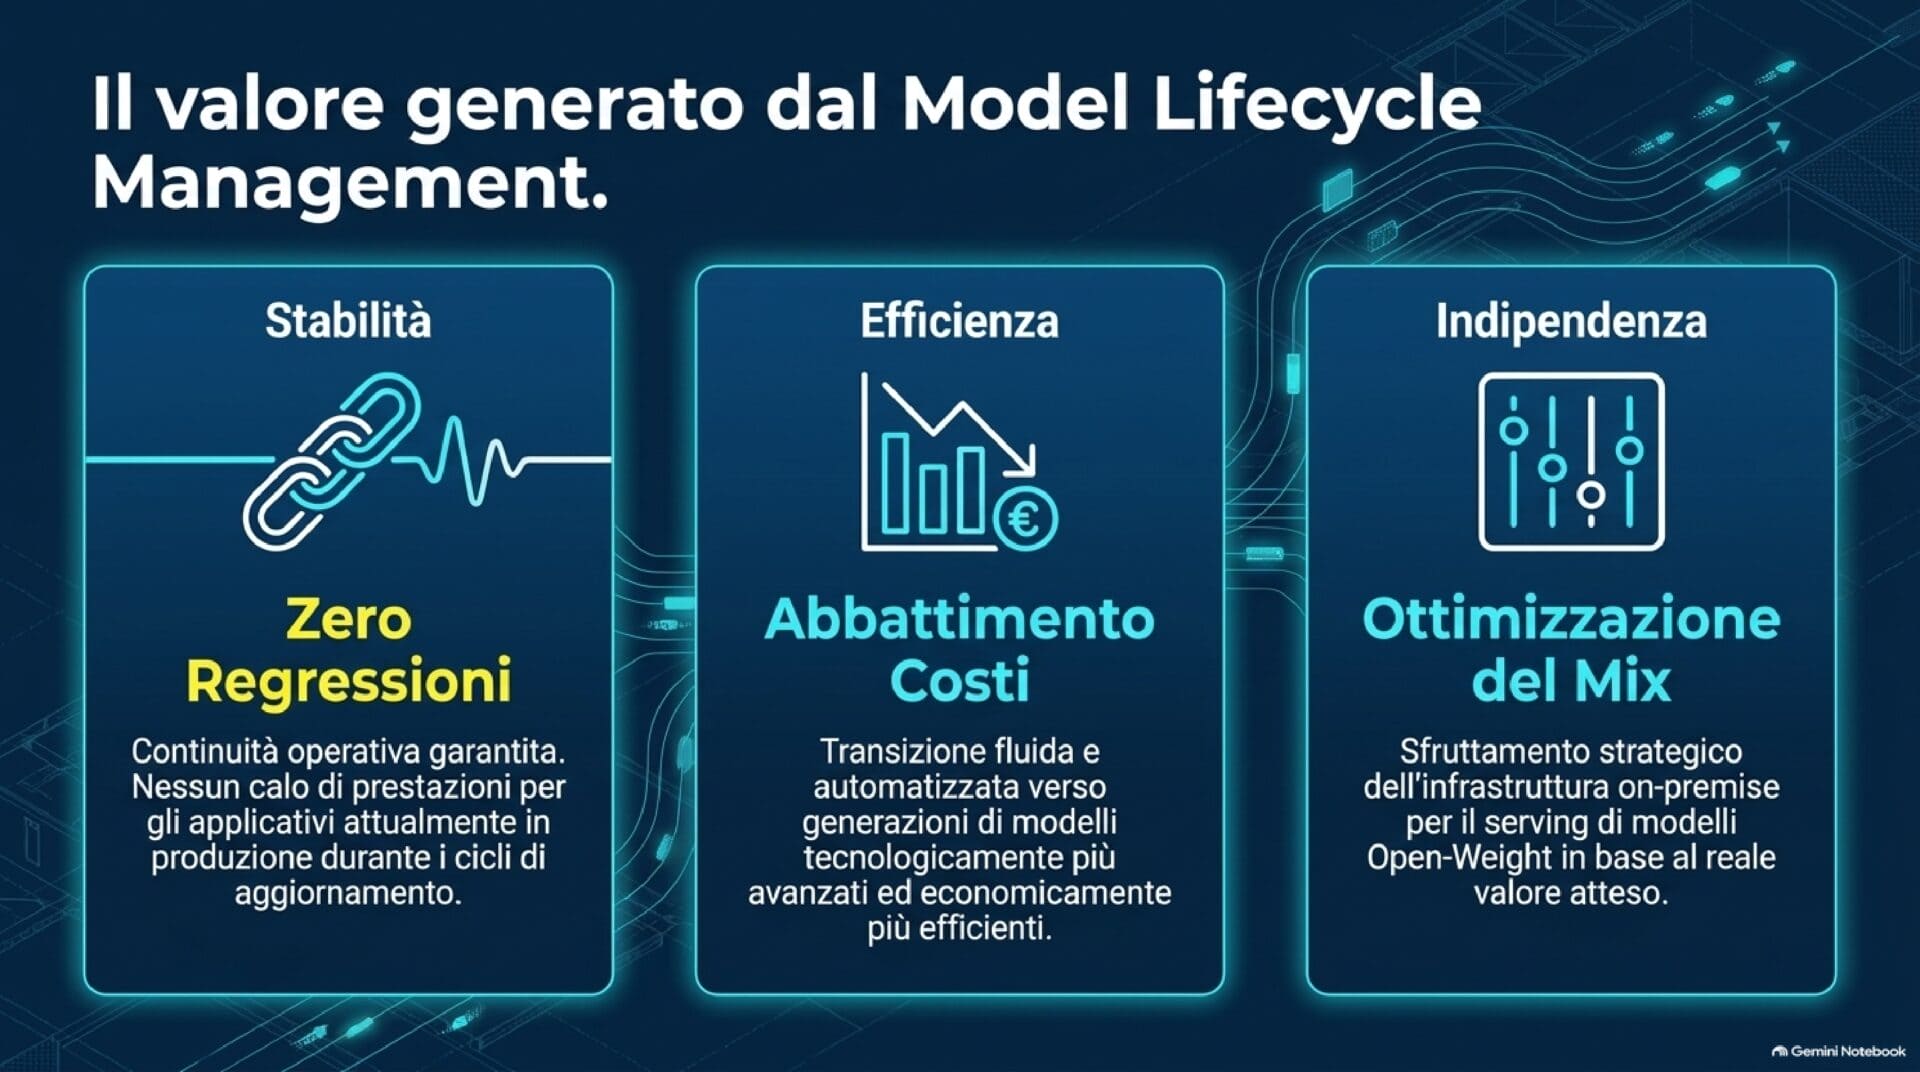
I benefici misurati sono diversi: “azzeramento delle regressioni in produzione”, rileva Lorenzo Lancia, specialista AI di Eni, “riduzione dei costi di aggiornamento, ottimizzazione dinamica del mix di modelli e valorizzazione delle infrastrutture Private AI on-premise”.
La pipeline di valutazione: dai dati di audit all’infrastruttura
Per selezionare i modelli AI in modo scientifico, Eni ha implementato una pipeline di classificazione e testing che trae linfa dai dati reali di utilizzo.
“Durante lo sviluppo, i test end-to-end e l’esercizio delle applicazioni AI”, spiega Lancia, “il model gateway raccoglie i dati di audit completi. Da questi viene estratto un dataset rappresentativo con le tracce di esecuzione reali per ciascun task AI, comprensivo di system prompt, contesto, user prompt, output e task label assegnato”.
Questo dataset viene sottoposto a un duplice processo di misura:
- Testing estensivo delle prestazioni: i modelli candidati — sia commerciali via API, sia Open-weight ospitati sull’infrastruttura di supercalcolo (HPC) di Eni — vengono testati sul dataset, generando Performance report dettagliati con metriche di qualità per ciascuna classe di task.
- Misura dei requisiti di carico: vengono analizzate le distribuzioni temporali per quantificare i volumi stimati in termini di RPM (Requests Per Minute) e TPM (Tokens Per Minute) per ogni Task AI e Use case.
Dalla combinazione tra report prestazionali e requisiti di carico scaturisce la definizione formale della strategia di scelta dei modelli AI.
I quattro criteri guida della selezione: qualità, costi, throughput e longevità
La strategia di selezione di Eni bilancia quattro criteri di valutazione fondamentali: qualità, efficienza dei costi, throughput e longevità. L’analisi dei task AI copre quattro macrocategorie di funzionalità GenAI:
- Text generation: comprende question answering con o senza contesto, generazione free-form, generazione di codice, intent detection, parafrasi, traduzione;
- Agentic workflow: compiti complessi che richiedono agentic reasoning, orchestrazione di workflow agentici e attivazione automatica di strumenti;
- Embedding: operazioni vettoriali per il recupero delle informazioni;
- Security-related: servizi di barriera di sicurezza e LLM guardrail (validazione input, controlli di sicurezza su codice e visualizzazione dati).
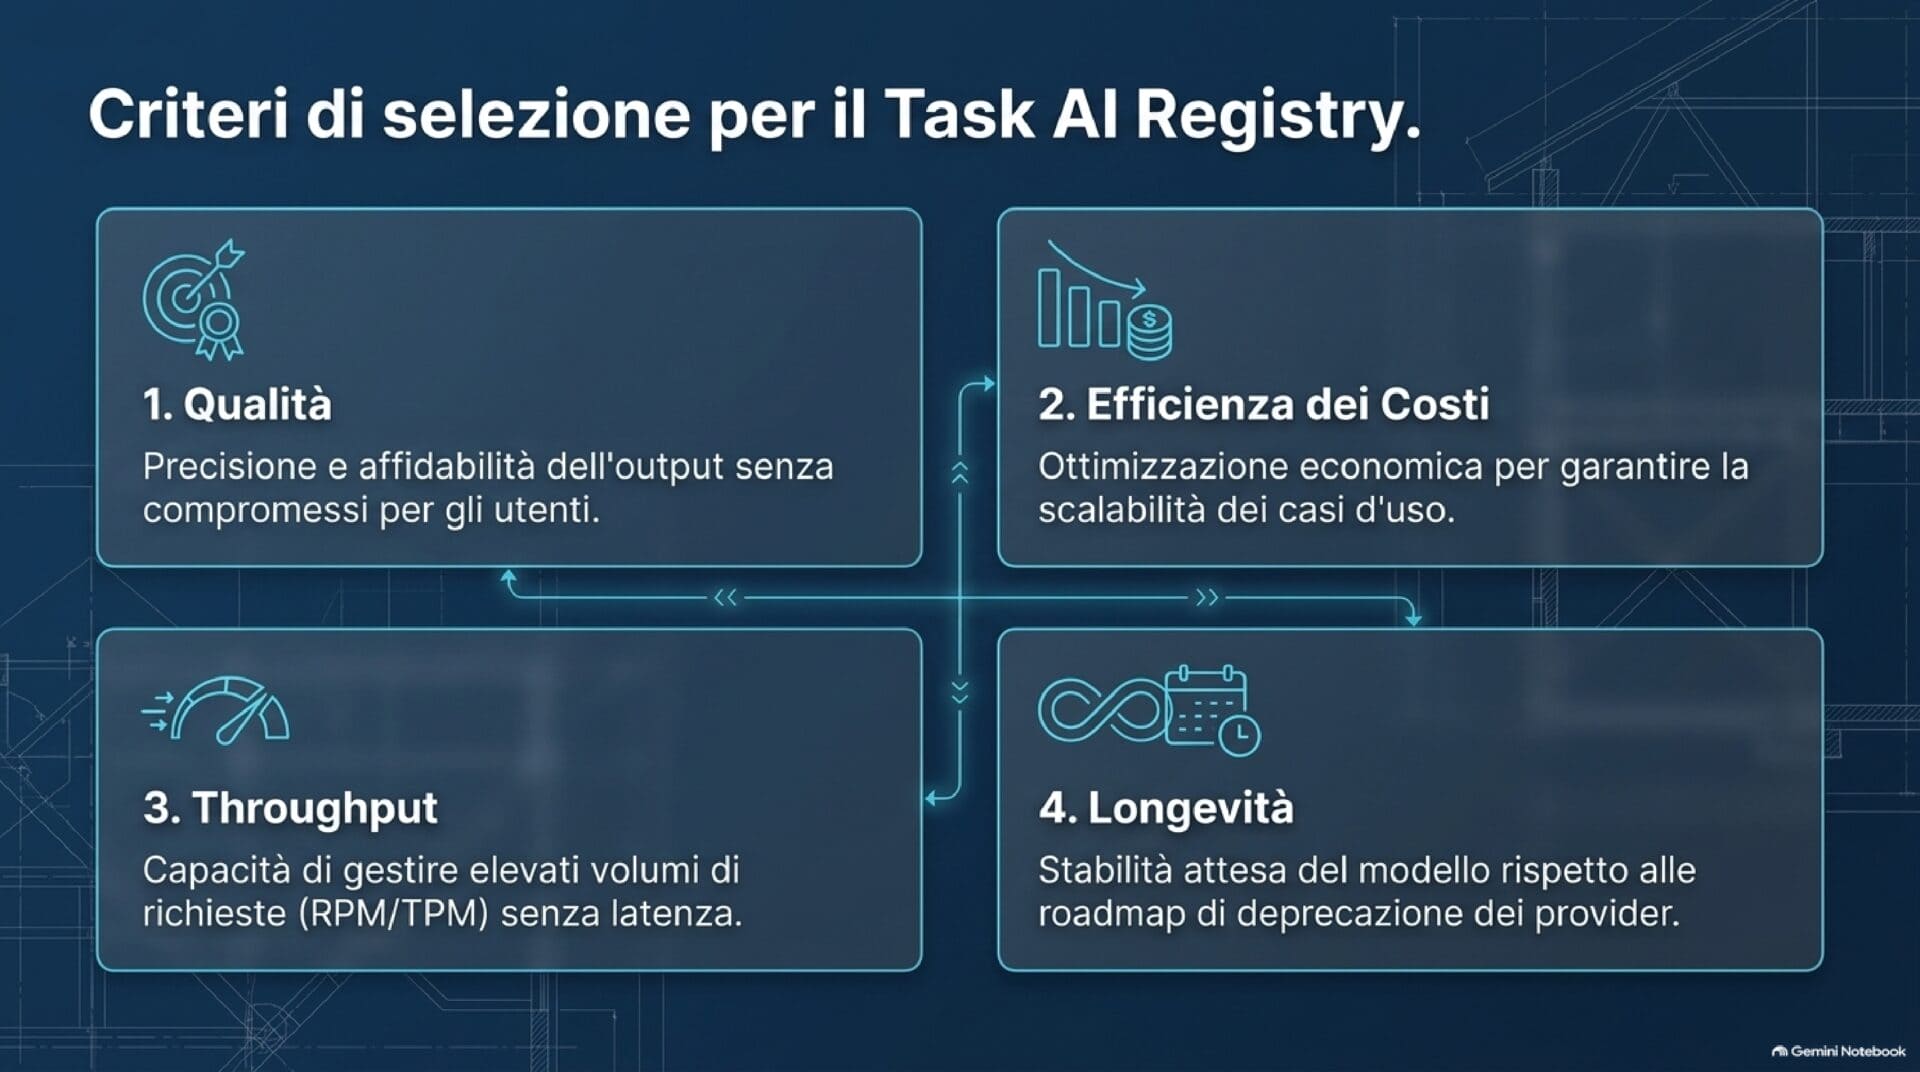
Sulla base di questi criteri, per ciascun task AI vengono selezionati i tre modelli ritenuti più adatti, sottoposti a revisione periodica in funzione dell’evoluzione del mercato e della roadmap tecnologica di Eni.
Sfatare il mito dei modelli di frontiera
I risultati emersi dal processo di valutazione di Eni scardinano anche un luogo comune diffuso: l’idea che per ottenere prestazioni enterprise sia indispensabile ricorrere sempre ai modelli commerciali di punta.
I dati sul campo dimostrano che oltre la metà dei Task AI aziendali può essere gestita con successo senza utilizzare modelli di frontiera. Inoltre, molti dei task usati a oggi possono essere affidati a modelli di dimensioni ridotte (i cosiddetti modelli Tiny), che offrono latenze minime e costi di calcolo contenuti mantenendo la qualità necessaria.
Ciò ha permesso a Eni di “adottare un portafoglio fortemente bilanciato tra LLM commerciali e modelli open-weight”, sottolinea lo specialista dell’azienda: “attraverso l’infrastruttura Private AI, Eni supporta il serving dei modelli Open-weight on-premise, garantendo il controllo sui dati sensibili, riducendo il vendor lock-in e abbattendo i costi operativi su larga scala”.
I tre pilastri per la governance dell’AI generativa
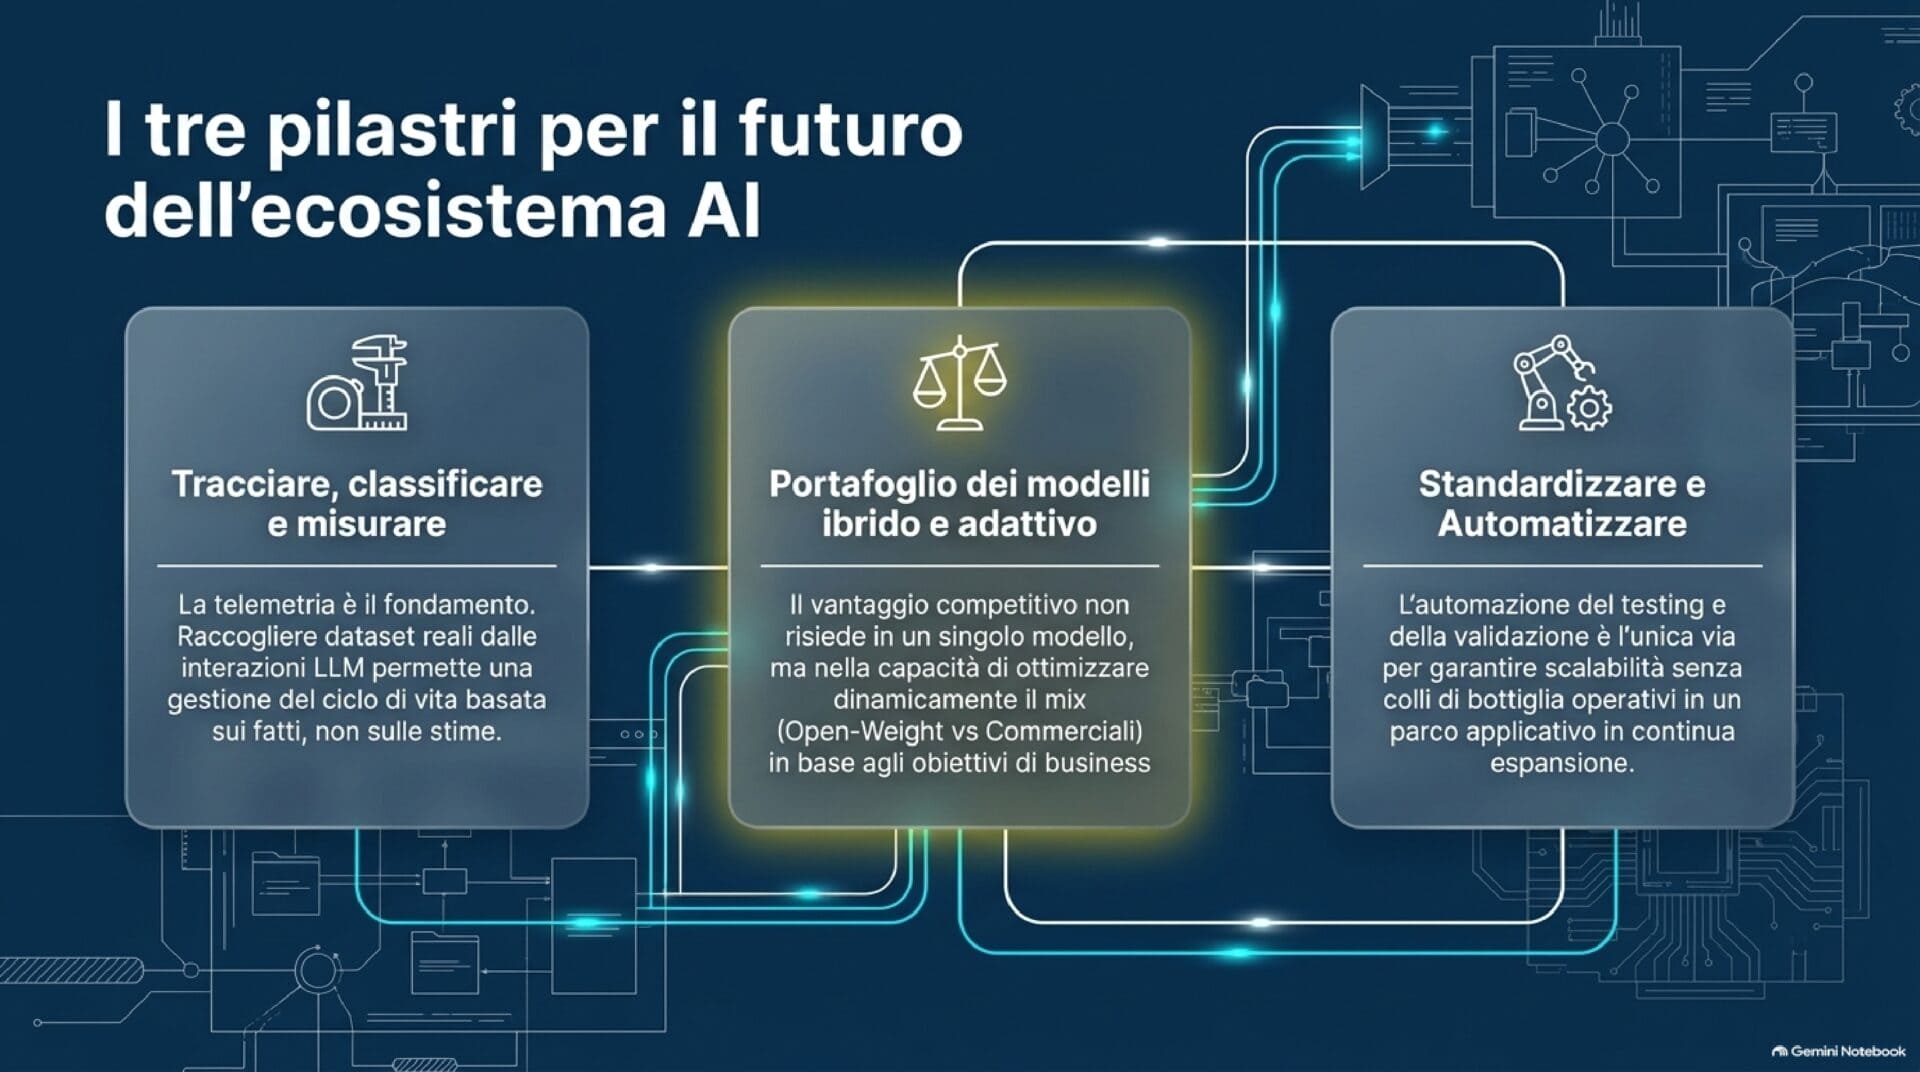
La transizione verso un’integrazione strutturale della Generative AI nei processi core d’impresa richiede un salto di maturità organizzativo e tecnologico. Dall’esperienza di Eni emergono tre indicazioni strategiche fondamentali per i decision maker che guidano la trasformazione digitale:
- Tracciare, classificare e misurare: raccogliere tutte le chiamate verso i modelli LLM, creare dataset di test realistici e disegnare metriche di valutazione è uno sforzo fondamentale per abilitare una gestione efficace del ciclo di vita dei modelli AI generativa.
- Portafoglio dei modelli ibrido e adattivo: il vantaggio competitivo non deriva da una scelta a priori tra modelli open-weight o commerciali, ma dalla capacità di ottimizzare il mix più efficace per ciascun obiettivo di business, mantenendo un processo aggiornato per garantire l’evoluzione dell’ecosistema.
- Standardizzare e automatizzare: la standardizzazione dei processi e l’automazione delle attività di testing e validazione delle performance non è più differibile senza impattare sulle capacità di scalabilità e di gestione di un parco applicativo in costante crescita.
“La gestione delle deprecazioni e del ciclo di vita dei modelli AI non è dunque soltanto un’incombenza tecnica”, fanno notare in Eni, “ma una leva strategica per efficientare l’architettura IT, ottimizzare gli investimenti e garantire l’evoluzione continua dell’ecosistema AI aziendale”.



Partecipa alla community