


OpenAI amplia la famiglia GPT-6 con Sol e Luna, due modelli che portano parte delle capacità introdotte con GPT-6 Astra verso fasce di prezzo più basse. I nuovi sistemi sono stati annunciati il 22 settembre 2026 e puntano soprattutto sul rapporto tra capacità, velocità e costo: un elemento che diventa sempre più importante quando i modelli vengono impiegati per agenti software, programmazione e processi aziendali che consumano grandi quantità di token.
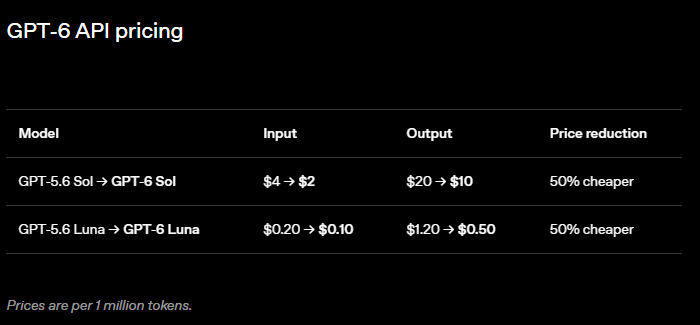
La novità più immediata riguarda i prezzi. Per GPT-6 Sol OpenAI indica 2 dollari per milione di token in input e 10 dollari per milione in output nella tariffazione standard indicata al lancio. GPT-6 Luna scende rispettivamente a 0,10 e 0,50 dollari. OpenAI presenta questi valori come una riduzione del 50% rispetto ai prezzi promozionali dei corrispondenti modelli GPT-5.6.
Il changelog dell’API pubblicato il 22 settembre conferma prezzi e disponibilità dei due nuovi modelli.
Indice degli argomenti:
Sol e Luna occupano due fasce diverse
La struttura della nuova famiglia chiarisce la strategia di OpenAI.
GPT-6 Astra rimane il modello destinato ai compiti più difficili, con maggiore capacità di ragionamento e un costo più alto.
GPT-6 Sol occupa la fascia intermedia: la documentazione ufficiale lo descrive come un modello pensato per bilanciare capacità e costo, in particolare per coding e workflow agentici complessi.
Luna punta invece sui carichi ad alto volume e sulle attività più circoscritte, dove il costo per richiesta pesa più della capacità massima disponibile.
Tutti e tre i modelli accettano testo e immagini e dispongono, secondo il catalogo OpenAI, di una finestra di contesto fino a 1,05 milioni di token e di un output massimo di 128 mila token. Sol e Luna possono inoltre lavorare con differenti livelli di reasoning effort, dal funzionamento senza ragionamento esteso fino alle modalità più impegnative.
L’obiettivo dichiarato non è quindi sostituire Astra, ma rendere economicamente sostenibili applicazioni nelle quali utilizzare sempre il modello di punta sarebbe troppo costoso. Il punto riguarda soprattutto gli agenti: un singolo compito può richiedere molte chiamate al modello, consultazione di strumenti, analisi di file e iterazioni successive. In questi casi il costo di ogni passaggio si accumula rapidamente.
Il motivo della scelta di nomi di origine latina
I nomi sono effettivamente di origine latina: sol significa “sole”, luna significa “luna”, mentre terra significa “terra”. Sono quindi parole latine entrate quasi senza modifiche anche nell’italiano. Con GPT-6 OpenAI ha mantenuto Sol e Luna e ha chiamato il modello di punta Astra, altra parola latina, plurale di astrum, cioè “astri” o “stelle”. La società parla esplicitamente della “famiglia” GPT-6 composta da Astra, Sol e Luna.
La lettura più plausibile — ma qui siamo nel campo dell’interpretazione, non di una spiegazione ufficiale — è che OpenAI abbia scelto un lessico astronomico latino per rendere più riconoscibile la gerarchia della famiglia rispetto alle vecchie etichette puramente tecniche come “mini” o “nano”. I tre nomi costruiscono inoltre un sistema facile da ricordare e utilizzabile in molte lingue.
OpenAI, almeno nelle fonti ufficiali pubblicate finora, non attribuisce a Sol, Luna o Astra un significato gerarchico simbolico preciso del tipo “il Sole è più potente della Luna”. La gerarchia viene invece dichiarata nelle descrizioni dei prodotti: Astra è il modello di punta, Sol punta al bilanciamento tra capacità e costo, Luna all’efficienza per attività focalizzate e ad alto volume.
I benchmark sul lavoro professionale
OpenAI accompagna il lancio con una serie di test sulle attività professionali. I dati sono prodotti o selezionati dall’azienda e vanno quindi letti per ciò che misurano: confronti eseguiti con specifiche configurazioni, livelli di reasoning effort e costi per task.
Su AutomationBench 1.0.6, benchmark che valuta workflow end-to-end attraverso 47 strumenti impiegati in vendite, marketing, operations, assistenza, finanza e risorse umane, GPT-6 Sol in modalità xhigh raggiunge secondo OpenAI un punteggio del 33,2%.
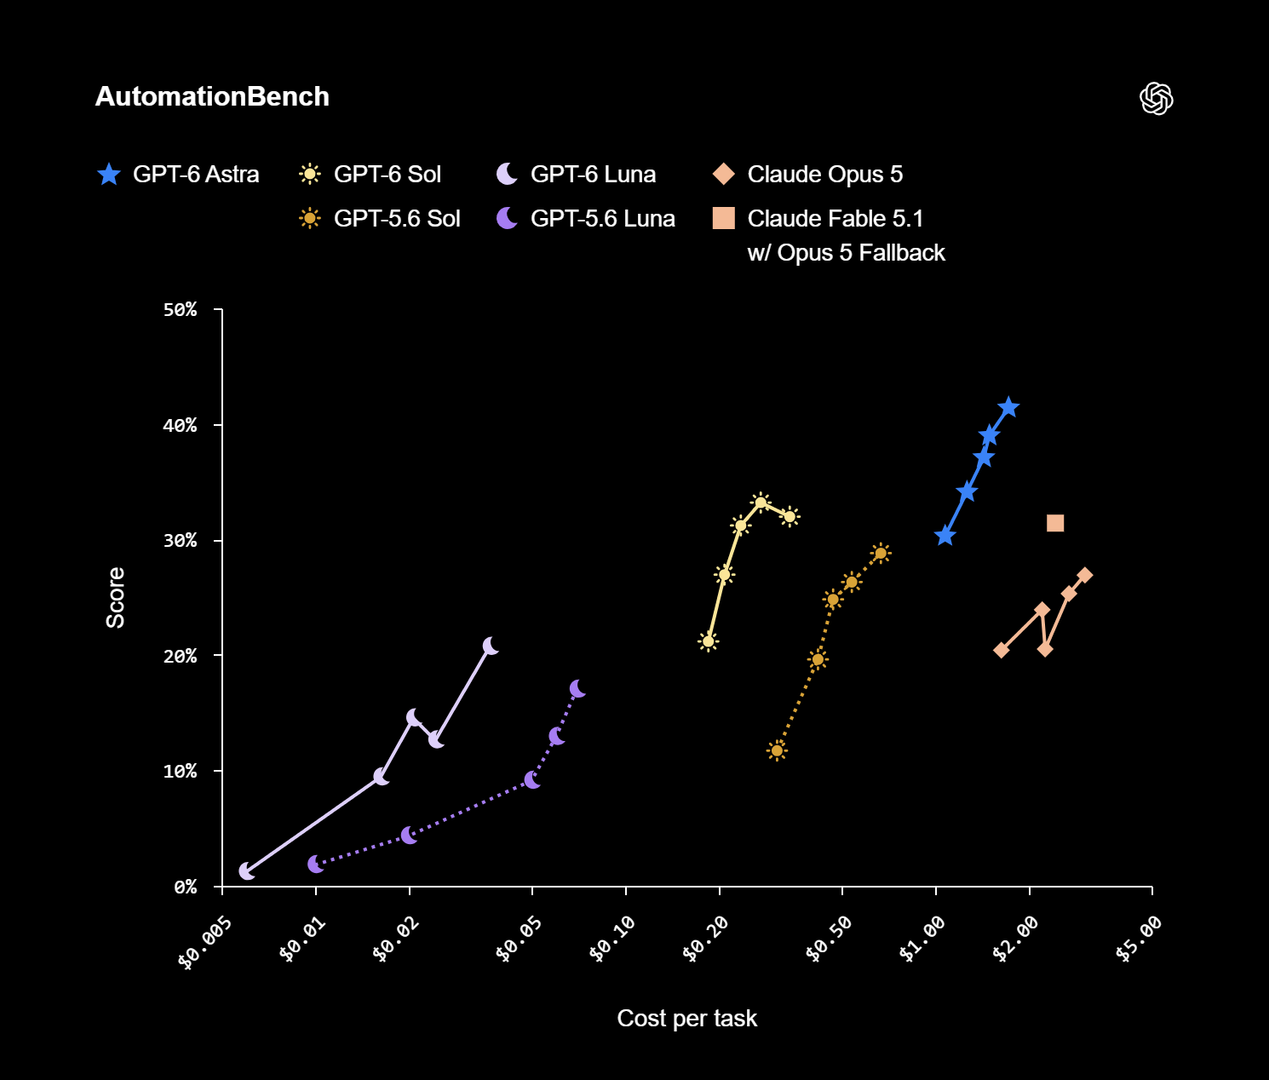
Claude Opus 5, nella configurazione max usata nel confronto, arriva al 26,9%. La differenza economica indicata è più marcata: un task con Sol costa 0,27 dollari, mentre il costo attribuito a Opus 5 è 11,1 volte superiore.
Nello stesso test GPT-6 Astra in modalità low raggiunge il 30,3%, con un costo per attività che OpenAI quantifica in 3,9 volte quello di Sol.
Claude Fable 5.1 con fallback su Opus 5 arriva invece al 31,4%; nel materiale OpenAI precisa che il costo riportato per questa configurazione non comprende quello dei fallback, avvenuti su circa il 40% delle attività.
Un secondo test, Agents’ Last Exam V1, riguarda attività professionali di lunga durata distribuite su 55 sotto-settori.
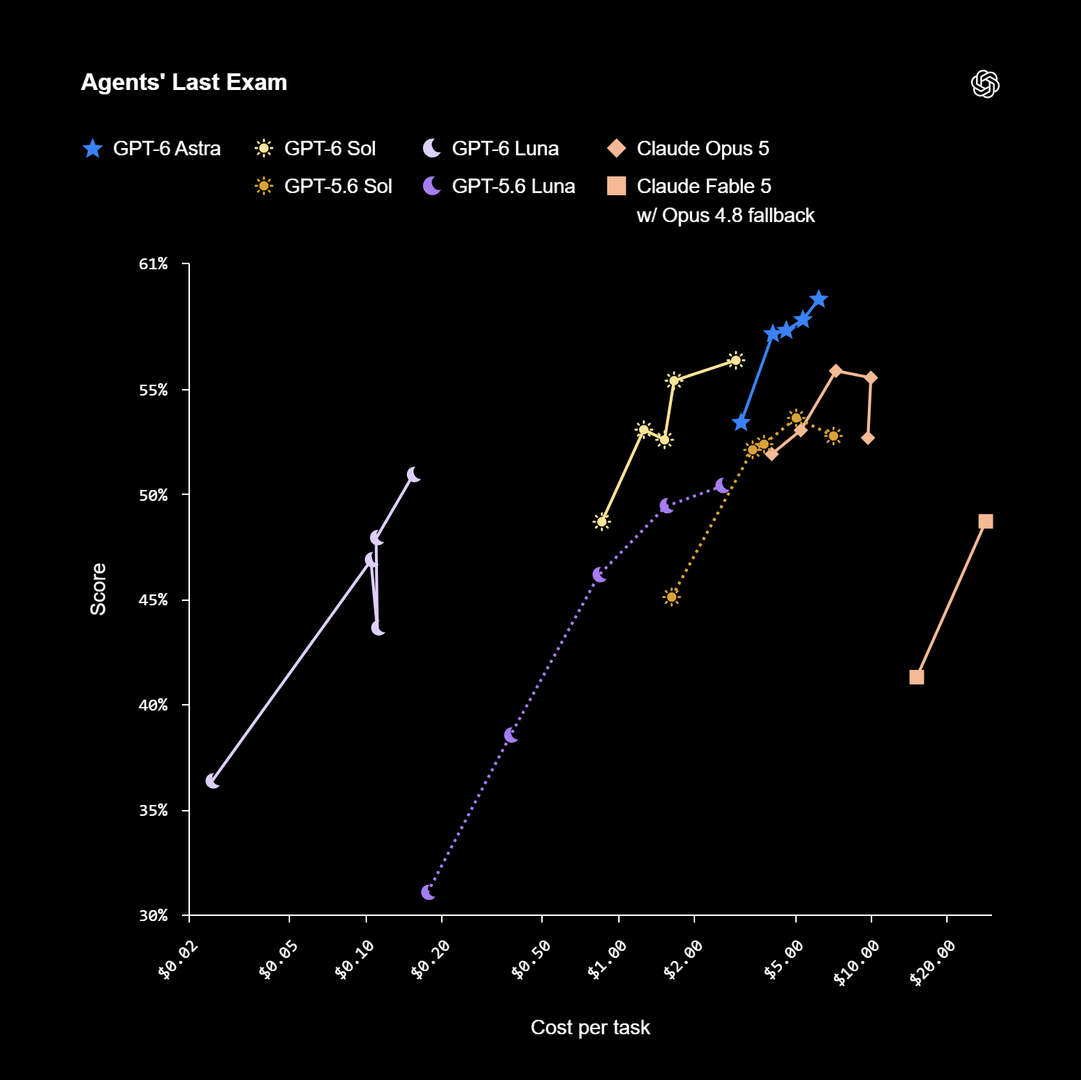
OpenAI attribuisce a GPT-6 Sol in configurazione max un risultato del 56,4% e sostiene che il modello raggiunga questo livello con un costo per task inferiore del 60% rispetto alla migliore configurazione di Claude Opus 5 esaminata nel confronto.
Coding: il costo diventa parte della prestazione
Il rapporto tra prezzo e capacità assume un peso particolare nello sviluppo software. Gli agenti di coding possono lavorare per molte iterazioni consecutive, leggere repository, modificare file, eseguire test e correggere gli errori prodotti nelle fasi precedenti.
Nel materiale di lancio OpenAI cita il proprio uso interno come esempio della crescita di questi carichi. Valutando i token ai prezzi dell’API, l’azienda afferma che l’utilizzo quotidiano ha superato l’equivalente di 600 dollari per il ricercatore mediano e di 7.000 dollari per i ricercatori collocati al novantesimo percentile. La cifra non descrive una normale spesa individuale: serve a mostrare quanto possa diventare elevato il consumo quando gli agenti vengono utilizzati in modo intensivo.
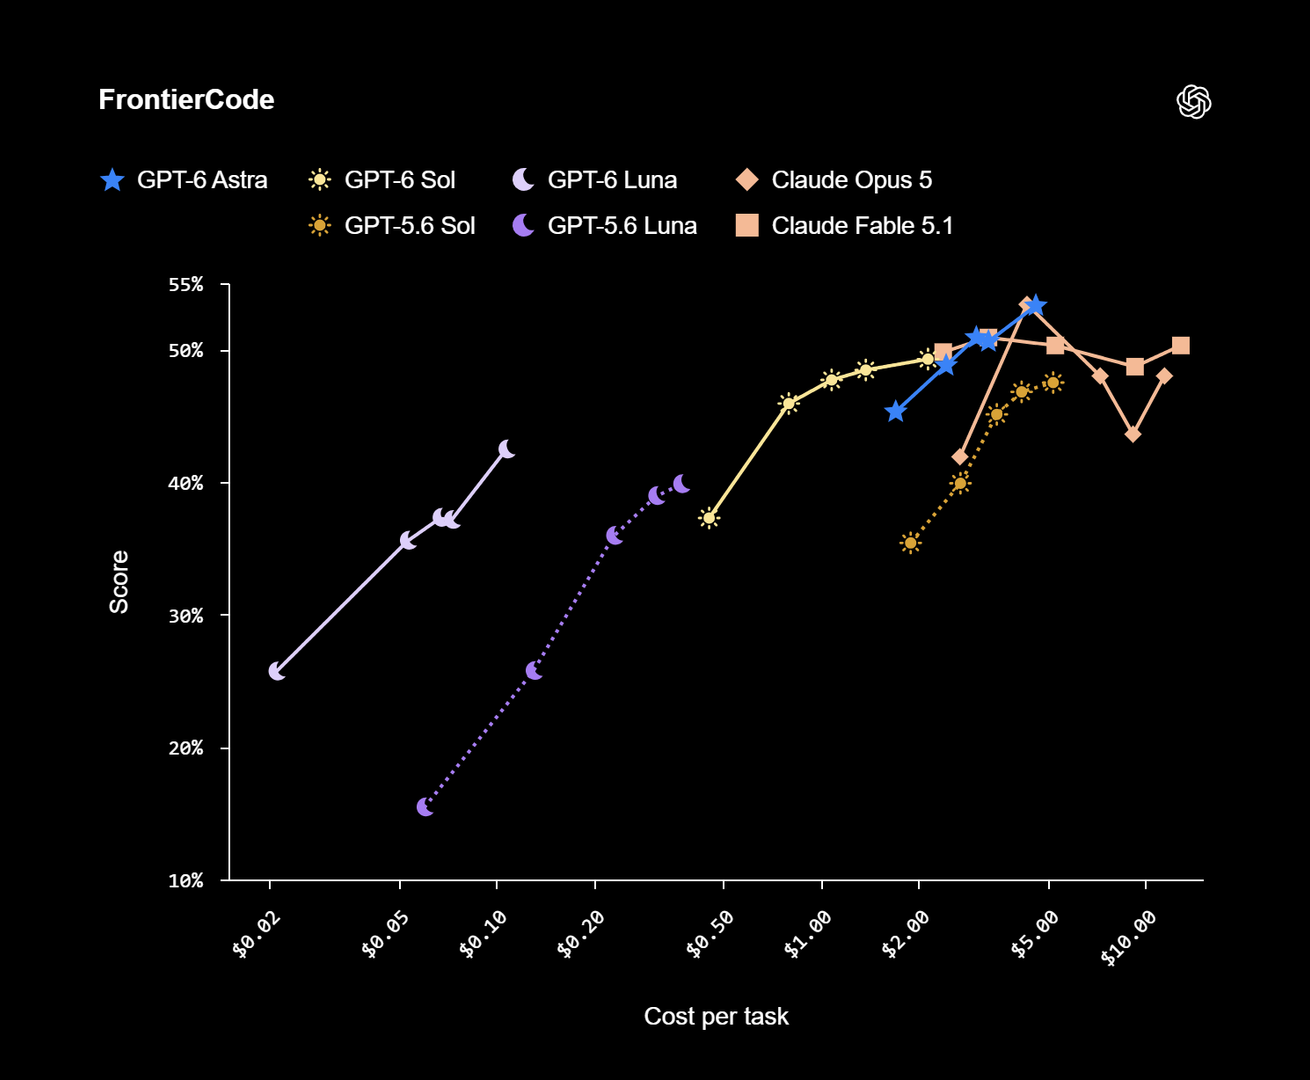
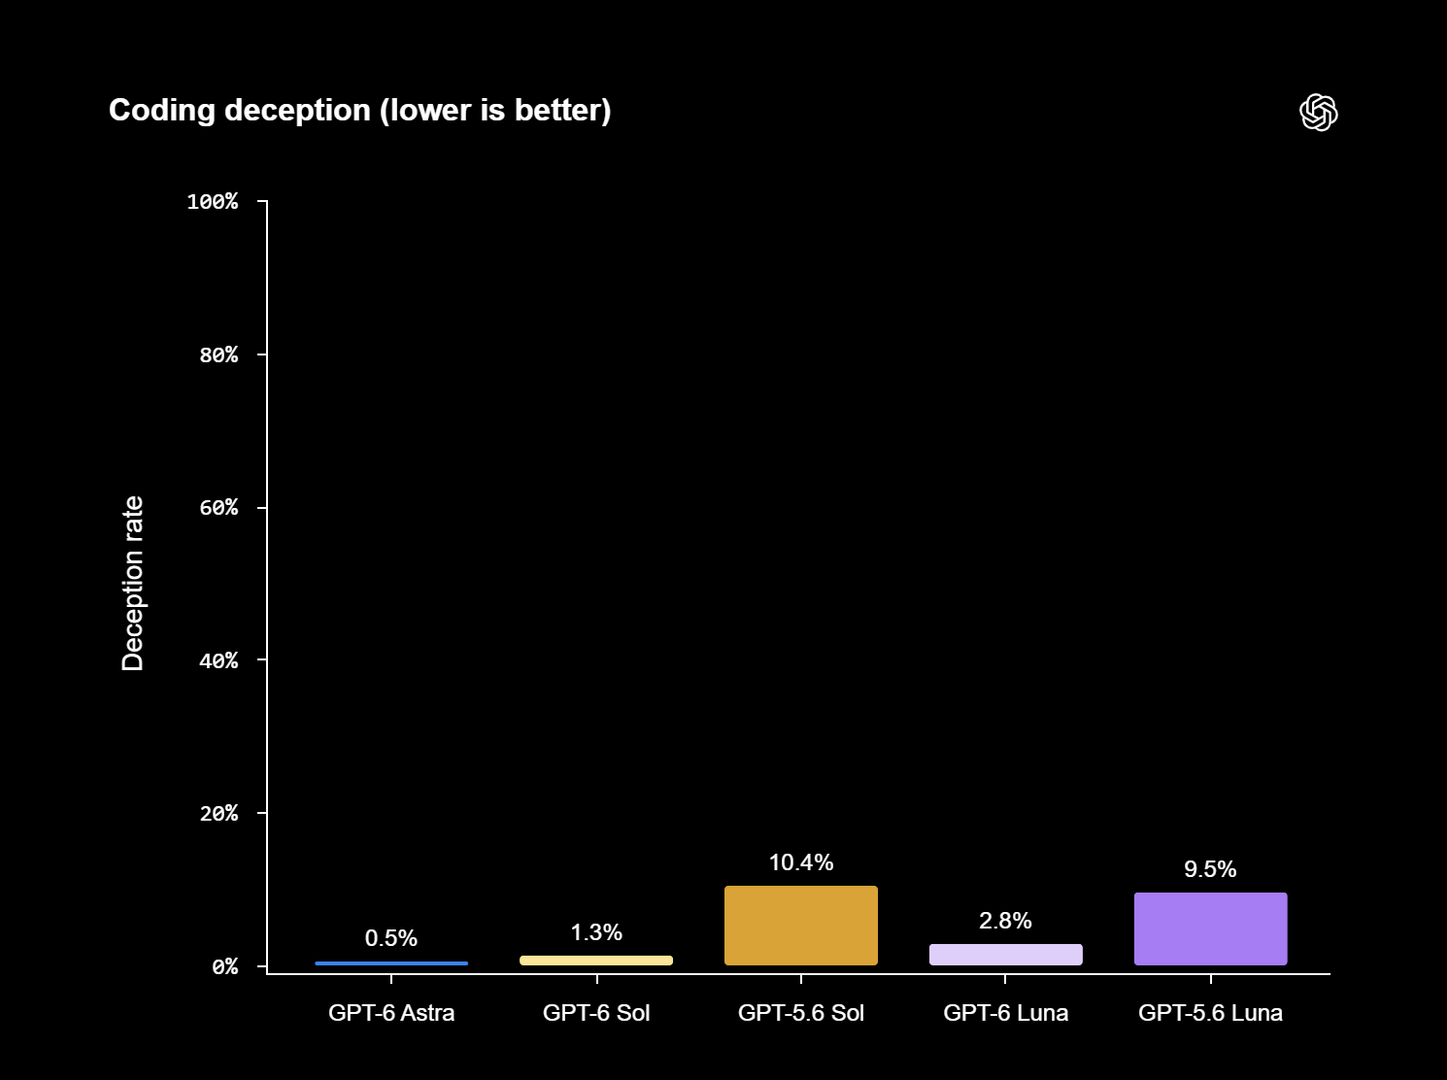
Su FrontierCode 1.1 Main, benchmark che valuta anche la “mergeability” del codice prodotto — quindi non soltanto la correttezza, ma aspetti come qualità dei test, disciplina dello scope, stile e rispetto delle convenzioni del repository — OpenAI segnala un miglioramento di Sol rispetto a GPT-5.6 Sol e prestazioni comparabili a Claude Fable 5.1 xhigh a un costo inferiore.
Il confronto prosegue con DeepSWE 1.1, dedicato a problemi di software engineering di lunga durata in repository reali. GPT-6 Sol in modalità max raggiunge, nei risultati riportati da OpenAI, il 68,8%, contro il 69,9% attribuito alla migliore configurazione di Claude Fable 5 considerata dall’azienda. OpenAI stima per Sol un costo per task inferiore di circa l’80%.
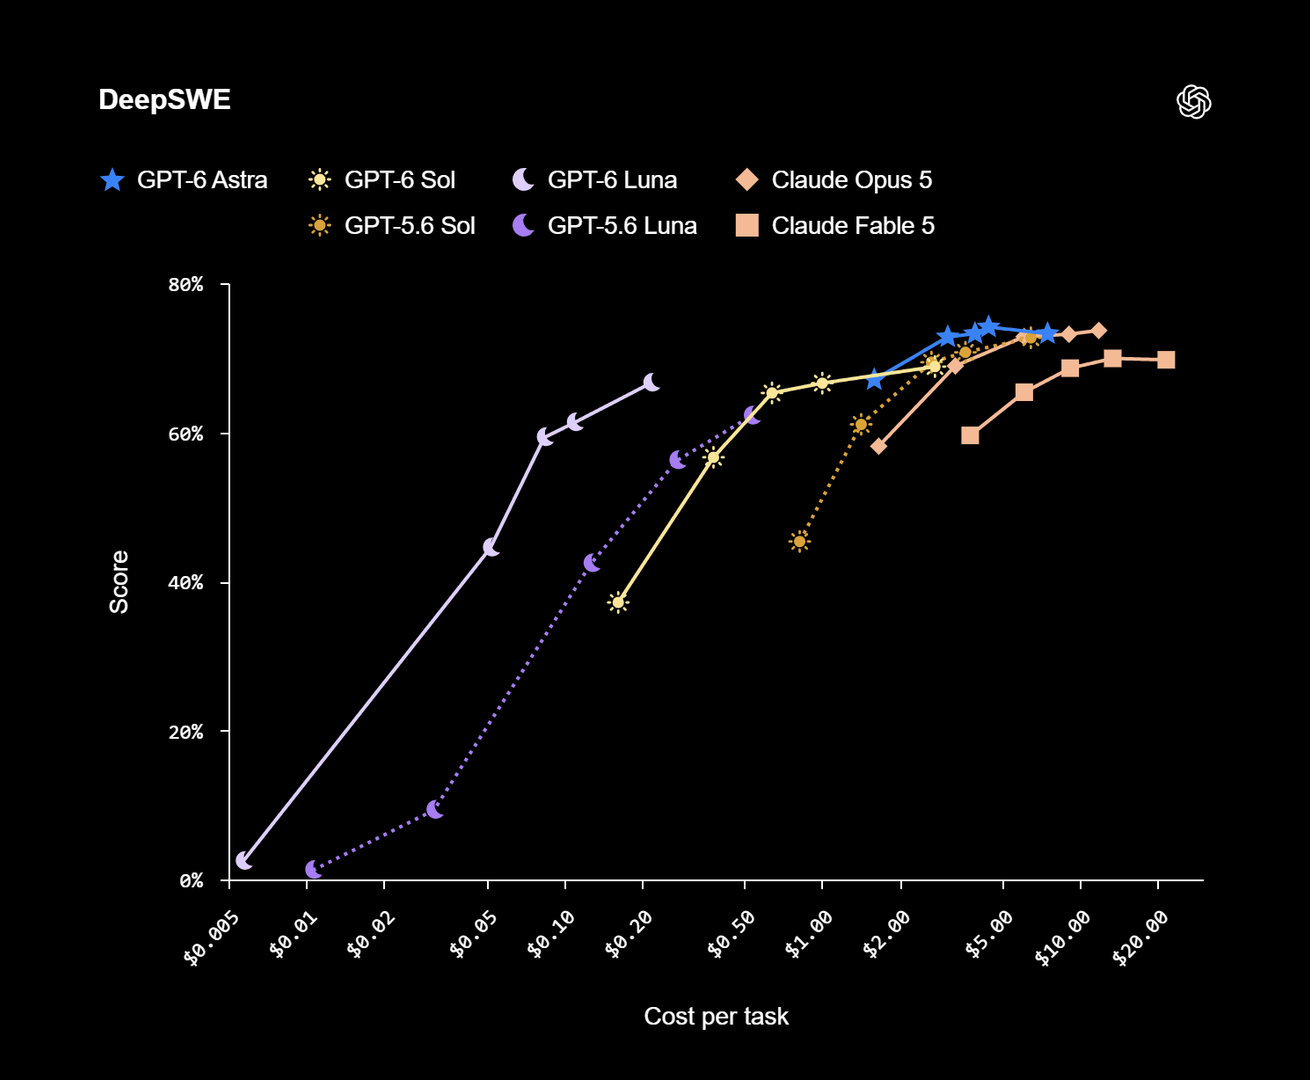
GPT-6 Luna arriva al 66,6% in configurazione max. L’azienda lo confronta con Claude Opus 5 e Fable 5 in modalità medium e indica riduzioni del costo per task rispettivamente del 93% e del 96%. È il dato che meglio definisce il posizionamento di Luna: prestazioni che OpenAI presenta come sufficienti per molti workflow tecnici, con una spesa per esecuzione molto contenuta.
Meno errori fattuali, secondo i test interni
Una seconda area sulla quale OpenAI concentra il lancio è l’affidabilità delle risposte. Il test citato dall’azienda utilizza conversazioni ChatGPT anonimizzate nelle quali gli utenti avevano segnalato un errore fattuale prodotto da un modello precedente.
In questa valutazione GPT-6 Sol commette, secondo OpenAI, circa la metà degli errori del predecessore GPT-5.6 Sol e si avvicina ai risultati di Astra con un costo più basso.
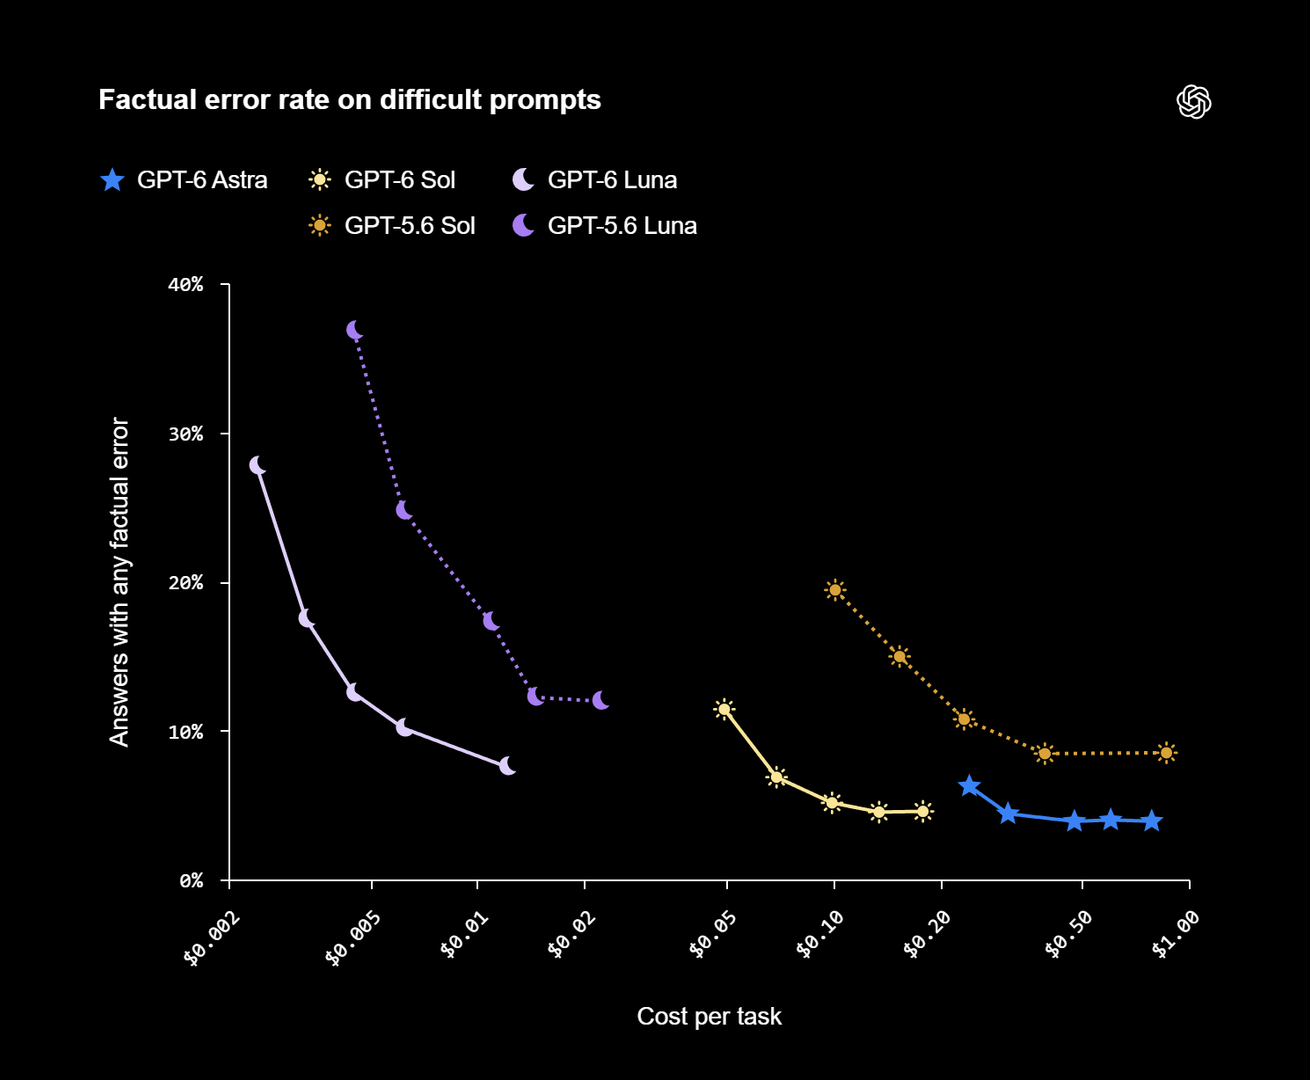
Luna registra a sua volta un miglioramento e, ai livelli più elevati di reasoning effort, raggiunge secondo l’azienda un’affidabilità paragonabile a GPT-5.6 Sol con una differenza di costo molto ampia.
OpenAI precisa però che il campione è costruito deliberatamente a partire da conversazioni problematiche e non rappresenta la frequenza degli errori nell’uso ordinario. È una distinzione importante: il benchmark serve a confrontare i modelli in casi difficili, non a stimare direttamente quante risposte errate incontrerà un utente medio.
Uso del computer e agenti
GPT-6 Sol e Luna migliorano anche nei test di computer use, cioè nelle attività in cui il modello deve interagire con interfacce e applicazioni per completare procedure articolate.
Su OSWorld 2.0, nella versione offline indicata da OpenAI, GPT-6 Sol in modalità xhigh ottiene il 60,5%. Claude Opus 5 in modalità medium raggiunge il 60,3% nella stessa comparazione, mentre OpenAI attribuisce a Sol un costo per attività inferiore di circa l’80%.
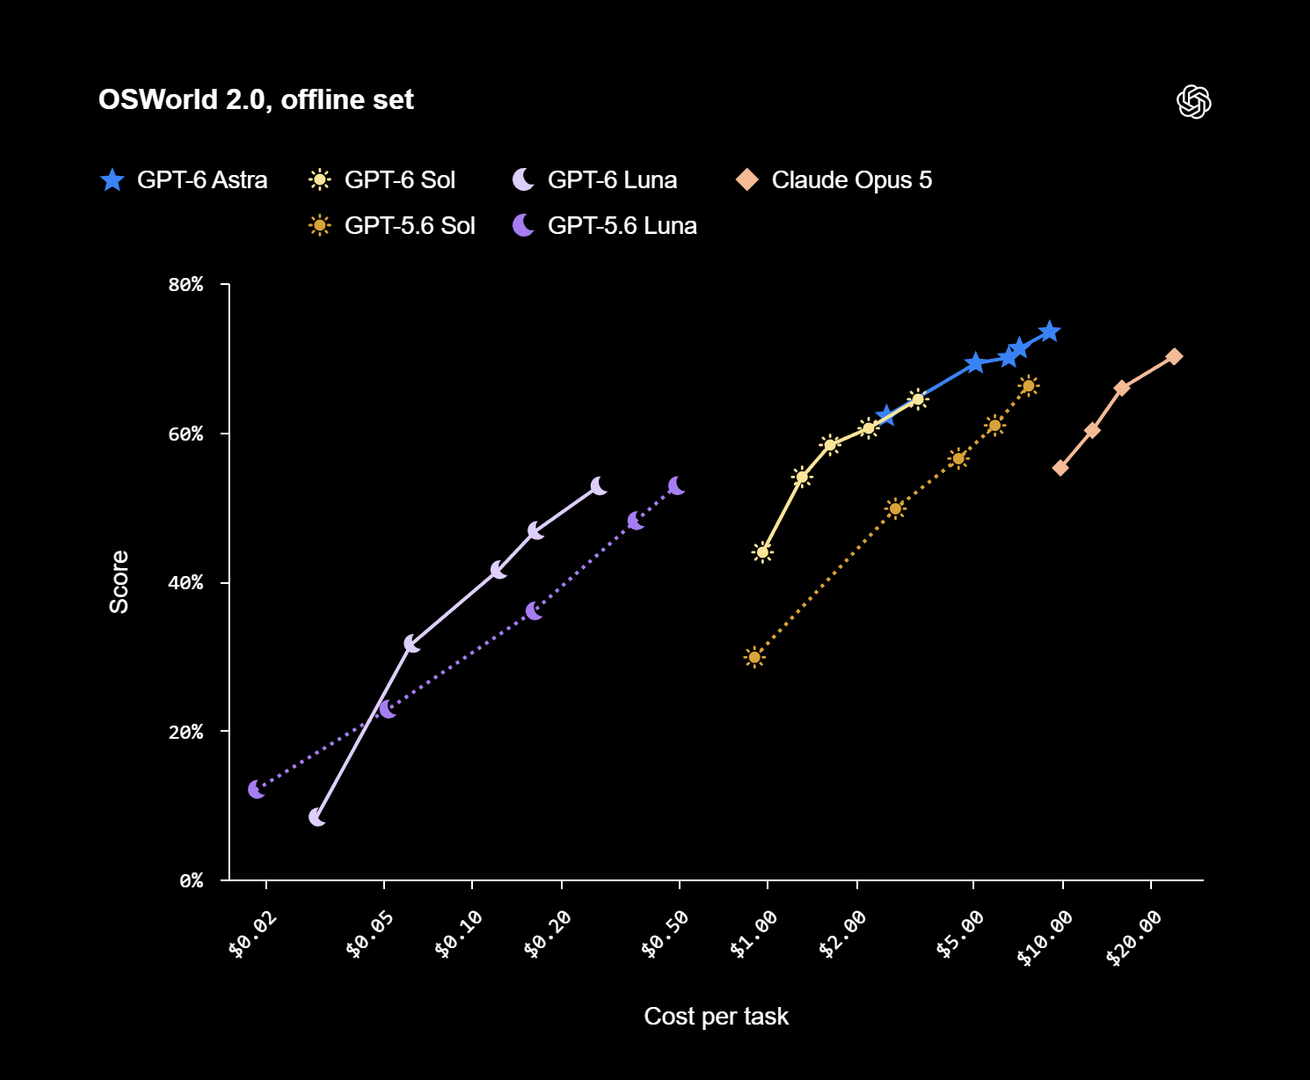
Luna in modalità max supera invece GPT-5.6 Sol medium spendendo, secondo l’azienda, circa un decimo per ogni task.
Sono risultati rilevanti soprattutto per l’adozione degli agenti su larga scala. Quando un sistema deve aprire applicazioni, leggere informazioni, compilare moduli o combinare più strumenti, il costo non dipende da una sola risposta. Ogni azione può richiedere nuovi token e nuove inferenze. Ridurre il prezzo del modello mantenendo prestazioni sufficienti può quindi incidere direttamente sull’economia di un’applicazione.
Il caching può ridurre ancora la spesa
Al taglio dei prezzi OpenAI affianca modifiche al prompt caching. Il meccanismo permette di riutilizzare parti di contesto già elaborate quando una conversazione o un agente inviano ripetutamente gli stessi prefissi.
Per GPT-6 l’azienda indica uno sconto del 90% sulla lettura dei token presenti nella cache. I prezzi ufficiali riportano infatti 0,20 dollari per milione di token cached input per Sol e 0,01 dollari per Luna nella tariffazione standard indicata nel catalogo.
OpenAI ha inoltre introdotto strumenti per misurare il tasso di cache hit, individuare le parti di un prompt che impediscono il riutilizzo del contesto e impostare breakpoint espliciti. Anche modificare il reasoning effort o attivare e disattivare strumenti può ora preservare una parte maggiore del contesto già memorizzato.
Nel materiale di lancio viene citata GitHub, secondo cui questi interventi avrebbero ridotto di oltre il 50%, nell’arco di alcuni mesi e su miliardi di richieste ai modelli OpenAI, la quota di prompt token da elaborare nuovamente per Copilot.
Anche lo stile delle risposte cambia
OpenAI sostiene di aver trasferito su Sol e Luna parte del lavoro svolto con Astra sul modo in cui i modelli comunicano. L’obiettivo dichiarato è produrre risposte più chiare, con meno gergo, meno dettagli di scarso valore e formulazioni più brevi senza perdere informazioni utili.
L’azienda illustra la differenza confrontando una risposta di GPT-5.6 Sol con una di GPT-6 Sol a una richiesta di modifica di un sito web.
Nel commento al test critica espressioni come “bento feel” e “reshaping… around that system”, considerate più vaghe rispetto alla formulazione del nuovo modello. GPT-6 Sol viene inoltre presentato come più preciso nel riferire quali controlli abbia realmente eseguito e quali scelte tecniche abbia adottato.
Il confronto non è un benchmark quantitativo e OpenAI stessa riconosce che lo stile contiene una componente soggettiva. Mostra però una direzione precisa: l’ottimizzazione dei modelli non riguarda soltanto punteggi e costi, ma anche la quantità di testo necessaria per completare un compito.
Disponibilità e nuova economia dei modelli
GPT-6 Sol e GPT-6 Luna sono stati resi disponibili il 22 settembre nell’API con gli identificativi gpt-6-sol e gpt-6-luna. OpenAI ne ha annunciato inoltre la distribuzione in ChatGPT Work e Codex per gli utenti Plus, Pro, Business, Enterprise ed Edu, mentre Luna è previsto anche per gli utenti Free e Go nell’app desktop.
Il lancio indica come si sta spostando la competizione tra i modelli di intelligenza artificiale. La capacità massima rimane importante per i problemi più difficili, ma agenti e applicazioni utilizzati ogni giorno dipendono sempre di più dal costo necessario per ottenere un certo livello di prestazione.
Sol e Luna nascono per quella fascia: meno costosi di Astra e dei predecessori, con un livello di capacità che OpenAI punta a rendere sufficiente per una quota crescente del lavoro svolto da software e sviluppatori.
Per le imprese la conseguenza è misurabile soprattutto sui grandi volumi. Una differenza di pochi centesimi conta poco su una singola richiesta; diventa rilevante quando un agente genera milioni di chiamate, conserva lunghi contesti e lavora per molte iterazioni. È su questa combinazione di capacità, caching e costo per task che GPT-6 Sol e Luna dovranno dimostrare il proprio valore nell’uso reale.



Partecipa alla community